Training Qwen3 di AWS Trainium Pakai torchtitan: 3 Cara Praktis
AWS membagikan panduan training dan fine tuning Qwen3 di chip Trainium2 pakai torchtitan. Simak tiga cara setup mulai dari Transformers v5 sampai custom kernel NKI.
· 7 menit baca
Inti singkat
- AWS Trainium kini bisa dipakai langsung seperti device PyTorch biasa lewat integrasi TorchNeuron di framework torchtitan.
- Developer bisa menjalankan training Qwen3 lewat Hugging Face Transformers v5, model native torchtitan, atau resep kernel NKI.
- Proses fine tuning Qwen3-4B terbukti valid dengan loss awal 6,54 dan bobot safetensors yang cocok saat diekspor ulang.
- Arsitektur Mixture of Experts (MoE) dan custom kernel RoPE bisa dipasang rapi memakai registry override torchtitan.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Melatih model AI skala besar sekarang nggak melulu harus bergantung pada GPU konvensional berbiaya selangit. AWS membagikan cara training Qwen3 di chip AWS Trainium memakai torchtitan, lengkap dari fine tuning bobot Hugging Face sampai pasang kernel NKI khusus.
Kabar ini dibagikan oleh Josh Longenecker lewat pengumuman resmi AWS. Lewat library torchtitan-neuron, chip akselerator Trainium2 dikenali langsung sebagai native device di PyTorch. Artinya, kamu bisa menjalankan alur kerja pre-training maupun fine tuning memakai pola dan perintah standar PyTorch yang udah biasa kamu pakai sehari-hari.
Dalam panduan teknis ini, pengujian dilakukan pada satu instance trn2.48xlarge. Ada tiga cara yang bisa kamu pilih: memanfaatkan backend Transformers v5, beralih ke model native torchtitan, atau menyematkan kernel Neuron Kernel Interface (NKI) untuk model arsitektur Mixture of Experts (MoE). Yuk, kita bedah langkah-langkah teknisnya bareng-bareng.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu torchtitan dan Kenapa Dipakai Bareng AWS Trainium?
torchtitan adalah framework open source dari tim PyTorch yang dirancang khusus buat melatih model fondasi (LLM) secara bersih, modular, dan gampang dikustomisasi. Masalahnya, chip akselerator non-GPU sering kali butuh konfigurasi runtime yang ribet dan bikin kode latihan AI harus dirombak total.
Di sinilah peran TorchNeuron. Paket ini mendaftarkan AWS Trainium langsung sebagai device neuron di PyTorch. Pas torchtitan dijalankan, framework ini otomatis mendeteksi hardware Trainium tanpa perlu trik aneh-aneh. Kalau kamu jalan di mode eager, Neuron bakal mengompilasi operasi pas kode dieksekusi. Sementara kalau kamu menyalakan torch.compile, Neuron bakal mengompilasi graph komputasi secara utuh.
Sebelumnya, kita sempat membahas dasar ekosistem ini di artikel /developer/torchneuron-aws-trainium-hugging-face-pytorch. Nah, lewat update resep torchtitan-neuron terbaru, alur kerja ini makin matang buat menangani model mutakhir kayak Qwen3.
Spek Hardware dan Persiapan Environment trn2.48xlarge
Buat mempraktikkan panduan ini, kamu butuh satu instance trn2.48xlarge. Lingkungan kerjanya bisa disiapkan memakai AWS Deep Learning AMI for Neuron atau container Docker Neuron PyTorch training. Keduanya udah memuat driver Neuron, runtime, dan compiler yang dibutuhkan.
Berikut spesifikasi environment yang dipakai dalam pengujian resmi AWS:
| Komponen | Versi / Spesifikasi |
|---|---|
| Tipe Instance | trn2.48xlarge (16 akselerator Trainium2, 128 NeuronCore fisik) |
| Logical NeuronCores | 64 core pada setting LNC=2 |
| PyTorch & Neuron | torch 2.14.0, torch_neuronx 2.14.3 |
| Hugging Face Transformers | 5.16.0 |
| torchtitan-neuron | release-2.33 (0.2.2+neuron.1) |
Sebelum mulai, cek dulu apakah environment kamu udah terpasang dependensi yang sesuai dengan menjalankan perintah ini di terminal:
python3 -c "import torchtitan, torchtitan_neuron; print(torchtitan.__version__, torchtitan_neuron.__file__)"Kalau belum ada, pasang repositori torchtitan-neuron beserta dependensinya. Ingat buat memakai opsi --no-deps supaya instalasi nggak menimpa build PyTorch khusus Neuron:
git clone https://github.com/aws-neuron/torchtitan-neuron
cd torchtitan-neuron
pip install -r requirements.txt
Setelah itu, unduh artefak model Qwen3 dari Hugging Face Hub ke folder lokal yang nantinya bakal dibaca oleh script training:
hf download Qwen/Qwen3-4B-Instruct-2507 \
  --local-dir "$PWD/assets/hf/Qwen3-4B-Instruct-2507"
Cara 1: Training dan Fine Tuning Pakai Transformers v5
Metode pertama cocok banget kalau kamu pengin alur kerja yang serba praktis. Di sini, Transformers v5 bertindak sebagai backend pemodelan di torchtitan lewat fungsi AutoModelForCausalLM. Definisi model langsung diambil dari Hub, jadi kamu tinggal mengarahkan ID modelnya aja.
Bikin file baru bernama neuron_qwen3.py di root repositori torchtitan-neuron, lalu masukkan konfigurasi dasar berikut:
import os
from torchtitan.experiments.transformers_modeling_backend.config_registry import (
    transformers_modeling_backend_full,
)
from torchtitan.experiments.transformers_modeling_backend.configs import (
    TransformersBackendConfig,
)

ASSETS = os.path.abspath("./assets/hf/Qwen3-4B-Instruct-2507")

def v5_qwen3_4b() -> TransformersBackendConfig:
    config = transformers_modeling_backend_full()
    config.hf_model = "Qwen/Qwen3-4B-Instruct-2507"
    config.hf_assets_path = ASSETS
    config.dataloader.dataset = "c4_test"
    config.training.steps = 10
    config.training.local_batch_size = 1
    config.parallelism.data_parallel_shard_degree = -1
    return config
Jalankan training memakai perintah torchrun dengan 64 proses (mencakup 64 logical NeuronCore):
torchrun --nproc_per_node=64 --rdzv_backend c10d --rdzv_endpoint localhost:0 \
  --local-ranks-filter 0 --role rank --tee 3 \
  -m torchtitan.train --module neuron_qwen3 --config v5_qwen3_4b
Memuat dan Menyimpan Checkpoint Hugging Face
Kalau kamu mau melakukan fine tuning dari bobot resmi yang udah dipublikasikan, aktifkan fitur checkpoint dan arahkan initial_load_path ke folder artefak tadi:
def v5_qwen3_4b_finetune() -> TransformersBackendConfig:
    config = v5_qwen3_4b()
    config.checkpoint.enable = True
    config.checkpoint.folder = "checkpoint_qwen3_4b_ft"
    config.checkpoint.initial_load_path = ASSETS # wajib path absolut
    config.checkpoint.initial_load_in_hf = True
    config.checkpoint.initial_load_model_only = True
    config.checkpoint.last_save_in_hf = True
    config.checkpoint.last_save_model_only = True
    return config
Nilai loss pada langkah pertama bisa jadi indikator cepat buat memastikan bobot pre-trained sukses terbaca. Pada model Qwen/Qwen3-4B-Instruct-2507, nilai loss di langkah ke-1 tercatat di angka 6,54 saat memakai bobot resmi, sedangkan kalau inisialisasi acak (random initialization) angkanya melonjak ke 12,43.
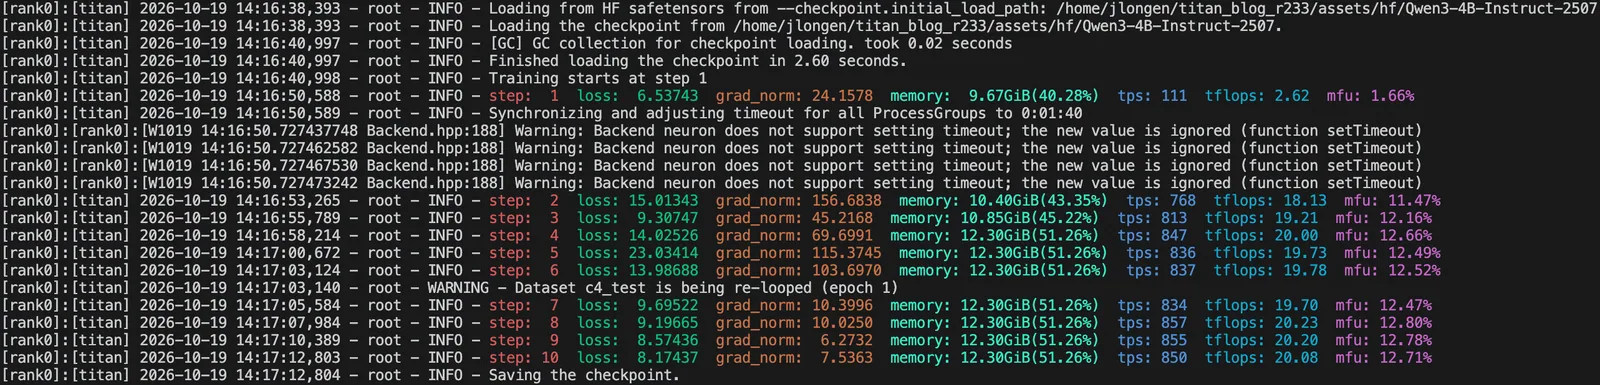
Begitu proses selesai, checkpoint hasil ekspor bisa langsung dimuat ulang lewat AutoModelForCausalLM dan load_state_dict. Pengujian membuktikan nggak ada key yang hilang atau berlebih selain lm_head.weight (yang emang wajar karena Qwen3-4B mengikat bobot kepala model dengan token embedding).
Cara 2: Training Native Qwen3 Langsung di torchtitan
Cara kedua adalah memakai implementasi native Qwen3Model bawaan torchtitan. Pendekatan ini biasanya dipilih developer yang pengin kontrol penuh atas arsitektur model tanpa lapisan abstraksi tambahan dari library eksternal.
Tambahkan fungsi konfigurasi native ini ke dalam file neuron_qwen3.py:
from torchtitan.models.qwen3 import model_registry
from torchtitan.models.qwen3.config_registry import qwen3_32b
from torchtitan.trainer import Trainer

def native_qwen3_4b() -> Trainer.Config:
    config = qwen3_32b()
    config.model_spec = model_registry("4B", attn_backend="sdpa")
    config.hf_assets_path = ASSETS
    config.dataloader.dataset = "c4_test"
    config.training.steps = 10
    config.training.local_batch_size = 1
    config.training.global_batch_size = 64
    config.parallelism.data_parallel_shard_degree = -1
    return config
Karena build pengujian belum menyediakan template generic qwen3_4b(), kodenya meminjam base config qwen3_32b() lalu mengganti model_spec ke ukuran 4B dengan backend Scaled Dot-Product Attention (sdpa). Jalankan perintah eksekusi berikut:
torchrun --nproc_per_node=64 --rdzv_backend c10d --rdzv_endpoint localhost:0 \
  --local-ranks-filter 0 --role rank --tee 3 \
-m torchtitan.train --module neuron_qwen3 --config native_qwen3_4bCara 3: Pasang Kernel NKI untuk Arsitektur Mixture of Experts (MoE)
Kalau kamu melatih varian model Mixture of Experts (MoE), operasi routing antarlapisan expert bisa memakan resource komputasi yang boros kalau nggak dioptimalkan. AWS menyediakan resep kernel NKI khusus buat mengelompokkan expert secara efisien.
Berikut contoh script buat menjalankan model varian Qwen3-30B-A3B yang dipangkas menjadi 4 layer dan 64 expert biar muat di dalam satu node trn2.48xlarge:
from torchtitan.config import CompileConfig
from torchtitan_neuron.models.qwen3.config_registry import qwen3_nki_moe_config

def nki_qwen3_30b_a3b() -> Trainer.Config:
    config = qwen3_nki_moe_config(
        "30B-A3B",
        compile_config=CompileConfig(enable=False, backend="neuron"),
        n_layers=4,
        num_experts=64,
        top_k=4,
    )
    config.hf_assets_path = ASSETS
    return config
Eksekusi konfigurasinya lewat baris perintah berikut:
torchrun --nproc_per_node=64 --rdzv_backend c10d --rdzv_endpoint localhost:0 \
  --local-ranks-filter 0 --role rank --tee 3 \
  -m torchtitan.train --module neuron_qwen3 --config nki_qwen3_30b_a3b
Pada resep ini, tiap token diarahkan ke 4 expert (top_k=4). Parameter num_experts=64 menentukan total expert di dalam model, bukan derajat paralelisme expert. Dalam mode eager (CompileConfig(enable=False)), operator NKI tetap bisa jalan mulus di Trainium.
Bikin dan Pasang Custom Kernel NKI Sendiri Lewat Override Registry
Buat kebutuhan optimasi tingkat lanjut, kamu mungkin pengin merancang kernel sendiri yang pas dengan bentuk tensor spesifik. torchtitan punya fitur override registry yang memungkinkan kamu menukar modul PyTorch standar dengan kernel NKI buatanmu tanpa merusak struktur kode utama.
Contoh di bawah ini memanfaatkan rope_hf dari library nkilib.core.embeddings untuk menangani Rotary Position Embedding (RoPE). Bikin file bernama my_neuron_kernels.py:
import torch
from nkilib.core.embeddings.rope_hf import rope_hf
from torch_neuronx import nki_op
from torch_neuronx.nki_hop import wrap_nki
from torch_neuronx.utils import get_logical_neuron_cores
from dataclasses import dataclass
from torchtitan.config import derive, override
from torchtitan.models.common.rope import CosSinRoPE

LNC = (int(get_logical_neuron_cores()),)
wrapped_rope = wrap_nki(rope_hf)

@nki_op("my_kernels::rope_fwd")
def rope_fwd(query, key, rope_cache):
    q = query.permute(0, 2, 1, 3).contiguous()
    k = key.permute(0, 2, 1, 3).contiguous()
    cache = rope_cache.reshape(-1, rope_cache.shape[-1])
    q_out, k_out = wrapped_rope[LNC](
        q, k, torch.empty_like(q), torch.empty_like(k), rope_cache=cache,
    )
    return q_out.permute(0, 2, 1, 3).contiguous(), k_out.permute(0, 2, 1, 3).contiguous()

@nki_op("my_kernels::rope_bwd")
def rope_bwd(grad_query, grad_key, rope_cache):
    gq = grad_query.permute(0, 2, 1, 3).contiguous()
    gk = grad_key.permute(0, 2, 1, 3).contiguous()
    cache = rope_cache.reshape(-1, rope_cache.shape[-1])
    out_q, out_k = wrapped_rope[LNC](
        gq, gk, torch.empty_like(gq), torch.empty_like(gk), rope_cache=cache, backward=True,
    )
    return out_q.permute(0, 2, 1, 3).contiguous(), out_k.permute(0, 2, 1, 3).contiguous()

def _setup_context(ctx, inputs, output):
    ctx.save_for_backward(inputs[2])

def _backward(ctx, grad_query, grad_key):
    (rope_cache,) = ctx.saved_tensors
    grad_q, grad_k = rope_bwd(grad_query, grad_key, rope_cache)
    return grad_q, grad_k, None

rope_fwd.register_autograd(_backward, setup_context=_setup_context)

class NKIRoPE(CosSinRoPE):
    @dataclass(kw_only=True, slots=True)
    class Config(CosSinRoPE.Config):
        pass

    @staticmethod
    def apply_rotary_emb(query, key, rope_cache):
        stride = 128 * LNC[0]
        if query.shape[1] % stride:
            raise ValueError(f"Panjang sequence harus kelipatan {stride}")
        q_out, k_out = rope_fwd(query, key, rope_cache)
        return q_out.type_as(query), k_out.type_as(key)

@override("nki_rope", target=CosSinRoPE.Config, exact=True, description="nkilib rope_hf kernel")
def _nki_rope(cfg: CosSinRoPE.Config) -> NKIRoPE.Config:
    return derive(cfg, NKIRoPE.Config)
Untuk menyematkan kernel kustom ini saat training, tambahkan parameter --override.imports my_neuron_kernels pada perintah peluncuran:
torchrun --nproc_per_node=64 --rdzv_backend c10d --rdzv_endpoint localhost:0 \
  --local-ranks-filter 0 --role rank --tee 3 \
  -m torchtitan.train --module neuron_qwen3 --config native_qwen3_4b \
  --override.imports my_neuron_kernels
Dalam pengujian numerik memakai input float32, perbedaan absolut maksimal antara kernel rope_hf dan implementasi PyTorch bawaan torchtitan tercatat 0,0 untuk query maupun key. Artinya, perhitungannya presisi dan identik.
Cara Mengatur Paralelisme dan Monitor Memori HBM
Pada instance trn2.48xlarge, ada 64 logical NeuronCore yang aktif dengan konfigurasi LNC=2. Nilai config.parallelism.data_parallel_shard_degree = -1 membagi bobot model, gradien, dan optimizer state ke semua rank yang dijalankan oleh torchrun.
Kalau kamu mau melatih model berukuran lebih gede, kamu bisa mengatur config.parallelism.tensor_parallel_degree. Pengaturan ini memecah bobot tiap layer ke sekelompok rank, di mana tiap rank menghitung irisan perkalian matriks secara paralel. Fitur sequence parallelism juga aktif secara default buat membagi beban layer normalisasi.
Pastikan kamu memantau pemakaian High-Bandwidth Memory (HBM) di setiap rank saat menaikkan batch size lokal atau sequence length. HBM inilah yang menentukan apakah alur kerja kamu bakal aman dari risiko Out of Memory (OOM).
Saya sedang merancang pipeline training model LLM di AWS Trainium menggunakan torchtitan. Tolong evaluasi konfigurasi berikut dari aspek pembagian data parallelism, alokasi memori HBM per rank, dan potensi bottleneck saat kompilasi graf Neuron.Dampak Nyata Buat Developer dan Tim AI di Indonesia
Buat praktisi AI dan software engineer di Indonesia, kemudahan training di AWS Trainium membuka alternatif infrastruktur yang menarik banget selain kluster GPU standar. Terutama buat tim yang pengin melakukan adaptasi domain atau fine tuning korpus bahasa Indonesia pada model open weights seperti Qwen3 tanpa terikat dependensi runtime vendor tunggal.
Kalau kamu pengin mengasah skill seputar arsitektur kecerdasan buatan, integrasi model, dan deployment pipeline modern, kelas AI untuk Developer bisa jadi pijakan belajar yang pas buat mendalami alur kerja praktis di industri.
Di sisi lain, kalau tim kamu saat ini cuma butuh akses inferensi instan model seri Qwen tanpa perlu repot menyiapkan cluster training dari nol, kamu bisa langsung nyobain model seperti qwen-3.8-27b (Rp810 input / Rp3.630 output per 1M token) atau model frontier seperti qwen3.8-max (Rp1.950 input / Rp9.720 output per 1M token) lewat Classai Router. Cukup pakai satu API key dengan SDK standar, tanpa tagihan server bulanan.
Sumber & referensi
- 01
AWS · 22 Oktober 2026
Train Qwen3 on AWS Trainium with torchtitan
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apakah AWS Trainium bisa menjalankan kode PyTorch standar tanpa diubah?
Bisa banget, karena paket TorchNeuron mendaftarkan chip Trainium langsung sebagai device native neuron di PyTorch. Kerangka kerja seperti torchtitan bisa mendeteksi akselerator ini secara otomatis dan mengeksekusi operasi standar via eager mode maupun torch.compile.
Berapa kapasitas chip yang tersedia pada instance trn2.48xlarge?
Instance trn2.48xlarge dibekali 16 akselerator Trainium2 yang setara dengan 128 NeuronCore fisik. Pada konfigurasi standar logical core LNC=2, sistem ini menyediakan 64 logical NeuronCore untuk menjalankan proses training paralel.
Bagaimana cara memastikan bobot pre-trained Qwen3 berhasil dimuat saat fine tuning?
Kamu bisa mengecek nilai loss pada langkah pertama training. Pada model Qwen3-4B-Instruct-2507, loss awal berada di angka sekitar 6,54 jika bobot pre-trained sukses terbaca, jauh lebih rendah dibanding inisialisasi acak yang menghasilkan loss 12,43.
Apakah hasil checkpoint dari torchtitan bisa dipakai langsung di Hugging Face?
Bisa langsung dipakai karena torchtitan mendukung penyimpanan checkpoint dalam format safetensors standar Hugging Face. Bobot model bisa langsung dimuat kembali menggunakan fungsi AutoModelForCausalLM tanpa ada parameter yang hilang.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.