TorchNeuron AWS Trainium Rilis: Hugging Face Jadi Makin Gampang
AWS dan Hugging Face ngerilis TorchNeuron, plugin native PyTorch buat chip Trainium. Nggak perlu lagi ribet pakai compiler khusus buat jalanin LLM.
· 7 menit baca
Inti singkat
- TorchNeuron bikin AWS Trainium jadi device native di PyTorch lewat eager execution dan torch.compile.
- Dukungan model generasi teks melonjak dari 46 persen di Optimum Neuron jadi 89 persen.
- Library populer kayak Transformers, Diffusers, Accelerate, PEFT, dan TRL bisa langsung jalan tanpa wrapper rumit.
- Deepgram mencatat efisiensi pemrosesan audio 70 persen lebih banyak per dolar setelah beralih ke Trainium.
- Model yang dilatih di Trainium menghasilkan checkpoint standar Transformers yang bisa dipakai di hardware mana pun.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
Hugging Face dan AWS resmi meluncurkan TorchNeuron buat menghadirkan backend native PyTorch di chip AWS Trainium. Update ini bikin kamu bisa menjalankan model AI open source langsung tanpa wrapper rumit.
Kabar gembira buat kamu yang sering ngerasa pusing ngeliat tagihan GPU cloud yang makin hari makin bikin dompet jebol. Menurut pengumuman resmi Hugging Face, TorchNeuron resmi tersedia dalam versi public beta mulai 20 Oktober 2026. Alat baru ini dirancang bareng tim AWS Annapurna Labs biar ekosistem open source bisa jalan mulus di chip buatan Amazon tanpa drama kompilasi yang bikin pusing kepala.
Langkah ini juga jadi pukulan telak buat dominasi Nvidia. Seperti dilaporkan TechCrunch, sekitar 85 persen aplikasi AI di dunia ditulis pakai PyTorch. Selama bertahun-tahun, Nvidia ngunci developer lewat software CUDA mereka. Nah, lewat TorchNeuron, Amazon pengin memutus ketergantungan itu dengan ngasih opsi hardware yang ramah kantong tapi performanya tetap bertenaga.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu TorchNeuron dan Kenapa Berbeda dari Optimum Neuron?
Sebelum ada TorchNeuron, pengalaman menjalankan model Hugging Face di AWS Trainium maupun Inferentia harus lewat library bernama Optimum Neuron. Library lawas ini mengandalkan package torch-neuronx yang berbasis PyTorch XLA.
Masalahnya, pendekatan lama itu bikin developer harus berpikir kayak mesin compiler. Kamu dipaksa berurusan sama lazy tensor, ukuran input yang serba kaku (static shapes), dan model bakal ngulang kompilasi terus tiap kali ada graph break. Hugging Face harus bikin dan memelihara banyak class kustom buat menambal kerumitan itu.
TorchNeuron ngubah total cara main ini. Alih-alih pakai wrapper terpisah, plugin ini langsung nancep ke dalam PyTorch sebagai backend native. Hasilnya, Trainium sekarang diperlakukan sama persis kayak kartu grafis biasa lewat device bernama neuron.
| Fitur / Kemampuan | Optimum Neuron v0.4.5 | TorchNeuron Baru | Keterangan |
|---|---|---|---|
| Status Device PyTorch | Perlu wrapper custom | Native (device_map="neuron") | Nggak butuh class modifikasi |
| Gaya Eksekusi | Lazy evaluation | Eager execution & torch.compile | Alur debugging jauh lebih natural |
| Dukungan 100 LLM Populer | 46% arsitektur | 89% arsitektur | Langsung jalan out-of-the-box |
| API Terdistribusi | Wrapper custom Neuron | FSDP2, DTensor, TP bawaan PyTorch | Standar komunitas PyTorch |
| Kompatibilitas Library | Optimum-neuron khusus | Transformers, Diffusers, PEFT, TRL | Kode sama persis antardevice |
Menjalankan Inferensi Teks di Transformers Nggak Pakai Ribet
Lompatan paling berasa ada di inferensi model bahasa besar. Kalau sebelumnya cuma 46 persen dari 100 model teks teratas yang bisa jalan mulus, sekarang 89 persen arsitektur langsung didukung secara bawaan.
Kamu cukup manggil parameter device_map="neuron" saat memuat model, persis kayak kamu biasa manggil kartu grafis biasa. Meski begitu, tim Hugging Face tetap ngingetin buat pakai static cache di konfigurasi generasi teks biar sistem nggak kompilasi ulang berkali-kali.
Penasaran gimana kodenya? Ini contoh ngerun model bahasa besar pakai tensor parallelism di chip Trainium:
import os
import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
Kode di atas kelihatan sangat rapi karena hampir semua konfigurasi paralelisme ditangani langsung lewat library Transformers standar, tanpa trik sulap tambahan.
Training Model Pakai TRL dan SFTTrainer di Trainium
Buat urusan training atau fine-tuning, kamu nggak butuh lagi fork khusus atau trainer modifikasi. Skrip standar TRL (Transformer Reinforcement Learning) berbasis SFTTrainer bisa langsung jalan di cluster Trainium.
Paralelisme diatur lewat DistributedConfig. Kamu tinggal nentuin ukuran tensor-parallel (TP) dan Fully Sharded Data Parallel (FSDP). Begitu model dimuat lewat from_pretrained, bobotnya langsung dipecah secara otomatis di grid core Trainium.
import os
import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig
from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser

def main(script_args, training_args, model_args):
    # Matikan dynamic shapes otomatis bawaan Dynamo
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    train_dataset = train_dataset.select_columns(["messages"])

    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()

if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
Buat ngejalanin skrip di atas, tim pengembang nyontohin penggunaan perintah torchrun di 8 chip Trainium2 (total 32 NeuronCores, atau setara setengah instance trn2.48xlarge):
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
  --model_name_or_path Qwen/Qwen3-8B \
  --dataset_name HuggingFaceH4/ultrachat_200k \
  --dataset_train_split train_sft \
  --output_dir Qwen3-8B-sft-tp4-fsdp8 \
  --dtype bfloat16 \
  --max_length 2048 \
  --packing true \
  --packing_strategy wrapped \
  --learning_rate 2e-5 \
  --warmup_steps 0.03 \
  --num_train_epochs 1 \
  --logging_steps 2 \
  --per_device_train_batch_size 4 \
  --gradient_accumulation_steps 4 \
  --save_only_model true \
  --torch_compile true
Kerennya lagi, checkpoint yang disimpan lewat trainer.save_model bener-bener berupa checkpoint standar Transformers. Artinya, kamu bisa langsung upload hasil latihannya ke Hugging Face Hub dan ngerun model itu di mesin GPU mana pun tanpa konversi format.
Diffusers dan Custom Kernel NKI: Gambar Jadi Makin Ngebut
Nggak cuma urusan teks, library Diffusers juga dapet perlakuan istimewa di TorchNeuron. Model generator gambar populer kayak FLUX.1-dev, FLUX.2, Qwen-Image, Qwen-Image-2.1, sampai H3 sekarang kompatibel dengan tensor parallelism di Trainium.
Contohnya, kamu bisa membagi beban pipeline Qwen/Qwen-Image-2.1 ke 8 device mesh Trainium sekaligus. Bagian text encoder tetap bisa dijalankan santai di CPU, sementara bagian model difusinya dieksekusi bareng-bareng di core Trainium.
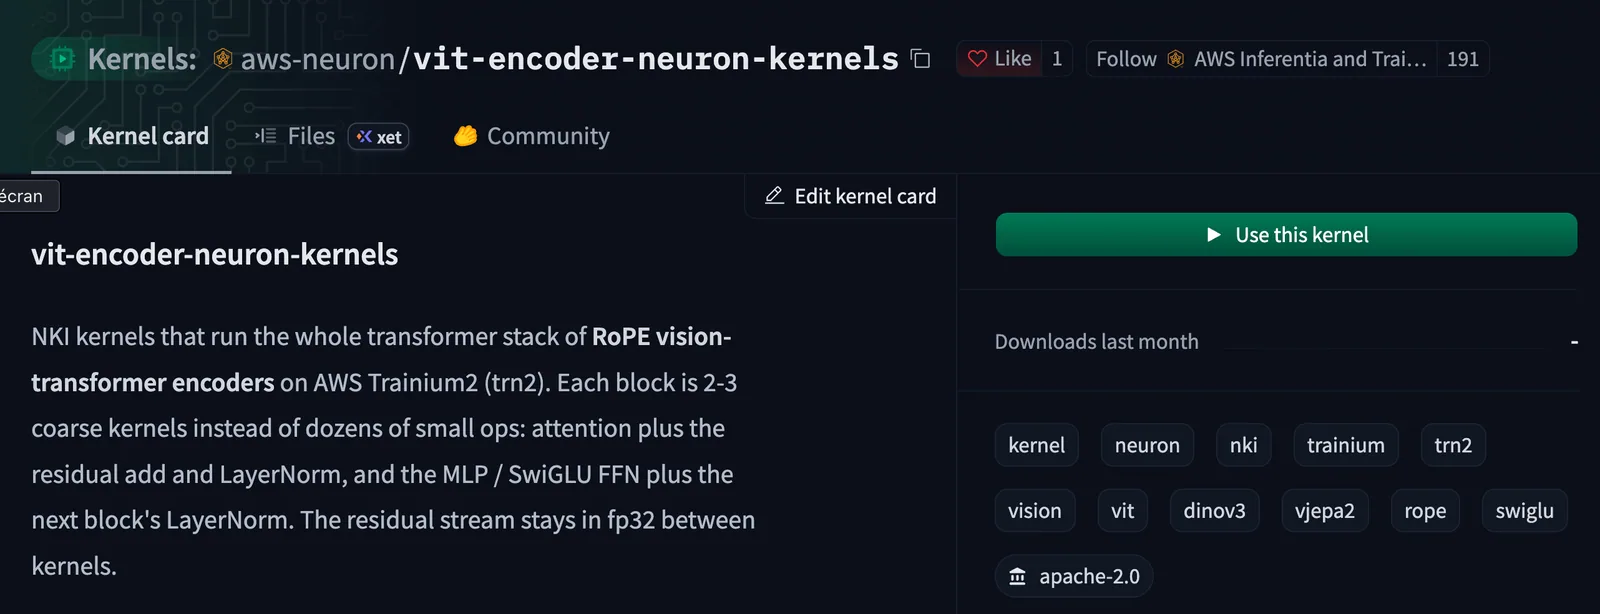
Selain itu, ada dukungan Neuron Kernel Interface (NKI). NKI ngasih kontrol tingkat rendah buat nulis operasi custom yang dioptimalkan khusus buat arsitektur Trainium. Komunitas sekarang bisa membagikan kernel rakitan mereka langsung di Hugging Face Hub. Salah satu kernel yang sudah diuji terbukti ngasih peningkatan kecepatan sampai 2,4 kali lipat pada arsitektur Vision Transformers.
Ambisi Amazon Melepas Keterikatan Ekosistem dari Cengkeraman Nvidia
Langkah AWS bareng Hugging Face ini bukan sekadar urusan teknis library Python biasa. Ini strategi bisnis yang sangat terarah. Menurut Colin Brace, VP of Technology Software di AWS Annapurna Labs, keunggulan Trainium ada di rasio performa terhadap harga sekaligus kenyamanan memakai satu platform terpadu.
Colin Brace ngasih contoh nyata Deepgram, platform AI pemroses suara yang bersaing dengan ElevenLabs. Setelah Deepgram migrasi ke Trainium menggunakan integrasi PyTorch native, mereka sukses memproses 70 persen lebih banyak audio per dolar dengan akurasi kelas produksi yang tetap terjaga.
Lebih dari itu, Amazon mengonfirmasi bahwa mereka bakal menyumbangkan perubahan kode ini langsung ke proyek upstream PyTorch resmi di bawah Linux Foundation. Tujuannya jelas: bikin framework PyTorch jadi bener-bener agnostik terhadap hardware, sehingga developer punya kebebasan milih infrastruktur tanpa terkunci di ekosistem CUDA milik satu vendor tertentu.
Apa Pengaruhnya Buat Tim Developer dan Bisnis di Indonesia?
Buat ekosistem teknologi di Indonesia, perkembangan ini membawa angin segar yang cukup terasa di beberapa aspek operasional:
- Peluang Efisiensi Anggaran Cloud: Banyak startup lokal dan software house di Jakarta atau Bandung yang boncos karena sewa instance GPU berbasis kartu grafis populer sangat mahal dan sering kehabisan kuota region. Hadirnya alternatif Trainium yang kini mudah diprogram bisa jadi opsi penghematan signifikan.
- Kemudahan Porting Kode: Kamu yang sebelumnya membangun arsitektur model open source (seperti yang pernah dibahas di artikel Beam 501B Hugging Face) nggak perlu nulis ulang ribuan baris kode cuma buat nyobain chip AWS.
- Kepatuhan Privasi Data Lokal: Buat perusahaan enterprise atau perbankan yang terikat regulasi UU PDP di Indonesia, melatih atau menjalankan model sendiri di private cloud AWS region Jakarta dengan biaya lebih hemat jadi jauh lebih masuk akal dibanding terus-terusan manggil API publik pihak ketiga.
Kalau tim developer kamu pengin membandingkan performa model bahasa sebelum mutusin investasi sewa server Trainium sendiri, kamu bisa memanfaatkan Classai Router. Lewat Classai Router, kamu bisa nyobain model open source keluarga Qwen seperti qwen-3.8-27b dengan tarif cuma Rp810 per 1 juta token input dan Rp3.630 per 1 juta token output. Cukup ubah satu baris base URL ke router.classai.id/v1, saldo bisa diisi mulai Rp10.000 pakai QRIS tanpa kartu kredit luar negeri.
Buat kamu yang pengin mendalami pipeline AI end-to-end bareng praktisi industri lokal, kamu juga bisa cek modul di kelas AI untuk Developer.
Cara Nyobain TorchNeuron Langkah demi Langkah
Kalau kamu pengin langsung bereksperimen di environment cloud AWS, berikut langkah praktis yang bisa kamu ikuti mulai hari ini:
- Sewa Instance Trainium di AWS: Luncurkan instance keluarga Trainium, misalnya
trn1atau generasi terbarutrn2(sepertitrn2.48xlarge) lewat AWS Management Console. - Pasang Package TorchNeuron: Instal paket resminya langsung lewat pip dengan menjalankan perintah terminal:
bash pip install torch-neuronx - Update Library Hugging Face: Pastikan kamu memakai versi terbaru dari Transformers, Diffusers, TRL, dan Accelerate agar deteksi device
neurondikenali otomatis. - Gunakan Parameter
device_map="neuron": Pada skrip Python inferensi kamu, ganti pemanggilan device CUDA menjadi device Neuron. - Atur Static Caching: Konfigurasikan
GenerationConfigdengancache_implementation="static"dan tentukan nilaimax_cache_lentetap untuk menghindari kompilasi ulang yang memakan waktu.
Kamu adalah senior MLOps engineer. Tolong review arsitektur deployment PyTorch berikut untuk migrasi ke AWS Trainium menggunakan TorchNeuron. Identifikasi potensi bottleneck pada static shapes, cache implementation, dan rekomendasikan konfigurasi tensor parallelism (TP) yang optimal.Sumber & referensi
- 01
Hugging Face · 19 Oktober 2026
TorchNeuron: running HF models on AWS Trainium is easier than ever - 02
TechCrunch · 20 Oktober 2026
Amazon is taking its biggest shot at Nvidia yet with new TorchNeuron dev tool
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu TorchNeuron?
TorchNeuron adalah plugin resmi PyTorch yang menyediakan backend native untuk chip AWS Trainium. Plugin ini memungkinkan eksekusi eager, fitur torch.compile, dan API paralelisme standar tanpa memerlukan wrapper khusus.
Apakah model Hugging Face bisa langsung jalan di AWS Trainium?
Bisa, mulai rilis TorchNeuron beta pada 20 Oktober 2026, library Transformers, Diffusers, dan TRL mengenali Trainium sebagai device native. Sekitar 89 persen arsitektur model teks populer langsung didukung tanpa ubah arsitektur kode.
Apa bedanya TorchNeuron dengan Optimum Neuron terdahulu?
Optimum Neuron bergantung pada PyTorch XLA dengan sifat lazy tensor dan bentuk input kaku yang sering memicu kompilasi ulang. TorchNeuron bekerja secara native di dalam PyTorch dengan eager execution dan pemetaan device yang jauh lebih sederhana.
Bagaimana cara menginstal TorchNeuron?
Kamu bisa langsung menginstalnya di instance AWS Trainium menggunakan perintah pip install torch-neuronx di terminal setelah menyiapkan environment Python yang sesuai.
Apakah hasil training di Trainium bisa dipakai di GPU Nvidia?
Bisa banget. Fungsi trainer di TRL dan Transformers menghasilkan file checkpoint standar yang kompatibel penuh dan bisa langsung diunggah ke Hugging Face Hub untuk dijalankan di hardware mana pun.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.