MPS PyTorch 2.15 Rilis: Mac Makin Kencang Buat AI Lokal
PyTorch 2.15 bawa update gede buat MPS di Apple silicon Mac: format FP8 resmi mendarat, decoding LLM MoE melonjak sampai 6,5x lipat, dan memori video VAE drop drastis.
· 8 menit baca
Inti singkat
- Format FP8 float8_e4m3fn resmi masuk ke MPS PyTorch 2.15 dan memangkas pemakaian memori sampai separuh dibanding BF16.
- Kecepatan decoding model MoE melonjak 5 sampai 6,5 kali lipat di chip Apple silicon berkat kernel Metal native.
- Alokasi memori driver pas decode video VAE Wan2.2 turun drastis dari 270 GiB jadi sisa sekitar 8 GiB aja.
- Softmax kosakata besar sekarang sekitar 8 kali lebih ngebut dan memotong waktu sampling token dari 57 us ke 7 us.
- PyTorch 2.15 di Mac mewajibkan sistem operasi minimal macOS 15 dan Python 3.11 ke atas.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
PyTorch 2.15 resmi ngerilis pembaruan gede buat backend Metal Performance Shaders (MPS), ngebawa format FP8, akselerasi decoding LLM sampai 6,5 kali lipat, dan pemangkasan drastis konsumsi memori di chip Apple silicon. Lewat racikan anyar ini, laptop Mac kamu bakal makin bertenaga buat ngejalanin inferensi maupun training model AI secara lokal tanpa bikin RAM langsung jebol.
Kabar gembira ini dibagikan langsung lewat blog resmi Hugging Face oleh Irakli Salia dan Khushi Agrawal dari tim PyTorch Hugging Face. Buat kamu yang doyan ngoprek model AI di Mac pakai Transformers, Diffusers, atau ComfyUI, rilis 2.15 ini ngasih jawaban konkret buat berbagai kendala lawas. Dulu, ngejalanin model di MPS sering banget nabrak operasi yang belum didukung atau grafik memori yang tiba-tiba bocor. Nah, sekarang banyak jalur komputasi MPSGraph yang diganti pakai kernel Metal khusus biar performanya makin pol.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Aja yang Baru di MPS PyTorch 2.15?
Pas awal 2026 kemarin, ngejalanin model machine learning di Mac sering bikin elus dada. Banyak operasi dasar belum kompatibel, performa gampang anjlok, dan memori suka mendadak bengkak. Tim PyTorch di Hugging Face bareng kontributor komunitas akhirnya turun tangan ngerombak backend MPS langsung ke sumbernya.
Ada deretan fitur keren yang mendarat di rilis 2.15:
- Dukungan FP8 resmi hadir: Tensor
float8_e4m3fnsekarang udah bisa dipakai di Mac, ukurannya cuma setengah dari format BF16. - Decoding MoE 5 sampai 6,5x lebih ngebut: Model Mixture of Experts kayak Qwen3.6-35B-A3B melesat jauh lebih kencang di chip M3 Ultra.
- Waktu per token makin hemat: Lapisan linear satu baris diproses pakai kernel matriks-vektor khusus, plus fungsi softmax kosakata besar sekitar 8x lebih cepat.
- Aljabar linier di GPU makin lengkap: Operasi matriks kompleks kayak faktorisasi LU, triangular solve, sampai invers matriks kecil sekarang langsung beres di GPU.
- Memori render video dipangkas habis: Proses VAE decode pada video model Wan2.2 yang tadinya makan RAM driver sampai 270 GiB, sekarang cuma butuh sekitar 8 GiB.
- Kendali stream langsung dari Python: Fitur
torch.mps.Streamkini terbuka buat umum biar kamu gampang ngatur antrean tugas GPU.
FP8 Mendarat di Mac: Hemat Memori Sampai Setengahnya
Salah satu fitur yang paling bikin developer penasaran adalah hadirnya tipe data torch.float8_e4m3fn. Format FP8 ini cuma butuh satu byte per nilai, alias separuh ukuran penyimpanan yang biasa dipakai BF16 atau FP16. Asyiknya lagi, kamu bisa langsung ngelakuin perkalian matriks pakai fungsi F.scaled_mm yang mendukung penskalaan per-tensor maupun per-baris.
Ini contoh sederhana cara quantize dan perkalian matriks berbobot FP8 langsung di GPU Mac kamu:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
Fitur ini jelas ngebantu banget buat kamu yang mau nyalain model berukuran gede di laptop MacBook Pro tanpa langsung kehabisan unified memory.
Decoding LLM dan Model MoE Jadi Jauh Lebih Gesit
Setiap LLM punya dua babak kerja pas bikin teks: prefill dan decode. Pas masuk babak decode, tiap token baru bakal lewat sebagai satu baris tunggal. Jadinya, perkalian matriks raksasa berubah bentuk jadi perkalian matriks-vektor. Di PyTorch 2.15, lapisan linear dense dan lapisan Mixture of Experts (MoE) dapet jatah optimasi gede-gedean.
Buat lapisan linear, fungsi F.linear sekarang langsung nyambung ke kernel GEMV native Metal tanpa lewat MPSGraph. Kecepatan rata-ratanya naik 1,23 kali lipat di berbagai bentuk layer BF16, dengan efek paling berasa di proyeksi matriks kecil kayak gate layer MoE.
Nah, model MoE sendiri membagi token dalam jumlah beda ke tiap expert. Dulu di versi 2.14, grouped matmul harus nyalin offset kelompok ke CPU dulu baru diproses giliran. Sekarang di PyTorch 2.15, kernel Metal ngebaca offset itu langsung di dalam GPU.
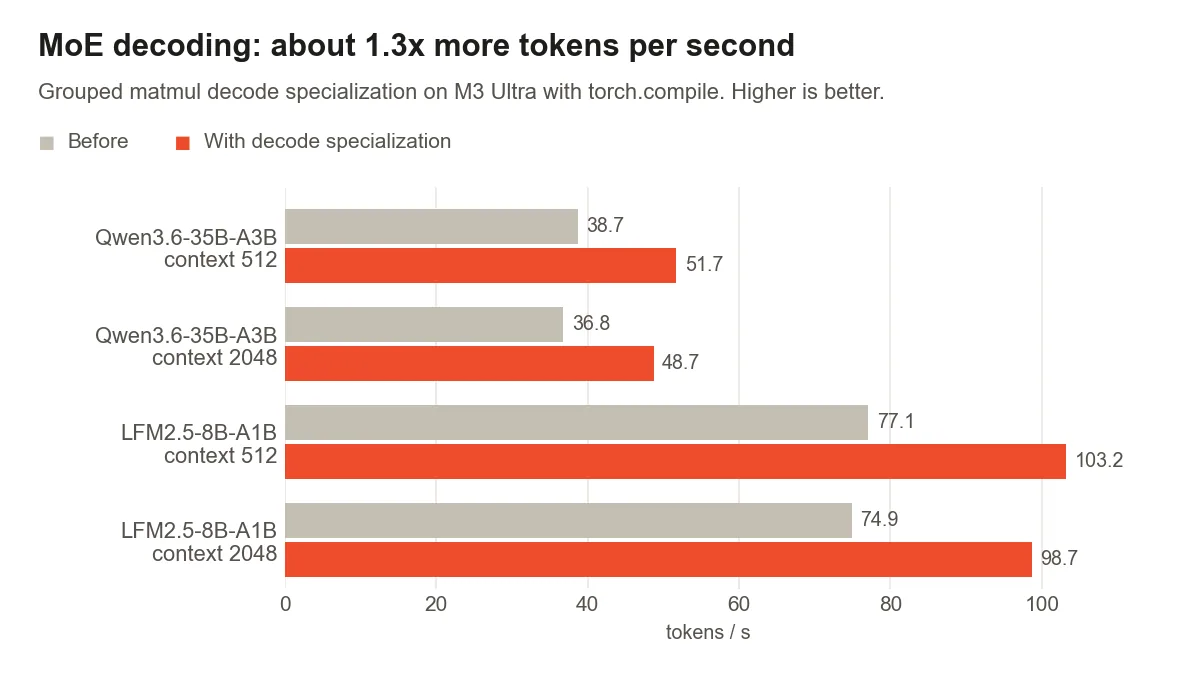
Pas diuji di chip M3 Ultra pakai torch.compile, hasilnya kelihatan beda banget. Model Qwen3.6-35B-A3B melonjak dari 9,4 jadi 61,3 tokens per detik. Sementara model LFM2.5-8B-A1B melesat dari 23,6 jadi 123,6 tokens per detik. Kalau kamu penasaran sama model open source besar berarsitektur serupa kayak di ulasan Beam 501B Hugging Face, racikan hardware yang makin matang begini bikin eksperimen lokal jadi makin masuk akal.
Softmax 8 Kali Lebih Kencang dan Aljabar Linier Lengkap
Bukan cuma urusan bobot model, proses sampling token di ujung generasi teks juga dapet sentuhan baru. Fungsi softmax dan log_softmax sekarang jalan di atas kernel Metal khusus. Dampaknya kerasa banget buat model modern yang punya daftar kosakata raksasa.
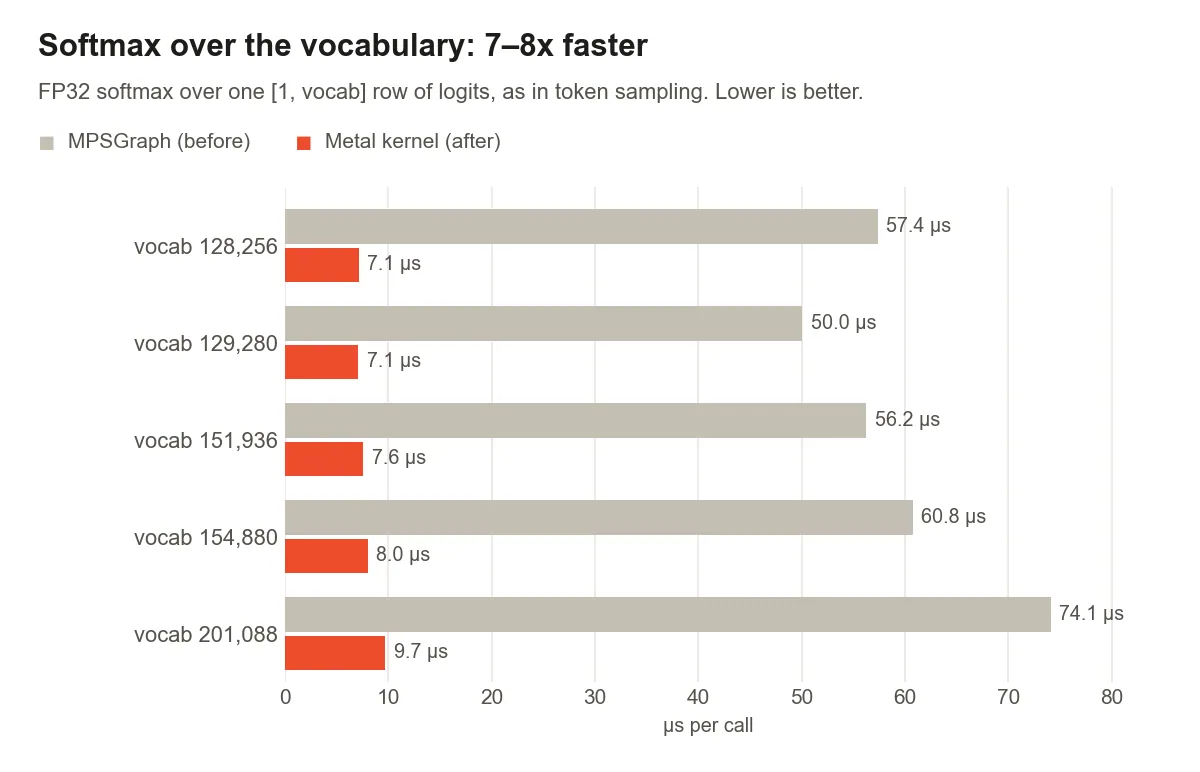
Buat baris logit ukuran [1, 128256], waktu komputasi FP32 softmax turun drastis dari 57 mikrodetik jadi cuma 7 mikrodetik alias sekitar 8 kali lebih ngebut. Jeda waktu pas bikin kata per kata pun jadi makin tipis.
Urusan aljabar linier di GPU Mac juga makin komplet:
- Mendukung faktorisasi LU, LU solve, dan triangular solve buat tipe
complex64. - Invers matriks kecil sampai ukuran 4x4 buat FP32 (berguna banget buat kalkulasi kamera dan olah citra) sekarang diberesin bareng dalam satu kernel Metal.
- Dekomposisi QR sekarang pakai metode blocked updates, dan SVD makin tangguh ngadepin angka-angka ekstrem atau nilai yang kelewat kecil.
Pemakaian Memori Video Turun Drastis dan Bug ComfyUI Tuntas
Salah satu problem yang sering bikin kesel pas generate video AI lokal di Mac adalah aplikasi mendadak mental gara-gara kehabisan memori. Model video kayak Wan2.2 pakai metode tiled VAE decode yang manggil fungsi constant padding ribuan kali.
Di PyTorch 2.14, fungsi padding lewat MPSGraph bikin konsumsi RAM driver membengkak liar. Untungnya di versi 2.15, semua proses padding dipindah ke kernel Metal murni.
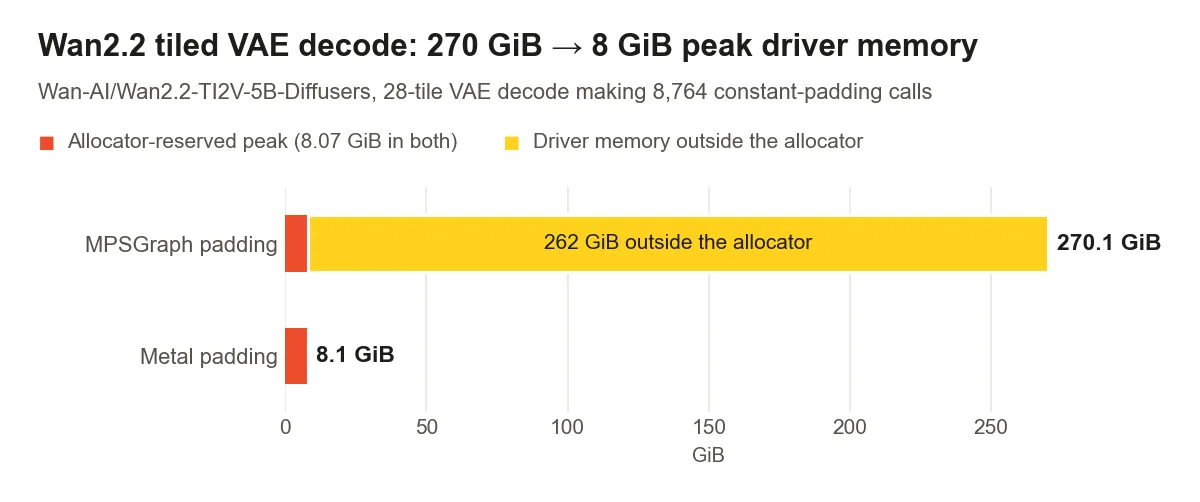
Efek perubahannya kerasa luar biasa kalau kamu cek tabel perbandingannya:
| Metrik Memori | MPSGraph Padding | Metal Padding (PyTorch 2.15) |
|---|---|---|
| Puncak Alokasi Tensor | 4,422 GiB | 4,095 GiB |
| Puncak Dicadangkan Alokator | 8,070 GiB | 8,070 GiB |
| Total Puncak Memori Driver | 270,135 GiB | 8,108 GiB |
Selain urusan video, perbaikan padding ini otomatis ngeberesin kendala visual di ComfyUI. Pada versi 2.14, encoder VAE model Qwen-Image-2.1 sempat bikin gambar editan jadi rusak buram. Di PyTorch 2.15, skor PSNR hasil encode-decode balik normal ke angka 29,95 dB (setara performa CPU), naik jauh dibanding skor sebelumnya yang cuma 10,06 dB.
Kerja audio dan training model juga makin lancar berkat kernel konvolusi 1D khusus, perbaikan backward pada konvolusi channels-last 2D, plus efisiensi dropout out-of-place.
Cara Nyobain PyTorch 2.15 di Mac Kamu
Kamu udah bisa langsung ngejajal versi release candidate ini di environment virtual terpisah biar setup coding kamu yang lain tetap aman.
- Pastikan Mac kamu udah update ke macOS 15 atau lebih baru dan pakai Python 3.11 ke atas.
- Buka aplikasi Terminal, bikin virtual environment baru, lalu pasang PyTorch 2.15 pakai perintah ini:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu- Cek apakah GPU kamu udah kebaca dengan ngetik perintah
torch.backends.mps.is_available(). Kalau perangkat kamu belum cocok, sistem sekarang bakal ngasih tahu detail kendalanya.
Contoh simpel cara pakai antrean MPS stream:
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
Efek Nyata Buat Developer dan Kreator di Indonesia
Peningkatan performa di PyTorch 2.15 ngasih angin segar buat komunitas tech di tanah air:
- Hemat Pengeluaran Cloud Server: Teman-teman mahasiswa, peneliti, atau software engineer lokal bisa ngerjain riset dan fine-tuning model langsung di laptop MacBook tanpa perlu buru-buru sewa GPU cloud luar negeri yang biayanya lumayan nguras kantong.
- Kreator Konten Lebih Nyaman: Komunitas kreator yang rajin pakai ComfyUI di Mac sekarang bisa render video dan bikin variasi gambar tanpa waswas aplikasinya mendadak force close karena kehabisan RAM.
- Bikin Aplikasi AI Privat Tanpa Internet: Startup atau kantor lokal yang wajib ngejaga kerahasiaan data pengguna bisa ngejalanin LLM lokal berkecepatan tinggi buat olah dokumen internal tanpa ada data yang bocor keluar.
Nah, kalau aplikasi yang kamu bikin butuh model cloud bertenaga tanpa ribet setup GPU lokal, kamu bisa coba Classai Router. Cukup pakai satu API key aja, kamu udah bisa nyambung ke aneka model pintar kayak DeepSeek V4.1 Flash (mulai Rp1.155 per 1 juta token input) atau GLM 5.3 (Rp1.875 per 1 juta token input). Bayarnya praktis pakai saldo rupiah lewat QRIS tanpa kartu kredit. Terus kalau kamu mau ngasah skill coding berbasis AI dari dasar sampai mahir, kamu juga bisa gabung di kelas AI untuk Developer.
Bocoran Menarik Buat PyTorch 2.16 Mendatang
Pengembangan backend MPS ternyata masih terus tancap gas. Tim developer udah nyiapin beberapa update lanjutan yang sebagian udah mulai diuji di versi nightly PyTorch 2.16:
- Attention Murni Berbasis Metal: Operasi scaled dot-product attention bakal ninggalin MPSGraph seutuhnya. Di chip M5 Pro, latensi decoding grouped-query attention diklaim turun drastis dari 465 mikrodetik jadi 65 mikrodetik aja.
- Decoding LLM Makin Gesit: GPU bakal langsung ngolah data tiap 16 kernel tanpa nunggu CPU selesai ngerangkai semua instruksi, bikin token rate naik antara 4% sampai 19%.
- Ukuran File Lebih Ramping: Berkas pustaka
libtorch_cpu.dylibmenyusut sekitar 25% dari 384 MiB jadi 287 MiB karena pembagian shader default Metal 3.1 dan Metal 4 yang jauh lebih rapi.
Update berkala ini makin ngebuktiin kalau ekosistem Mac Apple silicon sekarang udah dipandang serius sebagai mesin tempur utama buat riset dan pengembangan AI modern.
Sumber & referensi
- 01
Hugging Face · 20 Oktober 2026
MPS in PyTorch 2.15
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa syarat sistem buat ngejalanin MPS di PyTorch 2.15?
Kamu butuh Mac berchip Apple silicon dengan sistem operasi macOS 15 atau versi lebih baru. Selain itu, instalasi PyTorch 2.15 sekarang mewajibkan lingkungan Python versi 3.11 ke atas.
Kenapa model MoE bisa jalan jauh lebih ngebut di PyTorch 2.15?
Kecepatan melonjak 5 sampai 6,5 kali lipat karena ada kernel grouped matmul bawaan Metal. Kernel ini ngebaca offset kelompok langsung di GPU tanpa perlu bolak-balik sinkronisasi ke CPU kayak versi sebelumnya.
Gimana PyTorch 2.15 ngatasin boros memori pas decode video Wan2.2?
Operasi constant padding dipindahin dari MPSGraph ke kernel Metal murni. Hasilnya, pemakaian puncak memori driver pas decode tiled VAE Wan2.2 langsung anjlok dari 270 GiB jadi sisa sekitar 8 GiB aja.
Apakah format FP8 di MPS PyTorch 2.15 udah bisa dipakai perkalian matriks?
Bisa banget, tensor FP8 float8_e4m3fn di MPS udah bisa dikalikan langsung di GPU pakai fungsi F.scaled_mm. Fungsi ini ngedukung metode scaling tensorwise maupun rowwise dengan hasil presisi BF16.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.