Beam 501B Hugging Face Rilis: Model Coding MoE 1M Konteks Apache 2.0
Lab Reflection ngerilis Beam 501B di Hugging Face. Mengusung arsitektur MoE, context 1 juta token, dan lisensi Apache 2.0, model ini dibuat khusus untuk coding agent.
· 10 menit baca
Inti singkat
- Reflection merilis Beam 501B di Hugging Face dengan lisensi Apache 2.0 dan 23B parameter aktif per token.
- Model ini punya context window sampai 1 juta token dengan arsitektur hybrid attention yang hemat memori.
- Tersedia checkpoint format BF16, FP8, dan NVFP4 dengan dukungan langsung di transformers, vLLM, dan SGLang.
- Beam dilengkapi tokenizer khusus yang memisahkan proses reasoning, jawaban, dan pemanggilan tool secara otomatis.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Reflection bersama Hugging Face resmi ngerilis Beam, model bahasa 501 miliar parameter (501B) berarsitektur Mixture-of-Experts (MoE) dengan lisensi Apache 2.0. Model ini dirancang khusus buat kebutuhan coding dan tugas agentic dengan context window mencapai 1 juta token.
Kabar gembira nih buat kamu yang butuh model frontier tanpa takut terikat ekosistem tertutup. Menurut pengumuman resmi di Hugging Face, lab baru asal Amerika Serikat bernama Reflection resmi meluncurkan Beam. Model ini ngasih kebebasan penuh buat kamu simpan, sesuaikan (customize), dan jalankan di server lokal maupun cloud sendiri.
Peluncuran ini juga didukung penuh di ekosistem AWS seperti diulas AWS Machine Learning Blog, di mana kamu bisa langsung menjalankan Beam lewat SageMaker JumpStart dan SageMaker HyperPod Inference. Yuk kita bedah arsitektur, hasil uji benchmark, sampai cara menjalankannya.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu Beam 501B dan Arsitektur MoE di Dalamnya?
Beam adalah model khusus teks yang dibangun buat penalaran berkonteks panjang (long-context reasoning) dan eksekusi tugas AI agent. Walaupun total parameternya mencapai 501 miliar, Beam memakai pendekatan sparse Mixture-of-Experts (MoE). Tiap token cuma dihitung oleh sebagian kecil jaringan, tepatnya sekitar 23 miliar (23B) parameter aktif. Hasilnya, kapasitas pengetahuannya sebesar model 501B, tapi larinya sekencang model 23B.
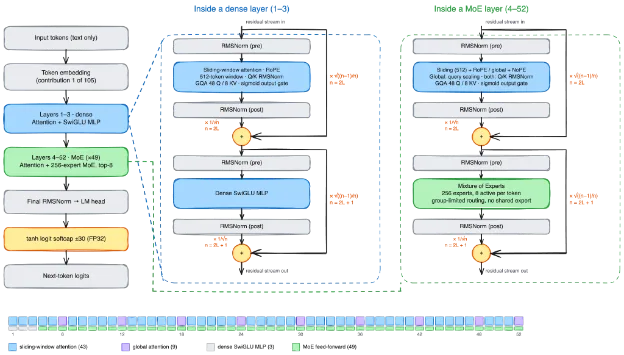
Secara teknis, dekoder Beam terdiri dari 52 layer dengan hidden size 5.120. Tiga layer awal memakai dense SwiGLU MLP biasa. Sebanyak 49 layer berikutnya memakai blok MoE yang masing-masing punya 256 expert. Setiap expert adalah SwiGLU MLP berukuran intermediate 2.560 (sekitar 39 juta parameter). Komponen expert ini memegang 98,4% dari total seluruh parameter model.
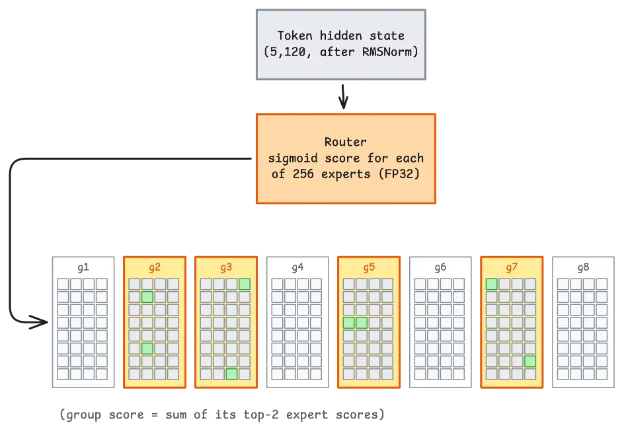
Router Beam mengikuti skema group-limited yang mirip DeepSeek-V3. Mekanismenya: semua 256 expert dinilai memakai fungsi sigmoid, dibagi ke dalam 8 grup berisi masing-masing 32 expert, dipilih 4 grup teratas, lalu diambil 8 expert terbaik di dalamnya tanpa shared expert. Bobot expert dikombinasikan secara normal dan dikalikan skalar 2,5. Karena seluruh 256 expert tetap diam di memori VRAM, kamu butuh kapasitas memori sebesar model 501B meski kecepatannya setara model 23B.
Bagian residual stream Beam juga unik banget. Kalau transformer biasa menambahkan output tiap sublayer dengan bobot 1 sehingga nilainya terus membesar, Beam memakai bobot 1/sqrt(k) dan mempertahankan stream lama dengan bobot sqrt((k-1)/k). Setelah 104 penambahan, skala nilainya tetap stabil dari layer pertama sampai terakhir.
Rahasia Attention dan Context Window 1 Juta Token
Menangani konteks sampai 1 juta token biasanya bikin memori KV cache jebol. Supaya tetap efisien, Beam mengombinasikan dua jenis attention dalam struktur hybrid.
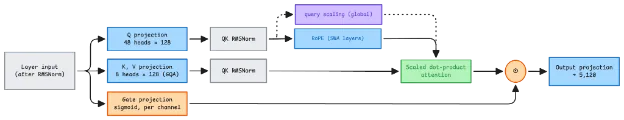
Dari total 52 layer, sebanyak 43 layer memakai sliding-window attention yang cuma mengingat 512 token ke belakang dengan RoPE (Rotary Position Embedding). Sementara itu, 9 layer lainnya (setiap kelipatan 6 layer dan layer paling akhir) memantau seluruh konteks secara global tanpa RoPE. Gantinya, layer global memakai scalable-softmax query scaling dengan rumus (1 + (pos + 1) / 2048) ** 0.1 agar ketelitian softmax nggak memudar saat membaca teks super panjang.
Kombinasi ini memangkas konsumsi cache secara drastis, seperti terlihat pada perbandingan per sekuens dalam format BF16 berikut:
| Panjang Konteks | Jika 52 Layer Global Penuh | Desain Hybrid Beam | Ruang Memori Terhemat |
|---|---|---|---|
| 32K token | 6,5 GiB | 1,2 GiB | ~81% |
| 128K token | 26 GiB | 4,6 GiB | ~82% |
| 1M token (Full) | 208 GiB | 36,08 GiB | ~82% |
Cache KV Beam cuma bertambah sekitar 36 KiB per token. Angka ini kira-kira seperenam dari kebutuhan model transformer standar yang biasanya menyedot 208 KiB per token.
Skor Benchmark: Seberapa Jago Beam untuk Coding dan Reasoning?
Tim Reflection menguji performa Beam pada tiga varian checkpoint: BF16 tanpa kompresi, FP8 buat GPU Hopper, dan NVFP4 buat arsitektur Blackwell. Hasilnya menunjukkan kestabilan tinggi untuk pemecahan masalah kode, matematika kompleks, dan pemanggilan tools.
Berikut rincian hasil benchmark resmi yang dipublikasikan:
| Kategori Pengujian | Tolok Ukur (Benchmark) | Beam BF16 | Beam FP8 | Beam NVFP4 |
|---|---|---|---|---|
| Agentic Coding / Terminal | SWEBench Verified | 81,6% | 80,2% | 80,7% |
| SWE Bench Pro v2-Hard | 76,5% | 78,4% | 78,6% | |
| Terminal Bench v2.1 | 80,1% | 78,9% | 78,2% | |
| SWEBench Multilingual | 78,3% | 78,1% | 77,5% | |
| SWE Bench Pro v1 | 66,1% | 65,9% | 65,6% | |
| DeepSWE v1.1 | 43,3% | 43,0% | 42,7% | |
| SWE Atlas Codebase QnA | 31,8% | 32,2% | 31,4% | |
| Reasoning | AIME 2026 | 97,7% | 98,0% | 97,5% |
| GPQA Diamond | 90,6% | 90,3% | 89,3% | |
| LiveCodeBench | 88,3% | 88,1% | 87,4% | |
| SciCode | 49,2% | 48,3% | 46,9% | |
| HLE (dengan tools) | 51,1% | 51,1% | 51,1% | |
| HLE (tanpa tools) | 36,0% | 36,0% | 34,8% | |
| Tool Calling / Search | MCP Atlas | 80,8% | 81,5% | 80,5% |
| DeepSearchQA w/ context | 80,5% | 79,6% | 81,1% | |
| BrowseComp w/ context | 76,8% | 76,7% | 75,6% | |
| AutomationBench (public) | 39,3% | 38,2% | 39,8% | |
| Tau3 Banking | 36,1% | 36,8% | 35,4% | |
| General Capabilities | IFBench | 79,6% | 80,7% | 79,2% |
| AA-LCR | 78,2% | 79,4% | 78,7% | |
| LongBench v2 | 67,5% | 67,6% | 67,2% | |
| AA Omniscience (index) | 10,8 | 8,8 | 9,8 |
Skor SWEBench Verified yang menembus 81,6% dan AIME 2026 di angka 97,7% membuktikan kemampuan penalaran kode model ini berada di jajaran atas model AI saat ini.
Kebutuhan Hardware untuk Menjalankan Beam 501B
Mengingat bobotnya yang masif, checkpoint BF16 Beam butuh penyimpanan safetensors sekitar 1 TB. Opsi paling praktis buat kebutuhan produksi adalah memakai checkpoint NVFP4 yang memangkas ukuran model jadi sekitar 280 GB.
Format NVFP4 berjalan secara native di chip GPU NVIDIA Blackwell (seperti B200 atau B300). Dua GPU B200 (masing-masing 180 GB HBM3e) sebenarnya sanggup memuat bobot model sebesar 360 GB, tapi sisa memorinya mepet banget buat aktivasi dan cache KV. Konfigurasi yang direkomendasikan adalah memakai empat unit B200 (total 720 GB VRAM), dua unit B300 (masing-masing 288 GB), atau delapan unit RTX Pro 6000.
Buat infrastruktur berbasis GPU Hopper seperti NVIDIA H200 (141 GB), format FP8 adalah opsi terbaik. Kamu bisa memakai node dengan 8 unit H200 untuk kebutuhan inferensi cepat.
Cara Mencoba dan Menjalankan Beam 501B
Kamu bisa langsung mencoba Beam lewat beberapa cara yang sudah didukung sejak hari pertama rilis:
1. Menjalankan via Transformers
Pasang dulu pustaka transformers versi terbaru dengan perintah pip install -U "transformers>=5.20.1". Cara paling simpel adalah memakai pipeline teks:
from transformers import pipeline

pipe = pipeline(
    "text-generation",
    model="reflection/Beam-1.0-501B-A23B",
    device_map="auto"
)

messages = [{"role": "user", "content": "Buat fungsi Python untuk membaca file CSV besar."}]
output = pipe(messages, max_new_tokens=2000)
print(output[0]["generated_text"][-1])
Kamu juga bisa memakai fungsi parse_response bawaan tokenizer Beam. Tokenizer ini langsung memisahkan teks penalaran (reasoning), jawaban final, dan panggilan tool tanpa perlu bantuan regex tambahan.
2. Serving dengan vLLM dan SGLang
Buat kebutuhan API mandiri, kamu bisa menjalankan server vLLM dengan dukungan speculative decoding DFlash2 pada cluster 16 GPU H200:
vllm serve reflection/Beam-1.0-501B-A23B \
  --tensor-parallel-size 16 \
  --speculative-config '{ "method": "dflash", "model": "reflection/dflash2-drafter-preview", "num_speculative_tokens": 15 }'
Untuk SGLang pada GPU Hopper FP8, perintahnya:
python -m sglang.launch_server \
  --model-path reflection/Beam-1.0-501B-A23B-FP8 \
  --served-model-name beam \
  --tp 8 \
  --attention-backend fa3 \
  --page-size 64 \
  --context-length 1048576 \
  --mem-fraction-static 0.85 \
  --enable-unified-memory \
  --speculative-algorithm DFLASH \
  --speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
  --speculative-dflash-block-size 8 \
  --tool-call-parser beam --reasoning-parser beam \
  --host 0.0.0.0 --port 30000
3. Memakai Serverless Inference Providers dan Cloud AWS
Kalau belum punya server sendiri, kamu bisa memakai Hugging Face Inference Providers (didukung Baseten, Fireworks, dan Together) memakai SDK OpenAI:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="reflection/Beam-1.0-501B-A23B:auto",
    messages=[{"role": "user", "content": "Jelaskan cara kerja MoE pada Beam!"}],
)
print(completion.choices[0].message.content)
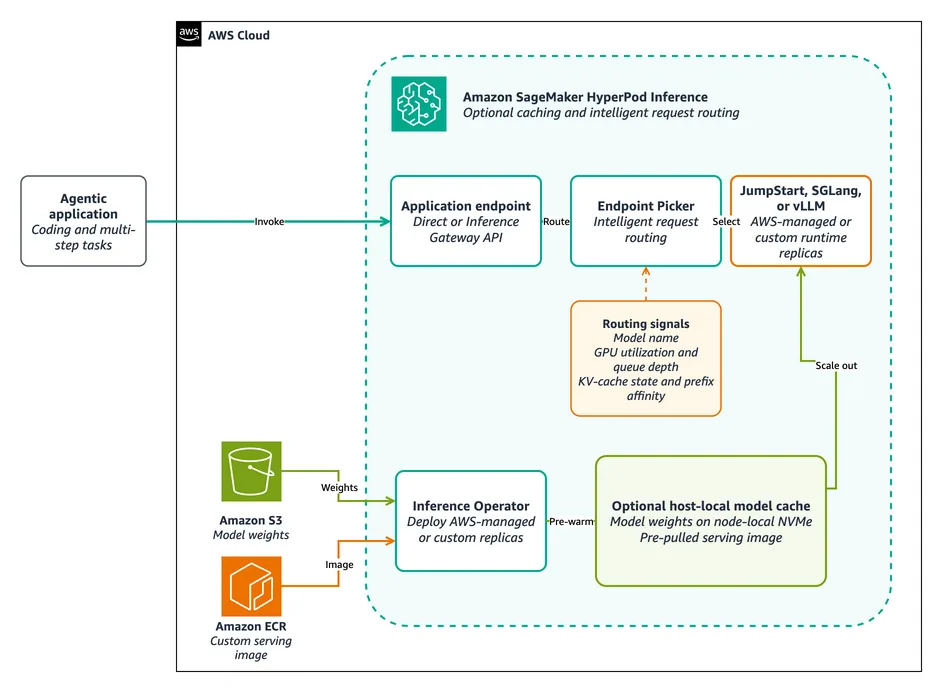
Pengguna AWS bisa memakai SageMaker JumpStart di region US East (N. Virginia dan Ohio), atau memanfaatkan arsitektur terdistribusi lewat Amazon SageMaker HyperPod Inference.
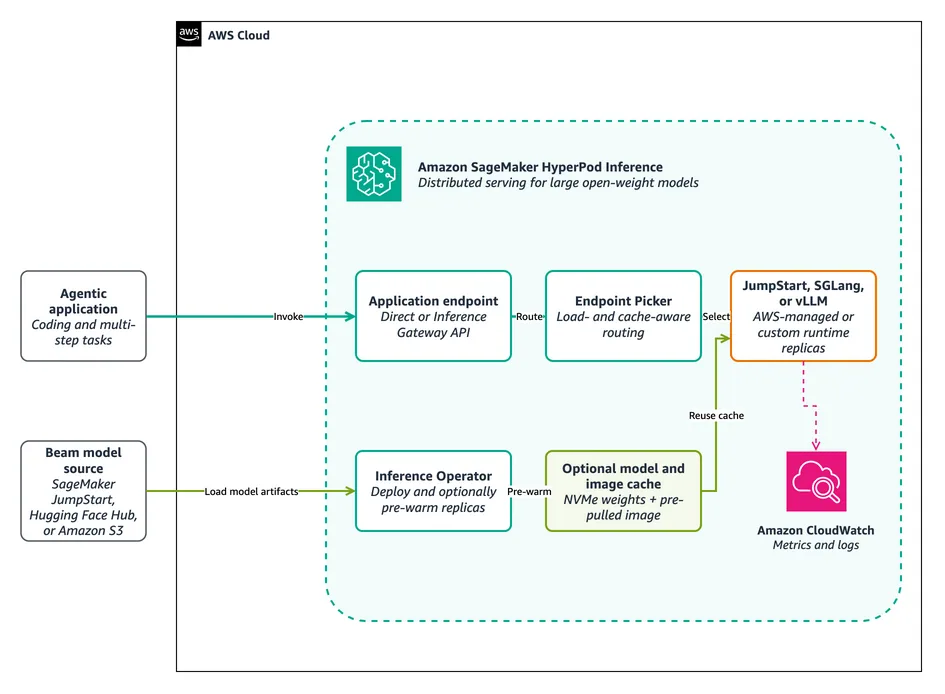
Alur HyperPod memungkinkan pengelolaan replika JumpStart, SGLang, atau vLLM melalui Inference Gateway dan penyeimbang beban tingkat lanjut.
Post-Training: Fine-Tuning LoRA dan RL GRPO di Beam
Keunggulan model dengan bobot terbuka adalah fleksibilitas pelatihannya. Reflection dan Hugging Face menyediakan resep post-training untuk kebutuhan spesifik:
Supervised Fine-Tuning (SFT) dengan TRL
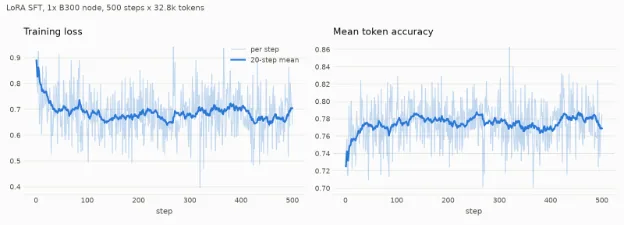
Memakai pustaka TRL dan PEFT, kamu bisa melatih adapter LoRA tanpa harus mengubah seluruh 501B parameter. Pada uji coba resmi dengan dataset Multilingual-Thinking di satu node 8 GPU B300, kecepatan pelatihan mencapai sekitar 19.000 token per detik. Kemampuan bernalar dalam bahasa yang diminta meningkat tajam dari 3/16 menjadi 16/16 prompt pengujian.
Reinforcement Learning (GRPO) dengan Miles
Reflection dan RadixArk merilis resep GRPO (Group Relative Policy Optimization) berbasis pustaka Miles dalam format BF16 menggunakan dataset DAPO-Math-17K. Kamu bisa memilih mode full-parameter (butuh 96 GPU H200: 64 train, 32 rollout) atau mode LoRA GRPO yang cuma butuh 32 GPU H200 (16 train, 16 rollout).
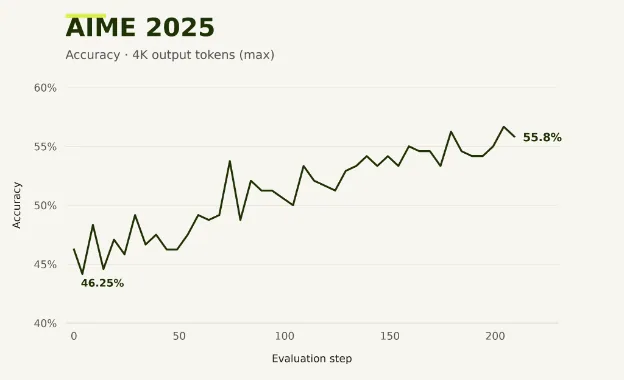
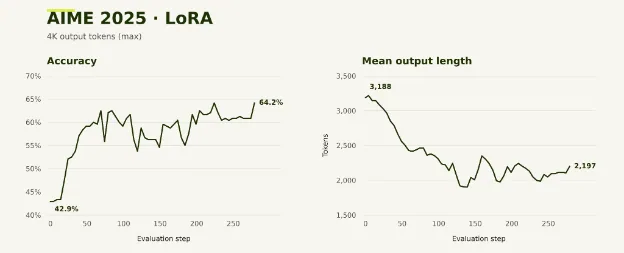
Selain itu, ada pula metode async GRPO dengan LoRA yang dapat dijalankan melintasi pekerjaan Hugging Face Jobs tanpa ketergantungan NCCL.
Demo Proyek Nyata yang Dibangun dengan Beam
Untuk membuktikan kebolehannya, Hugging Face membagikan beberapa proyek nyata yang dibuat memakai agen Beam:
- Aplikasi Native macOS (BeamSpeak): Beam dipasangkan dengan harness koding Pi untuk membuat aplikasi menu bar Mac lokal yang mentranskripsi suara ke teks menggunakan MLX dan model Parakeet.
-
Kolaborasi Multi-Agent: Beam diuji pada benchmark ProgramBench untuk membandingkan tiga metode: satu agent tunggal, lima agent kolaboratif via Git bersama, dan lead agent yang membagi pekerjaan ke sub-agent secara asinkron.
-
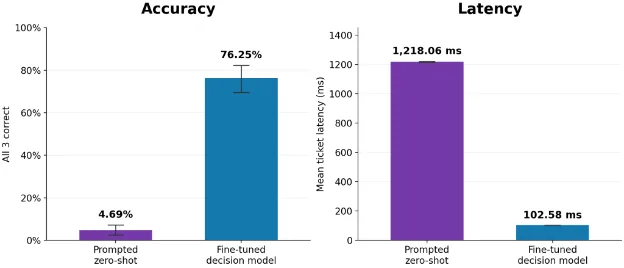
Melatih Model Keputusan Kecil: Agen koding Beam dipakai membuat dataset sintetis 2.300 insiden dan melatih model Qwen3.5-0.8B menggunakan Unsloth. Model kecil hasil pelatihan ini mencapai akurasi triage 76,25% (naik dari 4,69% pada zero-shot) dan memangkas latensi dari 1.218 ms jadi 102,58 ms (11,9 kali lebih ngebut).
Reflection juga mengadakan sayembara berhadiah $10.000 kredit Hub buat siapa pun yang membangun demo di Spaces, membuat dataset sintetis, atau membagikan hasil quantize Beam di Hugging Face.
Kalau kamu mau mencoba gaya prompt coding tingkat arsitek yang dipakai pada pengujian agen, kamu bisa menyalin contoh berikut:
Buatlah service background Python berbasis asyncio yang membaca antrean data Redis Stream.Pastikan service memiliki mekanisme:1. Consumer group dengan auto-acknowledgment yang aman.2. Graceful shutdown saat menerima sinyal SIGINT dan SIGTERM.3. Dead-letter queue sederhana untuk pesan yang gagal diproses sebanyak 3 kali.Tulis kode lengkap beserta langkah pengujian lokalnya.
Efek Kehadiran Beam 501B untuk Developer di Indonesia
Bagi para developer dan pegiat software di Indonesia, rilis Beam 501B ngasih dampak yang lumayan kerasa di beberapa aspek:
- Keamanan Data dan Kepatuhan Regulasi: Perusahaan fintech, perbankan, dan e-commerce di Indonesia yang terikat aturan perlindungan data pribadi (UU PDP) kini punya opsi model frontier berlisensi Apache 2.0 yang bisa di-host penuh di server internal tanpa mengirim kode rahasia ke luar negeri.
- Adaptasi Bahasa Lokal: Berkat resep LoRA SFT yang efisien, tim developer lokal bisa melatih adapter khusus untuk memahami basis kode lama, dokumentasi sistem pemerintahan, atau istilah bisnis Indonesia dengan biaya komputasi yang jauh lebih terjangkau.
- Karier Pengembang AI Agent: Kemampuan mengintegrasikan model MoE besar dengan harness agentic dan tools external menjadi salah satu skill paling dicari saat ini. Kamu bisa mendalami fondasi implementasinya di kelas AI untuk Developer.
- Pilihan Praktis Lewat API: Buat kamu yang belum memiliki cluster server GPU multi-node, kamu bisa memanfaatkan model penalaran dan coding berkualitas lewat Classai Router. Tersedia model seperti DeepSeek V4.1 Flash dengan biaya Rp1.155 (input) dan Rp4.200 (output) per 1 juta token, serta model tangguh lainnya seperti Kimi K3 (Rp2.925 / Rp14.580) atau Grok 4.7 (Rp2.205 / Rp9.000) yang bisa kamu coba langsung tanpa kartu kredit luar negeri.
Kamu juga bisa membaca ulasan model coding lokal lainnya pada artikel panduan /developer/muse-spark-open-meta-coding-mac untuk memperluas pilihan perangkat kerjamu.
Sumber & referensi
- 01
Hugging Face · 16 Oktober 2026
Welcome Beam: a 501B open model you can own, customize, and scale - 02
AWS · 16 Oktober 2026
Introducing Reflection Beam: an open-weight model for agentic coding on AWS
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu Beam 501B di Hugging Face?
Beam 501B adalah model AI berbasis Mixture-of-Experts (MoE) yang dirilis oleh Reflection di Hugging Face. Model ini memiliki total 501 miliar parameter dengan 23 miliar parameter aktif per token, context window 1 juta token, dan dirilis dengan lisensi Apache 2.0.
Berapa kapasitas context window yang dimiliki model Beam?
Beam memiliki context window hingga 1 juta token. Model ini menggunakan arsitektur hybrid attention yang memadukan 43 sliding-window layer dan 9 global layer, sehingga kebutuhan KV cache bisa ditekan hingga sekitar 36 KiB per token.
Hardware apa yang dibutuhkan untuk menjalankan Beam 501B?
Dalam format NVFP4 terkompresi (sekitar 280 GB), Beam disarankan berjalan pada 4 GPU NVIDIA B200 atau 2 GPU B300. Untuk format FP8 pada GPU generasi Hopper, kamu membutuhkan node dengan 8 atau 16 GPU NVIDIA H200.
Apakah Beam 501B bisa dicoba tanpa server GPU sendiri?
Bisa, kamu bisa mengaksesnya lewat Hugging Face Inference Providers yang ditenagai Baseten, Fireworks, dan Together, atau menjalankannya secara terkelola melalui Amazon SageMaker JumpStart di cloud AWS.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.