Meta Rilis Muse Spark Open: Model Coding AI Raksasa yang Bisa Jalan di Mac
Meta baru aja ngerilis Muse Spark Open, model open-weight raksasa 816B dengan multimodal audio visual dan context window 1M token yang dioptimalkan buat ngoding.
· 11 menit baca
Inti singkat
- Meta merilis Muse Spark Open dengan total 816 miliar parameter MoE dan 42 miliar parameter aktif per token.
- Mendukung multimodal lengkap mencakup teks, gambar, audio, dan video dengan context window hingga 1 juta token.
- Bisa dijalankan di Mac bertenaga Apple Silicon memakai MLX atau llama.cpp serta cloud lewat AWS SageMaker JumpStart.
- Fokus utama dirancang untuk agentic coding seperti refactoring multi-berkas, perbaikan bug, dan kontrol browser otomatis.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Meta resmi merilis Muse Spark Open, model open-weight multimodal berbasis Mixture-of-Experts (MoE) dengan total 816 miliar parameter yang dirancang khusus untuk agentic coding dan tugas komputasi panjang. Peluncuran model raksasa ini diumumkan langsung melalui laporan teknis Hugging Face serta mendapat sorotan hangat dari media teknologi global seperti TechCrunch dan The Verge.
Kabar ini menarik banget buat kalangan developer dan pegiat kecerdasan buatan sumber terbuka. Soalnya, model open-weight kelas frontier ini nggak cuma piawai membaca teks dan memprogram kode, tapi juga bisa langsung memproses gambar, audio rekaman suara, sampai video klip dalam satu kesatuan antarmuka kerja. Menariknya lagi, Meta bekerja sama bareng Apple supaya model raksasa ini bisa diuji coba langsung di perangkat desktop Mac tingkat lanjut, di samping ketersediaannya di platform cloud seperti AWS.
Penasaran seperti apa jeroan arsitekturnya, seberapa berat kebutuhan memorinya, dan gimana cara nyobainnya? Yuk, kita bedah tuntas.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu Muse Spark Open dan Arsitektur MoE 816B Miliknya?
Secara teknis, Muse Spark Open adalah model ukuran penuh dari keluarga seri Muse, menyusul model padat berukuran kecil Muse Glimmer yang dirilis Agustus sebelumnya. Kalau Muse Glimmer memakai jaringan dense standar, Muse Spark Open menggantinya dengan blok Mixture-of-Experts (MoE) berskala masif.
Model ini mengantongi total sekitar 816 miliar parameter, namun hanya menjalankan sekitar 42 miliar parameter aktif untuk memproses setiap token input. Dari 62 layer bahasa yang dimilikinya, masing-masing lapisan MoE dibekali 256 unit pakar (experts), dan sistem router cerdas bakal memilih 8 pakar paling relevan per token. Sekitar 97% parameter keseluruhan model memang tersimpan rapi di dalam barisan pakar tersebut.
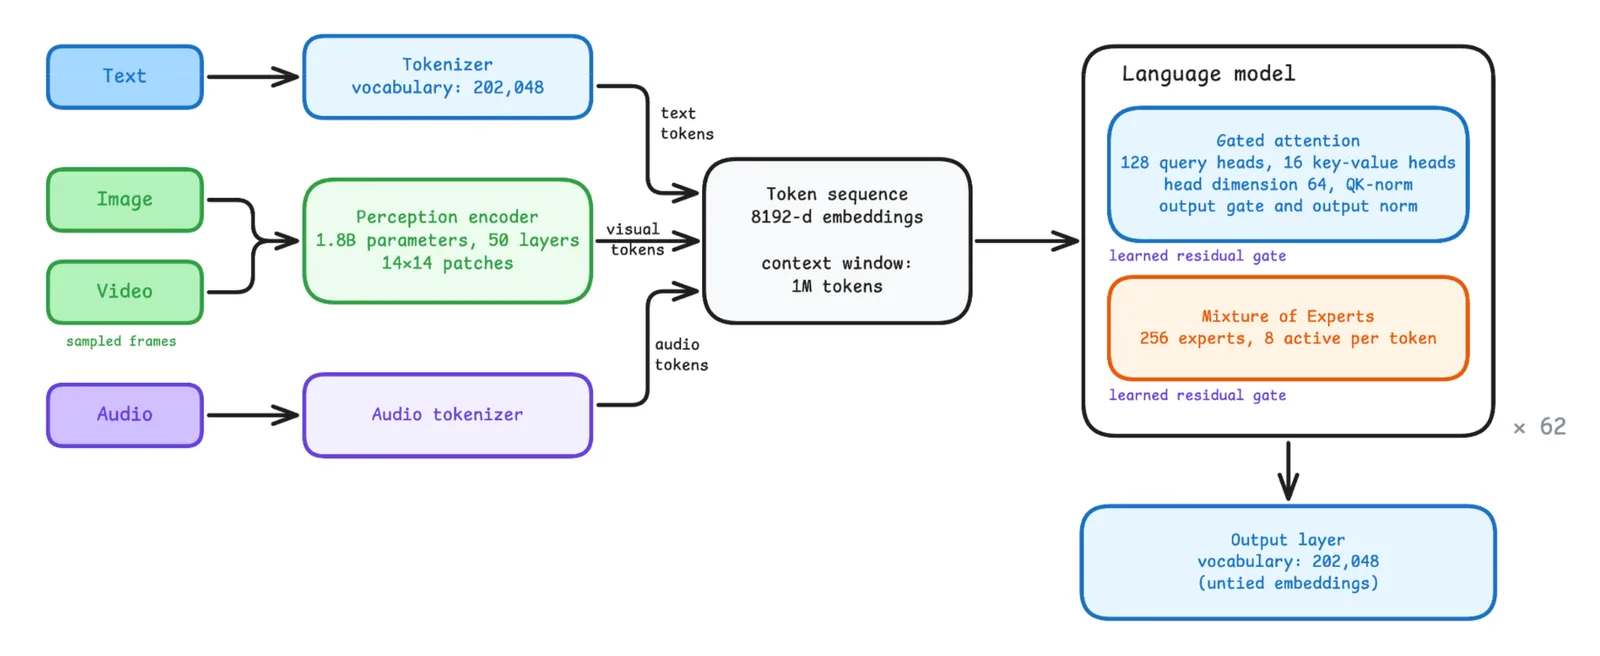
Karena cuma 8 pakar yang aktif dalam satu waktu kalkulasi, kecepatan inferensi per tokennya setara dengan model berbobot 42B. Kendati begitu, seluruh 256 pakar mesti tetap dimuat ke memori perangkat. Untuk bobot standar BF16, ukurannya mencapai kisaran 1,5 TB dalam format safetensors. Tersedia juga format kuantisasi NVFP4 4-bit yang dirancang khusus bagi GPU NVIDIA Blackwell dengan penurunan akurasi yang amat minim.
| Spesifikasi Kunci | Rincian Teknis Muse Spark Open |
|---|---|
| Ukuran Model | ~816B total parameter (~42B aktif per token) |
| Perutean Pakar | 256 pakar per layer MoE (8 pakar terpilih per token) |
| Input yang Didukung | Teks, gambar, audio, dan video |
| Format Output | Teks |
| Context Window | Hingga 1.048.576 token (1M token) |
| Format Bobot Checkpoint | BF16 dan NVFP4 |
| Lisensi | Muse Model License (termasuk Muse Spark Usage Policy) |
Dukungan Multimodal: Gambar, Audio, dan Video 1 Juta Token
Kekuatan utama Muse Spark Open terletak pada integrasi persepsi multimoda yang mulus ke dalam ruang konteks hingga 1 juta token (1.048.576 token). Di dalam satu sesi percakapan raksasa, kamu bisa memasukkan riwayat kode ribuan baris barengan dengan tangkapan layar antarmuka aplikasi, pesan suara instruksi klien, hingga rekaman alur kesalahan (screen recording).
Encoder Gambar dan Video
Untuk mengolah data visual, model ini mengandalkan encoder persepsi sebesar 1,8 miliar parameter dengan 50 lapisan transformer. Gambar dipecah menjadi petak-petak ukuran 14×14 dan menghasilkan representasi berdimensi 4096. Posisi gambar ditandai lewat gabungan embedding absolut dan 2D RoPE.
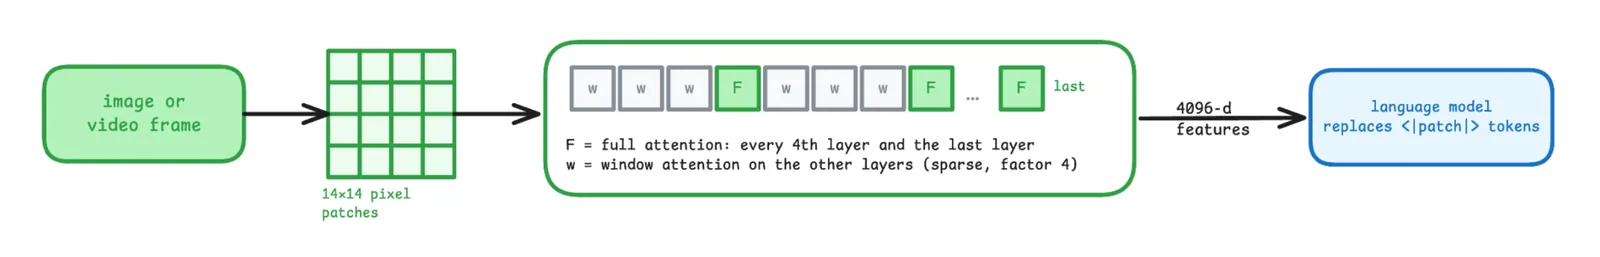
Menariknya, input video memakai encoder yang persis sama dengan gambar. Secara default, video diproses pada kecepatan 2 frame per detik (FPS) hingga maksimal 96 frame, diselingi teks penanda waktu seperti Time: 3.5s. Bila dibutuhkan detail gerakan yang lebih presisi, developer bisa menaikkan rasio FPS, meski konsekuensinya butuh memori prefill yang lebih lega.
Encoder Audio dan Penalaran Suara
Untuk audio, Muse Spark Open menerima gelombang mentah (mono pada frekuensi 24 kHz). Encoder audio berbasis piramida konvolusional ini memproduksi satu token audio setiap 80 milidetik, alias menghasilkan 12,5 token per detik rekaman suara. Jadi semisal kamu mengirimkan instruksi suara 10 detik, sistem cuma memakan 125 token audio di jendela konteks.
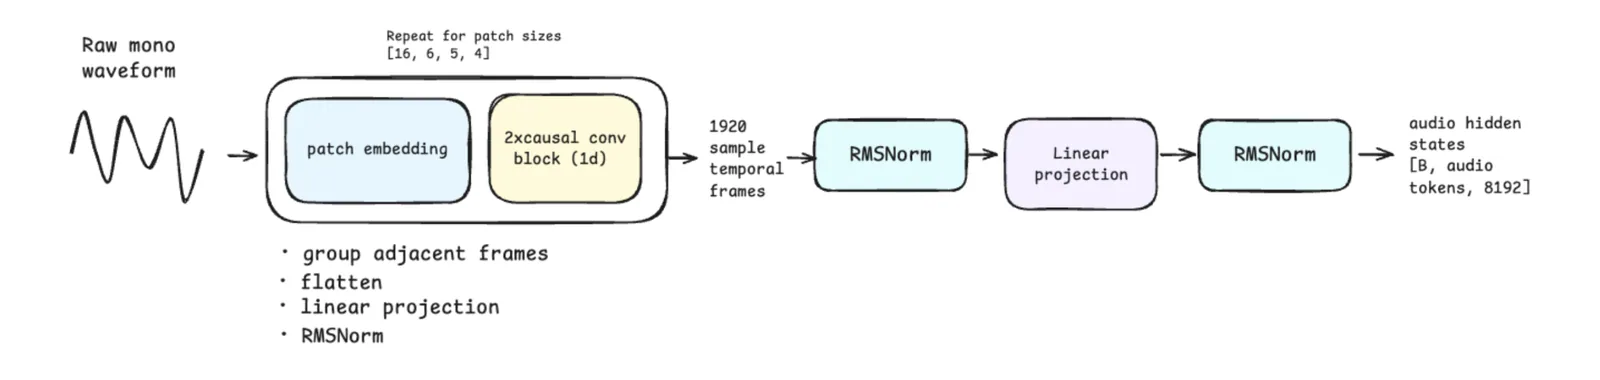
Melalui pendekatan ini, kamu nggak perlu lagi repot-repot menyambungkan pipeline transkripsi speech-to-text terpisah ketika ingin menyuruh AI mendengarkan perintah lisan.
Kolaborasi Meta dan Apple: Bisakah Berjalan di Mac?
Kabar paling menghebohkan yang disorot TechCrunch adalah kesiapan model open-weight raksasa ini untuk ekosistem komputer Apple. Kolaborasi langka antara dua raksasa teknologi ini dikonfirmasi langsung oleh petinggi kedua perusahaan. Melalui unggahan di media sosial X, CEO Meta Mark Zuckerberg mengungkapkan kebanggaannya bahwa bobot Muse Spark Open bisa berjalan mulus di Mac Studio baru berkat kerja sama bareng Apple.
CEO Apple John Ternus turut menyambut langkah ini dan menyatakan kekagumannya terhadap efisiensi Mac Studio dalam menangani model sekelas Muse Spark Open tepat di atas meja kerja pengguna. Melalui framework array MLX garapan Apple serta perkakas komunitas llama.cpp, model ini sukses diuji coba langsung di perangkat lokal.
Meski demikian, kebutuhan memorinya memang bukan untuk sembarang perangkat konsumen harian. Untuk menjalankan bobot asli secara utuh tanpa kompresi ekstrem, pengguna membutuhkan kapasitas RAM terpadu minimal 1 terabyte, atau menggunakan dua unit Apple M5 Ultra Mac Studio yang dirangkai secara paralel melalui framework MLX terbaru.
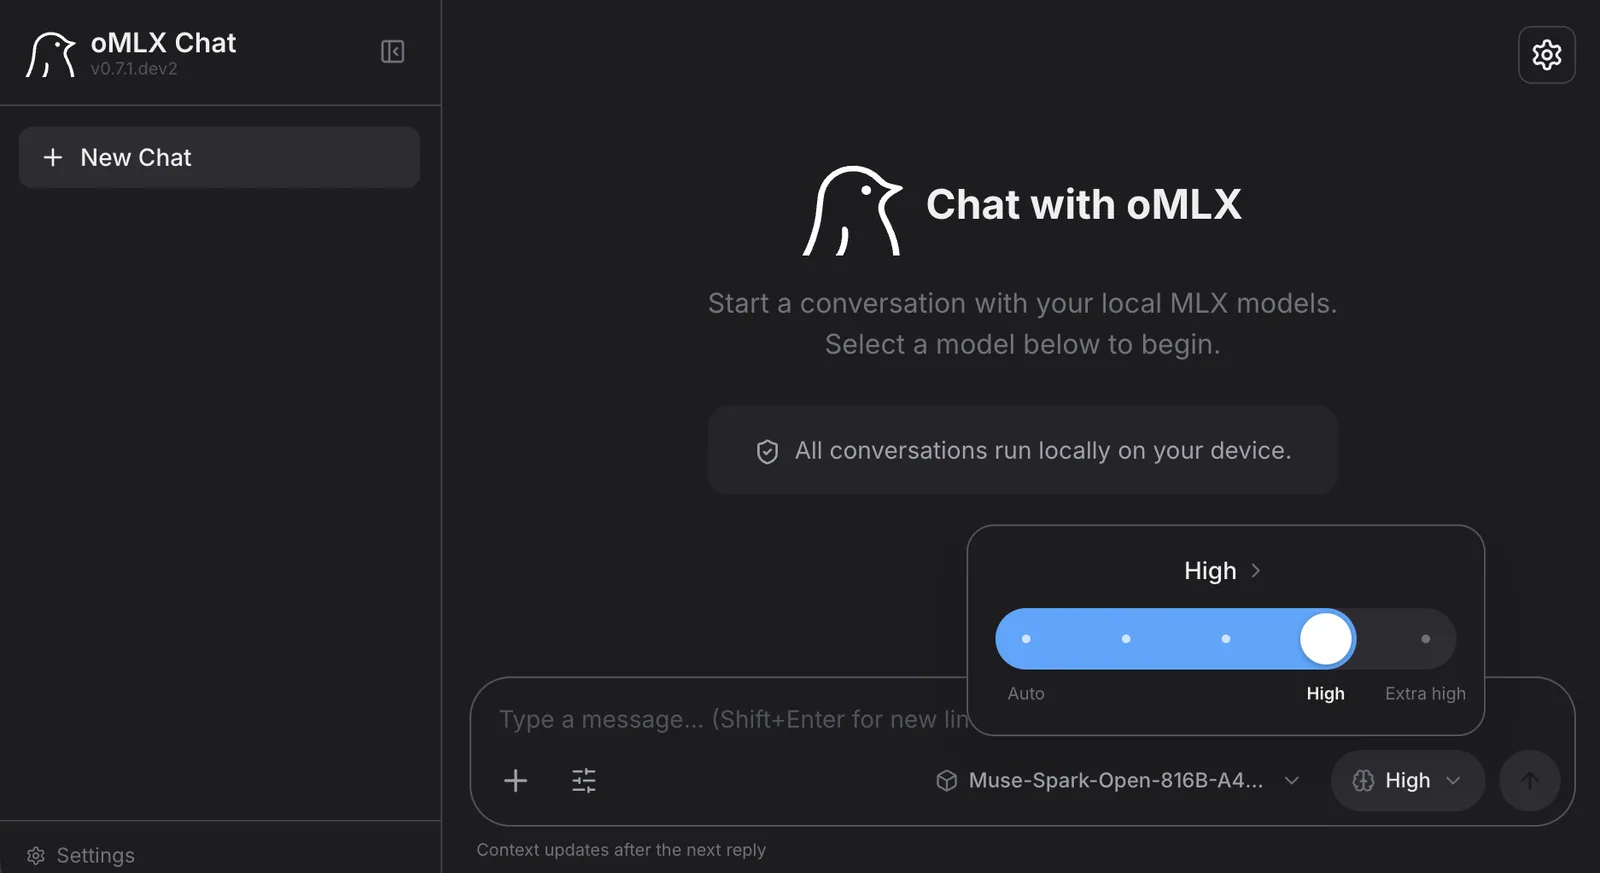
Untuk pengujian satu unit perangkat keras seperti Mac M3 Ultra (512 GB RAM), pengembang Hugging Face berhasil menjalankan versi kuantisasi 2-bit via llama.cpp pada kecepatan 18 token per detik dengan memori terpakai sekitar 304 GB. Sementara lewat oMLX, format kuantisasi 3-bit (oQ3e) memakan sekitar 344 GB RAM dan melaju hingga 225 token/s prefill serta 21 token/s kecepatan respons.
Panduan Praktis Menjalankan Inferensi Teks dan Multimodal
Kalau kamu punya kluster server GPU atau mesin multi-akselerator, kamu bisa memanfaatkan pustaka Hugging Face transformers memakai kelas MuseSparkForConditionalGeneration dan MuseSparkProcessor. Format chat template model ini mengadopsi struktur berbasis kanal Harmony, yang memisahkan kanal pemikiran (to=self), komentar alat (commentary), serta jawaban akhir ke pengguna (to=user).
Berikut langkah-langkah dasar menjalankan inferensi multimodal memakai Python:
- Pastikan lingkungan kerja mendukung dependensi multi-GPU atau Tensor Parallelism (TP).
- Siapkan model dan prosesor menggunakan ID repositori resmi Hugging Face.
- Susun data percakapan yang menggabungkan teks dan tautan gambar ke dalam struktur list pesan.
- Tentukan tingkat penalaran (reasoning effort) seperti
low,medium,high, atauxhigh. - Jalankan fungsi generate dan decode keluarannya.
Contoh kodenya bisa kamu lihat di bawah ini:
import os
from transformers import AutoModelForMultimodalLM, AutoTokenizer, DistributedConfig

# Atur konfigurasi paralelisme sesuai jumlah GPU
distributed_config = DistributedConfig(
    tp_size=int(os.environ.get("WORLD_SIZE", 1)),
    ep_size=int(os.environ.get("WORLD_SIZE", 1)),
)

model_id = "meta-models/Muse-Spark-Open-816B-A42B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(
    model_id,
    distributed_config=distributed_config,
)

messages = [
    {"role": "user", "content": "Jelaskan dalam satu kalimat cara kerja model Mixture-of-Experts."}
]

inputs = tokenizer.apply_chat_template(
    messages,
    reasoning_effort="medium",
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device).to(model.dtype)

outputs = model.generate(**inputs, max_new_tokens=2000)
generated_tokens = outputs[0][inputs["input_ids"].shape[1] :]
print(tokenizer.decode(generated_tokens, skip_special_tokens=True))Fine-Tuning Memakai TRL di Kluster H100
Buat kebutuhan perusahaan yang ingin mengadaptasi gaya bahasa atau template instruksi internal, bobot 816B ini bisa di-fine-tune memakai library TRL (SFTTrainer). Karena ukurannya jumbo, pendekatan yang paling efisien adalah teknik Parameter-Efficient Fine-Tuning (PEFT) menggunakan LoRA pada lapisan atensi, sementara 256 modul pakar tetap dibekukan (frozen).
Dalam eksperimen tim pengembang Hugging Face, pelatihan dilakukan pada 8 node berisi masing-masing 8 GPU NVIDIA H100 (total 64 GPU). Model dibagi memakai konfigurasi DistributedConfig(fsdp_size=64, ep_size=8).
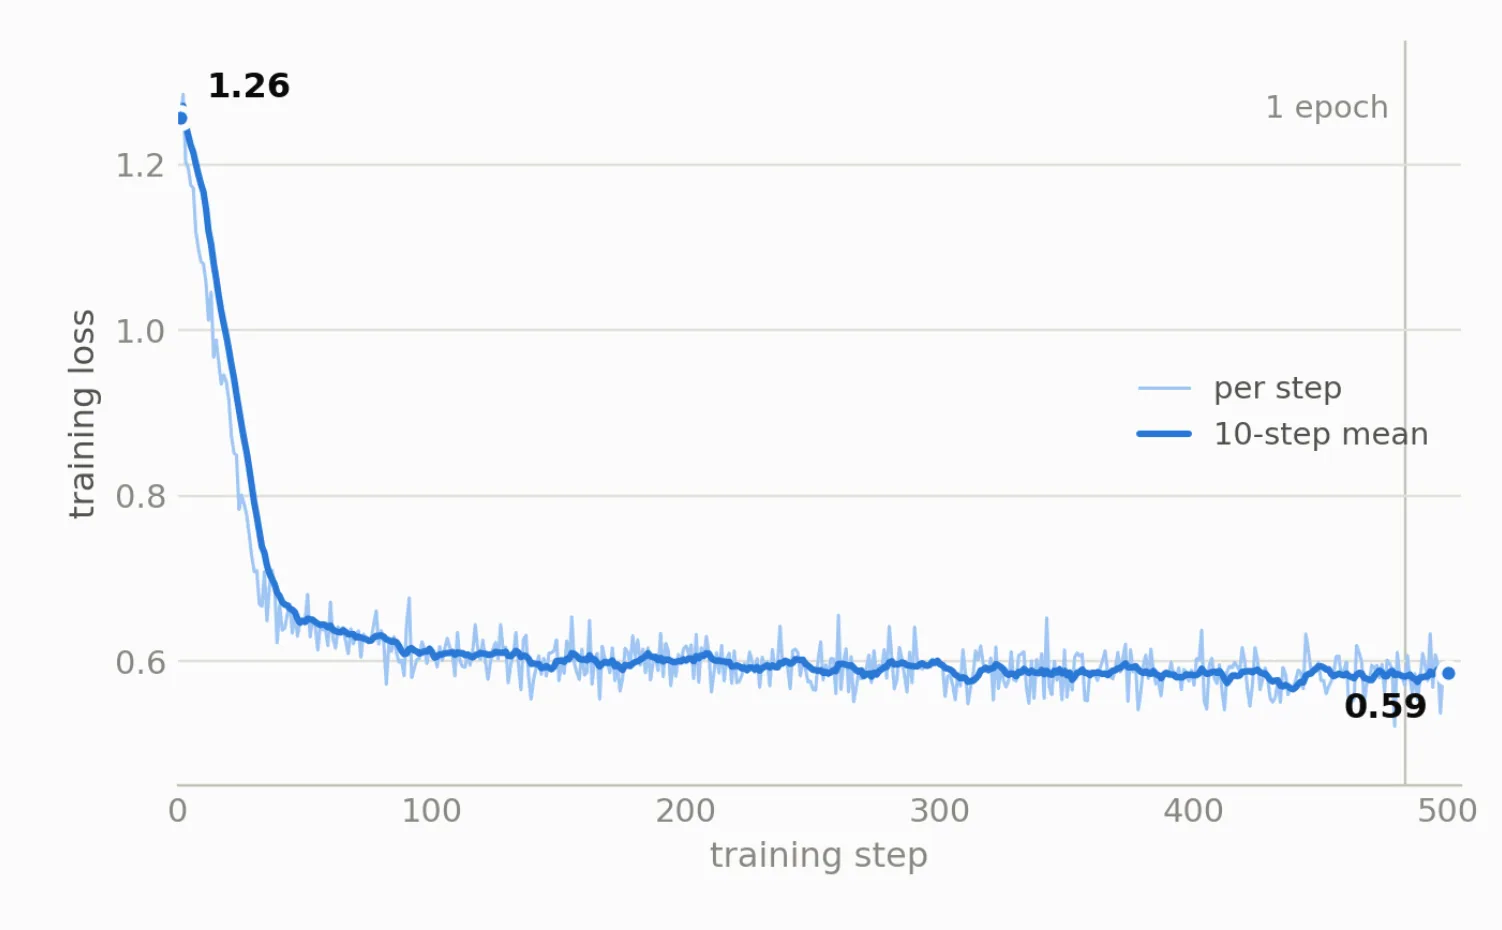
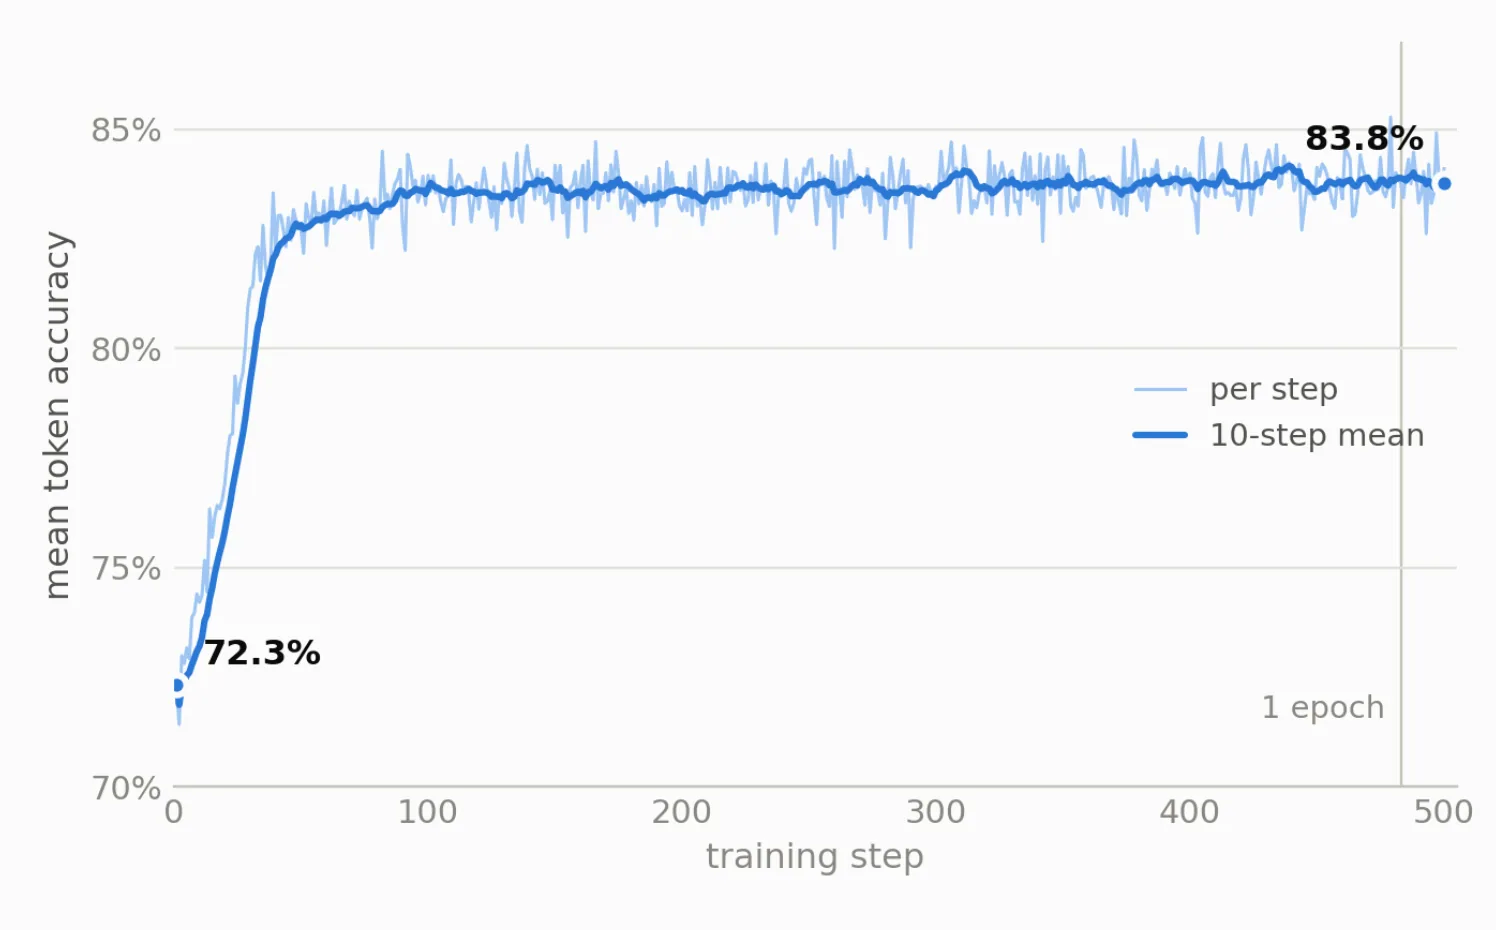
Pelatihan berjalan selama 500 langkah dengan throughput sekitar 8.000 token per detik, memakan waktu total sekitar 2 jam. Hasil evaluasi mencatatkan nilai loss turun dari 1,26 ke 0,57 dan rerata akurasi token meningkat dari 72% menjadi 84%.
Skenario Uji Coba: Dari Coding 3D Sampai Kontrol Komputer
Bukan sekadar lihai menyelesaikan soal algoritma teks, Muse Spark Open dirancang untuk alur kerja agentic nyata. Beberapa eksperimen langsung menunjukkan keluwesannya berkolaborasi dengan perangkat pihak ketiga:
1. Generator Aset 3D Iteratif (Three.js)
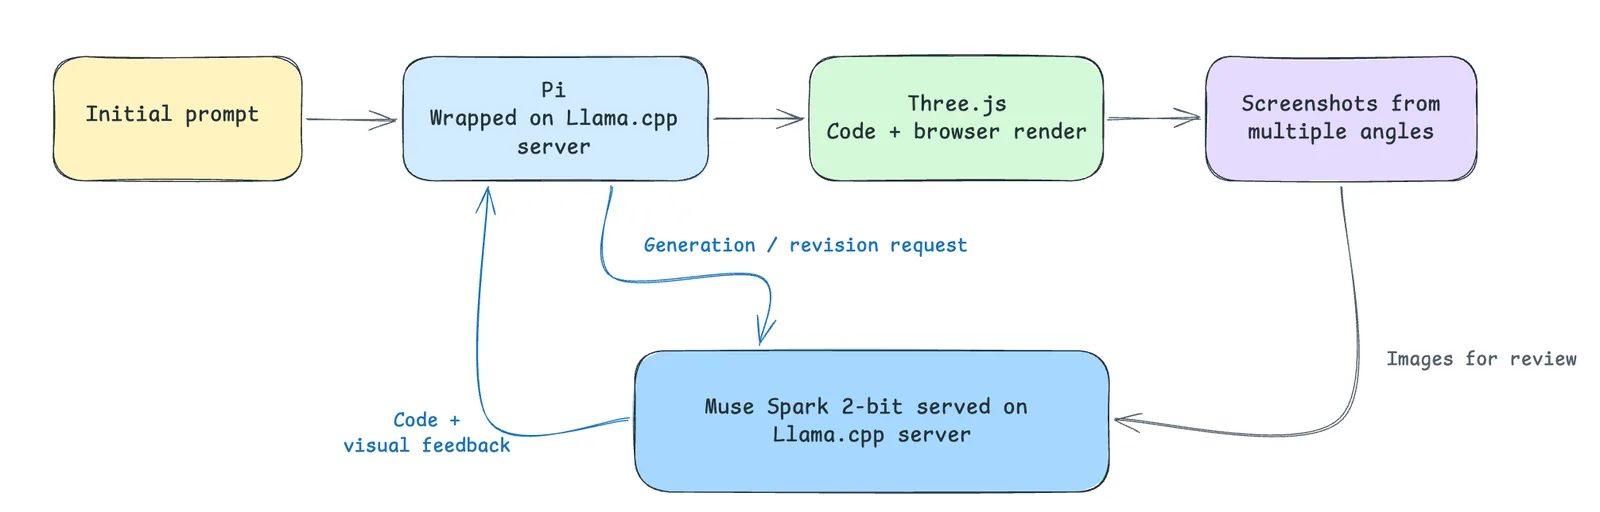
Tim Hugging Face menggabungkan model kuantisasi 2-bit pada llama.cpp dengan agent koding Pi. Pengguna cukup memberikan deskripsi aset, lalu agent memprogram kode Three.js, merendernya di peramban web, dan mengambil tangkapan layar dari berbagai sudut kamera. Tangkapan layar itu dikirimkan kembali ke model yang sama untuk ditinjau secara visual, lalu kodenya diperbaiki berulang kali hingga bentuk objeknya sempurna.
2. Agen Browser Tanpa Membaca Kode DOM HTML
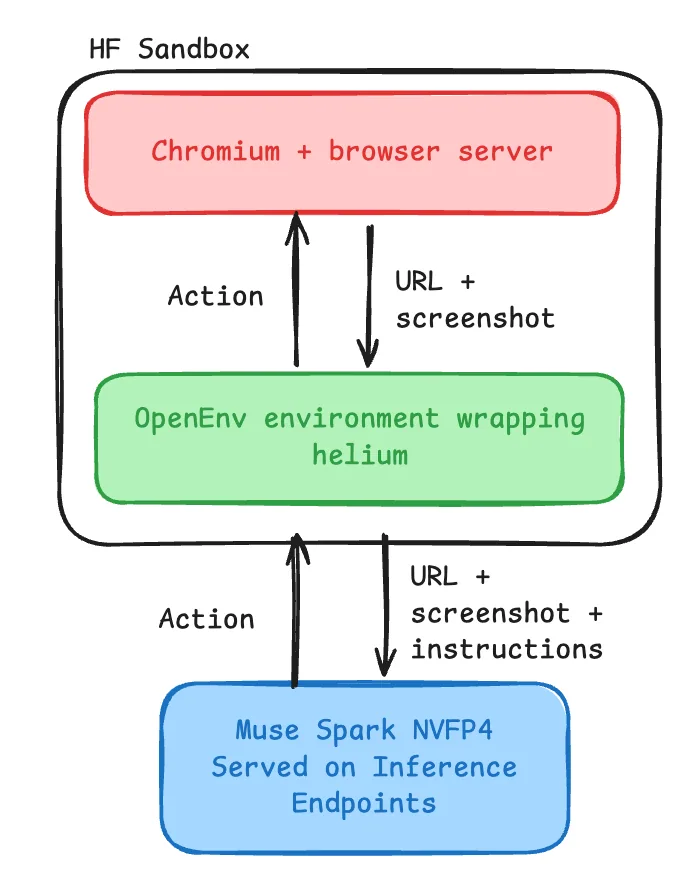
Dalam pengujian kontrol komputer dan browser menggunakan OpenEnv di Hugging Face Sandbox, model diuji menavigasi Chromium tanpa diberi akses ke kode HTML atau struktur DOM sama sekali. Model murni cuma melihat riwayat tindakan, instruksi sistem, URL, serta screenshot tampilan peramban. Berkat penglihatan multimodal yang tajam, agen sanggup memutuskan tindakan klik, pengetikan, maupun scroll secara otonom.
Bahkan lewat pengujian suara bertajuk "Call your Browser", pengguna bisa memberikan instruksi belanja lewat pesan suara. Model kemudian menganalisis kebutuhan barang, membuka peramban web ke situs Amazon, mencari opsi terbaik, dan menyaring produk berdasarkan kriteria yang diinginkan.
Cara Deploy Muse Spark Open di AWS SageMaker JumpStart
Bagi perusahaan yang memprioritaskan privasi data internal, deployment mandiri di infrastruktur cloud privat menjadi pilihan utama. Sesuai ulasan resmi AWS Machine Learning Blog, Muse Spark Open kini sudah tersedia langsung di katalog Amazon SageMaker JumpStart.
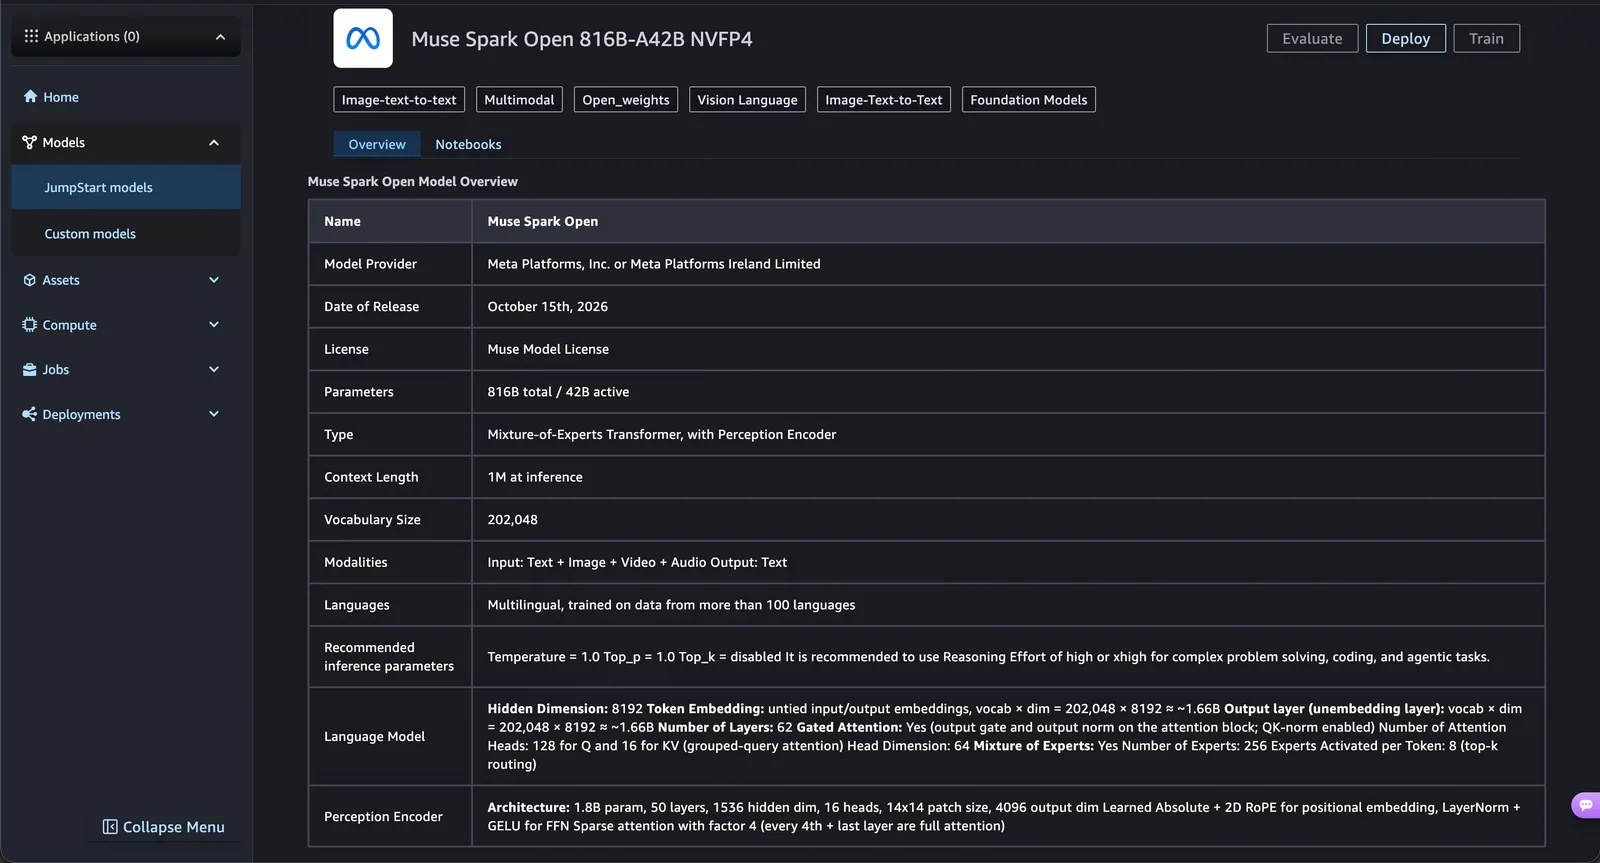
Keuntungan menjalankan model di AWS SageMaker AI adalah seluruh kode repositori privat, dokumen sensitif, dan log transaksi bisnis kamu tetap aman berada di VPC privat akun AWS milikmu sendiri, lengkap dengan enkripsi AWS KMS dan isolasi jaringan kontainer.
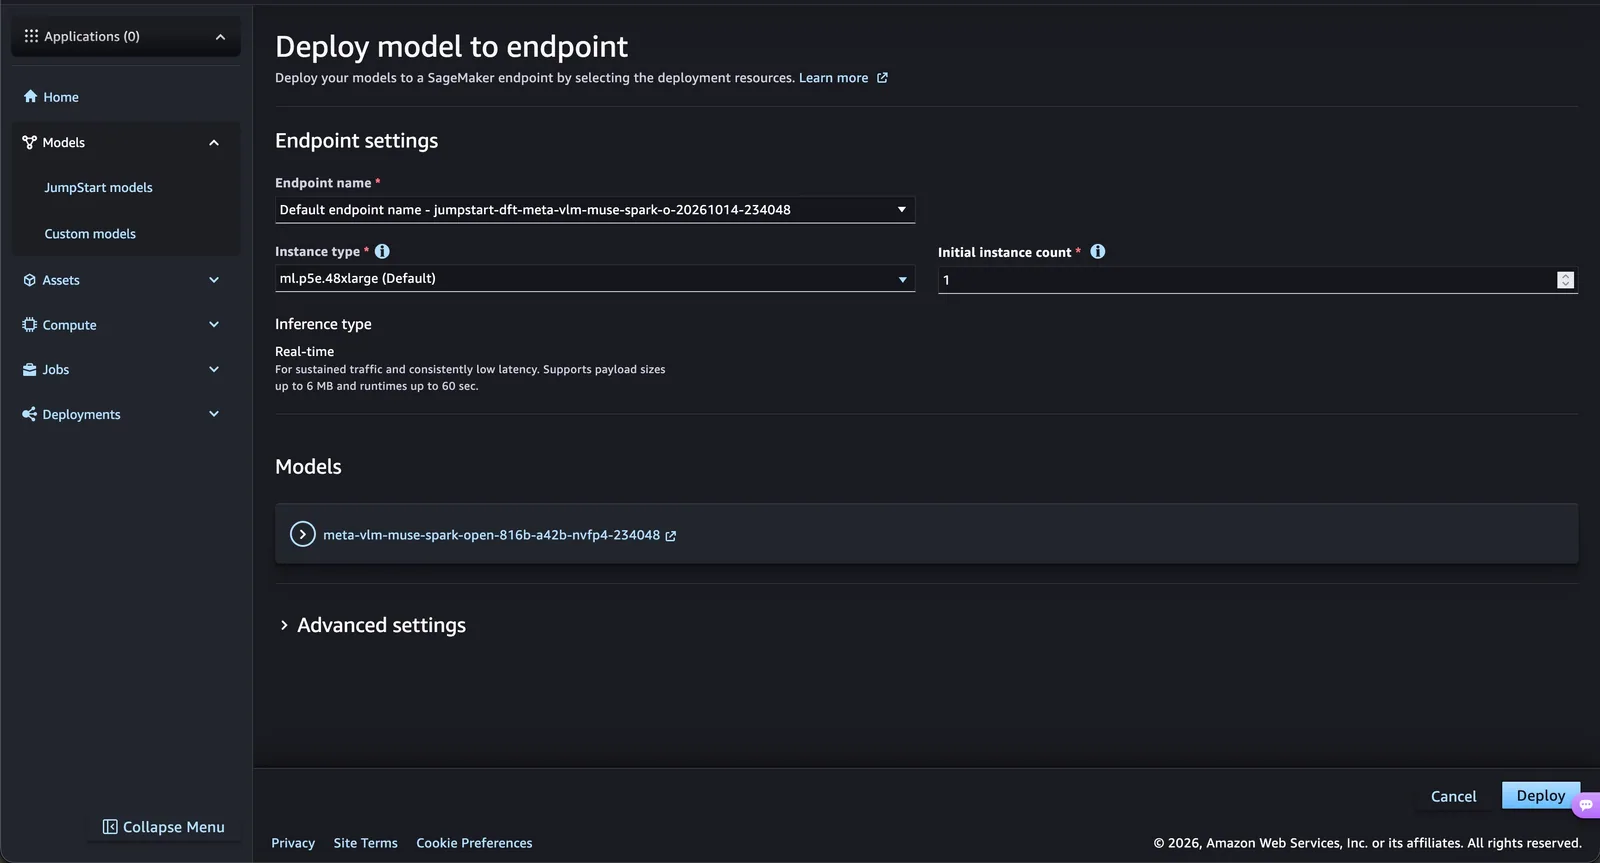
AWS menyediakan dua opsi pilihan varian:
- Varian NVFP4 (
Muse-Spark-Open-816B-A42B-NVFP4): Direkomendasikan untuk menekan biaya sewa server karena membutuhkan memori GPU seperempat lebih ramping. Varian ini berjalan pada instans GPUml.p5e.48xlarge. - Varian Penuh BF16 (
Muse-Spark-Open-816B-A42B): Membutuhkan kapasitas kluster lebih besar dan dialokasikan untuk instansml.p6-b300.48xlarge.
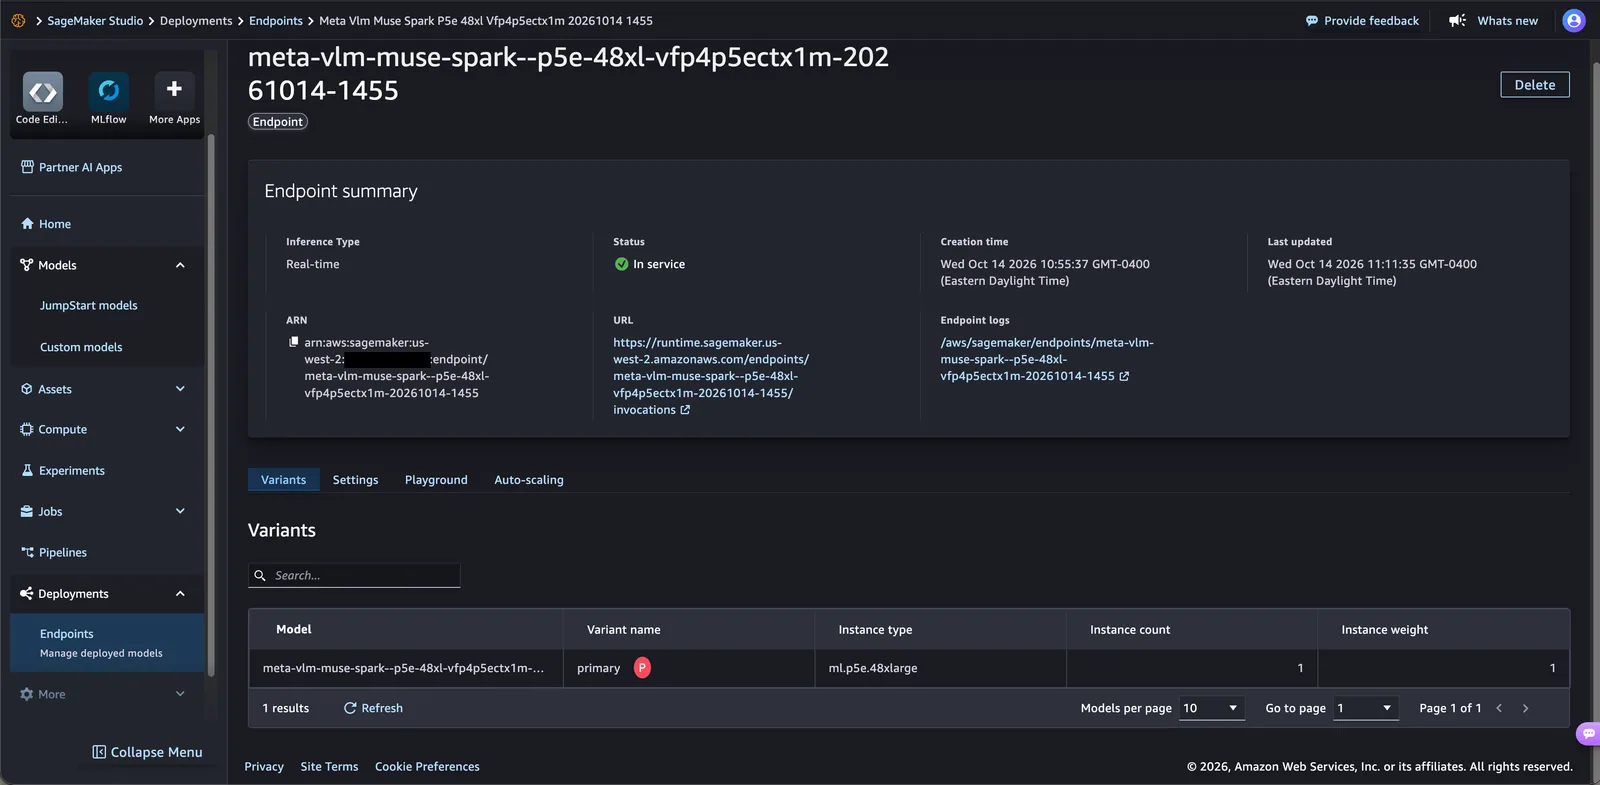
Bagi pengembang yang penasaran mengintegrasikan model cerdas ke dalam alur kerja coding internal, kamu bisa melatih pemahaman arsitektur agen melalui kelas AI untuk Developer di Classai.
Sementara itu, kalau kebutuhan aplikasimu saat ini belum memerlukan self-hosting kluster ratusan gigabyte yang mahal, kamu bisa memanfaatkan layanan Classai Router. Lewat satu API key terpadu, kamu bisa langsung memanggil model-model penalaran dan koding tangguh kelas dunia seperti claude-sonnet-5 (Rp3.210 / Rp15.750 per 1M token), gpt-4o (Rp525 / Rp2.700 per 1M token), hingga paket perutean hemat coding-us-auto (Rp4.500 / Rp22.500 per 1M token) dan coding-china-auto (Rp1.875 / Rp9.120 per 1M token). Semua tagihannya transparan dalam mata uang rupiah tanpa perlu repot mengurus sewa infrastruktur server.
Dampak Nyata Buat Developer dan Industri Software di Indonesia
Kehadiran model berbobot terbuka sekaliber Muse Spark Open membawa angin segar buat ekosistem teknologi di tanah air, khususnya pada beberapa aspek krusial:
- Kedaulatan Data dan Kepatuhan Regulasi: Perusahaan sektor keuangan, kesehatan, dan instansi pemerintahan yang terikat aturan kerahasiaan data (seperti UU Perlindungan Data Pribadi) kini punya alternatif model cerdas kelas atas yang bisa di-hosting sepenuhnya secara on-premise atau di virtual private cloud lokal tanpa kebocoran kode ke pihak ketiga.
- Otomasi Refactoring Repositori Lama (Legacy Code): Dengan batas konteks mencapai 1 juta token, tim rekayasa perangkat lunak bisa melempar keseluruhan basis kode aplikasi perbankan atau sistem korporat yang rumit untuk dianalisis arsitekturnya, dicari celah keamanannya, atau ditulis ulang tanpa perlu memecah berkas secara manual.
- Efisiensi Pengujian UI/UX Multimodal: Tim QA (quality assurance) dapat membangun agen otomatis yang mengevaluasi tampilan antarmuka aplikasi lokal cukup dengan memberikan screenshot desain Figma atau rekaman video bug dari pengguna, lalu membiarkan model mengoreksi kodenya secara otomatis.
Berikut contoh prompt sistem yang bisa kamu sontek saat mengarahkan model agentic seperti Muse Spark Open untuk menginspeksi bug visual pada berkas kode:
Kamu adalah staf senior software engineer yang bertugas mengecek bug visual antarmuka. Periksa tangkapan layar kesalahan yang dilampirkan bersama berkas kode komponen frontend berikut.1. Identifikasi baris styling atau logika komponen yang menyebabkan elemen visual bertumpuk atau salah posisi.2. Berikan analisis akar masalah secara ringkas di kanal pemikiran.3. Tuliskan revisi kode perbaikan yang bersih, modular, dan langsung siap digabungkan (merge) ke repositori.
Langkah berani Meta membuka bobot Muse Spark Open menegaskan bahwa peta persaingan model AI koding masa kini kian condong ke arah keterbukaan dan multimodalitas penuh. Bagi kamu yang ingin mengeksplorasi deployment mandiri di mesin lokal maupun cloud, model ini tentu pantas masuk ke daftar uji coba utama di lab pengembanganmu.
Sumber & referensi
- 01
Hugging Face · 15 Oktober 2026
Welcome Muse Spark Open: open-weight frontier multimodal mixture-of-experts model from Meta - 02
TechCrunch · 16 Oktober 2026
Meta launches an open-weight AI model that runs on Macs - 03
The Verge · 16 Oktober 2026
Meta and Apple team up to make Muse AI models run better on Macs - 04
AWS · 16 Oktober 2026
Meta’s Muse Spark Open now available in Amazon SageMaker JumpStart
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Berapa kapasitas RAM yang dibutuhkan untuk menjalankan Muse Spark Open di Mac?
Untuk menjalankan bobot utuh tanpa kompresi ekstrem, model membutuhkan memori RAM sekitar 1 TB atau dua unit Mac Studio bertenaga chip M5 Ultra. Namun, versi kuantisasi 2-bit lewat llama.cpp sudah bisa berjalan di Mac M3 Ultra memori 512 GB dengan konsumsi RAM sekitar 304 GB pada kecepatan 18 token per detik.
Apakah fitur penalaran (reasoning) pada Muse Spark Open bisa dinonaktifkan?
Fitur penalaran pada Muse Spark Open tidak bisa dimatikan sepenuhnya oleh pengguna. Untuk menghemat konsumsi token pada instruksi yang sederhana, kamu disarankan menurunkan tuas penalarannya ke setelan low di dalam template percakapan atau sistem prompt.
Apa keunggulan arsitektur MoE pada Muse Spark Open dibanding model biasa?
Arsitektur MoE memungkinkan model menyimpan kapasitas luas sebesar 816 miliar parameter tetapi hanya mengaktifkan 42 miliar parameter per token. Hasilnya, model memiliki wawasan pengetahuan yang sangat dalam namun proses inferensinya berjalan jauh lebih cepat dan efisien dibanding model padat berukuran serupa.
Di mana pengembang bisa men-deploy Muse Spark Open secara resmi di cloud?
Pengembang dapat men-deploy model ini secara resmi melalui Hugging Face Inference Endpoints serta Amazon SageMaker JumpStart. Tersedia pilihan varian presisi BF16 penuh maupun varian kompresi NVFP4 yang lebih hemat memori untuk akselerator grafis NVIDIA modern.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.