SageMaker Canvas MLOps: Trik GS Caltex Deploy Model Hitungan Jam
GS Caltex membuktikan model no-code dari insinyur lapangan bisa langsung masuk produksi tanpa bikin pusing tim ML engineer. Ini rahasia arsitekturnya.
· 9 menit baca
Inti singkat
- GS Caltex memangkas waktu rilis model ML dari sekitar seminggu menjadi hitungan jam saja.
- Model visual dan alur data dari Amazon SageMaker Canvas dipakai ulang langsung di Amazon SageMaker Pipelines tanpa nulis ulang kode logika.
- Inferensi batch dijadwalkan tiap 30 menit lewat Amazon EventBridge, memangkas biaya komputasi dibanding endpoint real-time 24 jam non-stop.
- Pemisahan peran terbukti efektif: insinyur proses fokus bikin model no-code, sementara ML engineer fokus mengurus otomatisasi pipeline dan operasi produksi.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Raksasa energi dan kimia asal Korea Selatan, GS Caltex, berhasil menghubungkan model no-code buatan insinyur proses langsung ke alur kerja produksi memakai kombinasi Amazon SageMaker Canvas dan Amazon SageMaker Pipelines. Terobosan ini bikin waktu rilis model terpangkas drastis dari sekitar satu minggu jadi cuma beberapa jam aja.
Banyak perusahaan sering terjebak dilema klasik: orang lapangan paling paham data proses bisnis tapi nggak bisa koding, sedangkan ML engineer jago bikin infrastruktur tapi kurang paham konteks data pabrik. Seperti dilaporkan dalam pengumuman resmi AWS Machine Learning Blog, GS Caltex memecahkan masalah ini dengan merancang alur kerja machine learning operations (MLOps) yang menyatukan kedua kubu tanpa bikin kerjaan dobel.
Penasaran gimana cara mereka menghubungkan aset no-code ke pipeline otomatis siap pakai? Yuk, kita bedah arsitektur teknis dan langkah implementasinya.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Jurang Pemisah Tim Lapangan dan ML Engineer: Kenapa MLOps Ini Penting?
Di fasilitas pengolahan GS Caltex, para process engineer punya keahlian mendalam soal variabel dan data di balik proses kimiawi. Mereka tahu persis apakah hasil tebakan model masuk akal atau nggak. Lewat model built and evaluated in SageMaker Canvas, mereka bisa menyiapkan data secara visual, melatih model, dan mengecek akurasinya tanpa menyentuh sebaris kode Python pun.
Tapi, tantangannya muncul pas model itu mau dipakai rutin di lingkungan produksi. Dulu, memindahkan aset dari Canvas butuh kerja integrasi manual yang ribet. ML engineer harus menentukan jalur data produksi, menyetel konfigurasi model, sampai menghubungkan tahapan preprocessing dan inferensi dari nol. Proses operasional ini biasanya makan waktu sampai sekitar seminggu buat tiap model.
GS Caltex akhirnya bikin sistem handoff otomatis. Tujuannya simpel: memakai ulang logika alur data dan model yang udah divalidasi insinyur lapangan tanpa perlu ditulis ulang oleh tim koding.
Berikut pembagian kerja yang diterapkan di lingkungan kerja GS Caltex:
| Area Pekerjaan | Dikerjakan di SageMaker Canvas | Dikelola di Pipeline Produksi |
|---|---|---|
| Persiapan Data | Alur preprocessing visual pakai Data Wrangler | Job pemrosesan data di Amazon SageMaker Processing |
| Pengembangan Model | Model terlatih dan hasil evaluasi performa | Versi model dan status approval di Model Registry |
| Prediksi | Validasi hasil tebakan model | Inferensi batch tiap 30 menit pakai model yang disetujui |
| Operasi & Monitoring | Pembuatan dan pengetesan model individual | Riwayat eksekusi, penyimpanan log, dan penanganan eror |
Arsitektur SageMaker Canvas MLOps ala GS Caltex
Untuk menyambungkan kedua sistem, arsitektur MLOps di GS Caltex dibagi jadi dua alur besar: persiapan versi model baru untuk rilis, dan penjalanan inferensi batch rutin memakai model yang sudah disetujui.
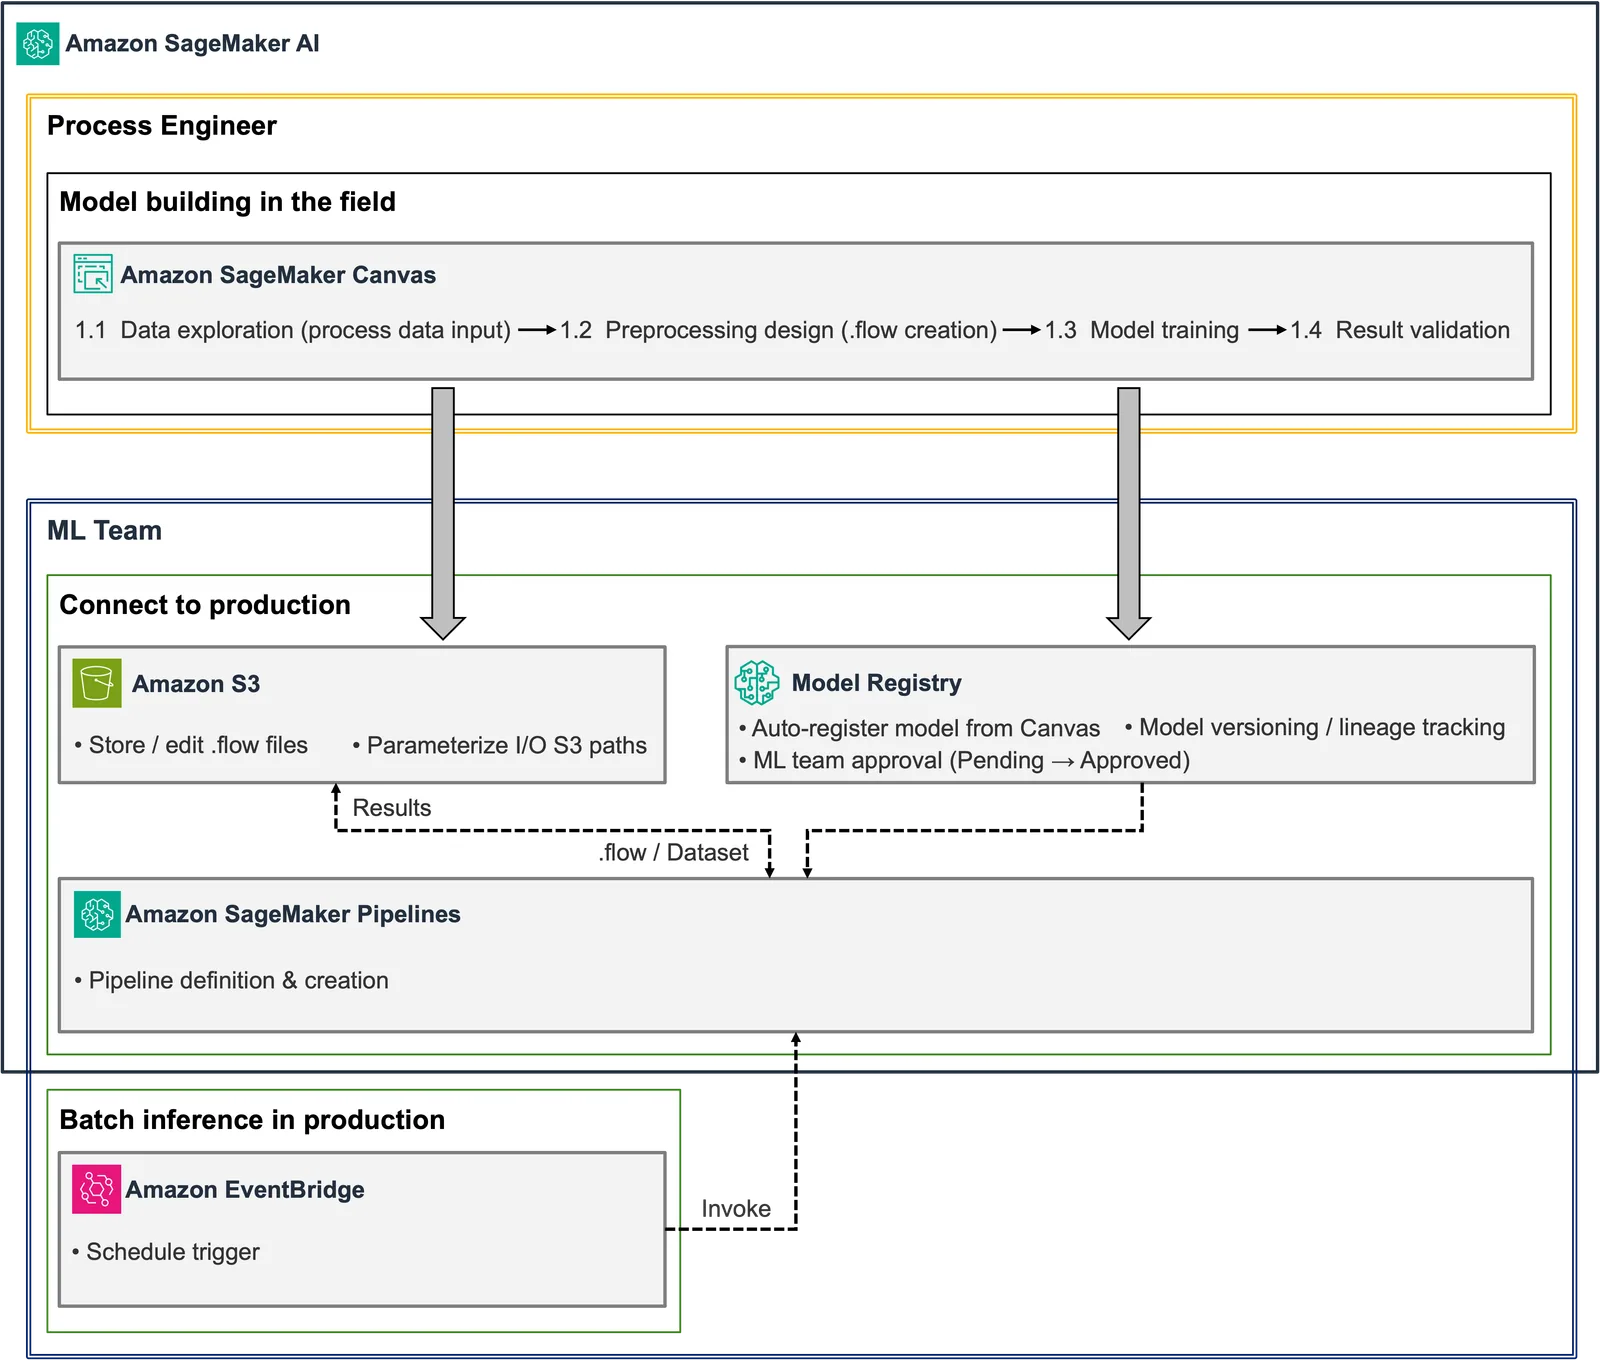
Alur kerjanya berjalan runut:
- Insinyur lapangan mengekspor Data Wrangler preprocessing flow ke Amazon S3 dan mendaftarkan modelnya ke Model Registry.
- ML engineer mengecek format data dan metrik evaluasi. Kalau aman, status di Model Registry diubah jadi Approved.
- Model yang disetujui kemudian didaftarkan sebagai sumber daya model SageMaker untuk dipakai SageMaker Batch Transform.
- Amazon EventBridge memicu eksekusi pipeline secara berkala tiap 30 menit.
- SageMaker Pipelines developer guide mengeksekusi langkah pembersihan data dari Amazon S3, menjalankan prediksi, dan menyimpan hasilnya kembali ke S3.
Dengan pola ini, tim ML nggak perlu meraba-raba formula transformasi data yang dibikin insinyur lapangan. Cukup ambil file konfigurasi .flow aslinya dan jalankan di infrastruktur cloud.
5 Langkah Alur Pipeline Batch Inference
Di tahap eksekusi produksi, inferensi data tidak dijalankan lewat server real-time yang terus menyala, melainkan lewat pipeline inferensi batch 5 langkah terstruktur.
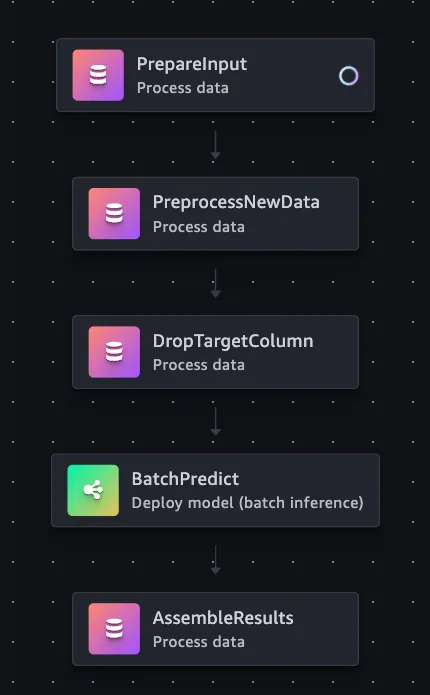
Kelima langkah ini dirancang saling bergantung (depends_on) untuk memastikan data nggak rusak di tengah jalan:
- PrepareInput: Langkah awal buat mengecek data baru. Kalau kolom target prediksi hilang (wajar karena ini data baru yang belum ada jawabannya), langkah ini menambahkan kolom placeholder sementara agar skema data cocok dengan alur training.
- PreprocessNewData: Menjalankan file
.flowbawaan SageMaker Canvas memanfaatkan container SageMaker Processing. - DropTargetColumn: Membuang kembali kolom placeholder dan header CSV, menyisakan deretan fitur bersih yang siap diproses model.
- BatchPredict: Menjalankan inferensi sekumpulan data memakai model resmi yang sudah disetujui lewat Batch Transform.
- AssembleResults: Menggabungkan kembali data awal dengan hasil prediksi baris demi baris menjadi satu file CSV utuh.
Berikut potongan implementasi Python SDK buat menyusun pipeline tersebut:
from sagemaker.workflow.pipeline import Pipeline
from sagemaker.workflow.steps import ProcessingStep, TransformStep

prepare = ProcessingStep(
    name="PrepareInput",
    step_args=prepare_args
)
preprocess = ProcessingStep(
    name="PreprocessNewData",
    step_args=preprocess_args,
    depends_on=[prepare],
)
drop_target = ProcessingStep(
    name="DropTargetColumn",
    step_args=drop_target_args,
    depends_on=[preprocess],
)

features_uri = (
    drop_target.properties.ProcessingOutputConfig
    .Outputs["features"].S3Output.S3Uri
)

predict = TransformStep(
    name="BatchPredict",
    step_args=transformer.transform(
        data=features_uri,
        content_type="text/csv",
        split_type="Line",
    ),
)

assemble = ProcessingStep(
    name="AssembleResults",
    step_args=assemble_args,
    depends_on=[predict],
)

pipeline = Pipeline(
    name="canvas-process-inference",
    steps=[prepare, preprocess, drop_target, predict, assemble],
    sagemaker_session=pipeline_session,
)
pipeline_arn = pipeline.upsert(role_arn=sagemaker_role_arn)["PipelineArn"]
Kode di atas menunjukkan betapa rapinya dependensi antar langkah. Output S3 dari langkah sebelumnya langsung diteruskan jadi input langkah berikutnya secara otomatis.
Menjalankan Ulang File .flow dan Validasi Model
Salah satu trik terpenting yang dibagikan GS Caltex ada pada cara memakai ulang alur data visual. Saat insinyur mengekspor data ke S3 dari Canvas, sistem menghasilkan file berekstensi .flow yang mencatat detail transformasi Data Wrangler.
ML engineer harus mengecek beberapa poin penting sebelum file ini dijalankan otomatis:
- URI Gambar Kontainer: Gunakan image kontainer Processing yang sama persis seperti yang dipakai saat ekspor dari Canvas. Pastikan versinya dikunci (pinned) agar hasil perhitungannya konsisten.
- Pertahankan Parameter Training: Parameter transformasi yang dipelajari selama pelatihan—seperti rumus scaling atau encoding kategori—harus dipertahankan. Jangan sampai data inferensi baru malah menghitung ulang nilai rata-rata (mean) atau variance baru.
- Validasi Skema Output: Cek apakah urutan kolom, jumlah fitur, dan tipe data keluaran Processing di cloud identik dengan hasil pratinjau di antarmuka Canvas.
Setelah urusan alur data beres, model di Model Registry dicek status persetujuannya lewat Boto3 sebelum didaftarkan sebagai model aktif:
import boto3

sm_client = boto3.client("sagemaker")
package = sm_client.describe_model_package(ModelPackageName=model_package_arn)

if package["ModelPackageStatus"] != "Completed":
    raise RuntimeError("Model package is not ready")
if package["ModelApprovalStatus"] != "Approved":
    raise RuntimeError("Model package is not approved")

sm_client.create_model(
    ModelName=model_name,
    ExecutionRoleArn=sagemaker_role_arn,
    PrimaryContainer={"ModelPackageName": model_package_arn},
)
Pengecekan ini jadi pagar pengaman penting biar model yang performanya jeblok atau belum diverifikasi nggak sampai lolos ke tahap produksi.
Otomatisasi Jadwal Inferensi dengan Amazon EventBridge
Alih-alih menyuruh admin memencet tombol eksekusi tiap waktu, GS Caltex memakai aturan Amazon EventBridge untuk menjalankan pipeline secara terjadwal tiap 30 menit.
Kebutuhan ini butuh Amazon EventBridge role with permission to start the pipeline yang punya izin sagemaker:StartPipelineExecution. Kodenya ringkas banget:
import boto3

events_client = boto3.client("events")
rule_name = "canvas-process-inference-every-30-minutes"

events_client.put_rule(
    Name=rule_name,
    ScheduleExpression="rate(30 minutes)",
    State="ENABLED",
)

result = events_client.put_targets(
    Rule=rule_name,
    Targets=[{
        "Id": "canvas-process-inference",
        "Arn": pipeline_arn,
        "RoleArn": eventbridge_role_arn,
    }],
)
if result["FailedEntryCount"]:
    raise RuntimeError(result["FailedEntries"])
Jadwal rate(30 minutes) bakal menghasilkan 48 kali eksekusi per hari. Kamu juga bisa memakai format cron seperti cron(0/30 * * * ? *) kalau pengin eksekusinya tepat di menit ke-0 dan ke-30 setiap jam.
Real-Time Endpoint vs Batch Transform: Mana Lebih Hemat?
Kenapa GS Caltex nggak pakai endpoint real-time yang siap merespons kapan saja? Jawabannya ada pada efisiensi biaya dan karakteristik beban kerja industri kimia.
| Pertimbangan | Endpoint Real-Time | SageMaker Pipelines + Batch Transform |
|---|---|---|
| Siklus Hidup Resource | Mesin komputasi nyala terus melayani request | Komputasi cuma menyala saat job jalan, lalu dilepas |
| Penentu Biaya Utama | Kapasitas instans dan jam operasional (uptime) | Durasi job, frekuensi run, jumlah instans, dan layanan pendukung |
| Karakter Beban Kerja | Butuh respons instan milidetik (misal chatbot/API) | Memproses kumpulan data berkala yang menumpuk |
| Skalabilitas Model Baru | Butuh tambahan kapasitas hosting dan biaya tetap | Cukup jadwalkan antrean pemrosesan baru |
Data sensor pabrik di GS Caltex dievaluasi tiap setengah jam. Membiarkan klaster server inferensi menyala 24/7 bakal membuang anggaran cloud secara sia-sia. Dengan Batch Transform, mesin komputasi baru disewa saat data siap, dan langsung dimatikan setelah prediksi selesai ditulis ke S3.
Hal Operasional yang Wajib Diwaspadai
Sebelum kamu menerapkan arsitektur ini di perusahaanmu, ada beberapa jebakan teknis yang dicatat oleh tim GS Caltex:
- Eksekusi yang Tumpang Tindih (Overlapping Runs): Jadwal tiap 30 menit bukan jaminan pipeline kamu selesai dalam 30 menit. Kalau volume data mendadak membengkak atau ada instans yang lambat menyala, eksekusi baru bisa bentrok dengan yang lama. Atur folder output terpisah dengan format
runs/<execution-id>/di S3 agar data nggak tertimpa. - Trik Kolom Target: Menaruh nilai placeholder di kolom target cuma aman kalau transformasi datamu nggak memakai logika berbasis target (seperti target encoding atau penyaringan baris berdasarkan nilai target). Kalau alur data memakai logika kayak gitu, pisahkan proses transformasi fitur secara manual.
- Pencocokan Baris di AssembleResults: Langkah penggabungan hasil menggabungkan data awal dan prediksi berdasarkan urutan baris. Pastikan pembersihan data nggak membuang baris tertentu tanpa mencatat ID baris aslinya, biar prediksi nggak tertukar dengan data pelanggan atau sensor lain.
Kalau kamu tertarik mempelajari arsitektur berbasis agent dan integrasi cerdas lainnya di ekosistem AWS, kamu juga bisa membaca ulasan kami tentang AWS Pluggable Agentic AI Framework yang membahas orkestrasi skala enterprise.
3 Tahap Adopsi MLOps: Dari Crawl Sampai Run
GS Caltex menyarankan pendekatan bertahap agar proses adopsi teknologi ini nggak bikin tim kewalahan:
- Tahap Crawl (Merangkak): Fokus pada pembuktian. Ambil satu model yang sudah divalidasi insinyur di SageMaker Canvas, daftarkan ke Model Registry, lalu bangun alur pipeline sederhana dan jalankan secara manual untuk memverifikasi hasilnya.
- Tahap Walk (Berjalan): Bangun keandalan sistem operasional. Pasang validasi status persetujuan, jadwalkan eksekusi otomatis memakai EventBridge, pasang alarm notifikasi eror di CloudWatch, dan pisahkan jalur penyimpanan hasil per eksekusi.
- Tahap Run (Berlari): Standarisasi proses ke seluruh lini bisnis. Buat template kode yang bisa dipakai ulang antar tim, terapkan CI/CD otomatis, dan susun panduan serah terima tanggung jawab operasional antara insinyur proses dan tim ML.
Kamu bisa mengunduh contoh kode dan template implementasi lengkapnya langsung di GitHub repository contoh Canvas ke Pipelines MLOps.
Dampak Nyata untuk Industri dan Developer di Indonesia
Keberhasilan GS Caltex membawa angin segar buat transformasi digital perusahaan di Indonesia, terutama di sektor perbankan, manufaktur, logistik, dan ritel. Sering kali, inovasi AI terganjal karena keterbatasan talenta data scientist murni yang paham teknis koding sekaligus mengerti seluk-beluk bisnis lokal.
Dengan pola hybrid seperti ini, staf operasional di Jakarta atau daerah operasional lain bisa mengeksplorasi ide prediksi bisnis lewat antarmuka visual tanpa pusing memikirkan infrastruktur. Di sisi lain, tim developer atau DevOps internal cukup mengamankan gerbang produksi lewat pipeline teruji yang patuh pada tata kelola keamanan data.
Buat kamu yang lagi merancang sistem AI cerdas dan butuh menghubungkan berbagai model bahasa besar pendukung ke backend aplikasimu tanpa ribet langganan sana-sini, kamu bisa memanfaatkan Classai Router. Lewat satu API key terpusat, kamu bisa memanggil model canggih seperti DeepSeek V4.1 Flash (Rp1.250 / Rp4.540 per 1M token) atau Claude Sonnet 5 (Rp3.960 / Rp19.800 per 1M token) dengan skema bayar per token tanpa kartu kredit luar negeri.
Ingin mengasah kemampuan merancang alur kerja AI terapan untuk kebutuhan tim teknismu? Yuk, intip pilihan materi praktisnya di Kelas AI Developer yang dibimbing langsung oleh praktisi berpengalaman.
Berikut contoh prompt yang bisa kamu pakai untuk mengecek kesiapan skema MLOps timmu sebelum meluncurkannya ke cloud:
Saya sedang merancang pipeline MLOps batch inference menggunakan AWS SageMaker Pipelines dan data dari model no-code. Tolong bantu saya menyusun checklist audit operasional yang mencakup:1. Penanganan data drift dan skema input yang berubah.2. Mekanisme pencegahan overlapping run jika inferensi dijadwalkan setiap 30 menit.3. Skema penyimpanan output di S3 agar hasil prediksi tiap eksekusi terisolasi dengan aman.4. Parameter pemantauan metrik dan log di Amazon CloudWatch.Sajikan checklist dalam bentuk tabel ringkas dengan kolom: Komponen, Risiko Potensial, dan Solusi Mitigasi Teknis.
Sumber & referensi
- 01
AWS · 14 November 2026
Production MLOps at GS Caltex with Amazon SageMaker Canvas, part 1
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu pendekatan SageMaker Canvas MLOps yang dipakai GS Caltex?
Pendekatan ini adalah arsitektur alur kerja yang menghubungkan model no-code buatan insinyur proses di Amazon SageMaker Canvas ke sistem produksi otomatis Amazon SageMaker Pipelines. Melalui integrasi ini, logika pembersihan data dan model yang udah divalidasi bisa langsung dipakai ulang oleh tim ML engineer untuk inferensi batch terjadwal tanpa perlu menulis ulang kodenya dari awal lagi.
Seberapa besar penghematan waktu rilis model di GS Caltex?
GS Caltex melaporkan bahwa ML engineer mereka sekarang bisa meluncurkan model baru ke tahap produksi hanya dalam waktu beberapa jam saja. Sebelumnya, proses serah terima dan integrasi manual aset dari lingkungan pengembangan ke lingkungan operasional memakan waktu hingga sekitar satu minggu, sehingga pemangkasan waktu ini membuat tim jauh lebih produktif dalam mengelola banyak model sekaligus.
Mengapa GS Caltex memilih Batch Transform daripada endpoint real-time?
GS Caltex memilih inferensi batch tiap 30 menit karena data proses kimiawi mereka dievaluasi secara berkala dan nggak butuh respons instan milidetik. Pilihan ini terbukti bikin biaya komputasi jauh lebih hemat karena sumber daya komputasi cuma berjalan selama proses inferensi berlangsung, lalu langsung dimatikan kembali tanpa membiarkan server menyala terus-menerus selama 24 jam penuh setiap hari.
Bagaimana cara mengatasi kolom target yang hilang pada data inferensi?
Tim GS Caltex menyisipkan langkah PrepareInput sebelum proses transformasi data berjalan. Langkah ini menambahkan kolom target buatan berisi nilai placeholder agar format data tetap sesuai dengan skema pelatihan Data Wrangler. Setelah seluruh fitur selesai diproses, langkah DropTargetColumn akan membuang kembali kolom target itu sebelum data bersih dikirimkan ke model untuk diprediksi.
Apa peran Amazon EventBridge dalam alur MLOps GS Caltex?
Amazon EventBridge berperan sebagai pemicu otomatis yang menjalankan alur kerja SageMaker Pipelines secara konsisten setiap 30 menit sekali. Dengan memanfaatkan konfigurasi aturan jadwal dan role perizinan khusus, EventBridge memastikan data terbaru yang masuk ke Amazon S3 langsung diproses dan diprediksi oleh model tanpa memerlukan intervensi manual dari tim operasional maupun developer setiap kali jadwal tiba.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.