SageMaker MIG NVIDIA GPU Rilis: Trik Partisi GPU AWS Biar Hemat
SageMaker akhirnya ngedukung partisi GPU pakai NVIDIA MIG. Sekarang kamu bisa ngebagi satu GPU jadi beberapa slice mandiri tanpa ribet ngurus Kubernetes!
· 11 menit baca
Inti singkat
- Amazon SageMaker resmi mendukung partisi hardware GPU berbasis NVIDIA Multi-Instance GPU (MIG) lewat inference components.
- Satu GPU fisik bisa diiris sampai tujuh partisi mandiri dengan jaminan isolasi memori dan komputasi di tingkat hardware.
- Uji coba genai-bench membuktikan sepotong H100 (mig-3g.40gb) bisa 18–34% lebih hemat dibanding satu chip A100 utuh.
- Fitur partisi GPU ini sudah aktif di tujuh region AWS, termasuk kawasan terdekat Indonesia seperti Singapura dan Tokyo.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
Amazon SageMaker Inference resmi meluncurkan dukungan partisi GPU berbasis NVIDIA Multi-Instance GPU (MIG) buat memaksimalkan pemakaian chip dan memangkas pemborosan biaya cloud. Lewat fitur baru ini, kamu nggak perlu lagi menyewa satu GPU utuh buat model-model kecil atau menengah, karena satu chip fisik sekarang bisa dibagi jadi beberapa partisi mandiri berisolasi hardware.
Kabar ini diumumkan langsung lewat pengumuman resmi AWS Blog oleh Shantanu Tripathi. Selama ini, kendala paling bikin pusing saat deploy model AI ke endpoint GPU adalah batas unit terkecilnya: kamu wajib memesan satu akselerator penuh. Kalau kamu sewa instance ml.p4d.24xlarge yang punya delapan GPU NVIDIA A100, kapasitas tampungnya mentok di delapan model aja, peduli amat modelmu cuma butuh VRAM 14 GB atau 40 GB.
Akibatnya, tim developer sering terjebak di dua pilihan serba salah: pakai GPU generasi lama yang megap-megap saat request ramai, atau lompat ke GPU generasi baru tapi bayar kapasitas gede yang sebenarnya mubazir. Nah, pembaruan di AWS SageMaker ini datang buat beresin masalah klasik itu.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu Fitur MIG di SageMaker dan Kenapa Bikin Hemat?
NVIDIA Multi-Instance GPU (MIG) adalah teknologi bawaan chip NVIDIA yang bisa membelah satu GPU fisik jadi maksimal tujuh partisi mandiri. Tiap partisi punya jatah core komputasi, cache, kapasitas memori, dan memory bandwidth sendiri yang terisolasi langsung di tingkat hardware.
Sebelum ada update ini di SageMaker, kalau kamu mau mengoptimalkan pemakaian GPU yang longgar, biasanya cuma ada tiga opsi yang semuanya punya kelemahan:
- Pakai endpoint lebih sedikit terus genjot batching: Trik ini cuma jalan kalau model yang kamu jalankan memang seragam. Kalau kamu punya puluhan model hasil fine-tuning berbeda atau model khusus per klien (multi-tenant), trik ini langsung mentok.
- Pakai Multi-Model Endpoints (MME): Skema ini ngeload dan unload model dari GPU secara dinamis pas ada traffic. Cocok buat traffic yang jarang-jarang, tapi nggak ada isolasi hardware sama sekali. Kalau ada satu model kena traffic lonjakan, model lain bakal ikut lemot. Ditambah lagi, ada load penalty alias jeda waktu pas model pertama kali dipanggil.
- Pindah ke Kubernetes mandiri (self-managed EKS): Di Kubernetes, fitur NVIDIA Multi-Instance GPU emang udah bisa dipakai sejak lama. Tapi konsekuensinya repot banget: tim engineering harus ngurusin versi driver sendiri, setup device plugin, konfigurasi partisi, bikin scheduling pod, sampai maintenance armada server.
Dengan hadirnya partisi GPU di SageMaker, semua keribetan platform itu hilang. Kamu tinggal pilih profil partisi yang dimau lewat konfigurasi endpoint, lalu SageMaker yang bakal ngatur setup hardware, penempatan model, sampai urusan scaling di belakang layar.
Cara Kerja Partisi GPU AWS Lewat Inference Components
Fitur partisi GPU ini dibangun langsung di atas pondasi inference components. Buat kamu yang belum familiar, inference component adalah mekanisme di SageMaker yang memungkinkan kamu memasang banyak model di satu endpoint yang sama sambil menentukan jatah CPU dan RAM masing-masing model.
Sekarang, jatah partisi GPU masuk sebagai salah satu parameter resource yang bisa diminta oleh si komponen. Menariknya, pembaruan ini nggak bikin ribet karena nggak ada API baru, nggak ada resource type aneh-aneh, dan nggak butuh izin AWS IAM tambahan. Semuanya cuma nambah dua field opsional di pemanggilan API yang biasa kamu pakai.
Field pertama adalah AcceleratorPartitionLayouts. Parameter ini ditaruh di level ProductionVariants pada saat kamu manggil CreateEndpointConfig. Fungsinya buat mendefinisikan gimana tiap GPU fisik di instance tersebut bakal dipotong.
{
  "EndpointConfigName": "multi-model-partitioned",
  "ExecutionRoleArn": "<execution-role-arn>",
  "ProductionVariants": [
    {
      "VariantName": "AllTraffic",
      "InstanceType": "ml.p4d.24xlarge",
      "InitialInstanceCount": 1,
      "AcceleratorPartitionLayouts": [
        {
          "AcceleratorPartitionTypes": ["mig-4g.20gb", "mig-2g.10gb", "mig-1g.5gb"]
        }
      ]
    }
  ]
}
Potongan di atas menunjukkan contoh pada instance ml.p4d.24xlarge yang punya delapan GPU A100. Satu chip A100 punya tujuh unit komputasi. Layout di atas memakai total 7 unit (4 + 2 + 1), artinya tiap chip A100 bakal dibelah jadi 3 partisi. Karena ada 8 chip di instance itu, total partisi yang siap dipakai di endpoint mencapai 24 partisi!
Field kedua adalah AcceleratorPartitionType, yang dipasang saat kamu mendaftarkan model lewat inference component:
{
  "InferenceComponentName": "summarizer",
  "EndpointName": "multi-model-partitioned",
  "VariantName": "AllTraffic",
  "Specification": {
    "ModelName": "summarizer-model",
    "ComputeResourceRequirements": {
      "AcceleratorPartitionType": "mig-4g.20gb",
      "NumberOfAcceleratorDevicesRequired": 1,
      "NumberOfCpuCoresRequired": 1,
      "MinMemoryRequiredInMb": 2048
    }
  },
  "RuntimeConfig": { "CopyCount": 1 }
}
Di konfigurasi komponen ini, NumberOfAcceleratorDevicesRequired nilainya tetap diisi 1, yang artinya kamu meminta 1 unit partisi bertipe mig-4g.20gb, bukan 1 chip GPU utuh. Menariknya lagi, saat client aplikasi memanggil endpoint lewat InvokeEndpoint, caranya sama persis seperti biasa. Aplikasi kamu tinggal menyebut nama komponen tanpa perlu tahu model itu lagi duduk di partisi GPU sebelah mana.
Daftar Profil GPU yang Didukung: A100, H100, sampai Blackwell
Pilihan profil partisi yang tersedia bergantung penuh pada kartu akselerator yang terpasang di instance kamu. Kamu bisa mengecek panduan lengkap di daftar NVIDIA supported MIG profiles. Berikut daftar instance AWS dan profil partisi yang didukung:
| Keluarga Instance | Akselerator GPU | Total VRAM | Rasio Irisan (Komputasi / Memori) | Pilihan Profil Partisi yang Tersedia | Maksimal Partisi per GPU |
|---|---|---|---|---|---|
| P4d | NVIDIA A100 | 40 GB | 7 / 8 | mig-1g.5gb, mig-1g.10gb, mig-2g.10gb, mig-3g.20gb, mig-4g.20gb, mig-7g.40gb | 7 |
| P5 | NVIDIA H100 | 80 GB | 7 / 8 | mig-1g.10gb, mig-1g.20gb, mig-2g.20gb, mig-3g.40gb, mig-4g.40gb, mig-7g.80gb | 7 |
| G7 | NVIDIA RTX PRO 4500 Blackwell | 32 GB | 2 / 2 | mig-1g.16gb, mig-2g.32gb | 2 |
| G7e | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 GB | 4 / 4 | mig-1g.24gb, mig-2g.48gb, mig-4g.96gb | 4 |
Cara membaca kodenya gampang banget: angka sebelum huruf g adalah jumlah unit komputasi, dan angka setelah titik adalah kapasitas VRAM. Contohnya, mig-3g.40gb pada H100 berarti partisi itu dapat jatah 3 unit komputasi dan VRAM 40 GB.
Hasil Benchmark: Sepotong H100 Lawan Satu A100 Utuh
Banyak developer mikir, mending sewa satu GPU A100 utuh generasi lama atau sewa sepotong GPU H100 generasi baru? Tim AWS ngelakuin pengujian langsung pakai tool benchmark populer genai-bench buat membandingkan satu partisi mig-3g.40gb pada instance P5 (NVIDIA H100) melawan satu chip penuh NVIDIA A100-40GB pada instance P4d.
Keduanya menjalankan model yang sama persis, yaitu Llama-3.1-8B-Instruct, dengan container image, tokenizer, dan setting client yang identik. Pengujian dilakukan di lima pola ukuran prompt dan output token, dengan variasi concurrency dari 2 sampai 512 request bersamaan.
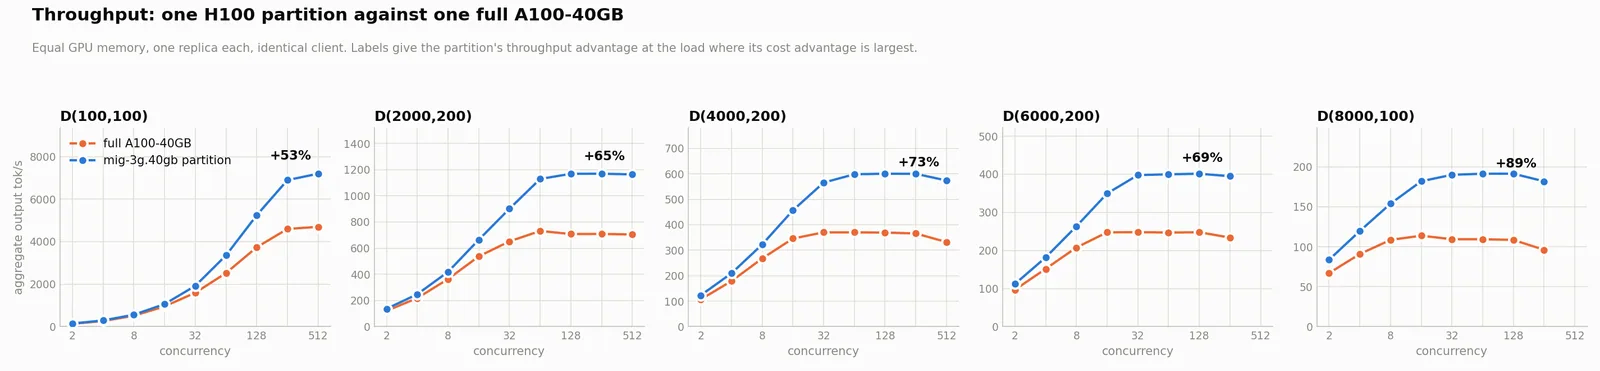
Hasil pengujiannya nunjukin beberapa fakta menarik:
- Partisi H100 menang telak di urusan kecepatan: Di semua skenario pengujian, partisi H100 menghasilkan output token per detik 53% hingga 89% lebih tinggi pas beban traffic puncak. Jeda waktu antartoken (inter-token latency) juga lebih gesit antara 8,9% sampai 42,1%.
- Waktu tunggu respon pertama lebih singkat: Metrik Time to First Token (TTFT) di partisi H100 tercatat 5,6% hingga 47,5% lebih cepat dibanding A100 utuh.
- A100 rontok di context panjang: Pada beban prompt panjang (6.000 dan 8.000 token) dengan concurrency tinggi, GPU A100 gagal melayani sepertiga sampai separuh request karena nabrak batas serving deadline. Sebaliknya, partisi H100 sukses memproses semua request tanpa ada yang gagal satu pun.
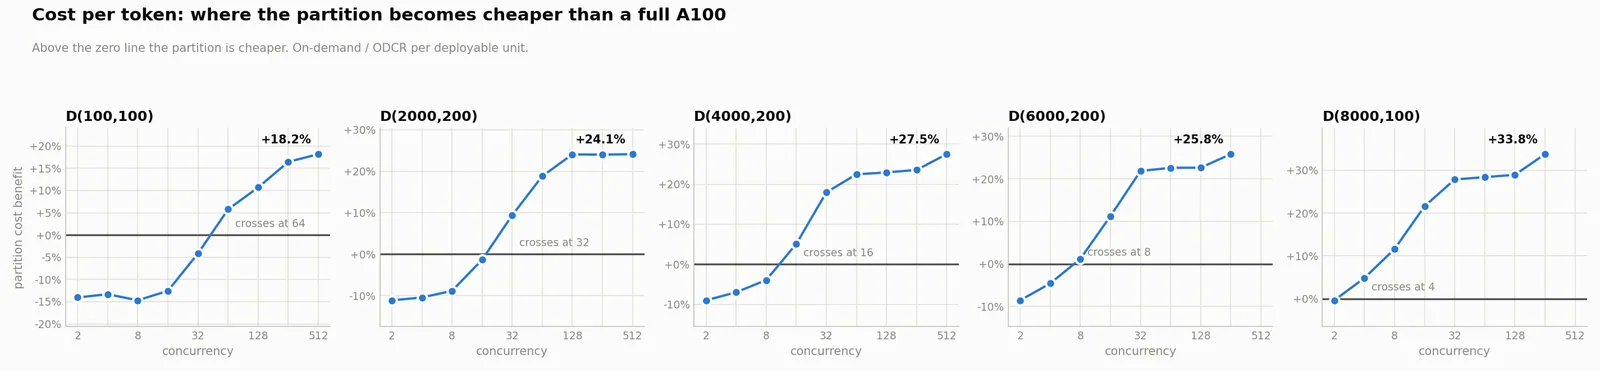
Gimana dengan biayanya? Sebagai gambaran, harga on-demand di region US West (Oregon) saat analisis dilakukan adalah $25.251286 per jam buat ml.p4d.24xlarge (punya 8 unit A100, sekitar $3,15 per GPU per jam) dan $63.296000 per jam buat ml.p5.48xlarge (bisa dibagi jadi 16 unit partisi mig-3g.40gb, sekitar $3,95 per partisi per jam).
Secara biaya per satu juta token, partisi H100 ternyata 18% sampai 34% lebih murah begitu melewati titik crossover. Untuk prompt pendek (100 token), crossover terjadi pas concurrency menyentuh angka 64. Tapi untuk prompt panjang (8.000 token), titik hematnya udah kerasa sejak concurrency 4! Kalau traffic kamu santai atau promptnya pendek banget, satu chip A100 memang masih lebih murah. Tapi begitu aplikasi kamu mulai ramai, sepotong H100 jelas menang telak di performa maupun efisiensi kantong.
Cara Menentukan Layout Partisi Biar Nggak Kehabisan VRAM
Saat menyusun layout partisi, kamu harus paham perbedaan kerja antara unit komputasi dan memori GPU pas melayani inferensi model bahasa:
- Unit Komputasi (Compute): Dipakai paling berat pas fase prefill, yaitu momen saat model membaca keseluruhan prompt input kamu. Makin panjang prompt dan makin banyak request masuk barengan, makin banyak core komputasi yang kamu butuhkan biar respon pertama nggak lelet.
- Unit Memori (VRAM & Bandwidth): Dipakai pas fase decode (menghasilkan token kata demi kata). Decode sangat dibatasi oleh kecepatan transfer memori (memory bandwidth). Selain itu, VRAM bertugas menampung ruang KV cache yang ukurannya membesar mengikuti panjang konteks dan jumlah user aktif.
Banyak developer pemula bikin salah perhitungan karena cuma ngitung ukuran bobot model (model weights). Sebagai contoh, model Llama ukuran 8B pada format FP16 butuh memori sekitar 16 GB. Tapi kalau kamu pasang di partisi 20 GB, aplikasimu bisa gampang out of memory (OOM) pas diserbu banyak user.
Buat arsitektur sistem yang lebih kompleks, kamu juga bisa menggabungkan pola ini dengan alur pipeline agen AI. Kamu bisa baca trik integrasi backend agen di artikel MCP Server ECS Fargate Data Lake AI atau panduan keamanan remote di Claude Code Bedrock AgentCore Remote Agent buat memperkaya arsitektur cloud kamu.
Kapan Sebaiknya Pakai Partisi GPU SageMaker?
Richard Chang, Software Engineering Architect di Salesforce, menyebutkan bahwa perusahaannya ikut menguji solusi ini sejak awal. Menurut Salesforce, banyak beban kerja inferensi AI yang sebenarnya nggak memerlukan satu chip GPU utuh. Partisi hardware bikin konsolidasi server jadi jauh lebih aman dan hemat biaya.
Fitur SageMaker MIG ini sangat pas kamu terapkan pada beberapa skenario berikut:
- Koleksi Model Kecil dan Menengah: Menjalankan model embedding, reranker, guardrail keselamatan, atau model classifier barengan dalam satu GPU tanpa saling ganggu.
- Aplikasi Multi-Tenant: Saat kamu menghosting satu model terpisah buat tiap klien bisnis. Proteksi memori antarpartisi dijamin lewat hardware, bikin audit kepatuhan data jadi lebih gampang.
- Pipeline AI Multi-Tahap: Menaruh model speech-to-text, model bahasa, dan text-to-speech di satu instance yang sama. Hasilnya, latensi jaringan antarmodel hilang total karena proses komunikasi terjadi di dalam mesin yang sama.
- Pengujian Model Baru (Canary/Challenger): Menguji model versi baru di partisi kecil berdampingan dengan model utama yang melayani traffic produksi, tanpa perlu keluar duit buat bikin endpoint kedua.
Batasan Teknis yang Wajib Kamu Catat
Meskipun kelihatan fleksibel banget, ada beberapa batasan fitur yang wajib kamu ketahui sebelum merancang arsitektur produksi:
- Profil Partisi Bersifat Permanen: Tipe partisi sebuah komponen dikunci saat komponen dibuat. Kalau kamu mau ganti ukuran profil, kamu harus bikin komponen baru. Mengubah konfigurasi layout endpoint juga nggak bakal memotong ulang instance yang sudah berjalan, jadi kamu harus deploy endpoint baru dan migrasi traffic.
- Tidak Berlaku untuk Serverless dan Async: Partisi GPU cuma didukung buat real-time endpoint yang memakai inference components. Endpoint bertipe serverless, async invocation, dan heterogeneous instance pools belum bisa memakainya.
- Tidak Bisa Menyeberang Antar-GPU: Satu partisi nggak bisa menggabungkan VRAM dari dua kartu grafis berbeda. Kalau modelmu super gede dan butuh multi-GPU, kamu tetap wajib pakai GPU utuh.
- Skema Penagihan AWS Tetap per Jam Instance: AWS tetap menagih biaya sewa instance penuh per jam seperti biasa. Partisi ini bikin kamu bisa memeras utilisasi mesin sampai tetes terakhir, bukan memotong tarif dasar per jam dari server AWS tersebut.
Untuk ketersediaan wilayah, fitur ini sudah bisa kamu pakai di region US East (N. Virginia), US East (Ohio), US West (Oregon), Asia Pacific (Singapore), Asia Pacific (Tokyo), Europe (Frankfurt), dan Europe (Ireland). Buat developer di Indonesia, memilih region Singapura atau Tokyo adalah opsi paling pas buat dapetin latensi jaringan yang paling rendah.
Kalau kamu mau langsung bereksperimen dengan kodenya, AWS menyediakan GPU partitioning sample notebook yang bisa kamu clone langsung ke environment kerja kamu.
Kalau kamu merasa setup infrastruktur cloud AWS, ngatur layout partisi JSON, dan maintenance instance GPU terlalu makan waktu untuk kebutuhan produkmu sekarang, ada opsi yang jauh lebih simpel. Kamu bisa memanfaatkan Classai Router. Lewat satu API key yang kompatibel penuh dengan SDK OpenAI dan Anthropic, kamu bisa langsung memanggil model kencang seperti deepseek-v4.1-flash-1017 seharga Rp1.155 per 1 juta token input dan Rp4.200 per 1 juta token output, atau gemini-3.8-flash seharga Rp2.100 per 1 juta token input. Nggak perlu repot mikirin sewa instance ratusan dollar per bulan, cukup bayar token yang beneran kamu pakai lewat pembayaran lokal seperti QRIS dan virtual account.
Sumber & referensi
- 01
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa keunggulan NVIDIA MIG di SageMaker dibanding multi-model endpoints biasa?
NVIDIA MIG membagi GPU langsung di tingkat hardware sehingga tiap partisi punya alokasi core, cache, dan bandwidth memori sendiri. Beda dengan multi-model endpoints yang bergantian memakai memori tanpa isolasi, partisi MIG menjamin latensi tetap stabil dan nggak ada masalah cold start.
Apakah partisi GPU ini otomatis bikin tagihan AWS saya turun?
Tagihan per jam untuk sewa instance GPU sebenarnya tetap sama seperti biasa. Tapi biayanya jadi jauh lebih hemat karena satu instance sekarang bisa menampung banyak model sekaligus, sehingga kamu nggak perlu menyewa banyak server GPU terpisah.
Apakah kita bisa mengubah ukuran partisi GPU secara langsung saat server jalan?
Nggak bisa. Pengaturan partisi GPU dikunci saat endpoint pertama kali dibuat dan hanya bisa diproses saat kondisi idle. Kalau kamu butuh mengubah ukuran partisi, kamu harus membuat endpoint baru lalu mengalihkan traffic aplikasi ke endpoint tersebut.
Region AWS mana yang paling cocok dipilih untuk developer di Indonesia?
Region Asia Pacific (Singapore) dan Asia Pacific (Tokyo) adalah pilihan terbaik buat pengguna di Indonesia. Kedua lokasi ini sudah mendukung fitur partisi GPU SageMaker dan menawarkan latensi jaringan yang paling singkat dibanding region Amerika atau Eropa.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.