MCP Server ECS Fargate: Trik AWS Hubungkan Agen AI ke Data Lake
AWS membagikan arsitektur serverless MCP server di Amazon ECS Fargate. Tambah dataset ke agen AI kini cukup modal satu file JSON tanpa bikin ulang kode.
· 8 menit baca
Inti singkat
- AWS merilis pola arsitektur serverless MCP server di Amazon ECS Fargate untuk akses data lake terpusat.
- Proses onboarding dataset baru kini hanya butuh file metadata JSON tanpa perlu menulis kode integrasi tambahan.
- Sistem memakai FastMCP dan Amazon Bedrock dengan latensi kueri rata-rata sekitar 15 hingga 20 detik.
- Keamanan diperketat lewat aturan SELECT-only di level tool, Bedrock Guardrails, serta isolasi subnet privat.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Tim internal AWS berhasil membangun arsitektur serverless MCP server di Amazon ECS Fargate untuk menghubungkan agen AI langsung ke data lake perusahaan tanpa perlu koding ulang tiap kali ada tabel baru. Pendekatan berbasis metadata ini memangkas proses integrasi data yang biasanya makan waktu berhari-hari jadi hitungan menit saja.
Menghubungkan asisten pintar atau agen AI ke data lake kantor biasanya bikin pusing developer. Masalah klasiknya selalu sama: setiap kali tim bikin bot baru, mereka harus nulis ulang logika SQL, mapping schema tabel, sampai aturan hak akses dari nol. Begitu ada struktur tabel yang berubah, semua agen ikutan rusak. Lewat pembahasan resmi tim AWS, tim North America Sort Center (NASC) Amazon membeberkan cara mereka mengatasi masalah ini memakai Model Context Protocol (MCP) yang jalan di atas infrastruktur serverless.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Integrasi Agen AI ke Data Lake Sering Bikin Pusing?
Di jaringan operasional NASC Amazon, tim perencana sangat bergantung pada data metrik harian buat mengatur kapasitas gudang, tenaga kerja, dan arus paket. Waktu banyak tim ingin bikin asisten AI percakapan sendiri, arsitektur awal mereka langsung kewalahan.
Setiap bot punya jalur integrasi sendiri-sendiri ke database. Developer harus menanamkan logika pembuatan SQL dan pemahaman skema langsung di dalam prompt atau kode agen. Akibatnya, ada beberapa masalah berat yang muncul:
- Integrasi terfragmentasi: Nggak ada pintu gerbang terpusat buat mengaudit siapa yang mengakses data apa.
- Onboarding data lelet: Menambahkan satu tabel baru ke agen AI butuh waktu berhari-hari karena developer harus menulis custom tool, validasi kueri, dan deploy ulang aplikasi.
- Schema drift: Begitu nama kolom atau tipe data di data lake berubah, agen AI langsung salah bikin SQL dan menghasilkan jawaban ngawur.
Untuk menyelesaikannya, tim NASC menetapkan empat target utama: akses data lake berbasis konfigurasi (cukup file metadata, bukan kode), antarmuka tool yang agnostik terhadap jenis agen, penegakan izin terpusat, dan infrastruktur elastis yang bisa naik-turun otomatis mengikuti lonjakan beban kueri AI.
Mengenal Arsitektur Serverless MCP Server ECS Fargate
Solusi yang dibangun AWS memisahkan sistem ke dalam empat lapisan independen: client layer, MCP server layer, tools layer, dan knowledge-base refresh layer. Kunci utamanya ada pada pemisahan antara agen AI dengan tool akses data.
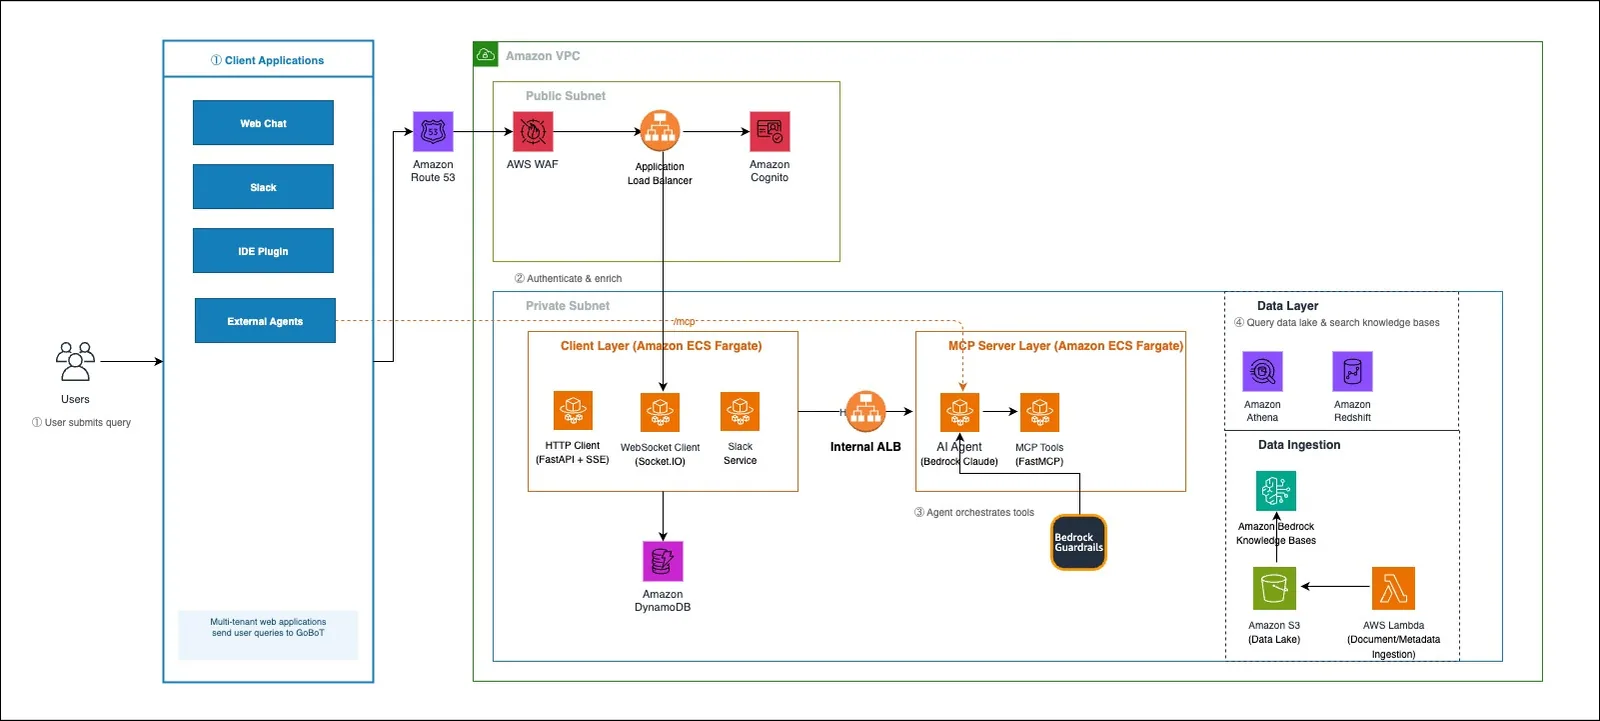
Alur kerjanya dimulai dari pengguna yang mengirimkan pertanyaan lewat web chat, Slack, plugin IDE, atau agen eksternal. Permintaan ini masuk lewat Amazon Route 53, disaring AWS WAF di Application Load Balancer (ALB) publik, lalu diautentikasi oleh Amazon Cognito. Dari sana, request diteruskan ke client layer di subnet privat Amazon ECS Fargate yang menyimpan riwayat sesi di Amazon DynamoDB.
Setelah itu, request masuk ke MCP server layer via internal ALB. Di lapisan inilah model Amazon Bedrock mengorkestrasi tools yang dibangun memakai FastMCP (framework Python untuk bikin MCP server). Bedrock Guardrails dipasang di setiap interaksi model buat menyaring konten berbahaya dan menangkal percobaan prompt injection. Di sisi backend data, Amazon Athena dan Amazon Redshift bertugas menjalankan kueri SQL, sementara Amazon Bedrock Knowledge Bases menangani pencarian semantik dokumen.
Cara Kerja 4 Lapisan Sistem: Dari Chat Sampai Data Lake
Pemisahan tanggung jawab di tiap lapisan bikin sistem ini sangat stabil dan gampang dirawat:
1. Lapisan Klien (Client Layer)
Lapisan ini berjalan di container ECS Fargate dan bertugas mengelola autentikasi token JWT dari Amazon Cognito serta riwayat percakapan di DynamoDB. Di sini juga ada konfigurasi pemetaan konteks (context mapping) yang membatasi pencarian tabel agar agen nggak kebingungan membaca ribuan skema sekaligus.
2. Lapisan Server MCP (MCP Server Layer)
Server MCP berjalan di cluster ECS Fargate terpisah dalam subnet privat tanpa akses internet langsung. Tugasnya menerima panggilan lewat endpoint standar /mcp berbasis JSON-RPC. Tugas Fargate di sini bersifat stateless, jadi container bisa ditambah, dikurangi, atau diganti sewaktu-waktu tanpa khawatir kehilangan status obrolan yang tersimpan di DynamoDB.
3. Lapisan Tools (Tools Layer)
Semua perkakas kerja didaftarkan lewat FastMCP dan bisa ditemukan otomatis oleh agen saat runtime. Tool utamanya mencakup:
| No | Nama Tool | Backend | Fungsi Utama |
|---|---|---|---|
| 1 | SQL query tools | Amazon Athena & Redshift | Eksekusi kueri SQL ke dataset data lake dan data warehouse |
| 2 | Document & metadata search | Amazon Bedrock Knowledge Bases | Pencarian semantik untuk dokumentasi internal, metadata tabel, dan wiki |
| 3 | Policy search | Amazon Bedrock Knowledge Bases | Pencarian aturan operasional dan prosedur standar (SOP) |
4. Lapisan Refresh Knowledge Base
Lapisan ini memastikan katalog metadata selalu mutakhir. Setiap kali ada file metadata baru diunggah ke Amazon S3, AWS Lambda otomatis memprosesnya, menghasilkan embedding vektor lewat Amazon Titan Text Embeddings, dan memasukkannya ke Bedrock Knowledge Bases.
Onboarding Dataset Baru Cuma Modal File JSON
Bagian paling menarik dari arsitektur ini adalah cara menambahkan tabel baru ke agen AI. Developer atau data engineer nggak perlu menyentuh kode Python sama sekali. Cukup siapkan satu file JSON metadata seperti ini:
{
  "database_service_name": "athena",
  "database_name": "analytics_db",
  "table_name": "regional_order_summary",
  "business_description_for_the_table": "Regional order history with shipping status and delivery performance. Refreshes daily. In Athena SQL, always use date() to wrap string literals when comparing against timestamp columns.",
  "column_details": {
    "order_id [varchar]": {
      "description": "Unique order identifier assigned at checkout.",
      "sample_values": ["ORD-20250115-001234", "ORD-20250116-005678"]
    },
    "order_date [timestamp(3)]": {
      "description": "Date and time the order was placed. Use this column for time-range filtering.",
      "sample_values": ["2025-01-15 08:00:00.000", "2025-01-16 12:30:00.000"]
    },
    "warehouse_id [varchar]": {
      "description": "Fulfillment center that processed the order.",
      "sample_values": ["FC-EAST-07", "FC-WEST-03", "FC-SOUTH-12"]
    }
  },
  "load_type": "Incremental (refreshes last 7 days)",
  "refresh_frequency": "Daily at 6:00 AM UTC",
  "table_size": "~2.1B rows",
  "creation_time": "2024-03-15",
  "last_refresh_time": "2025-05-20T06:00:00Z"
}
Perhatikan bagian business_description_for_the_table. Di situ developer bisa menyelipkan instruksi khusus mesin kueri, misalnya panduan sintaks Athena yang mewajibkan fungsi date() saat membandingkan string dengan kolom timestamp. Selain itu, contoh nilai di sample_values bikin model paham format data riil—misalnya kode gudang berupa FC-EAST-07, bukan tulisan panjang.
Kamu juga bisa menambahkan konfigurasi pemetaan konteks opsional buat mempercepat pencarian:
{
  "delivery_metrics": {
    "description": "Delivery accuracy and defect attribution data",
    "tables": ["analytics_db.customer_orders_summary"],
    "sources": {"wiki": [], "quip": []}
  }
}
Dalam pengujian AWS, pembatasan cakupan konteks ini berhasil menjaga total latensi interaksi dari awal chat sampai jawaban keluar di rentang 15–20 detik saja.
Keamanan Ketat dan Dukungan Multi-Tenant
Menyambungkan LLM ke data sensitif perusahaan tentu butuh kontrol ketat. Di arsitektur ini, AWS menerapkan sistem keamanan berlapis:
- Isolasi Jaringan: Server MCP berada di private subnet di balik internal ALB, sama sekali nggak bisa diakses dari internet publik.
- Kueri Khusus SELECT: Tool Athena di level server mengunci kueri hanya untuk operasi baca (SELECT-only). Segala perintah tulis, ubah, atau hapus (
INSERT,UPDATE,DROP) langsung ditolak sebelum sempat dikirim ke data lake. - Audit Terpusat: Semua pemanggilan tool dicatat ke Amazon CloudWatch dalam format JSON terstruktur. Tim keamanan punya satu titik log audit untuk memantau semua akses data dari berbagai aplikasi.
- Amazon Bedrock Guardrails: Setiap input dan output disaring buat mencegah prompt injection dan memastikan jawaban model tetap berbasis data (grounded).
Karena endpoint /mcp memakai protokol standar industri, server ini bisa dipakai banyak agen sekaligus (multi-tenant). Agen analisis data, agen notifikasi operasional, maupun asisten IDE seperti Amazon Q Developer bisa mengakses tool data lake yang sama tanpa perlu bikin ulang sistem autentikasi.
Skalabilitas Serverless di Tiap Lapisan
Salah satu keunggulan utama dari kombinasi Fargate dan layanan terkelola AWS adalah kemampuan adaptasi bebannya tanpa perlu pusing mikirin server fisik:
| Lapisan Arsitektur | Mekanisme Skalabilitas | Pemicu (Trigger) |
|---|---|---|
| Klien (ECS Fargate) | ECS Service Auto Scaling | Utilisasi CPU (ambang batas 50%) |
| Server MCP (ECS Fargate) | ECS Service Auto Scaling | Utilisasi CPU dan Memori |
| Mesin Data (Athena) | Serverless otomatis bawaan AWS | Jumlah konkurensi kueri SQL |
| Fondasi AI (Amazon Bedrock) | Managed service scaling bawaan AWS | Volume permintaan inferensi model |
Dengan arsitektur ini, sistem bisa menangani satu pertanyaan santai sampai ratusan kueri serentak dari berbagai divisi tanpa perlu ubah konfigurasi infrastruktur sama sekali.
Dampak Nyata Buat Tim Developer dan Bisnis di Indonesia
Buat perusahaan di Indonesia yang sedang mengembangkan asisten AI internal—baik di sektor logistik, perbankan, maupun e-commerce—pola MCP terpusat ini menawarkan solusi buat beberapa tantangan besar:
- Efisiensi Biaya Engineering: Developer nggak perlu membuang waktu berminggu-minggu menyambungkan database ke bot baru. Cukup satu tim data engineer yang memelihara file JSON metadata.
- Kepatuhan Privasi Data (UU PDP): Menyatukan akses data lake lewat satu gateway privat mempermudah kepatuhan terhadap aturan perlindungan data pribadi. Log CloudWatch terpusat memudahkan pembuktian audit jika terjadi kebocoran atau akses data mencurigakan.
- Pemisahan Logika Agen dan Data: Model AI berkembang sangat cepat. Kalau besok kamu mau ganti model LLM atau pindah framework orkestrasi, data lake dan logika tool-mu tetap utuh di server MCP tanpa perlu dirombak.
Kalau kamu sedang membangun backend agen koding atau asisten internal serupa dan butuh integrasi berbagai model LLM lewat satu pintu hemat biaya, kamu bisa memanfaatkan Classai Router. Lewat Classai Router, kamu bisa memanggil model seperti DeepSeek V4.1 Flash 1017 (Rp1.155 input / Rp4.200 output per 1 juta token) atau Gemini 3.8 Flash (Rp2.100 input / Rp8.400 output) cukup dengan satu API key kompatibel OpenAI tanpa pusing kartu kredit luar negeri.
Kamu juga bisa mengasah kemampuan teknis membangun agen AI cerdas lewat kelas AI untuk Developer atau panduan API di Tutorial Classai Router Coding.
Bagi kamu yang ingin mengeksplorasi integrasi agen cerdas dengan sistem cloud AWS lainnya, simak juga pembahasan kami tentang Claude Code Bedrock AgentCore dan teknik optimasi konteks di Context Engineering AI Agent.
Contoh Prompt Pengujian Kueri Data Lake
Untuk menguji apakah agen AI milikmu mampu memilih tabel dan menyusun klausa SQL dengan benar berdasarkan metadata yang diberikan, kamu bisa mencoba template prompt pengujian berikut:
Kamu adalah agen analis data lake SQL. Gunakan konteks metadata tabel berikut untuk menjawab pertanyaan pengguna. [METADATA TABEL]Nama: analytics_db.regional_order_summaryKolom:- order_id (varchar): ID unik order, contoh: 'ORD-20250115-001234'- order_date (timestamp): Tanggal order dibuat- total_amount (double): Total nilai transaksi- warehouse_id (varchar): Kode fulfillment center, contoh: 'FC-EAST-07'Aturan Mesin Athena: Selalu gunakan date() saat membandingkan string dengan kolom tanggal. Pertanyaan Pengguna: "Tampilkan 10 pesanan dengan nilai transaksi terbesar dari gudang FC-EAST-07 dalam 30 hari terakhir." Tugasmu:1. Tentukan kolom yang relevan.2. Tulis kueri SQL SELECT yang valid sesuai aturan Athena.3. Jangan buat kueri selain SELECT.
Sumber & referensi
- 01
AWS · 7 November 2026
Serverless MCP server for AI agent data lake access on Amazon ECS Fargate
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu MCP server di Amazon ECS Fargate?
MCP server di ECS Fargate adalah aplikasi gateway berbasis Model Context Protocol yang berjalan secara serverless di container AWS. Fungsinya menjembatani agen AI dengan data lake dan database perusahaan agar bot bisa mengambil data lewat antarmuka standar tanpa konfigurasi rumit.
Mengapa memakai Fargate bukan server EC2 biasa?
AWS Fargate menghilangkan kerepotan mengelola instans server fisik dan patch sistem operasi. Fargate otomatis menaikkan atau menurunkan jumlah container sesuai beban kueri agen AI, sehingga biaya operasional jauh lebih hemat karena kamu cuma bayar komputasi yang terpakai.
Bagaimana cara kerja penambahan tabel baru di arsitektur ini?
Developer cukup membuat file metadata berformat JSON yang berisi nama database, deskripsi bisnis, struktur kolom, dan contoh data. File ini diunggah ke S3, lalu diindeks otomatis ke Amazon Bedrock Knowledge Bases sehingga langsung terbaca oleh agen AI tanpa perlu coding ulang.
Apakah agen AI bisa merusak atau mengubah data lake?
Tidak bisa. Arsitektur ini menerapkan aturan SELECT-only secara ketat di level tool kueri Athena sebelum perintah dikirim ke database, sehingga seluruh upaya penulisan, modifikasi, atau penghapusan data otomatis ditolak oleh sistem.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.