Kokoro TTS SageMaker: Solusi Voice Agent Cepat Tanpa Lemot
Nunggu voice agent selesai mikir sebelum ngomong bikin pengguna bete. Ini panduan deploy Kokoro TTS di SageMaker buat streaming suara instan.
· 10 menit baca
Inti singkat
- Menunggu seluruh teks selesai sebelum sintesis suara bikin jeda percakapan voice agent molor sampai lima detik.
- Streaming per kalimat ke model Kokoro-82M memangkas waktu audio pertama hingga 52,4 persen pada level transport.
- Uji coba menyeluruh bersama model bahasa di Bedrock AgentCore terbukti 3,5 kali lebih cepat dibanding cara batch biasa.
- Mengirim audio biner murni lewat WebSocket menghindari pembengkakan ukuran data 33 persen akibat encoding base64 di SSE.
- Auto scaling Kokoro-82M di SageMaker lebih akurat diatur memakai metrik ConcurrentRequestsPerModel berbasis tes Q_max dan T_total.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
AWS membagikan arsitektur streaming voice agent memakai model text to speech Kokoro-82M di Amazon SageMaker AI. Metode ini sukses memangkas waktu tunggu audio pertama sampai 3,5 kali lebih cepat dibanding sistem batch biasa.
Pernah nggak kamu ngobrol bareng asisten suara AI, terus sehabis kamu nanya, suasananya hening canggung sampai lima detik? Agen AI sebenarnya udah tahu jawabannya dan lagi sibuk menyusun respons panjang beberapa paragraf. Masalahnya, integrasi text to speech (TTS) konvensional baru mulai bekerja mengubah teks jadi suara sehabis semua kalimat selesai dibuat. Jeda lama begini jelas bikin pengguna bingung dan malas lanjut ngobrol.
Kabar baiknya, tim Machine Learning AWS membagikan solusi praktis buat menutup celah itu lewat arsitektur bidirectional streaming. Alih-alih menunggu paragraf selesai, teks dialirkan kalimat demi kalimat ke model Kokoro-82M yang berjalan di Amazon SageMaker AI. Yuk, kita bedah langkah teknisnya sampai tuntas biar kamu bisa bikin voice agent yang responsif dan hemat biaya.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Voice Agent Sering Bikin Pengguna Nunggu Kelamaan?
Masalah utama integrasi audio pada agen AI ada di perbedaan kecepatan antara pembuatan teks dan pengolahan suara. Kalimat pertama mungkin selesai dibuat oleh model bahasa dalam waktu 600 milidetik, tapi respons utuh yang panjang butuh sekitar lima detik. Kalau aplikasi kamu menunggu seluruh teks tuntas baru dikirim ke pipeline audio, ada jeda kosong lima detik yang bikin interaksi terasa kaku banget.
Biar jeda itu hilang, proses sintesis suara kudu dijalankan berbarengan dengan proses generasi teks. Begitu kalimat pertama selesai dirangkai oleh agen AI, potongan itu langsung dikirim ke model TTS tanpa menunggu kalimat berikutnya. Pendekatan ini bikin browser atau aplikasi pengguna bisa langsung memutar suara selagi model bahasa di latar belakang masih sibuk mengetik kalimat berikutnya.
Selain urusan streaming per kalimat, pemilihan model suara juga memegang peran penting. Model suara raksasa butuh kartu grafis mahal dan sering makan waktu lama buat memproses audio. Di sinilah model kecil berkecepatan tinggi jadi pilihan yang pas buat kebutuhan produksi nyata.
Mengenal Arsitektur Kokoro TTS SageMaker: Ringan dan Irit GPU
Kokoro-82M cuma punya 82 juta parameter. Ukuran mungil ini bikin Kokoro-82M enteng dijalankan pada satu instans GPU kelas menengah seperti ml.g5.xlarge di Amazon SageMaker AI. Biaya sewanya jadi jauh lebih ramah di kantong dan latensi inferensinya tetap rendah buat melayani percakapan dinamis.
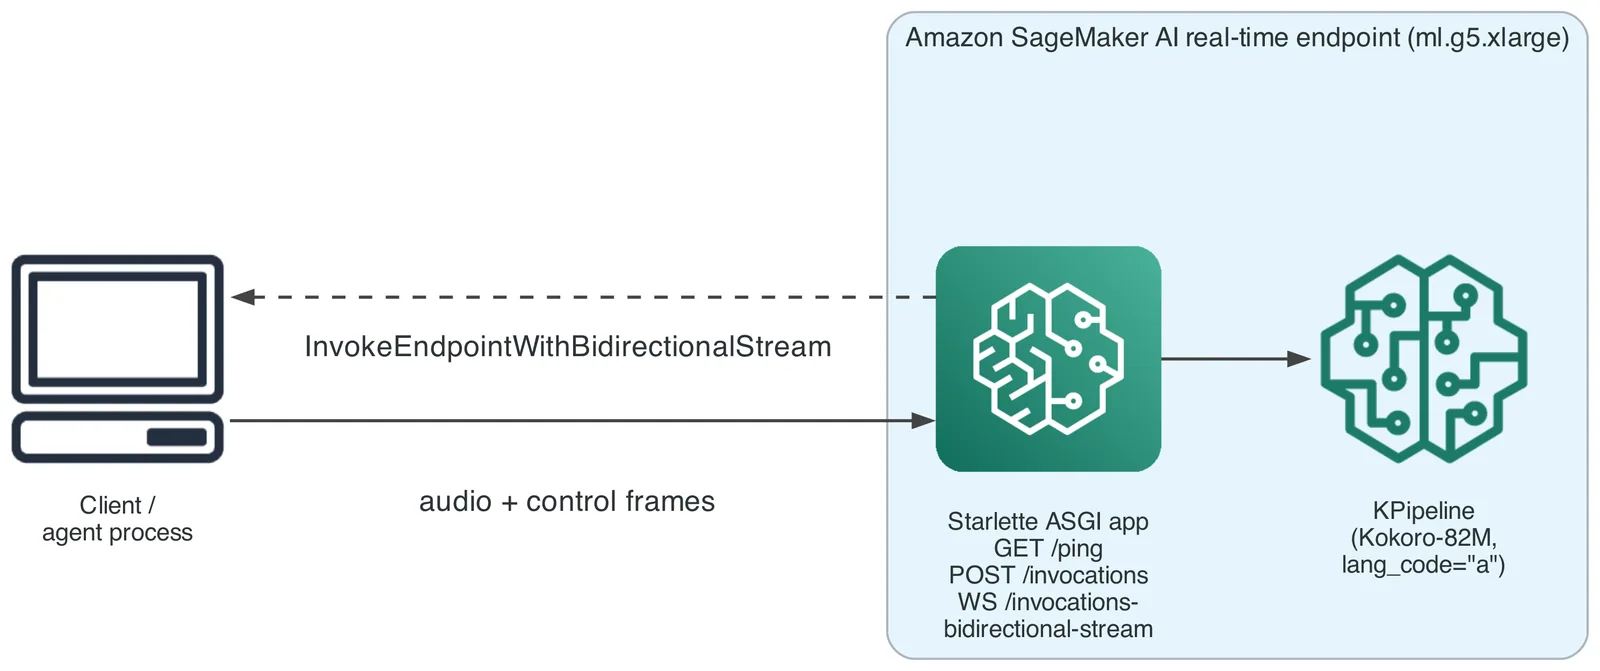
Model ini berbasis arsitektur StyleTTS2 dengan decoder ISTFTNet yang non-autoregressive. Artinya, model nggak memprediksi token audio satu demi satu secara berulang, melainkan memproses audio kalimat utuh dalam satu lintasan selaras durasi. Container khusus yang disiapkan di SageMaker membuka dua jalur endpoint: rute POST /invocations untuk streaming audio satu arah, dan WS /invocations-bidirectional-stream untuk koneksi dua arah yang terus terbuka.
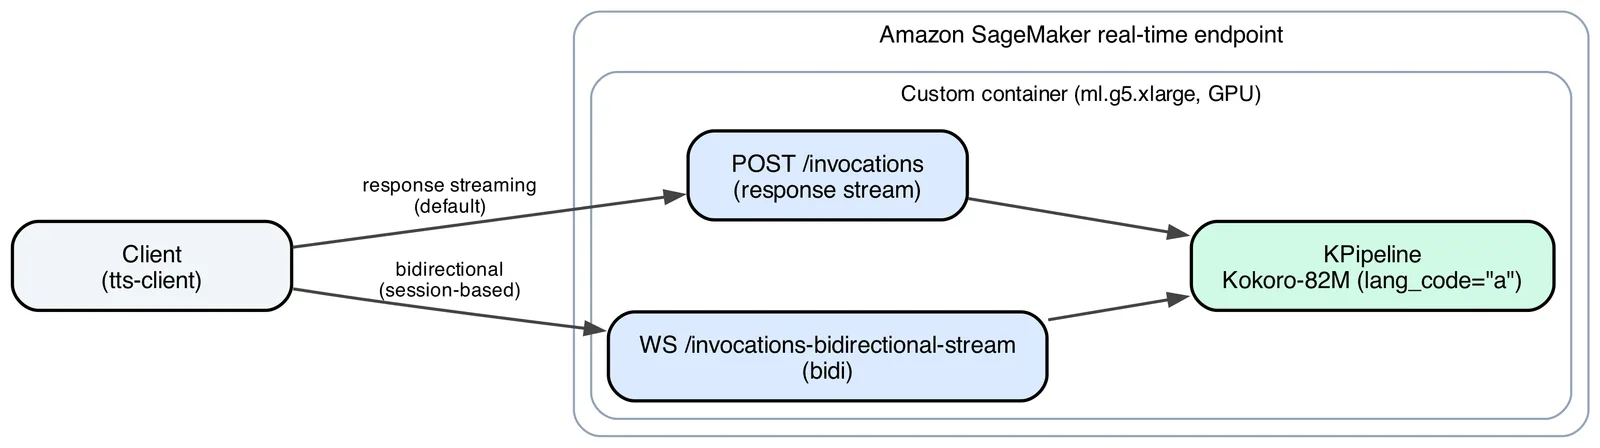
Buat menyiapkan infrastruktur ini, kamu butuh akun AWS yang punya izin membuat endpoint SageMaker AI, Amazon Bedrock AgentCore, IAM role, serta repository Amazon ECR. Proses deployment dikelola rapi memakai AWS CDK v2 dan pengelola paket uv dengan Python 3.12 ke atas.
Langkah 1 & 2: Atasi Masalah Frame WebSocket dan Jaga Sesi Tetap Nyala
Saat mulai meracik kode container di SageMaker, ada kendala umum yang sering bikin bingung developer. Jalur streaming dua arah di SageMaker AI mengirimkan pesan klien ke container dalam format frame biner WebSocket. Kalau kamu membangun server memakai framework Starlette dan langsung memanggil fungsi bawaan receive_text(), handler bakal error melempar KeyError: 'text'.
Error ini sering salah dipahami karena endpoint di konsol AWS tetap berstatus InService, tapi tiap ada request yang masuk responsnya selalu gagal. Biar aman dari masalah framing ini, container harus bisa menerima data teks maupun biner secara fleksibel seperti contoh berikut:
from starlette.websockets import WebSocket, WebSocketDisconnect

async def _receive_message(websocket: WebSocket) -> str:
    message = await websocket.receive()
    if message["type"] == "websocket.disconnect":
        raise WebSocketDisconnect(message.get("code", 1000))
    payload = message.get("text")
    if payload is None:
        payload = message.get("bytes", b"").decode("utf-8")
    return payload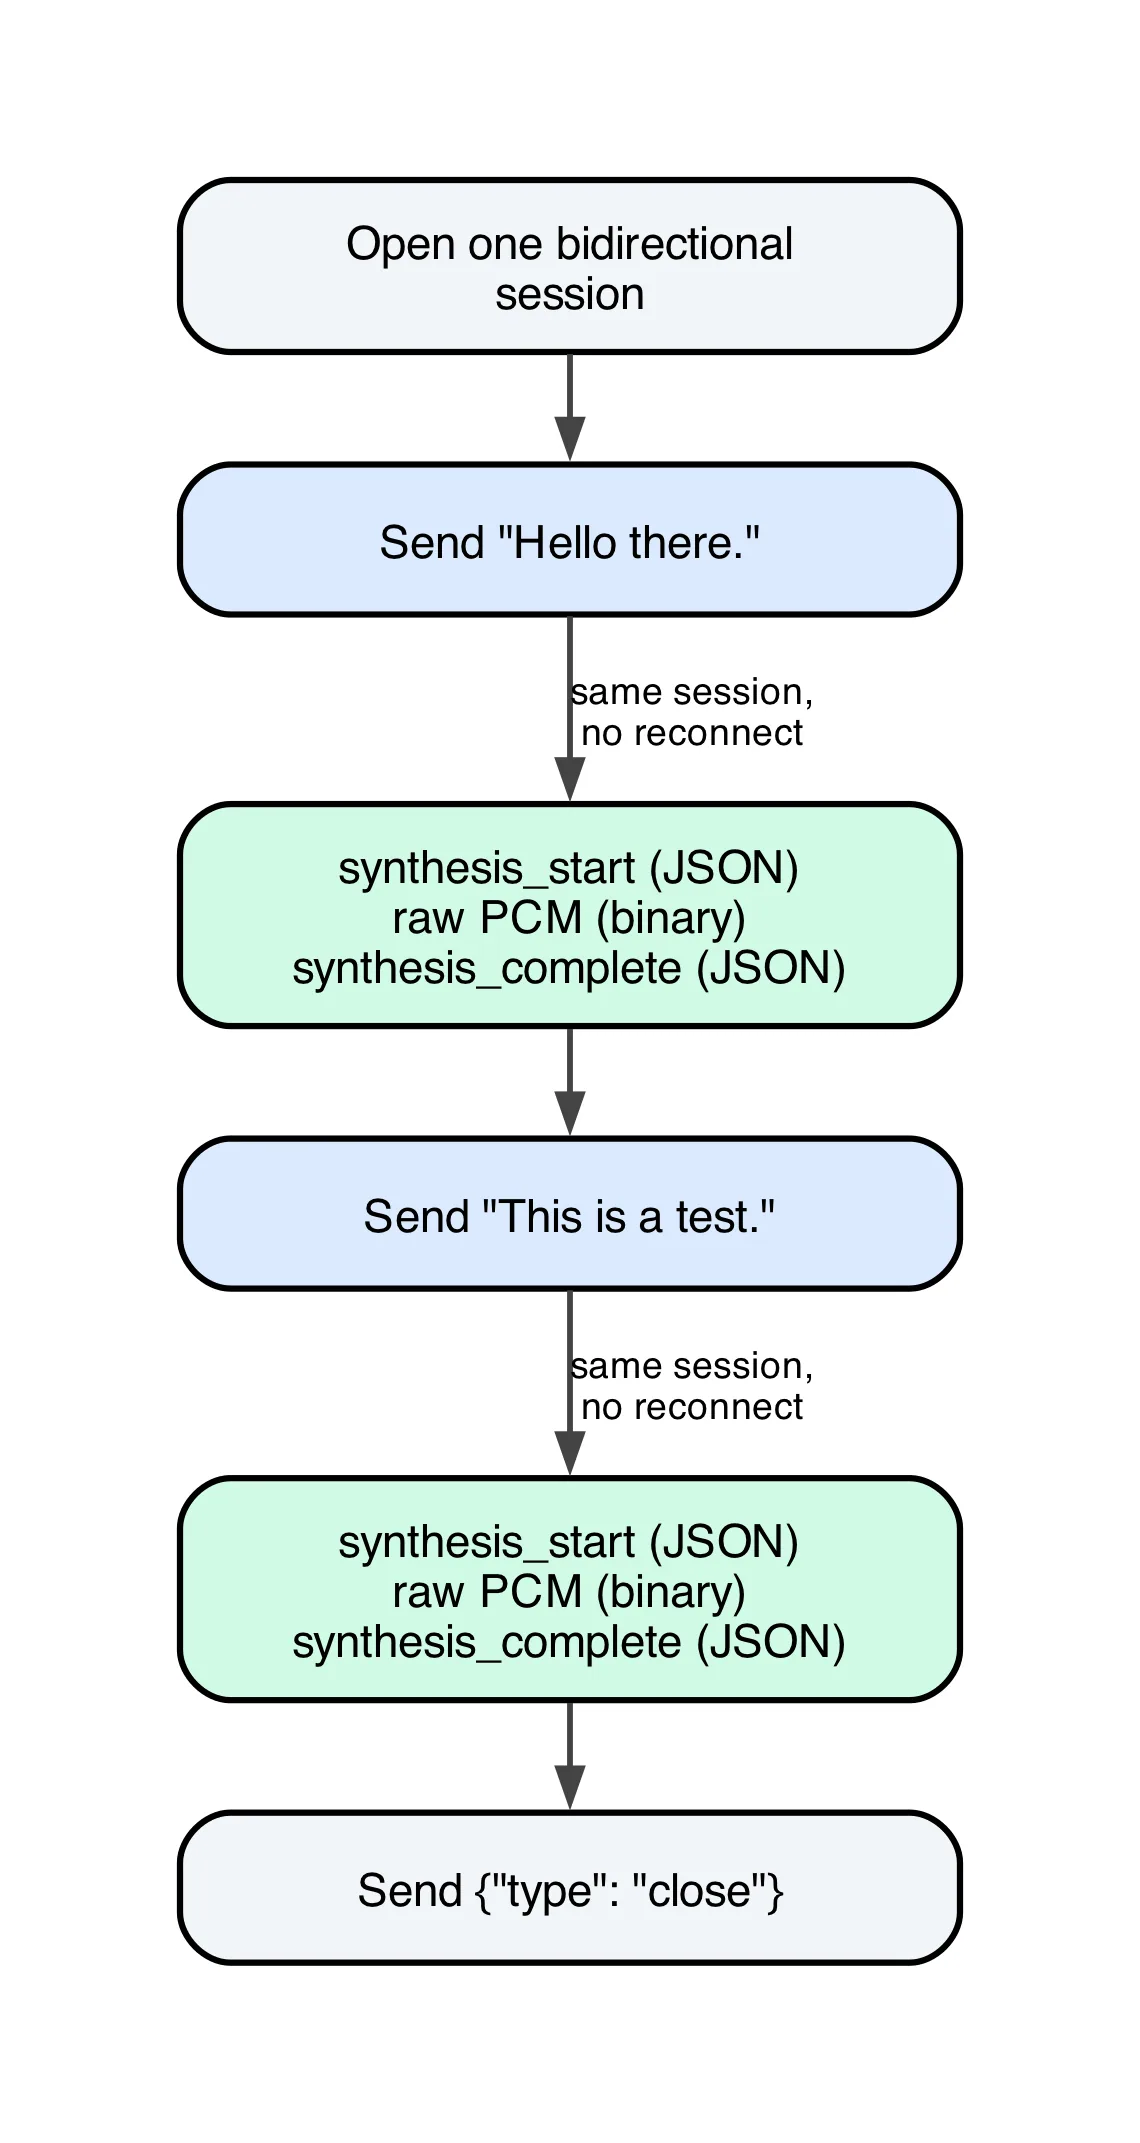
Langkah krusial kedua adalah menjaga koneksi tetap menyala. Di protokol HTTP biasa, sesi otomatis berakhir begitu jawaban dikirim. Tapi pada arsitektur streaming ini, setelah container mengirim audio dan frame kontrol synthesis_complete, koneksi jangan ditutup. Container harus terus menunggu pesan kalimat berikutnya di loop yang sama. Sesi baru ditutup saat klien mengirim pesan kontrol eksplisit {"type": "close"}. Kalau kamu buru-buru menutup koneksi di tiap kalimat, keuntungan latensi bakal habis cuma buat proses jabat tangan koneksi berulang.
Langkah 3: Potong Kalimat Otomatis Pakai Incremental Chunker
Model bahasa generatif biasanya mengeluarkan jawaban berupa potongan kata (token stream). Kita butuh mekanisme praktis di sisi klien yang bisa menggabungkan token-token itu sampai membentuk satu kalimat utuh sebelum dikirim ke endpoint Kokoro TTS SageMaker.
Kode berikut memanfaatkan ekspresi reguler buat mendeteksi tanda baca akhir kalimat seperti titik, tanda seru, atau tanda tanya:
import re

_SENTENCE_RE = re.compile(r"(?<=[.!?])\s+")

class IncrementalSentenceChunker:
    def __init__(self) -> None:
        self._buffer = ""

    def feed(self, fragment: str) -> list[str]:
        self._buffer += fragment
        parts = _SENTENCE_RE.split(self._buffer)
        if len(parts) == 1:
            return []
        self._buffer = parts[-1]
        return [s.strip() for s in parts[:-1] if s.strip()]

    def flush(self) -> str | None:
        remainder = self._buffer.strip()
        self._buffer = ""
        return remainder or None
Fungsi feed() dipanggil setiap kali ada pecahan teks baru dari model bahasa. Begitu potongan kalimat sudah genap diakhiri tanda baca, fungsi langsung mengembalikannya sebagai daftar kalimat siap kirim. Di akhir pembicaraan, panggil fungsi flush() biar sisa teks yang nggak punya tanda baca penutup tetap diproses dan nggak tertinggal di memori buffer.
Pengujian langsung pada endpoint yang aktif membuktikan efisiensi metode pemotongan kalimat ini lewat data ukuran audio berikut:
| Potongan (Chunk) | Teks Kalimat | Ukuran Audio (Bytes) | Durasi (Detik) |
|---|---|---|---|
| Kalimat 1 | “Hello there.” | 73.200 | 1,525 |
| Kalimat 2 | “This is a post deployment check.” | 108.000 | 2,250 |
| Kalimat 3 | “It has three sentences.” | 98.400 | 2,050 |
Langkah 4: Pilih Jalur Data Audio ke Klien (Base64 vs Binary Langsung)
Setelah audio kalimat berhasil diolah, tantangan berikutnya adalah mengirim data suara itu kembali ke peramban pengguna. Kebanyakan aplikasi chat web sudah terbiasa memakai Server-Sent Events (SSE). Karena SSE berbasis teks, developer umumnya membungkus data suara memakai format base64 di dalam format JSON.
Namun, hasil pengujian pada 24 klip audio memperlihatkan bahwa encoding base64 memakan bandwidth tambahan sekitar 33 persen. Selain itu, potongan frame SSE sering kali nggak sinkron sama batas frame file MP3, sehingga audio player di browser rentan rusak kalau buffer penampungnya nggak ditangani dengan teliti.
| Format Audio | Ukuran Mentah (Bytes) | Ukuran Base64 (Bytes) | Bitrate Rata-rata |
|---|---|---|---|
| Raw PCM | 2.396.400 | 3.195.200 | 384 kbps |
| MP3 48k | 308.304 | 411.072 | 49,5 kbps |
| AAC 32k fMP4 | 258.039 | 344.084 | 41,6 kbps |
Solusi yang lebih hemat adalah memanfaatkan sesi bidirectional buat membawa data audio biner mentah berdampingan dengan pesan kontrol JSON. Caranya simpel: periksa apakah paket data yang masuk merupakan teks JSON yang valid. Kalau decoding JSON gagal, data itu langsung dipastikan sebagai audio biner dan diteruskan tanpa perlu di-encode ulang.
import json

def _decode_control_frame(chunk: bytes) -> dict | None:
    try:
        decoded = json.loads(chunk.decode("utf-8"))
    except (UnicodeDecodeError, json.JSONDecodeError):
        return None
return decoded if isinstance(decoded, dict) else NoneIntegrasi Penuh Voice Agent di Amazon Bedrock AgentCore
Ketika semua komponen dirangkai jadi agen cerdas utuh, sistem ini menghubungkan tiga jalur komunikasi sekaligus: jalur browser pengguna, jalur streaming teks ke Amazon Bedrock, dan jalur dua arah ke endpoint Kokoro TTS SageMaker.
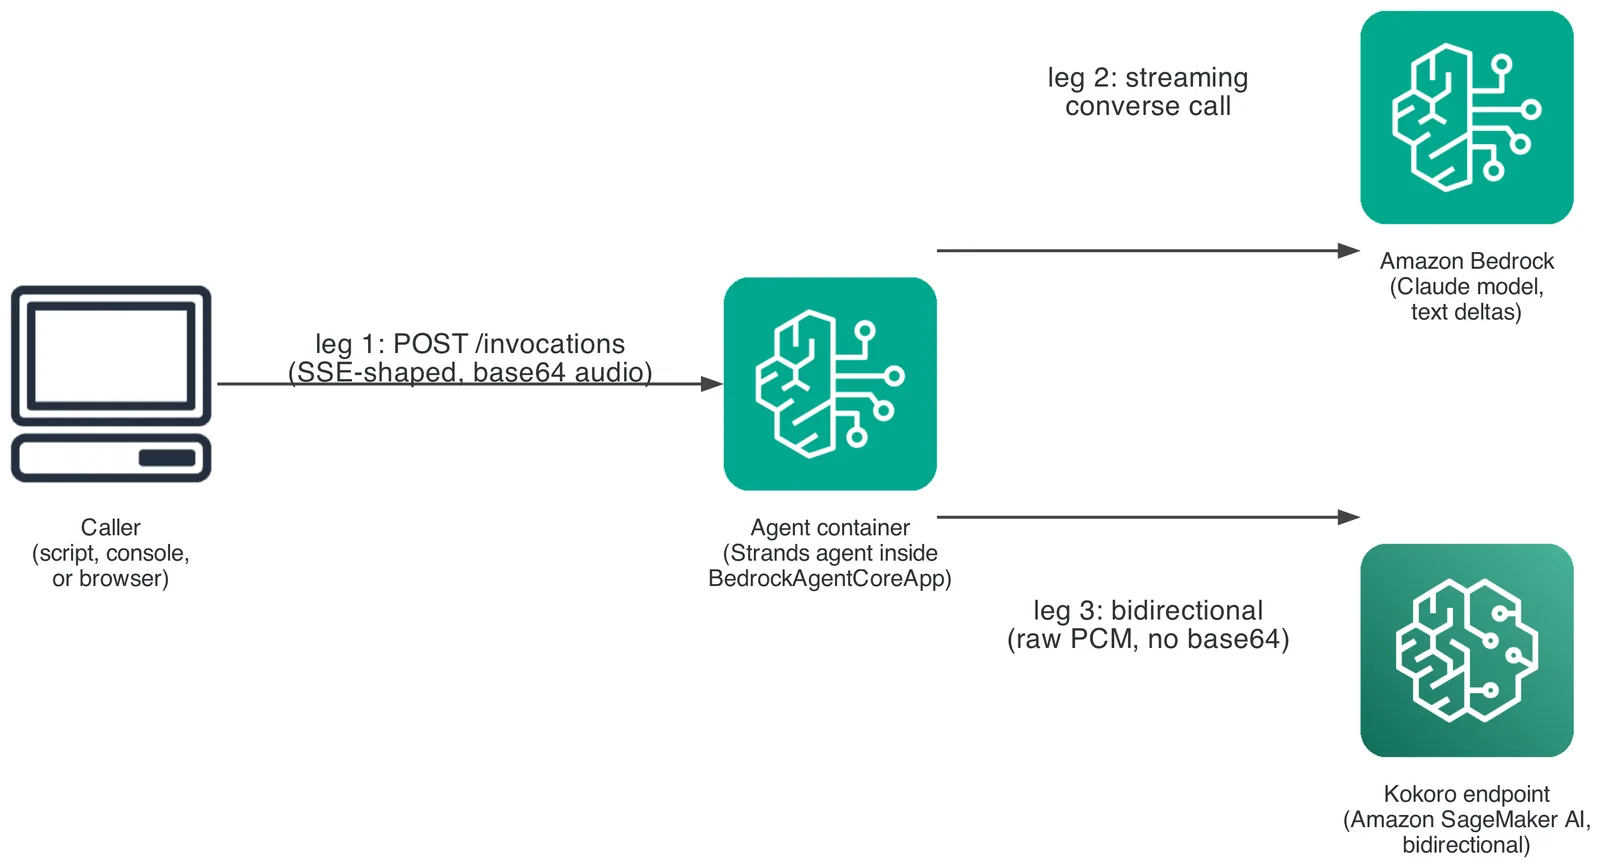
Aplikasi agen dibangun memakai runtime BedrockAgentCoreApp. Di dalamnya ada dua tugas yang berjalan bersamaan: satu tugas mengambil token teks dari Bedrock lalu memasukkannya ke pemotong kalimat (IncrementalSentenceChunker), sementara tugas lainnya mengambil potongan audio dari Kokoro dan mengirimkannya ke antrean bersama. Dengan begitu, pemanggil di browser sudah bisa mendengar suara kalimat pertama meskipun model bahasa di AWS Bedrock masih memproses kalimat terakhir.
Buat kamu yang lagi merancang sistem agen cerdas di cloud, kamu juga bisa membaca artikel kami tentang arsitektur multi-agent AI di AWS buat memperluas wawasan infrastruktur skala besar.
Hasil Benchmark: Seberapa Cepat Streaming Kokoro TTS Dibanding Batch?
Pengujian latensi dilakukan dengan membandingkan teks empat kalimat berisi 267 karakter yang dikirim lewat dua skenario: mode batch (menunggu seluruh teks utuh) dan mode incremental (mengirim kalimat pertama langsung).
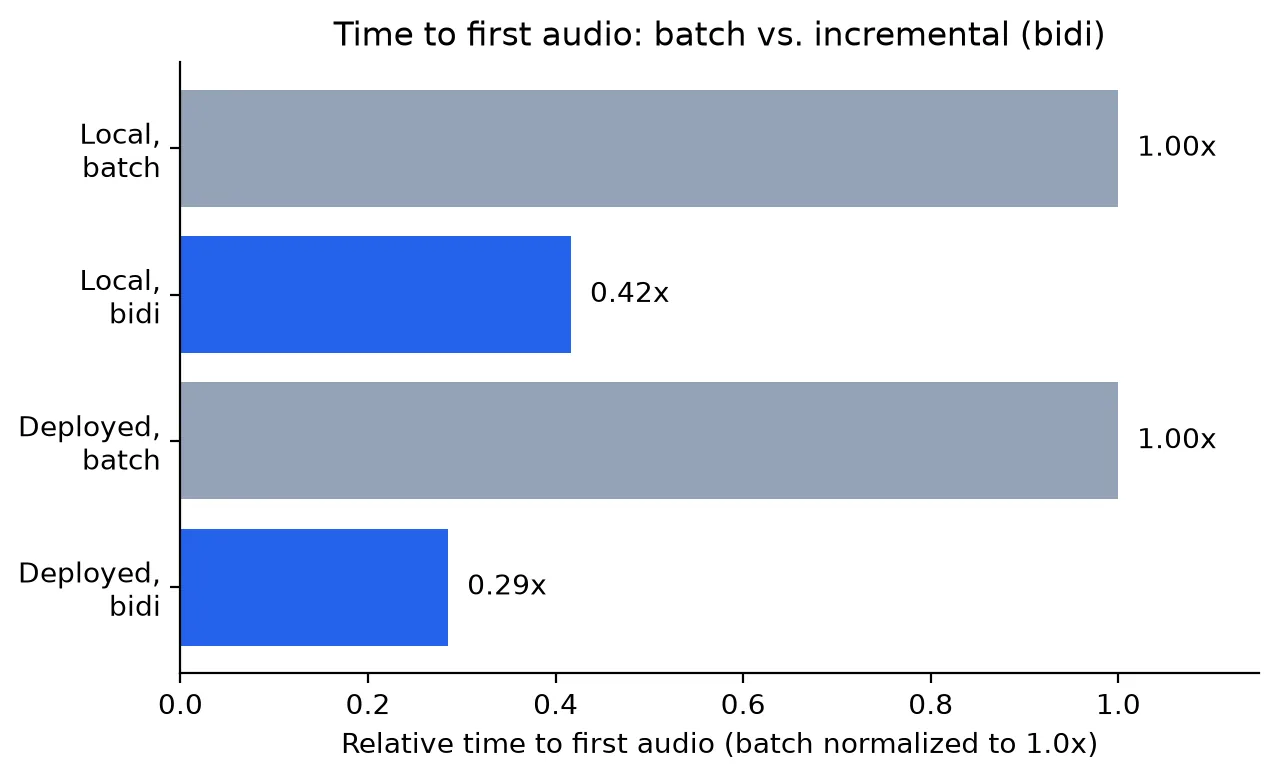
Pada pengujian terisolasi di sisi transport TTS saja, pengiriman kalimat pertama berhasil memotong rata-rata waktu sampai byte audio pertama (Time to First Audio Byte/TTFAB) dari 329,3 milidetik menjadi cuma 156,7 milidetik. Peningkatannya mencapai 52,4 persen lebih cepat.
Ketika diuji secara penuh dari ujung ke ujung bersama model bahasa di lingkungan produksi, keunggulannya makin kelihatan:
- Pengujian container lokal: Mode bidirectional mencatatkan waktu 2,4 kali lebih cepat dibanding metode batch konvensional.
- Pengujian runtime Bedrock AgentCore ter-deploy: Kecepatannya melonjak hingga 3,5 kali lebih cepat dibanding mode batch.
Perbedaan ini makin terasa di lingkungan jaringan nyata karena mode bidirectional mampu menyamarkan jeda jaringan (network hop) di sela-sela proses generasi teks dan sintesis suara yang berjalan paralel.
Menghitung Target Auto Scaling Kokoro TTS di SageMaker Tanpa Tebak-tebakan
Banyak tim salah mengatur konfigurasi auto scaling pada endpoint TTS mandiri. Model bahasa biasa umumnya dipantau lewat metrik token per detik, tapi model non-autoregressive seperti Kokoro-82M nggak punya loop per-token. Kalau salah pasang target, GPU bakal menganggur mahal atau justru antrean meledak saat traffic ramai.
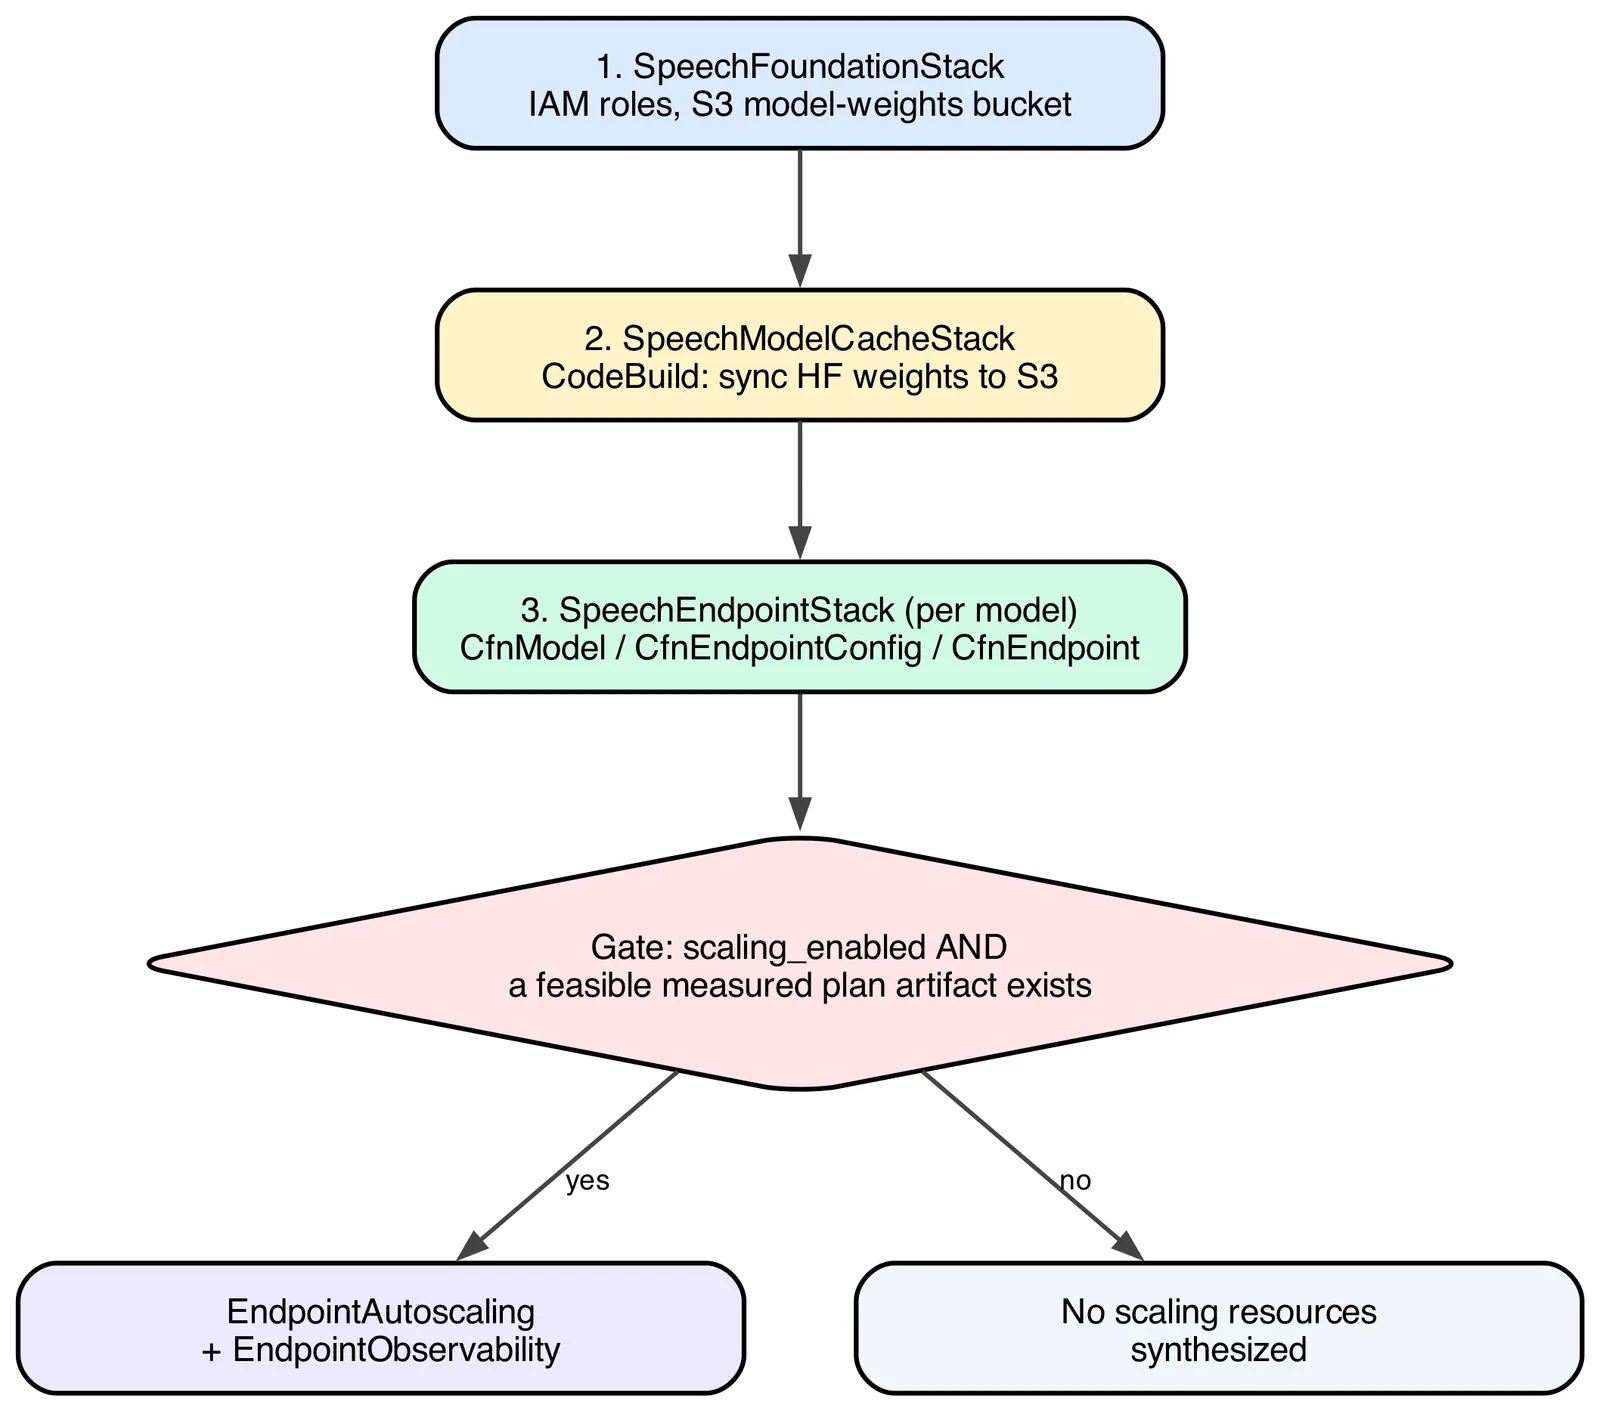
Berdasarkan pengujian AWS pada repositori contohnya, kebijakan auto scaling sebaiknya diikat pada metrik bawaan ConcurrentRequestsPerModel di CloudWatch. Dua angka penting yang wajib diukur langsung adalah Q_max (batas konkurensi tertinggi sebelum melanggar target waktu layanan/SLO) dan T_total (durasi riil penambahan instans baru).

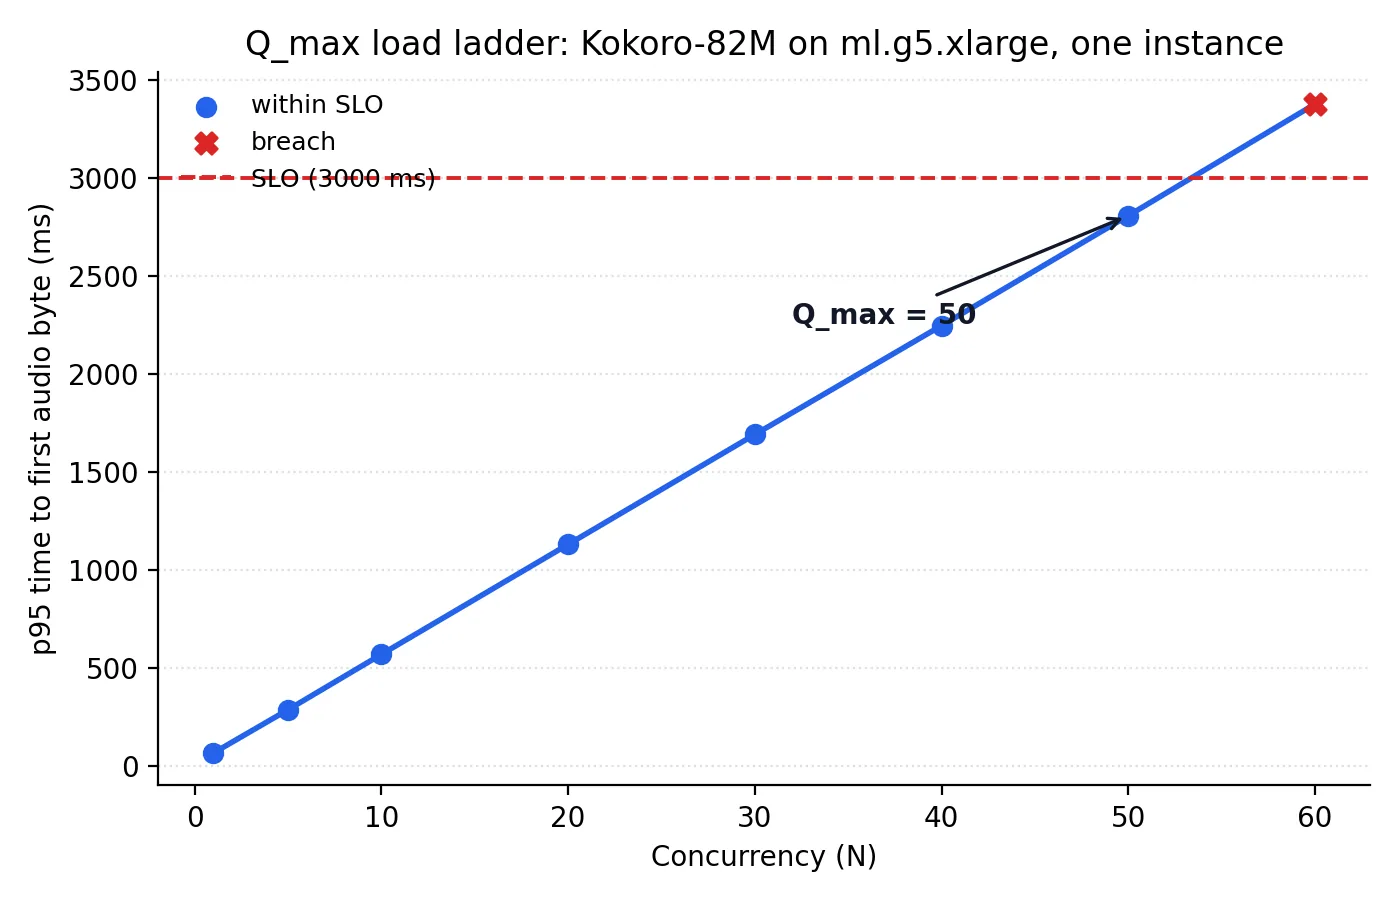
Pada grafik pengukuran langsung, nilai p95 waktu respons naik dari 65,4 milidetik di konkurensi 1 hingga menyentuh 3374,8 milidetik pada konkurensi 60, melampaui batas toleransi SLO 3000 milidetik. Dari sinilah kapasitas maksimal satu GPU dipatok secara presisi tanpa kira-kira.
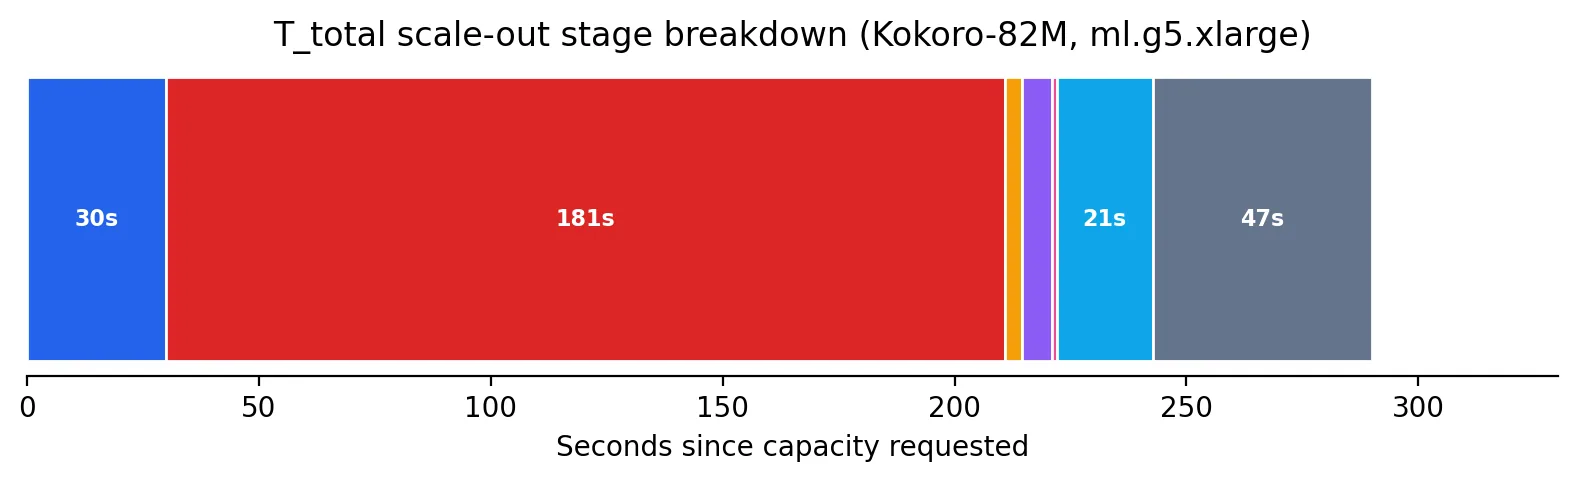
Fase penambahan instans GPU ml.g5.xlarge sendiri membutuhkan waktu provisioning dominan sekitar 181 detik dan alokasi kapasitas 30 detik. Dengan mengetahui angka riil ini, kamu bisa menyetel jeda cooldown auto scaling yang pas biar sistem nggak telat mengembang pas lonjakan traffic datang.
Dampak Nyata Buat Developer dan Bisnis AI di Indonesia
Implementasi arsitektur suara berlatensi rendah ini membuka peluang lebar bagi banyak sektor di Indonesia. Di bidang layanan pelanggan (customer service) dan perbankan digital, voice bot interaktif bisa menjawab komplain nasabah dengan intonasi wajar tanpa jeda kaku yang bikin pengguna kesal.
Model Kokoro-82M yang hemat resource GPU bikin biaya sewa cloud tetap terkendali bagi startup lokal maupun tim engineering korporat. Kemudahan menjalankan container sendiri di SageMaker juga mempermudah kepatuhan keamanan data karena seluruh data audio percakapan tetap berada di dalam perimeter VPC cloud perusahaan kamu sendiri.
Kalau kamu butuh model bahasa tangguh buat menjadi otak dari voice agent sebelum dialirkan ke Kokoro TTS, kamu bisa menghubungkannya dengan model frontier lewat Classai Router. Mulai dari deepseek-v4.1-flash (Rp1.155 / Rp4.200 per 1M token) atau gemini-3.7-flash (Rp1.320 / Rp6.510 per 1M token), semuanya bisa diakses fleksibel dengan satu API key dan pembayaran saldo rupiah lokal tanpa kartu kredit luar negeri.
Untuk kamu yang ingin mendalami cara mengintegrasikan API model cerdas langsung ke dalam arsitektur software modern, kamu bisa belajar langkah demi langkah di kelas AI untuk Developer yang dibimbing praktisi berpengalaman.
Kode implementasi lengkap dan script deployment CDK untuk panduan ini dapat kamu temukan langsung di repositori GitHub aws-samples.
Sumber & referensi
- 01
AWS · 23 Oktober 2026
Stream low-latency speech from AI agents using Kokoro TTS on Amazon SageMaker AI - 02
AWS · 22 Oktober 2026
Stop guessing auto scaling targets for TTS on Amazon SageMaker AI
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa keunggulan utama Kokoro TTS dibanding model suara lain di SageMaker?
Kokoro-82M cuma berukuran 82 juta parameter dan memakai arsitektur non-autoregressive. Model ini sanggup menghasilkan ucapan jernih secara instan dan enteng dijalankan pada satu GPU hemat biaya seperti ml.g5.xlarge.
Kenapa bidirectional streaming bikin voice agent jauh lebih cepat?
Bidirectional streaming memungkinkan teks dikirim dan diproses jadi audio per kalimat secara beriringan. Pengguna bisa langsung mendengar suara kalimat pertama tanpa perlu menunggu seluruh teks jawaban selesai diproduksi.
Apa penyebab umum error KeyError text saat deploy container di SageMaker?
SageMaker AI mengirimkan data frame WebSocket dalam bentuk biner secara default. Pemanggilan fungsi receive_text() bawaan Starlette bakal gagal membaca field teks, sehingga container wajib membaca payload bytes dan men-decode-nya ke UTF-8.
Kenapa pengiriman audio biner lebih disarankan dibanding base64 lewat SSE?
Encoding base64 membuat ukuran payload membengkak sekitar 33 persen dan rentan merusak batas frame audio MP3 di browser. Pengiriman biner langsung lewat WebSocket menghemat bandwidth dan menghilangkan proses decode di frontend.
Metrik apa yang paling pas buat auto scaling endpoint Kokoro TTS?
Gunakan metrik ConcurrentRequestsPerModel bawaan CloudWatch. Metrik ini mengukur jumlah request aktif yang sedang berjalan di instans secara riil, bukan metrik token per detik yang biasa dipakai pada model LLM teks.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.