TorchTPU Hugging Face Rilis: PyTorch di Google TPU Jadi Gampang
Hugging Face resmi mendukung TorchTPU secara native. Nggak perlu lagi pusing mikirin torch_xla atau JAX buat jalanin model PyTorch di Google TPU.
· 9 menit baca
Inti singkat
- TorchTPU menambahkan TPU sebagai backend native PyTorch tanpa butuh Optimum TPU atau torch_xla lagi.
- Model di Hugging Face Transformers dan Diffusers bisa langsung jalan ke TPU cuma dengan satu baris kode.
- Kernel khusus Pallas dan Tokamax mendongkrak kecepatan decoding MoE sampai 21,5 kali lipat di batch size 64.
- Langkah Google dan Hugging Face ini memperkuat posisi TPU sebagai alternatif GPU Nvidia yang makin ramah developer.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Google dan Hugging Face resmi merilis integrasi TorchTPU, bikin model PyTorch bisa berjalan langsung secara native di Google TPU tanpa perlu utak-atik kode yang bikin pusing. Kabar gembira buat developer AI ini diumumkan langsung lewat blog resmi Hugging Face dan dilaporkan juga oleh TechCrunch.
Selama ini, kalau kamu mau menjalankan model AI berbasis PyTorch di atas chip akselerator Google alias Tensor Processing Unit (TPU), rintangannya lumayan berasa. Kamu kudu belajar framework JAX dari nol atau berurusan sama torch_xla yang tingkahnya sering bikin garuk kepala. Sekarang, dengan hadirnya backend native TorchTPU, TPU diperlakukan sama persis kayak device komputasi biasa di ekosistem PyTorch.
Langkah ini sekaligus jadi babak baru dalam peta persaingan chip AI global, waktu para raksasa teknologi mulai serius ngasih alternatif GPU Nvidia yang selama ini menguasai pasar.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu TorchTPU dan Kenapa Bikin Heboh Developer AI?
TorchTPU adalah backend baru buat PyTorch yang dirancang supaya kode Python standar kamu bisa langsung berkomunikasi dengan chip TPU milik Google. Proyek ini sekarang udah berstatus open source di GitHub TorchTPU.
TPU sendiri adalah chip khusus bikinan Google yang udah dikembangkan sekitar sepuluh tahun buat satu tugas utama: perkalian matriks super cepat yang jadi makanan sehari-hari neural network. Google memakai TPU buat melatih dan melayani model raksasa mereka sendiri, termasuk seri Gemini. Chip ini tersedia di Google Cloud, mulai dari satu chip tunggal sampai cluster ribuan chip.
Masalahnya, sekitar 85% aplikasi AI di dunia ditulis memakai PyTorch yang awalnya dioptimalkan buat GPU Nvidia. Dengan adanya TorchTPU, ekosistem besar kayak Hugging Face Transformers, Diffusers, sampai library Kernels bisa langsung mengenali TPU tanpa jembatan tambahan yang rumit.
Masalah Lama PyTorch di Google TPU: Kenapa Dulu Ribet Banget?
Sebelum TorchTPU ada, menjembatani PyTorch ke Google TPU rasanya kayak memaksakan dua bahasa yang beda dialek. Developer harus memakai library torch_xla.
torch_xla memang berfungsi, tapi punya beberapa sifat yang bikin proses debugging jadi susah ditebak:
- Lazy Evaluation: Tensor di
torch_xlabersifat malas (lazy). Kode kamu nggak langsung dieksekusi baris per baris pas dipanggil, melainkan dikumpulkan dulu jadi grafik komputasi. - Kompilasi Ulang Terus-menerus: Sedikit aja ada perubahan ukuran input atau logika percabangan, sistem bakal memicu kompilasi ulang grafik (graph recompilation) yang makan waktu lama.
- Debugging Bikin Pusing: Melacak baris kode mana yang bikin error jadi pekerjaan rumah tersendiri karena eksekusinya tertunda.
Buat menambal kerepotan itu, Hugging Face dulu merilis library perantara bernama Optimum TPU. Tapi sekarang ceritanya beda. Dengan integrasi TorchTPU, library Optimum TPU udah nggak wajib lagi buat menjalankan Transformers dan Diffusers di TPU.
Cara Kerja TorchTPU di Hugging Face Transformers
Di Transformers versi 5, arsitekturnya memang dirancang biar model bisa jalan di perangkat keras apa pun. Sekarang, kata "apa pun" itu resmi mencakup Google TPU.
Kamu nggak perlu lagi bikin wrapper aneh-aneh. Cukup tambahkan parameter device_map="tpu", dan model langsung di-load ke memori TPU. Model bakal berjalan dalam mode eager secara bawaan, tapi kamu juga bisa mengaktifkan torch.compile biar makin kencang.
Berikut contoh script sederhana buat menjalankan model teks Qwen langsung di TPU:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3.5-9B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="tpu", # model langsung masuk ke memori TPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
inputs = tokenizer("The future of AI is", return_tensors="pt").to("tpu")
out = model.generate(**inputs, max_new_tokens=64)
print(tokenizer.decode(out[0], skip_special_tokens=True))
Kodenya bersih dan nggak beda jauh sama script PyTorch biasa waktu kamu nge-load model ke GPU Nvidia atau CPU.
Bikin Gambar dan Video Pakai Diffusers di TPU
Bukan cuma model teks, model generatif gambar dan video lewat library Diffusers juga dapet perlakuan kelas satu di TorchTPU. Mau sekadar eksperimen cepat atau pasang di server produksi, jalurnya udah disiapkan.
Buat tahap uji coba dan debugging, kamu cukup pakai pemanggilan biasa pipe.to("tpu"). Kalau butuh kecepatan tinggi buat serving, kamu tinggal menambahkan satu baris kompilasi pipe.transformer.compile(backend="tpu", fullgraph=True, dynamic=False).
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-medium", dtype=torch.bfloat16
)
pipe.to("tpu")  # mode eager biasa

# opsional: mode kompilasi biar lebih ngebut
pipe.transformer.compile(backend="tpu", fullgraph=True, dynamic=False)

image = pipe("a corgi astronaut planting a flag on a pizza moon").images[0]
Panggilan pertama bakal memakan waktu sebentar buat kompilasi, tapi panggilan berikutnya dengan resolusi gambar yang sama bakal memakai ulang grafik komputasi tadi tanpa jeda.
Kalau model yang mau kamu pakai ukurannya terlalu jumbo buat satu chip, kamu tinggal memasang konfigurasi TensorParallelConfig. Fitur ini otomatis memecah transformer ke beberapa chip TPU sekaligus waktu proses loading.
Di pengujian Cloud TPU v6e-4 dengan konfigurasi tensor parallel 4 chip (TP=4) dan presisi bfloat16, hasilnya kelihatan menjanjikan:
| Model | Prompt & Spesifikasi | Mode Eager | Mode Compiled |
|---|---|---|---|
| MiniMax-H3 (Video + Audio) | Karakter maskot Hugging Face di kapal Yunani kuno, resolusi 1344×768, durasi 5,2 detik, 49 step | 262 detik | 188 detik |
| Qwen-Image-2.1 | Lukisan cat minyak kapibara bertopi penyihir, 1024×1024, 40 step | 8,0 detik | 3,5 detik |
| Qwen-Image-2.1 | Papan neon bertuliskan nama model di jalanan basah, 2048×2048, 40 step | - | Berjalan mulus |
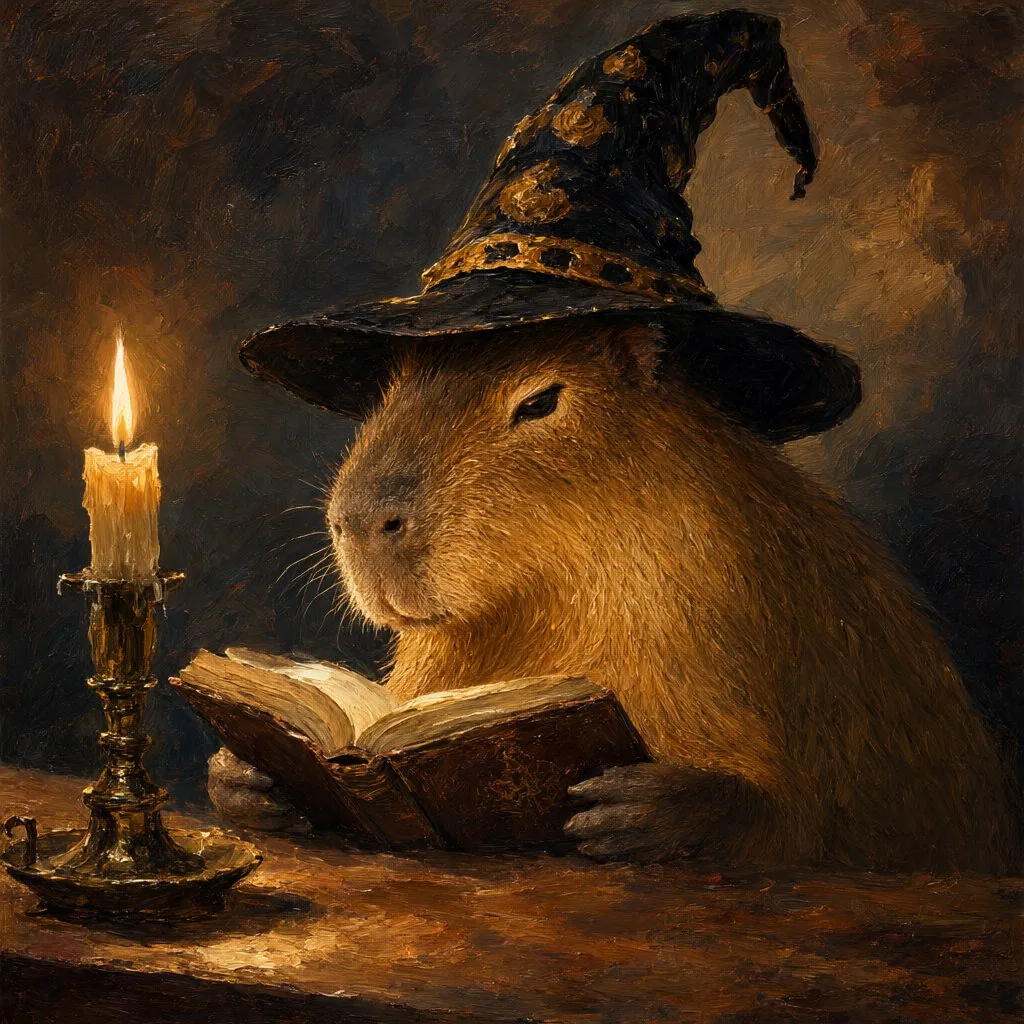
Mode compiled terbukti memangkas waktu generate secara drastis, dari 8 detik jadi cuma 3,5 detik buat gambar resolusi 1024×1024.
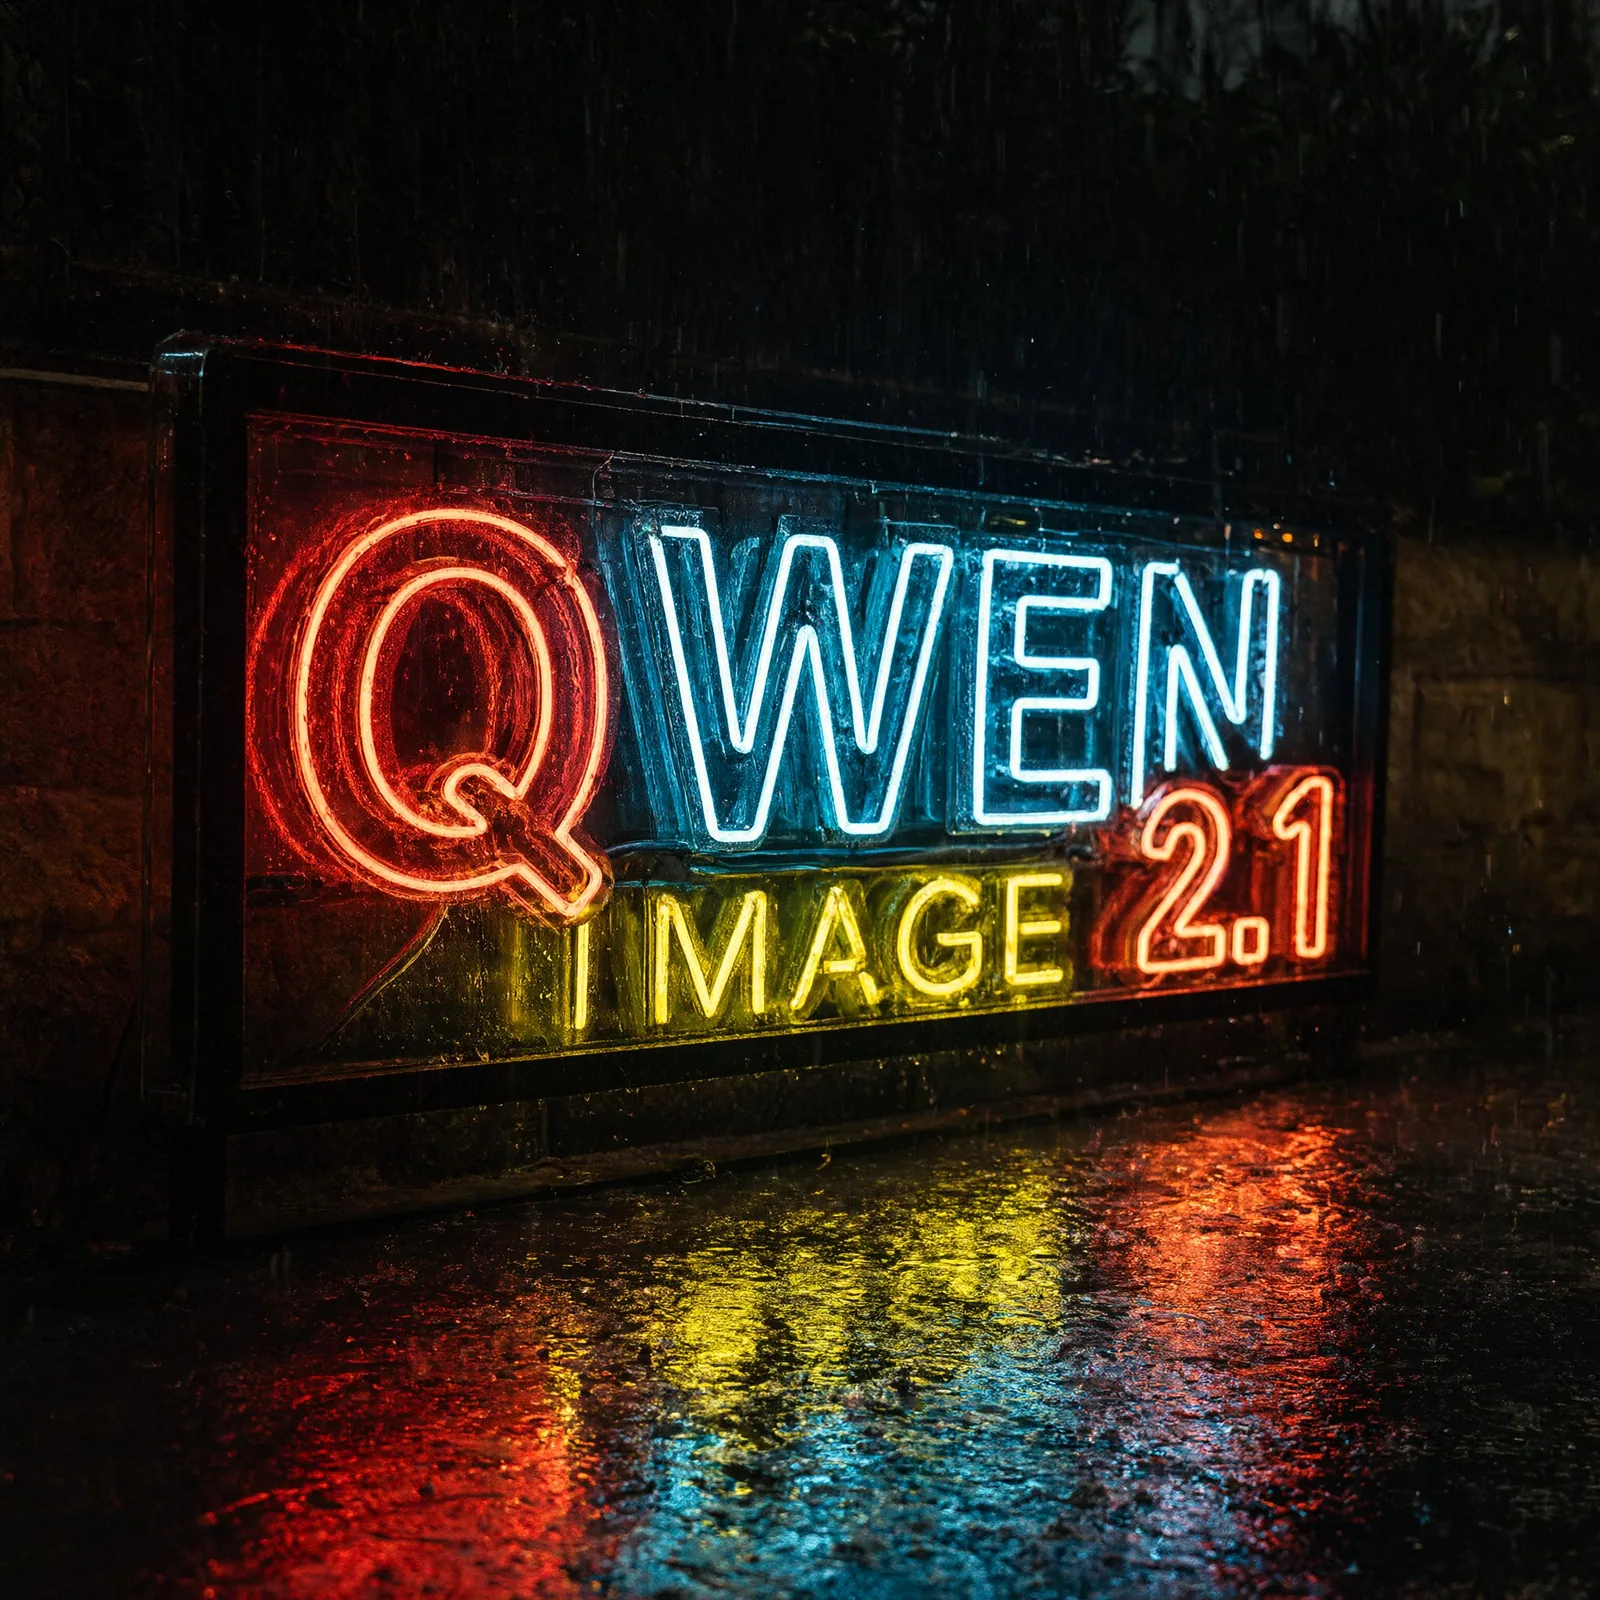
Optimasi Training AI TPU Lewat Kernel Pallas dan Tokamax
Salah satu rahasia performa tinggi di TPU adalah ketersediaan custom kernel. TorchTPU menyertakan kernel yang ditulis memakai Pallas, framework tingkat rendah yang ngasih kontrol langsung ke arsitektur hardware TPU.
Lewat Hugging Face Kernels Hub, developer bisa langsung mencomot kernel siap pakai atau memanfaatkan pustaka dari proyek Tokamax. Salah satu contoh menariknya adalah implementasi kernel ragged-dot buat model Mixture-of-Experts (MoE).
from kernels import get_kernel
from transformers import AutoModelForCausalLM
from transformers.integrations.moe import ALL_EXPERTS_FUNCTIONS

repo_id = "tengomucho/ragged-dot-tpu"
kernel = get_kernel(repo_id, version=1, trust_remote_code=[repo_id])
ALL_EXPERTS_FUNCTIONS.register("tokamax_ragged_dot", kernel.experts_forward)

model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3-30B-A3B-Instruct-2507",
    experts_implementation="tokamax_ragged_dot",
)
Keuntungan kernel khusus ini bakal makin terasa waktu ukuran batch makin besar. Di pengetesan Cloud TPU v6e-8 pada batch size 64, kecepatan decoding melompat drastis:
- Qwen3-30B-A3B: Kecepatan decoding mencapai 21,5 kali lebih cepat dibanding implementasi standar.
- Gemma 4 26B-A4B: Kecepatan decoding naik sampai 12,8 kali lebih cepat.
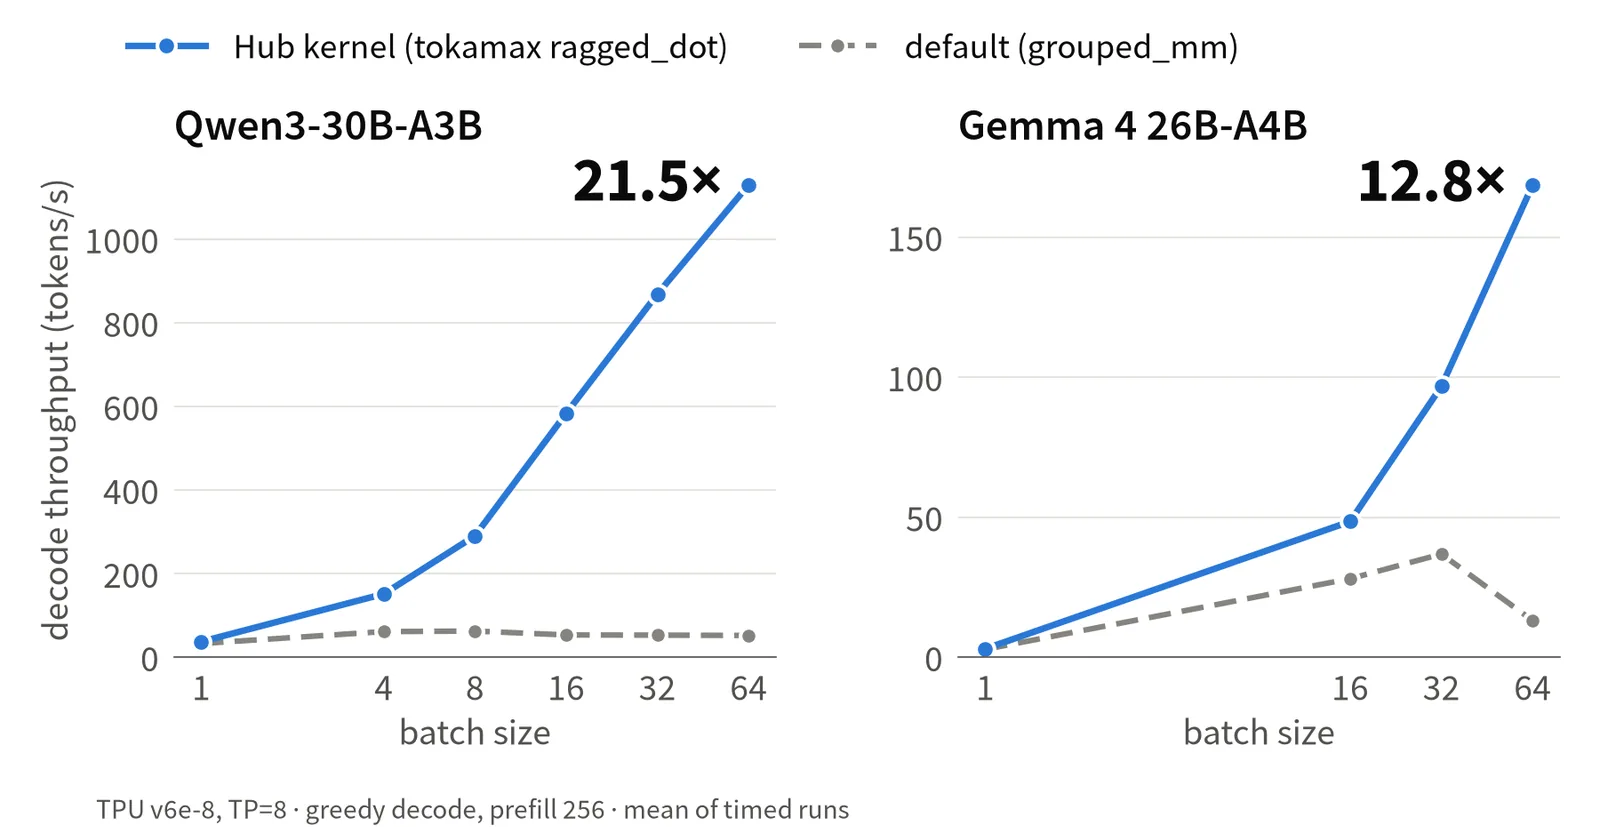
Lonjakan performa ini ngebuktiin kalau optimasi tingkat kernel di TPU nggak kalah bersaing sama kernel CUDA di GPU.
Seberapa Stabil TorchTPU? Ini Data Uji Coba Hugging Face
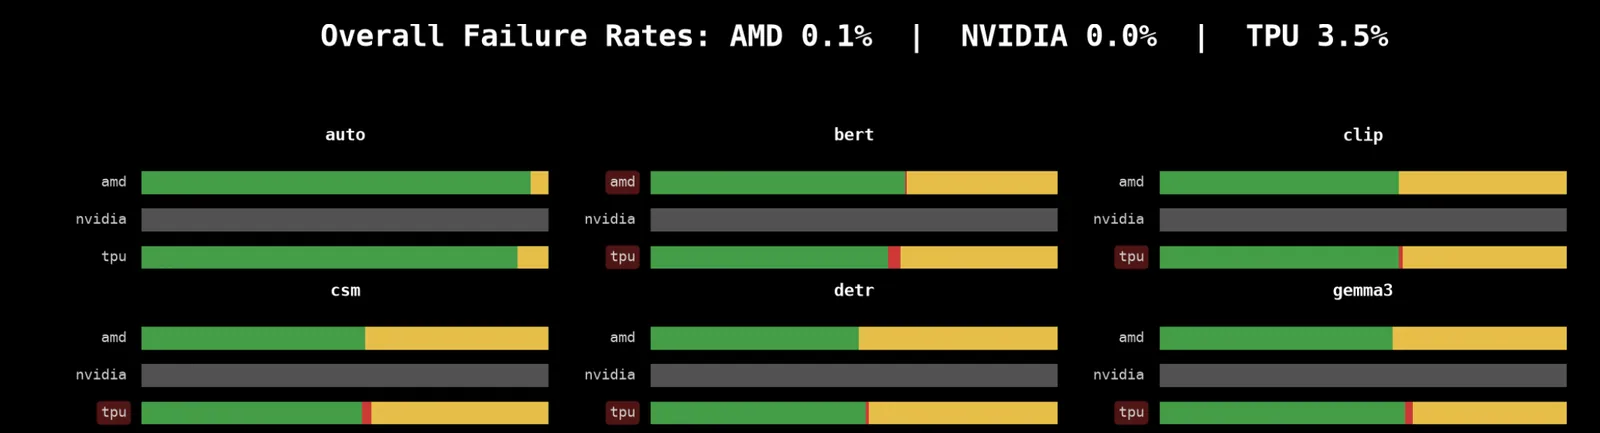
Banyak developer biasanya ragu nyobain backend baru karena takut nemu banyak error aneh di tengah jalan. Menanggapi kekhawatiran ini, tim Hugging Face langsung menjalankan test suite internal mereka secara rutin di atas TPU.
Hasil pengujian mereka menunjukkan tingkat kelulusan tes mencapai 96,5%. Dari serangkaian pengujian tersebut, tim Hugging Face udah menemukan 34 isu bug, dan 19 di antaranya udah berhasil diperbaiki langsung di repositori TorchTPU.
Menariknya, proses uji coba di TPU ini juga ngebantu mendeteksi bug tersembunyi di dalam library Transformers itu sendiri, misalnya pada modul StaticCache dan skema tensor-parallel buat keluarga model Qwen3. Semua perbaikan itu udah langsung digabungkan ke kode utama (upstream).
Integrasi mulus ini sebetulnya merupakan buah dari kerja sama bertahap antara kedua pihak. Hubungan ini udah dibangun sejak kerja sama awal ketersediaan Cloud TPU buat komunitas Hugging Face dan ekosistem open model di cloud.
Persaingan Panas Alternatif GPU Nvidia: Google vs Amazon
Kehadiran TorchTPU bukan sekadar update teknis biasa. Menurut laporan TechCrunch, langkah Google ini adalah bagian dari strategi besar bersama raksasa cloud lain buat mengikis dominasi Nvidia di pasar AI.
Sebelumnya, Amazon juga baru aja merilis langkah serupa lewat proyek TorchNeuron di AWS Trainium. Amazon bahkan mengajukan kode langsung ke proyek induk PyTorch buat memisahkan ketergantungan fitur bawaan dari chip Nvidia.
Nggak mau kalah, Google menggandeng langsung Meta, Hugging Face, Inferact (tim pengembang vLLM), dan RadixArk (pengembang SGLang). Tujuannya jelas: memastikan software stack mereka siap pakai sejak hari pertama tanpa bikin developer mikir dua kali.
Google juga memperbarui tool LiteRT mereka, yang biasa dipakai buat menjalankan model AI di perangkat smartphone, laptop, dan perangkat embedded, biar makin nyambung sama aplikasi PyTorch.
Cara Mencoba TorchTPU Langkah demi Langkah
Kalau kamu punya akses ke virtual machine (VM) TPU di Google Cloud, instalasinya sangat gampang. Kamu cuma perlu satu baris perintah pip:
pip install torch-tpu --extra-index-url https://download.pytorch.org/whl/cpuPerhatikan bagian --extra-index-url ke build CPU PyTorch. Parameter ini penting banget dipasang biar sistem nggak mengunduh paket CUDA yang ukurannya bergiga-giga dan sama sekali nggak terpakai di mesin TPU.
Setelah instalasi beres, kamu bisa langsung buka editor favoritmu (misalnya Cursor atau VS Code), panggil library Transformers v5, dan arahkan model ke target device "tpu" seperti contoh kode di atas.
Dampak Buat Developer dan Tim AI di Indonesia
Buat ekosistem developer dan startup AI di Indonesia, kehadiran TorchTPU ngasih angin segar di beberapa aspek praktis:
- Fleksibilitas Infrastruktur Cloud: Kamu nggak lagi terkunci (vendor lock-in) di satu jenis hardware GPU aja. Kalau alokasi GPU di penyedia cloud lagi penuh atau harganya melambung, TPU v6e di Google Cloud sekarang jadi opsi alternatif yang sangat masuk akal.
- Biaya Eksperimen yang Lebih Masuk Akal: Buat tim kecil yang mau melatih atau fine-tuning model open-source, ketersediaan opsi chip alternatif bikin kalkulasi anggaran cloud bulanan jadi lebih kompetitif.
- Kemudahan Integrasi Kode: Kamu nggak perlu menulis ulang ratusan baris kode ke framework JAX atau berkutat dengan keanehan
torch_xla. Kode PyTorch yang udah kamu buat bisa langsung dipindahkan dengan sedikit penyesuaian.
Kalau tim kamu belum butuh menyewa mesin TPU sendiri tapi pengin langsung memanfaatkan model-model mutakhir lewat API siap pakai, kamu juga bisa melirik layanan Classai Router.
Lewat satu API key yang kompatibel dengan SDK OpenAI dan Anthropic, kamu bisa mengakses model canggih keluarga Google seperti gemini-3.8-flash (Rp2.100 input / Rp8.400 output per 1 juta token) atau model reasoning cepat seperti deepseek-v4.1-flash (Rp1.155 input / Rp4.200 output per 1 juta token). Pembayarannya fleksibel memakai saldo rupiah via QRIS tanpa perlu pusing mikirin tagihan kartu kredit luar negeri.
TorchTPU membuktikan kalau gap software antar hardware AI makin tipis. Sekarang, giliran kamu buat nyobain dan buktikan sendiri performanya di project AI kamu berikutnya!
Sumber & referensi
- 01
Hugging Face · 20 Oktober 2026
Hugging Face ❤️ TorchTPU: TPUs, Natively - 02
TechCrunch · 21 Oktober 2026
Google has joined Amazon in attacking Nvidia’s stronghold with AI app developers
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa bedanya TorchTPU dengan torch_xla yang lama?
TorchTPU menambahkan TPU sebagai backend native di PyTorch, jadi kamu bisa menulis kode PyTorch standar tanpa perilaku lazy tensor yang membingungkan. Berbeda dengan torch_xla lama yang sering memicu kompilasi ulang grafik berulang kali, TorchTPU bekerja mulus dengan mode eager bawaan dan torch.compile.
Apakah Optimum TPU masih wajib dipakai di Hugging Face?
Nggak wajib lagi. Berkat dukungan native dari TorchTPU, library Transformers dan Diffusers di Hugging Face sekarang bisa langsung mengenali dan menjalankan model di Google TPU tanpa memerlukan perantara Optimum TPU.
Bagaimana cara install TorchTPU di Google Cloud TPU?
Kamu cukup menjalankan perintah pip install torch-tpu --extra-index-url https://download.pytorch.org/whl/cpu di dalam VM TPU. URL tambahan ke build CPU tersebut penting dipakai supaya pip tidak mengunduh paket CUDA yang berukuran besar.
Model apa saja yang sudah diuji berjalan lancar di TorchTPU?
Hugging Face sudah menguji berbagai arsitektur model teks dan visual, termasuk model teks Qwen3.5-9B, model gambar Qwen-Image-2.1, Stable Diffusion 3.5, hingga model video-audio MiniMax-H3 dengan tingkat kelulusan tes otomatis mencapai 96,5%.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.