Fine Tuning GPT-OSS di SageMaker: Cara AI Nalar Multibahasa
Model penalaran open-weight sering ngeyel mikir pakai bahasa Inggris. Riset AWS terbaru membuktikan kombinasi SFT dan GRPO di SageMaker HyperPod sukses mengatasinya.
· 9 menit baca
Inti singkat
- GPT-OSS-20B bawaan hanya bernalar dalam bahasa target sebesar 22% dan hampir selalu mikir pakai bahasa Inggris.
- SFT berhasil menaikkan akurasi bahasa penalaran dari 22% menjadi 100% penuh di 5 bahasa uji.
- GRPO menyempurnakan akurasi bahasa jawaban akhir dari 62% ke 70% karena masih memiliki ruang peningkatan.
- Eksperimen kontrol Qwen membuktikan GRPO tidak memberi peningkatan sama sekali pada tugas tanpa headroom seperti GSM8K.
- Setup LoRA r=8 dan alpha=16 di SageMaker HyperPod terbukti stabil dan hemat resource komputasi.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Fine tuning GPT-OSS-20B di Amazon SageMaker HyperPod membuktikan bahwa metode Supervised Fine-Tuning (SFT) wajib dipakai untuk mengajarkan kemampuan baru, sedangkan Group Relative Policy Optimization (GRPO) efektif menyempurnakan hasil jika masih ada ruang optimasi (headroom). Kombinasi kedua teknik ini sukses memaksa model penalaran open-weight yang awalnya selalu berpikir dalam bahasa Inggris agar mampu bernalar dan menjawab lancar dalam bahasa lain.
Kalau kamu pernah nyobain model penalaran (reasoning model) berbasis open-weight, kamu pasti sering nemu tingkah uniknya: waktu disuruh mikir dalam bahasa non-Inggris, modelnya sering ngangguk setuju di awal, tapi proses rantai pemikiran (chain-of-thought) di dalamnya tetap aja ditulis pakai bahasa Inggris. Masalah ini baru aja dibedah tuntas oleh tim AWS lewat laporan resmi di AWS Machine Learning Blog.
AWS membagikan arsitektur dan racikan eksperimen mereka saat melakukan fine tuning GPT-OSS-20B untuk penalaran multibahasa (multilingual reasoning). Bukan cuma ngasih resep jalan pintas, mereka juga ngasih jawaban jelas atas dilema banyak praktisi AI: kapan kita cukup pakai SFT biasa, dan kapan kita butuh tambahan teknik reinforcement learning modern kayak GRPO?
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Model Reasoning Suka Ngeyel Mikir Pakai Bahasa Inggris?
Secara arsitektur, GPT-OSS-20B adalah model penalaran bobot terbuka (open-weight) yang punya kebiasaan mikir kuat banget dalam bahasa Inggris. Waktu dikasih prompt sistem buat mikir dan jawab dalam bahasa Prancis, Jerman, Spanyol, atau Italia, model ini biasanya cuma mematuhi instruksi luarnya saja, sementara alur logikanya tetap diproduksi pakai bahasa Inggris.
Dalam pengujian awal AWS yang memakai 50 sampel kasus penalaran multibahasa, model dasar GPT-OSS-20B cuma berhasil mikir pakai bahasa target yang diminta sebesar 22% saja. Angka 22% ini pun didapat murni karena sampel pengujian berbahasa Inggris sukses 100%. Untuk bahasa Prancis dan Spanyol skornya 0%, Jerman cuma 10%, dan Italia mentok di 0%.
Kondisi ini tentu jadi masalah besar kalau kamu mau men-deploy asisten AI penalaran buat user lokal atau operasional bisnis di luar negara penutur bahasa Inggris. Pengguna jelas mengharapkan AI memproses logika dan memberi jawaban dalam bahasa yang sama, bukan ganti bahasa di tengah-tengah alur pikiran.
Untuk menjembatani jurang kemampuan ini, AWS memanfaatkan dataset HuggingFaceH4/Multilingual-Thinking. Dataset ini memuat sekitar 949 sampel data latih dan 50 data validasi berupa chain-of-thought logika dan matematika yang diterjemahkan ke bahasa Prancis, Jerman, Spanyol, dan Italia di samping bahasa Inggris.
Memahami Konsep SFT vs GRPO: Kapan Harus Dipakai?
Banyak developer yang sering bingung memilih antara supervised fine-tuning langsung atau langsung lompat menerapkan reinforcement learning. Eksperimen AWS ini ngasih aturan praktis yang sangat intuitif:
- SFT mengajarkan perilaku yang belum dimiliki model. Kalau model punya probabilitas mendekati nol untuk melakukan suatu instruksi, SFT bertugas menanamkan pola dasar itu dari awal lewat contoh data.
- GRPO mengoptimalkan perilaku yang sudah bisa diproduksi sesekali. GRPO bekerja dengan mengambil sampel sekelompok respons untuk tiap prompt, lalu mendorong bobot model ke arah respons yang nilainya di atas rata-rata.
Prinsip inilah yang menjelaskan kenapa SFT jadi pondasi wajib dalam proyek fine tuning gpt oss sagemaker ini, baru kemudian ditutup dengan GRPO untuk memoles hasil akhirnya.
Bedah Arsitektur Training di Amazon SageMaker HyperPod
Untuk menjalankan proses training terdistribusi tanpa kendala memori dan sinkronisasi, tim AWS merancang stack infrastruktur modern di Amazon SageMaker HyperPod dengan orkestrasi Amazon Elastic Kubernetes Service (EKS). Kamu juga bisa membandingkan fleksibilitas infrastruktur cloud ini dengan ulasan SageMaker Studio tanpa kartu kredit buat eksplorasi awal.
Pada eksperimen GPT-OSS-20B, mereka menggunakan klaster berisikan 4 instance ml.g6e.12xlarge yang totalnya memuat 16 kartu GPU NVIDIA L40S 48GB. Storage bersama berkecepatan tinggi ditangani oleh Amazon FSx for Lustre yang dipasang lewat PersistentVolumeClaim bernama fsx-claim pada path /fsx.
Konektivitas antarnode GPU memanfaatkan Elastic Fabric Adapter (EFA) bersama tumpukan NVIDIA Collective Communications Library (NCCL) dan aws-ofi-nccl. Sementara manajemen job training elastis dikelola oleh Kueue menggunakan custom resource HyperPodPyTorchJob lewat perintah hyperpodrun.
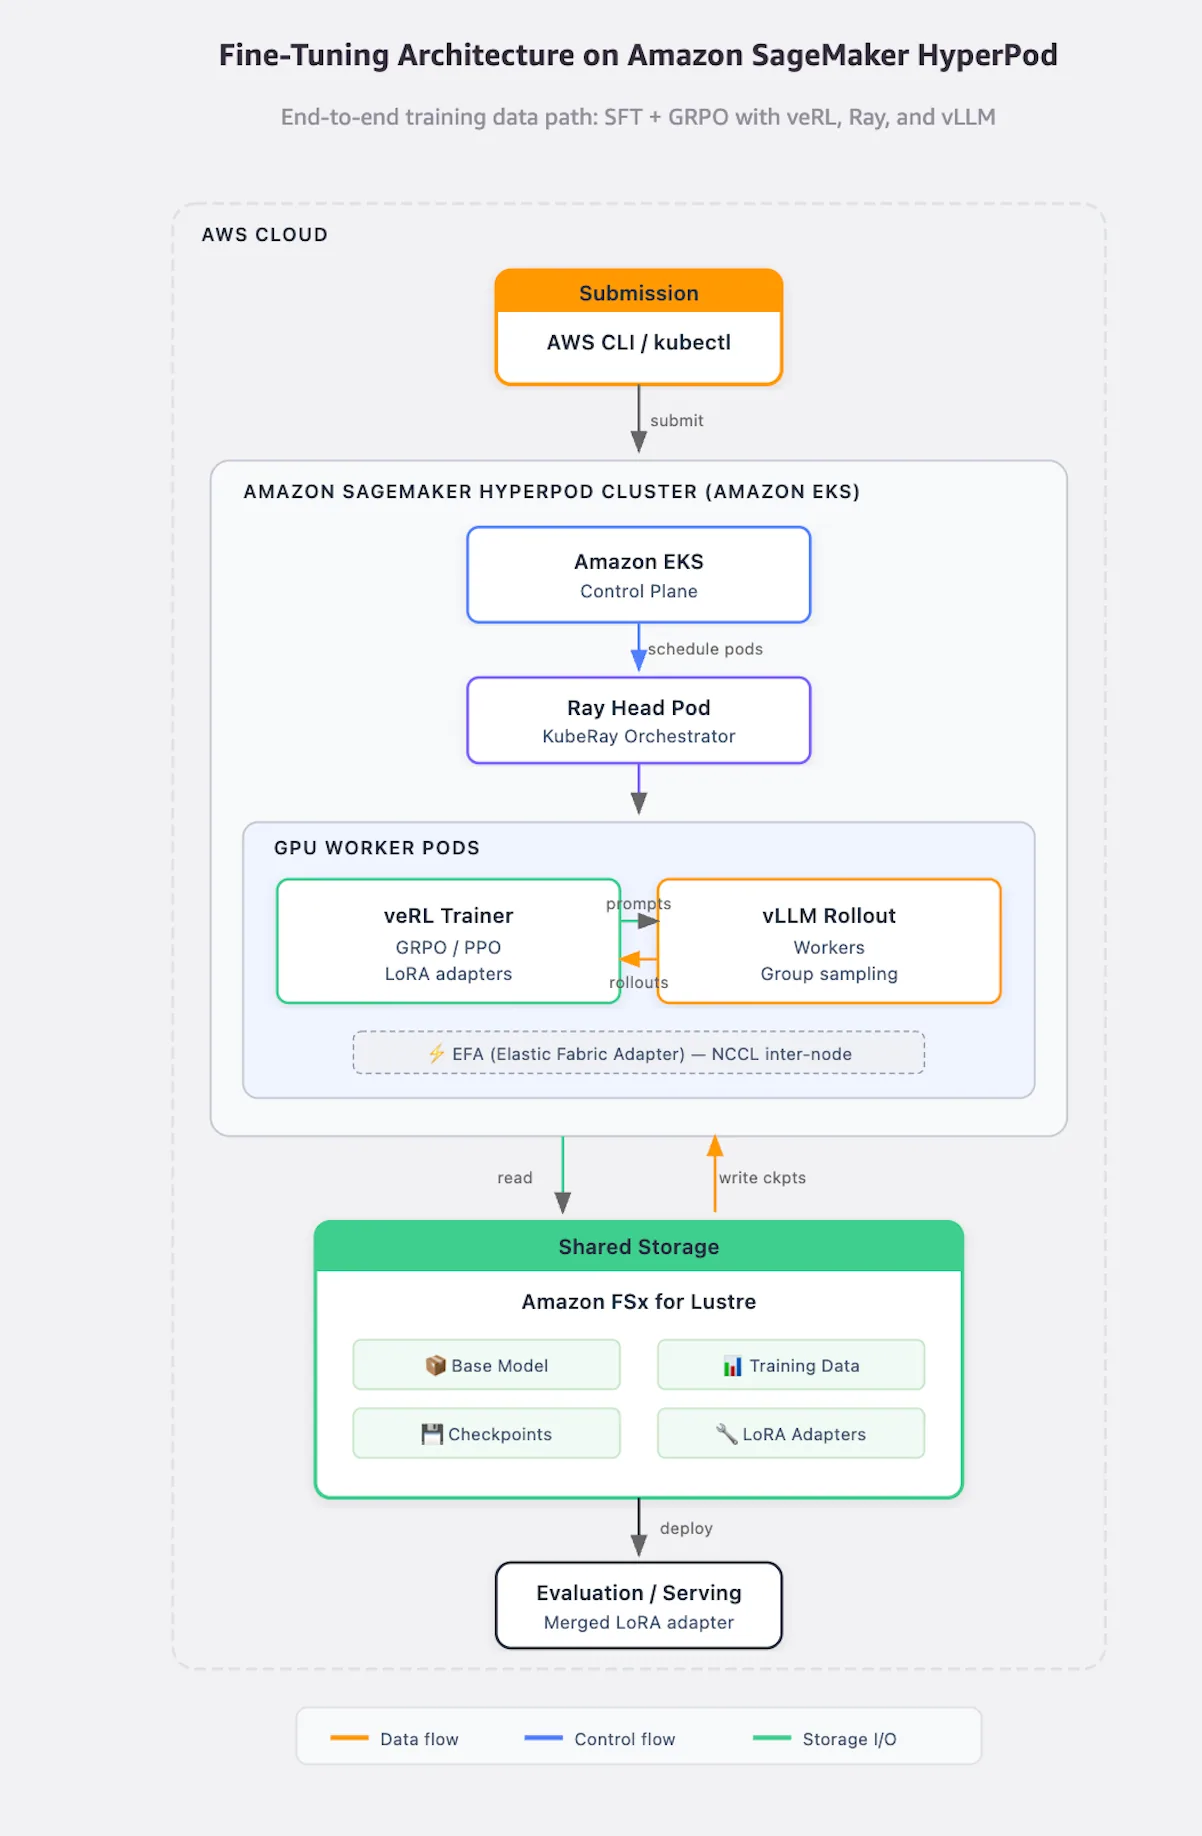
Pada diagram alur data di atas, submission job training dari developer masuk melalui control plane Amazon EKS di SageMaker HyperPod. EKS kemudian menjadwalkan Ray head pod dan worker pod yang menjalankan trainer veRL serta pekerja rollout vLLM. Kedua kelompok pod ini membaca model dasar dan data latih secara paralel dari Amazon FSx for Lustre, sementara adapter LoRA hasil training langsung disimpan kembali ke storage bersama tersebut.
Tahap 1: Fine-Tune GPT-OSS-20B dengan SFT dan LoRA
Langkah pertama dimulai dengan menjalankan SFT berbasis Parameter-Efficient Fine-Tuning (PEFT) LoRA dengan konfigurasi r=8 dan α=16. Model dilatih selama 1.000 langkah menggunakan Fully Sharded Data Parallel (FSDP) full-shard, presisi bf16, dan gradient checkpointing.
Proses belajarnya ternyata membentuk kurva bertingkat (staged learning curve) yang sangat menarik:
- Di sekitar step 200, model sudah sepenuhnya paham cara bernalar dalam bahasa target. Metrik bahasa penalaran (reasoning-language) langsung melonjak ke 100%.
- Menjelang step 1000, model baru mulai belajar konsisten menyajikan jawaban akhir (answer-language) dalam bahasa yang sama.
Pada evaluasi akhir SFT di langkah 1.000, akurasi bahasa penalaran mencapai 100% (50/50 kasus). Namun, akurasi bahasa jawaban akhir baru mentok di angka 62% (31/50 kasus). Rincian per bahasanya: Prancis 60%, Jerman 60%, Spanyol 30%, Italia 60%, dan Inggris 100%.
Di sinilah batas SFT terlihat. Menghasilkan jawaban akhir yang pendek dalam bahasa non-Inggris ternyata lebih menantang karena bias bahasa Inggris bawaan model paling kuat menempel di bagian penutup respons.
Tahap 2: Poles Bahasa Jawaban Menggunakan GRPO
Karena model hasil SFT sudah 100% konsisten bernalar dalam bahasa target dan kadang-kadang (62%) sudah bisa menjawab dengan benar, kondisi ini membuka ruang peningkatan (headroom) yang sempurna buat teknik GRPO.
AWS menjalankan GRPO memakai pustaka TRL GRPOTrainer di atas checkpoint hasil SFT tadi. Mereka memuat LoRA SFT, menjalankan merge_and_unload, lalu menambahkan adapter LoRA baru (r=8, α=16, hanya 0,068% parameter aktif atau sekitar 13,6 juta parameter dari total 20 miliar parameter).
Parameter training GRPO disetel dengan K=8 generasi per prompt, learning rate 1e-6, dan 10 epoch. Fungsi reward dirancang untuk mengevaluasi tiga komponen utama:
- Ketepatan bahasa jawaban (skor ±5,0)
- Ketepatan bahasa penalaran (skor ±1,5)
- Keringkasan format (skor +0,5 atau -1,0)
Kombinasi reward ini menghasilkan rentang nilai antara -7,5 hingga +7,0. Hasilnya terbukti sangat efektif:
- Metrik bahasa penalaran tetap bertahan sempurna di angka 100% (GRPO tidak merusak apa yang sudah diajarkan SFT).
- Metrik bahasa jawaban naik dari 62% ke 70% (peningkatan bersih +8 poin persentase, 35/50 kasus benar).
- Skor kedua metrik benar sekaligus ikut naik menjadi 70%.
- Rincian jawaban akhir per bahasa: Prancis 70%, Jerman 80%, Spanyol 60%, Italia 40%, dan Inggris 100%.
Pembuktian Hipotesis Headroom Lewat Kontrol Qwen2.5-7B
Untuk membuktikan apakah rumus "SFT dulu, baru GRPO jika ada headroom" ini berlaku umum, tim AWS menjalankan eksperimen pembanding memakai model Qwen2.5-7B-Instruct pada dua tugas berbeda. Infrastrukturnya memakai 2 instance g6e.48xlarge (16x L40S) dengan tumpukan veRL v0.6.1, Ray 2.44, KubeRay 1.4.2, dan vLLM 0.8.4.
Berikut perbandingan hasil pengujian pada tugas penalaran multibahasa (multilingual reasoning):
| Metrik Evaluasi | Varian A (Base) | Varian B (SFT Saja) | Varian C (SFT + GRPO) | Selisih GRPO (Δ) |
|---|---|---|---|---|
| Format Terstruktur | 0% | 92% | 98% | +6% |
| Bahasa Penalaran | 0% | 96% | 98% | +2% |
| Bahasa Jawaban | 0% | 38% | 44% | +6% |
| Keduanya Benar | 0% | 38% | 44% | +6% |
Pada tugas ini, GRPO kembali menyumbang kenaikan terukur sebesar +6% karena masih ada ruang peningkatan dari hasil SFT.
Sebaliknya, pada tugas GSM8K (penalaran matematika sekolah dasar), model dasar Qwen2.5-7B bawaan sudah mencetak akurasi tinggi sebesar 90,5% (181/200 soal). Ketika dijalankan pelatihan GRPO hingga step 30, akurasinya tetap persis di angka 90,5% tanpa ada peningkatan sama sekali.
Kenapa bisa begitu? Karena sebagian besar sampel respons dalam grup sudah sama-sama benar. Akibatnya, nilai keunggulan relatif antarsampel (group-relative advantage) rontok mendekati nol, sehingga model tidak mendapatkan gradien perubahan bobot yang berarti.
Panduan Praktis Menjalankan Pipeline Fine Tuning
Seluruh skrip dan konfigurasi manifes Kubernetes proyek ini sudah dipublikasikan di repositori resmi awsome-distributed-ai. Kalau kamu mau mereplikasi langkah ini di klaster EKS milikmu, berikut urutan langkah intinya:
1. Clone Repositori dan Set Lingkungan Kerja
Unduh repositori pengujian dan masuk ke direktori modul:
git clone https://github.com/awslabs/awsome-distributed-ai
cd awsome-distributed-ai/3.test_cases/pytorch/trl/gpt-oss-lora-grpo
cp env_vars.example env_vars
Edit berkas env_vars dengan memasukkan URL Amazon ECR, nama image, tag, serta token Hugging Face kamu, lalu jalankan source env_vars.
2. Build Container Image dan Siapkan Storage
Bangun image container yang memuat dependensi PyTorch, TRL, Transformers, dan PEFT, lalu unggah ke registry:
cd artifacts && ./build_push.sh && cd ..
aws eks update-kubeconfig --name <NAMA_KLASTER_KAMU> --region us-east-2
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' < kubernetes/fsx-storage-manager.yaml | kubectl apply -f -
3. Eksekusi Training SFT dan Konversi Checkpoint
Jalankan job training SFT di klaster HyperPod:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' < hyperpod-eks/train-lora-hyperpod-elastic-g6e.yaml | kubectl apply -f -Pantau log training dengan perintah kubectl logs -f -l app=gpt-oss-lora-elastic. Setelah selesai 1.000 step, ubah format checkpoint FSDP ke format PEFT melalui pod storage manager:
kubectl exec -it fsx-storage-manager -- python /app/convert_fsdp_checkpoint.py \
  --checkpoint /fsx/checkpoints/checkpoint-1000 \
  --output /fsx/checkpoints/converted-peft/lora-checkpoint-1000-peft
4. Eksekusi GRPO dan Uji Inferensi
Luncurkan training GRPO dari checkpoint yang sudah dikonversi:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' < kubernetes/train-grpo-singlenode.yaml | kubectl apply -f -Untuk menguji apakah model kamu sekarang sudah benar-benar mikir dalam bahasa yang diminta, kamu bisa memakai template prompt pengujian berikut:
System: You are an expert reasoning AI. You must produce your chain-of-thought and your final answer strictly in the requested target language.Reasoning language: French User: Jean a trois fois plus de pommes que Marie. Si Marie en a 4, combien de pommes Jean a-t-il au total ?
Dampak Nyata untuk Praktisi dan Developer AI di Indonesia
Temuan dari riset AWS ini ngasih panduan teknis yang sangat berharga buat ekosistem pengembang AI di Indonesia. Sering kali model penalaran canggih yang kita unduh dari Hugging Face kesulitan diajak berpikir runut memakai bahasa Indonesia formal atau bahasa daerah, dan cenderung melompat kembali ke logika bahasa Inggris.
Dengan memanfaatkan metode SFT berbasis LoRA ini, tim developer lokal nggak perlu melatih ulang model fondasi dari nol yang memakan biaya miliaran rupiah. Cukup siapkan dataset penalaran berbahasa Indonesia sekitar 1.000 sampel berkualitas tinggi, jalankan SFT untuk menanamkan kemampuan bahasa nalar, lalu lanjutkan dengan GRPO jika ingin menyempurnakan gaya penyusunan respons akhirnya.
Kalau kamu lagi membangun prototipe aplikasi cerdas atau agen AI dan belum berencana mengelola klaster GPU skala enterprise sendiri, kamu bisa memanfaatkan model penalaran siap pakai lewat Classai Router. Lewat satu API key terpadu, kamu bisa langsung mengakses model penalaran canggih seperti DeepSeek V4.1 Flash (deepseek-v4.1-flash) seharga Rp1.155 per 1 juta token input dan Rp4.200 per 1 juta token output, atau Qwen 3.7 Plus (qwen3.7-plus) mulai Rp810 per 1 juta token input.
Bagi engineer yang ingin memperdalam integrasi sistem cerdas ini ke dalam pipeline produksi berbasis cloud, kamu juga bisa mengikuti panduan komprehensif di kelas AI untuk Developer. Di sana kamu bakal belajar praktik terbaik menyusun prompt terstruktur, orkestrasi alat otomatis, hingga optimasi biaya token aplikasi komersial.
Sumber & referensi
- 01
AWS · 21 Oktober 2026
Fine-tuning GPT-OSS-20B for multilingual reasoning on Amazon SageMaker HyperPod
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa kelemahan utama model penalaran open-weight seperti GPT-OSS-20B sebelum di-fine-tune?
Kelemahan utamanya adalah model bawaan hampir selalu bernalar dalam bahasa Inggris meski sistem prompt meminta bahasa lain. Pada pengujian awal, akurasi penalaran bahasa non-Inggris model dasar hanya berkisar 0% hingga 10%.
Mengapa kita tidak langsung melatih model menggunakan metode GRPO saja?
GRPO tidak bisa mengajarkan kemampuan baru yang probabilitas dasarnya nol di dalam model. GRPO hanya bisa memperkuat pola jawaban yang sesekali sudah bisa dihasilkan, sehingga SFT wajib dilakukan lebih dulu untuk menanamkan kemampuan dasar.
Apa arti konsep headroom dalam pelatihan reinforcement learning seperti GRPO?
Headroom adalah ruang peningkatan di mana model terkadang bisa menjawab benar tetapi belum konsisten (pass@k jauh lebih tinggi dari pass@1). Jika akurasi model sudah mendekati 100% pada suatu tugas, keunggulan relatif antarrespons menjadi nol sehingga GRPO tidak memberikan peningkatan apa pun.
Spesifikasi infrastruktur apa yang dipakai AWS untuk fine tuning GPT-OSS-20B?
Eksperimen SFT GPT-OSS-20B memakai 4 instance ml.g6e.12xlarge dengan total 16 GPU NVIDIA L40S 48GB di Amazon SageMaker HyperPod. Penyimpanan data latih dan checkpoint ditangani oleh Amazon FSx for Lustre dengan jaringan interkoneksi Elastic Fabric Adapter (EFA).
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.