Distilasi Agen SageMaker AI: Pangkas Biaya Agen AI Skala Besar
Mau bikin agen AI mandiri tapi takut boncos karena biaya model frontier? AWS bocorkan trik distilasi agen di SageMaker AI pakai SeqKD yang bikin model 4B sekelas raksasa.
· 10 menit baca
Inti singkat
- Distilasi agen SageMaker AI pakai teknik SeqKD sukses bikin model 4B menyamai skor task agen frontier sebesar 54,1%.
- Menyertakan proses penalaran (reasoning) saat fine-tuning terbukti menaikkan success rate agen hingga 13 poin dibanding cuma meniru tool call.
- Model student LoRA disajikan lewat container DJL LMI di instance G-family untuk mengubah tagihan token variabel jadi biaya server tetap yang hemat.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
AWS membagikan cara distilasi agen SageMaker AI menggunakan metode Sequence-level Knowledge Distillation (SeqKD), yang terbukti bikin model kecil 4B bisa menandingi performa agen frontier dengan biaya hosting yang jauh lebih ramah di kantong.
Kamu mungkin pernah bikin asisten belanja atau customer service berbasis agen AI yang ditenagai model raksasa (frontier model), dan hasilnya emang keren banget. Pengguna minta dicarikan tas pinggang hitam di bawah 20 dolar dari toko rating 4,5 ke atas, lalu si agen otomatis jalan: mencari katalog produk, memeriksa filter harga, mengecek ulasan toko, dan ngasih rekomendasi akhir. Tapi coba hitung berapa biaya yang keluar buat satu transaksi tadi?
Seperti dibahas dalam panduan resmi AWS Machine Learning Blog, sistem agen AI itu bukan sekadar satu panggilan API sekali jalan. Agen AI bekerja dalam sebuah putaran (loop) multi-langkah: cari data, baca hasil, perbaiki kueri, verifikasi kriteria, baru bikin keputusan. Kalau tiap langkah memanggil model frontier berbayar mahal, biaya produksi agen AI bakal melesat tinggi pas pengguna aplikasi kamu mulai membludak. Biar nggak boncos, teknik knowledge distillation jadi jalan keluar paling realistis.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Biaya Produksi Agen AI Sering Bikin Boncos?
Banyak developer pemula kaget pas melihat tagihan API saat agen AI mereka masuk tahap uji coba pengguna massal. Masalahnya ada pada sifat dasar agen itu sendiri. Kalau chatbot biasa cuma butuh satu kali request-response, agen AI butuh berulang kali bolak-balik mikir dan memanggil tool eksternal sebelum ngasih jawaban akhir ke pengguna.
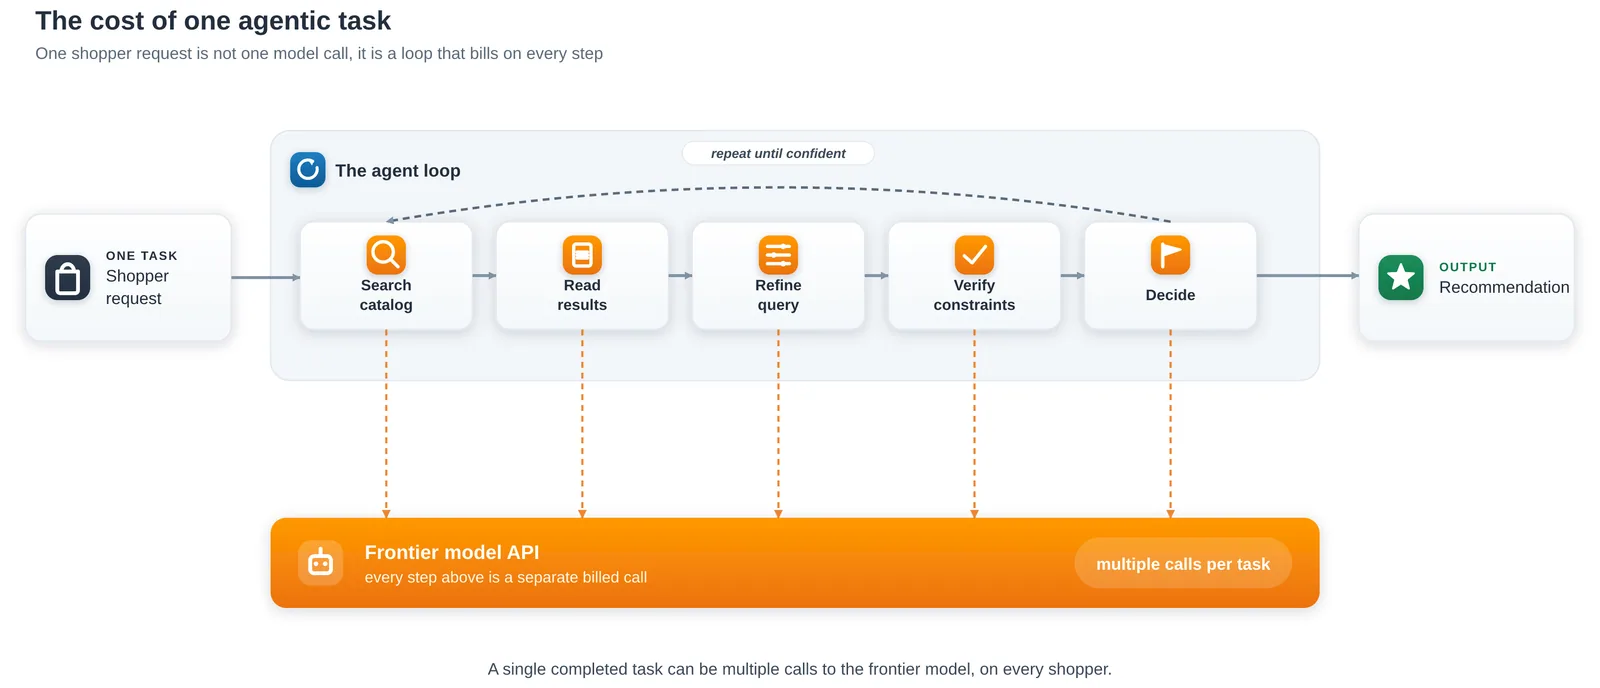
Bayangkan kalau satu permintaan belanja butuh 5 sampai 8 langkah penalaran. Berarti ada 8 panggilan token input dan output ke model frontier cuma buat melayani satu orang pembeli. Di level produksi, biaya per tugas ini menumpuk cepat banget dan langsung menggerus margin bisnis kamu. Solusi memakai model kecil yang murah sering kali gagal karena model mungil biasanya gampang bingung pas disuruh memanggil tool berurutan.
Di sinilah teknik distilasi agen SageMaker AI hadir buat menjembatani jurang antara kualitas model raksasa dan efisiensi model kecil. Lewat distilasi, kepintaran model guru (teacher) dipindahkan ke model murid (student) yang jauh lebih ramping.
Apa Itu Sequence-Level Knowledge Distillation (SeqKD)?
Distilasi model biasanya butuh akses ke struktur jeroan model seperti bobot (weights), distribusi probabilitas token (logits), atau gradien. Masalahnya, model-model frontier terbaik saat ini kebanyakan berstatus tertutup dan cuma bisa diakses lewat antarmuka API. Di kondisi kayak gini, teknik Sequence-level Knowledge Distillation (SeqKD) adalah pilihan paling pas.
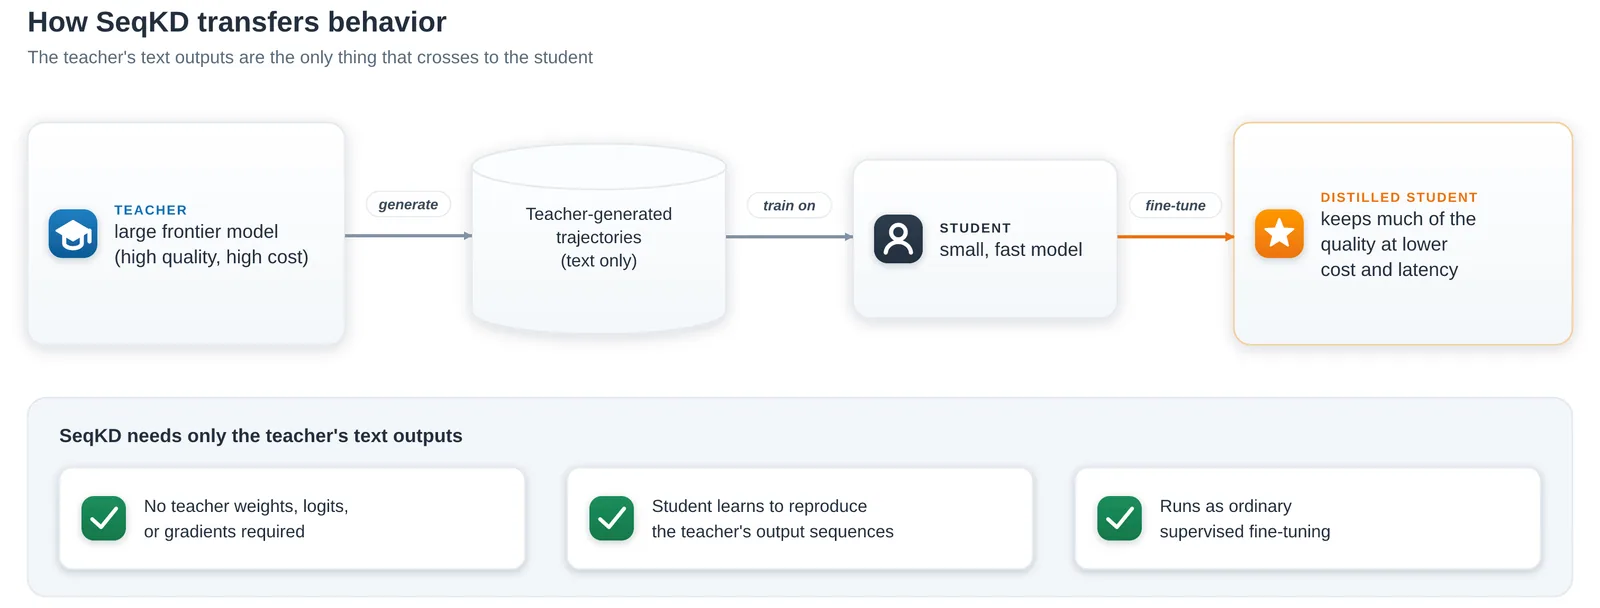
SeqKD bekerja murni menggunakan output teks yang dihasilkan oleh model guru. Guru diminta menyelesaikan serangkaian tugas, mencatat seluruh jalannya proses (trajektori), lalu hasil catatan tadi dijadikan data latihan buat model murid lewat Supervised Fine-Tuning (SFT) biasa. Karena cuma butuh teks hasil akhir, kamu bisa pakai model API apa pun sebagai guru tanpa pusing mikirin infrastruktur reinforcement learning yang ribet.
Pada sistem agen, trajektori yang ditiru bukan cuma paragraf jawaban akhir. Trajektori agen adalah urutan lengkap berisi alasan berpikir (reasoning), pemanggilan fungsi (tool calls), dan observasi balik dari sistem. Melatih model murid dengan seluruh trajektori ini bakal mengajarkan si murid cara berpikir runtut sebelum memutuskan tindakan berikutnya.
Kapan Kamu Perlu Pakai SeqKD Buat Agen AI?
Nggak semua masalah harus diselesaikan dengan distilasi rumit. Teknik SeqKD di Amazon SageMaker AI ini sangat tepat dipakai pas kamu menghadapi skenario berikut:
- Punya input tugas tapi nggak punya contoh jawaban ideal: Mengumpulkan ribuan contoh langkah agen secara manual itu mahal banget. Lewat SeqKD, model frontier yang bertindak sebagai pembuat target data sintetis.
- Model guru cuma bisa diakses via API: Kalau kamu pakai model seperti GLM-5.3 di Amazon Bedrock, kamu nggak bisa ngutak-ngatik arsitektur aslinya. SeqKD jadi satu-satunya cara distilasi yang bisa jalan.
- Butuh pijakan awal yang kokoh dan hemat: Banyak model penalaran mini yang populer belakangan ini dibangun lewat SeqKD. Contohnya model turunan DeepSeek-R1 distilled models yang menyalin jejak berpikir model besar ke arsitektur Qwen dan Llama.
Kalau kamu lagi merancang arsitektur data buat kebutuhan agen semacam ini, pastikan juga membaca panduan kami tentang /developer/kelola-biaya-amazon-bedrock biar pengelolaan kuota pengujian data sintetis kamu tetap terkontrol rapi.
Pipeline Distilasi Agen di Amazon SageMaker AI
Eksperimen yang dipaparkan AWS menggunakan studi kasus agen belanja e-commerce dengan benchmark ShoppingBench. Pipeline kerjanya dirancang otomatis mulai dari pembuatan data sampai deployment model murid.
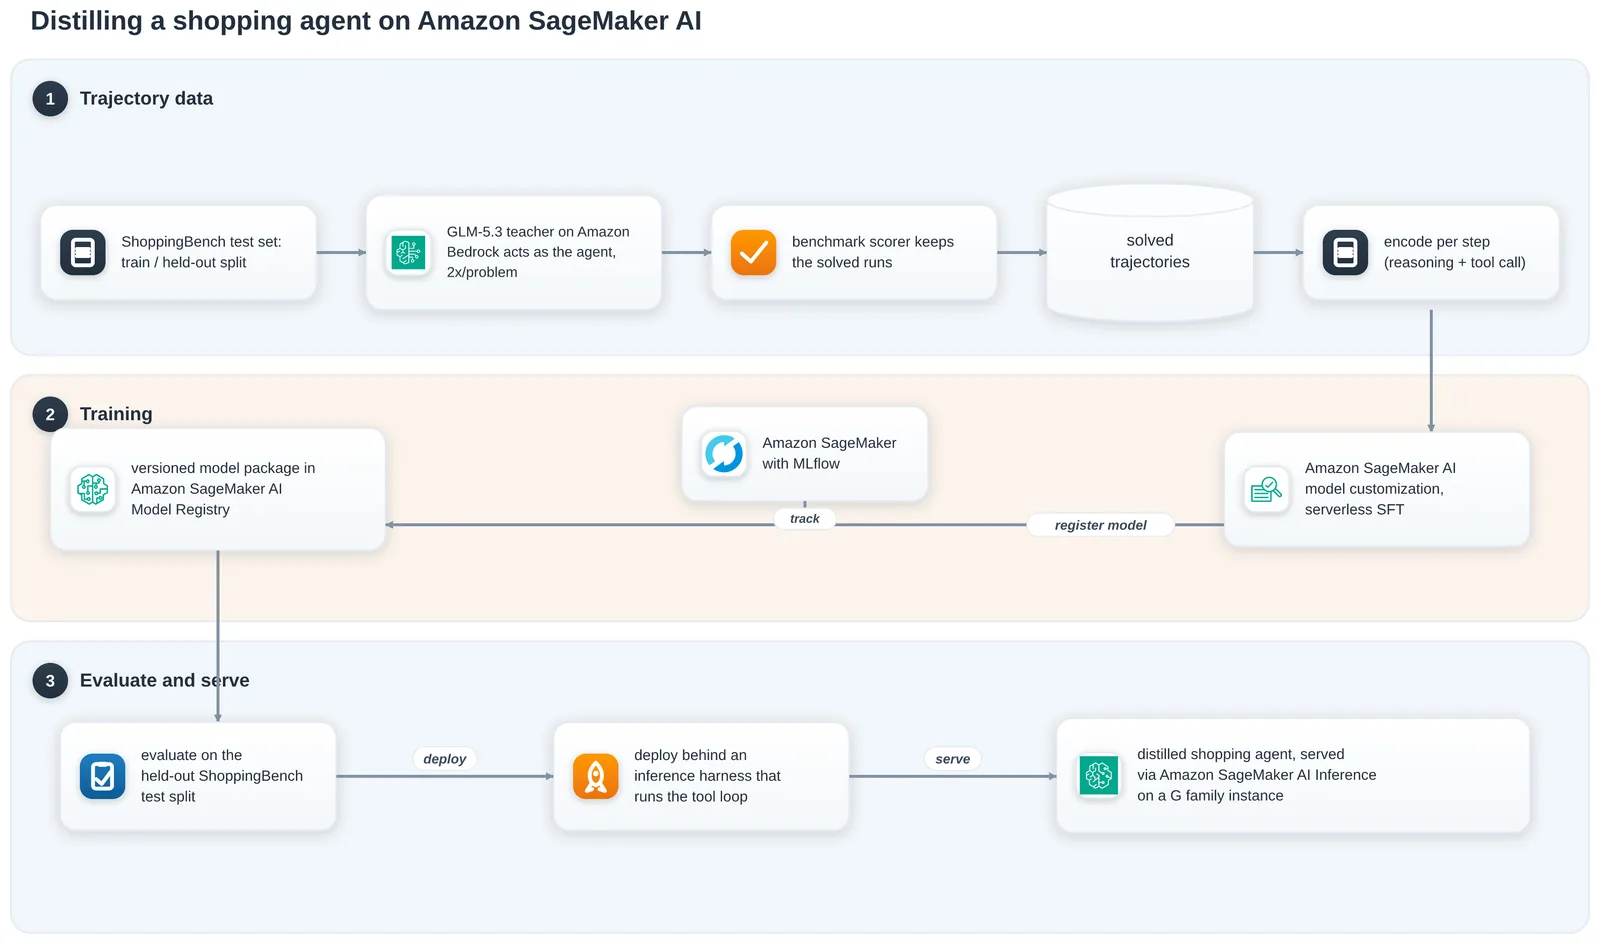
Dalam eksperimen ini, model frontier GLM-5.3 di Amazon Bedrock bertindak sebagai guru, sedangkan Qwen3.5-4B dipilih sebagai model murid yang bakal dilatih di SageMaker AI.
1. Menyiapkan Dataset dengan Rejection Sampling
ShoppingBench menyediakan 750 skenario belanja sintetis (produk, toko, dan voucher). Data ini dibagi menjadi 426 problem untuk latihan dan 324 problem untuk evaluasi akhir. Model guru GLM-5.3 dijalankan dengan reasoning aktif dan temperatur 1.0 untuk menyelesaikan tiap masalah belanja di katalog berisi 2,7 juta produk.
Setiap problem dicoba dua kali oleh model guru, menghasilkan 850 trajektori. Suhu 1.0 sengaja dipakai supaya eksplorasi kueri pencarian bervariasi. Dari kumpulan trajektori ini, dilakukan teknik rejection sampling: hanya trajektori yang lolos uji penilaian ShoppingBench (berhasil memenuhi semua batasan harga dan rating) yang disimpan sebagai data training. Langkah ini menyaring kesalahan guru sehingga murid cuma meniru langkah yang benar-benar sukses.
2. Format Data Per-Langkah (Per-Step Encoding)
Dataset yang sudah disaring diubah ke format percakapan chat. Tiap langkah tindakan agen dipecah jadi satu baris JSONL mandiri. Bagian user berisi riwayat percakapan dan instruksi sistem, sedangkan target assistant berisi blok pemikiran dan pemanggilan tool.
Berikut format baris data yang dipakai untuk melatih model murid:
{ "messages": [ { "role": "user", "content": "You are a shopping assistant...\n# Task\nFind a black waist bag under $20 from a shop rated 4.5 or higher.\n# Observations so far\n(none yet)" }, { "role": "assistant", "content": "<think>Start with a broad search and let the price filter work before I narrow by shop rating.</think>\n<tool_call>[{\"name\": \"find_product\", \"parameters\": {\"q\": \"black waist bag\", \"price\": \"0-20\"}}]</tool_call>" } ]}
Data hasil filter ini menghasilkan sekitar 2.600 baris training dan 130 baris validasi. Pembagian validasi wajib dilakukan per problem belanja utuh (bukan acak per baris), biar konteks masalah nggak bocor antara data latih dan data uji.
Langkah Fine-Tuning Serverless dan Evaluasi Model Student
Setelah dataset JSONL diunggah ke Amazon S3, proses pelatihan dijalankan lewat fitur SageMaker AI model customization menggunakan SFT Trainer serverless. Kamu nggak perlu pusing mengelola cluster GPU mentah atau menulis script training dari nol.
Pelatihan dikonfigurasi menggunakan teknik Low-Rank Adaptation (LoRA) dengan rank 64 dan alpha 256 pada model dasar Qwen3.5-4B. Panjang urutan (dataset_max_len) disetel ke 16.384 token dan dilatih selama 3 epoch. Metrik pelatihan dipantau secara real-time via integrasi SageMaker dengan MLflow.
Sebelum menjalankan pengujian penuh yang butuh server katalog besar, AWS menyarankan evaluasi dua tahap:
- Pre-check Custom Scorer: Uji cepat dan murah di SageMaker AI model evaluation. Fungsi evaluasi mengecek apakah model murid memanggil nama tool yang sama persis dengan yang dipanggil guru pada tiap langkah.
- End-to-End Evaluation: Kalau skor pre-check terbukti mengungguli model dasar, baru deploy model ke endpoint real-time untuk menjalankan loop agen belanja utuh.
Model murid disajikan sebagai adapter LoRA di atas base model menggunakan container Deep Java Library Large Model Inference (DJL LMI) dengan engine vLLM. Skema ini menghemat memori GPU secara drastis karena base model dan adapter bisa berbagi kapasitas dalam satu instance tipe ml.g5.2xlarge atau ml.g6.2xlarge.
Kalau kamu mengelola banyak eksperimen pelatihan GPU bersama tim developer lainnya di AWS, cek juga trik alokasi resource di ulasan kami tentang /developer/aws-batch-quota-sagemaker-training-gpu.
Hasil Benchmark: Model 4B Sukses Saingi Model Frontier
Pengujian dilakukan pada 324 problem evaluasi ShoppingBench yang belum pernah dilihat model selama training. Metrik yang diukur adalah Absolute Success Rate (ASR), yaitu persentase masalah belanja yang diselesaikan dengan rekomendasi produk yang benar-benar valid.
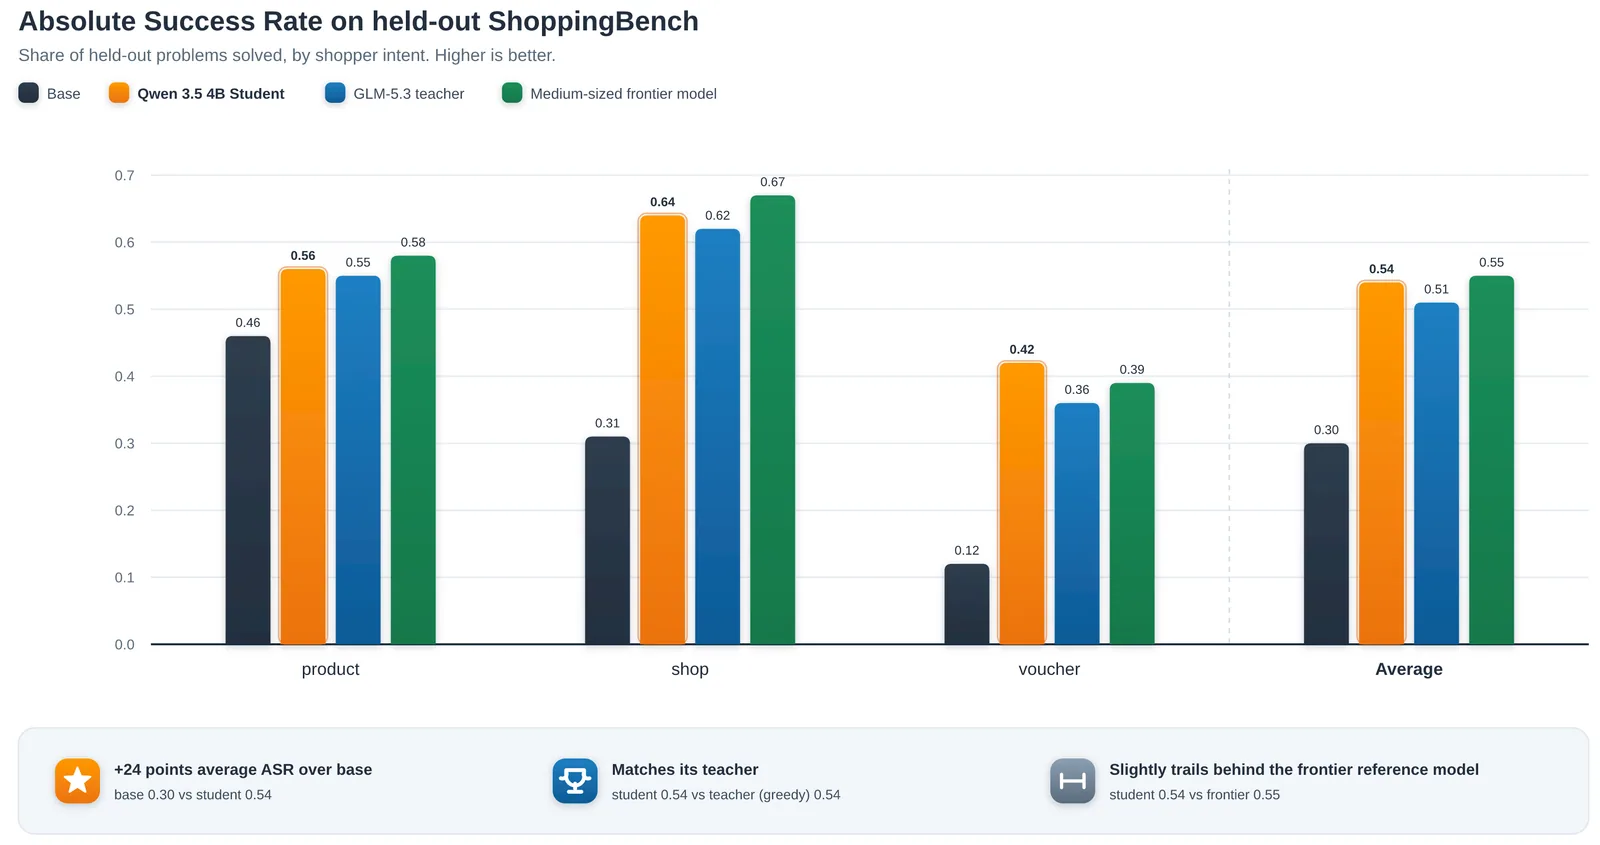
Berikut rangkuman angka performa yang dicatatkan dari pengujian ini:
| Model AI | Kategori Product | Kategori Shop | Kategori Voucher | Rata-Rata ASR |
|---|---|---|---|---|
| Base Qwen3.5-4B (tanpa fine-tuning) | 0,456 | 0,314 | 0,121 | 0,297 |
| Distilled Student 4B (SeqKD) | 0,563 | 0,638 | 0,422 | 0,541 |
| GLM-5.3 Teacher (sampled, temp 1.0) | 0,553 | 0,619 | 0,362 | 0,511 |
| GLM-5.3 Teacher (greedy, temp 0) | 0,544 | 0,638 | 0,439 | 0,540 |
| Frontier Model Kelas Menengah | 0,583 | 0,667 | 0,388 | 0,546 |
Hasil di atas membuktikan bahwa model mungil 4B yang sudah didistilasi berhasil mendongkrak ASR sebesar 24 poin dari versi standarnya (dari 0,297 jadi 0,541). Nilai ini bahkan sukses menandingi model frontier kelas menengah (0,546) dan model guru GLM-5.3 versi greedy (0,540).
Alasan Penalaran (Reasoning) Jadi Kunci Utama
Eksperimen AWS juga menguji apa yang terjadi kalau jejak pemikiran guru dibuang dan murid cuma dilatih meniru perintah tool call-nya saja.
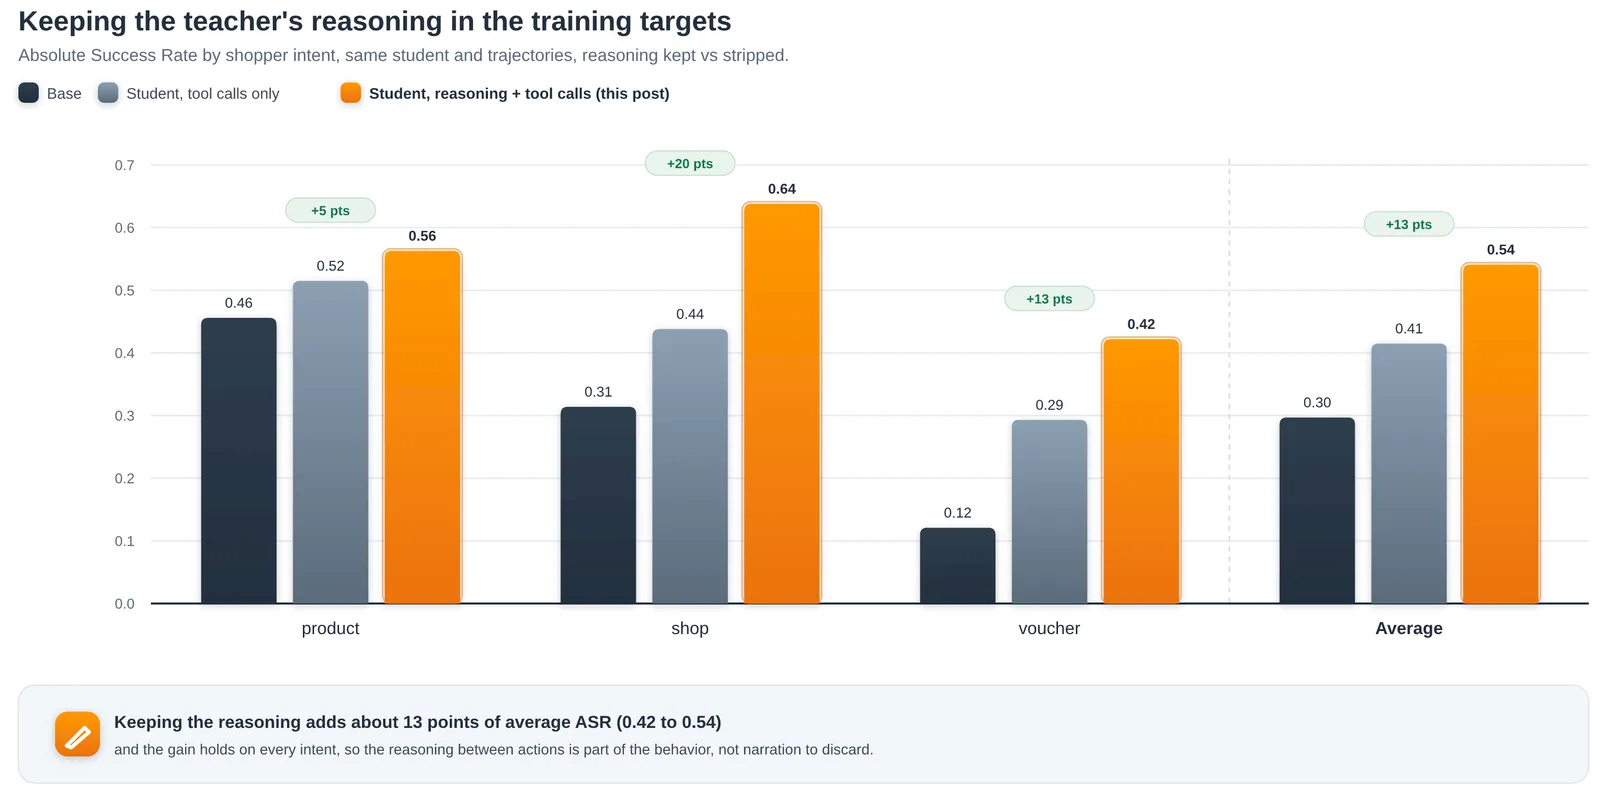
Saat teks reasoning dihilangkan dari data latihan, skor rata-rata ASR murid langsung anjlok dari 0,541 ke 0,415. Ini membuktikan bahwa blok penalaran bukan sekadar basa-basi teks, melainkan bagian inti dari perilaku cerdas yang memandu agen mengambil langkah yang tepat.
Pengaruh Terhadap Kemampuan Umum (IFEval)
Fine-tuning untuk tugas spesifik biasanya punya efek samping menurunkan kepintaran umum model. Tim AWS mengujinya menggunakan tolok ukur kepatuhan instruksi IFEval.
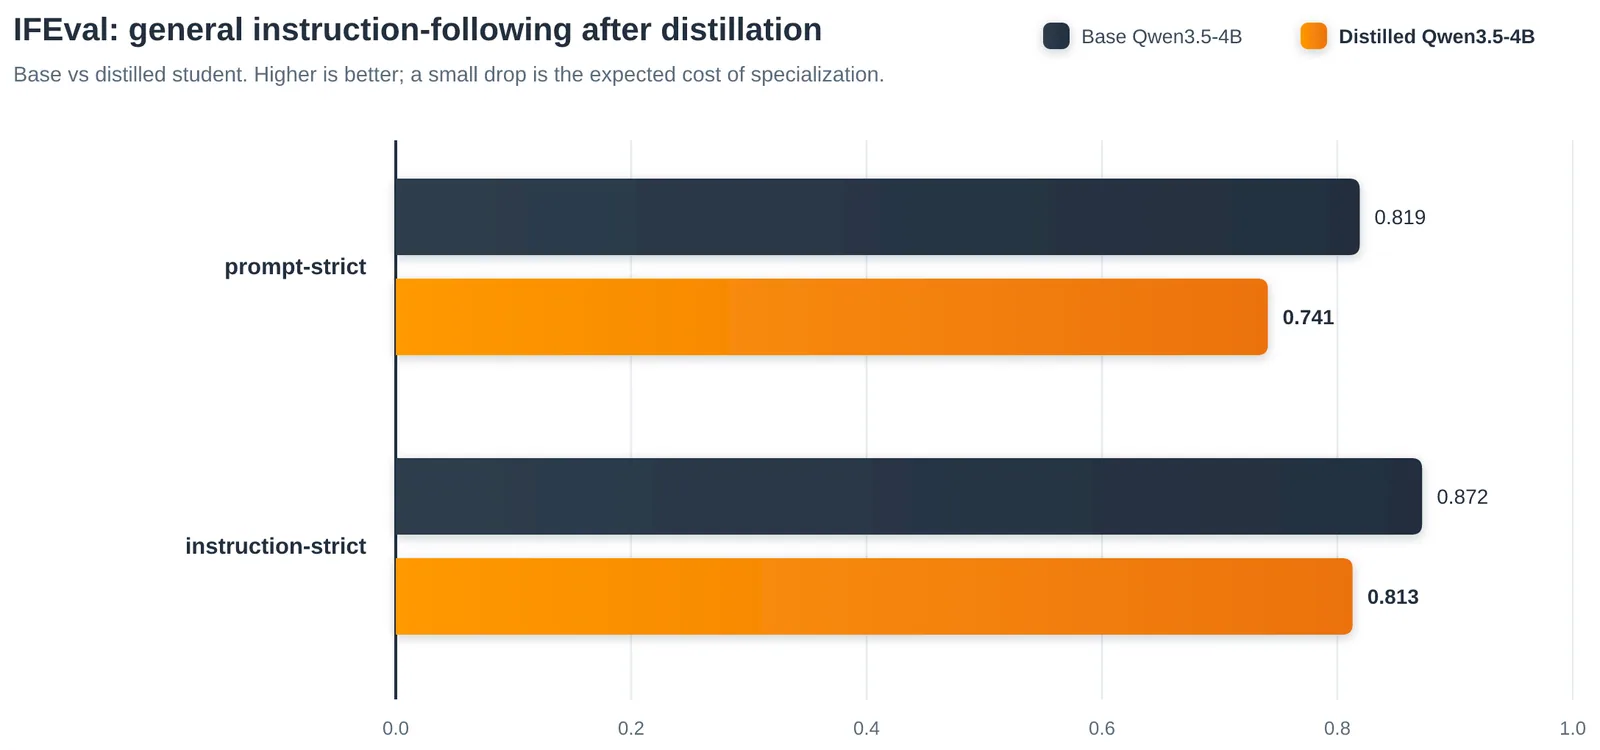
Skor prompt-strict model murid turun dari 0,819 ke 0,741, sementara instruction-strict turun dari 0,872 ke 0,813. Penurunan sekitar 6 sampai 8 poin ini dinilai sebagai kompromi yang sangat wajar buat model yang dispesialisasi menangani workflow spesifik.
Batasan SeqKD dan Kapan Waspada Capacity Wall
Meski SeqKD kelihatan sangat menjanjikan buat memangkas pengeluaran operasional agen, ada beberapa batasan penting yang wajib kamu pahami sebelum menerapkannya di aplikasi komersial.
Gejala capacity wall gampang dikenali: teks pemikiran model murid makin panjang dan rapi, tapi akurasi tugasnya jalan di tempat. Kalau tanda ini muncul di proyek kamu, solusinya cuma dua: naikkan ukuran parameter model murid atau sederhanakan ruang lingkup tugas agenmu.
Selain itu, metode SeqKD berbasis SFT punya keterbatasan pas menghadapi error berantai di tengah loop interaksi. Model murid belum diajarkan cara memulihkan diri kalau di langkah awal dia salah memanggil tool. Untuk mengatasi error berantai ini, teknik lanjutan seperti on-policy reinforcement learning biasanya dibutuhkan sebagai tahap penyempurnaan setelah SeqKD selesai.
Dampak Nyata Buat Developer dan Startup di Indonesia
Bagi software engineer, tech lead, maupun founder startup di Indonesia yang lagi membangun produk AI mandiri, pendekatan distilasi agen SageMaker AI ini membawa perubahan besar dari sisi manajemen biaya.
- Ubah Biaya Variabel Jadi Biaya Tetap: Memakai API frontier bikin kamu waswas tiap kali trafik pengguna melonjak karena tagihan dihitung per token. Lewat model 4B hasil distilasi yang di-host di instance GPU mandiri, biaya operasional server kamu jadi tetap dan mudah diprediksi.
- Kepatuhan Data Lokal: Dengan melatih dan menjalankan model open-weight sendiri di infrastruktur cloud privat, kamu punya kendali penuh atas data transaksi pengguna, sejalan dengan prinsip perlindungan privasi UU PDP di Indonesia.
- Latensi Respons Lebih Cepat: Model dengan 4 miliar parameter punya ukuran memori yang jauh lebih enteng, menghasilkan latensi antar-langkah tool yang jauh lebih gesit dibanding menunggu respons model raksasa dari server luar negeri.
Buat tahap awal saat kamu butuh menguji model guru frontier seperti GLM 5.3 sebelum menyiapkan data latih, kamu nggak perlu ribet daftar akun dan langganan kartu kredit luar negeri. Kamu bisa memanfaatkan Classai Router yang menyediakan akses API model GLM 5.3 seharga Rp1.875 per 1 juta token input dan Rp9.120 per 1 juta token output. Cukup gunakan satu API key yang kompatibel dengan format SDK OpenAI, lalu isi saldo instan pakai QRIS atau transfer bank lokal.
Sumber & referensi
- 01
AWS · 3 November 2026
Build efficient agents with knowledge distillation on Amazon SageMaker AI
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa keunggulan utama Sequence-level Knowledge Distillation (SeqKD) untuk agen AI?
SeqKD cuma butuh output teks dari model guru, jadi kamu bisa mendistilasi kepintaran model frontier tertutup yang cuma bisa diakses lewat API tanpa perlu akses bobot internal atau logits.
Kenapa menyertakan penalaran (reasoning) sangat penting saat distilasi agen AI?
Penalaran memandu model memahami konteks sebelum memutuskan pemanggilan fungsi. Eksperimen membuktikan bahwa menghapus penalaran membuat tingkat keberhasilan tugas agen anjlok hingga 13 poin persentase.
Berapa kapasitas model murid yang ideal untuk tugas agen belanja?
Model dengan ukuran 4 miliar parameter seperti Qwen3.5-4B terbukti sanggup menampung logika agen belanja dan menyamai model guru 40B asalkan dilatih memakai trajektori hasil seleksi ketat.
Bagaimana cara menyajikan model hasil distilasi secara hemat di AWS?
Kamu bisa menyajikan bobot dasar sekali saja di container DJL LMI pada instance GPU famili G, lalu menempelkan adapter LoRA hasil distilasi sebagai inference component terpisah di endpoint yang sama.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.