Kelola Biaya Amazon Bedrock: 5 Langkah FinOps Anti Boncos
Tagihan Bedrock melonjak gara-gara AI agent? Simak playbook 5 tahap dari AWS buat mengatur atribusi, pasang limit budget, dan pangkas biaya tanpa nebak-nebak.
· 9 menit baca
Inti singkat
- Kelola biaya generative AI butuh sistem operasional berulang, bukan sekadar memotong panjang prompt.
- Atribusi biaya invoice-grade bisa dicapai lewat IAM principal tags dan AWS CUR 2.0 tanpa bikin infrastruktur kustom.
- Shared-role gateway rawan menghilangkan transparansi biaya, tetapi bisa diatasi lewat role session tags STS.
- Prompt caching Claude di Bedrock bisa memangkas tarif token input berulang hingga diskon 90 sampai 95 persen.
- Tiga level enforcement budget mencakup alert AWS Budgets, deny policy IAM otomatis, dan gateway sinkron.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
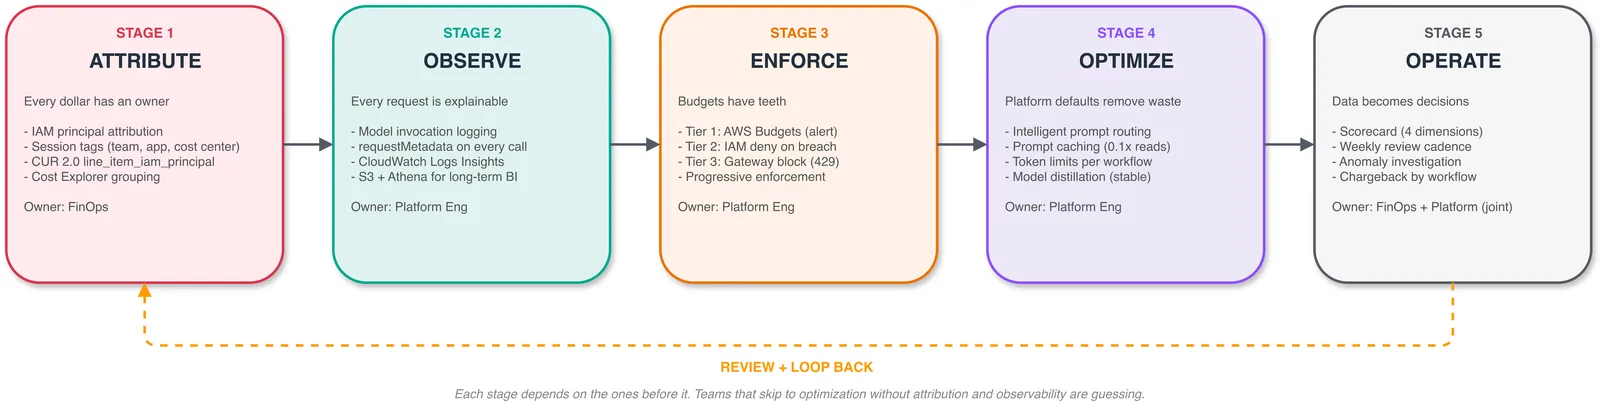
AWS merilis playbook resmi buat mengelola pengeluaran Amazon Bedrock secara menyeluruh lewat siklus FinOps lima tahap: atribusi, observabilitas, penegakan budget, optimasi default, dan operasional review. Panduan ini menjawab masalah klasik tim engineering dan finance yang sering kebingungan melacak tim mana yang menghabiskan token saat menjalankan aplikasi agentic skala besar.
Banyak tim yang baru mengadopsi AI generatif cuma fokus membandingkan harga token per model atau menyuruh developer memperpendek prompt. Pendekatan kayak gitu jelas nggak bakal menjawab pertanyaan bos waktu tagihan bulanan tiba: siapa yang pakai, buat fitur apa, dan kenapa bisa melewati kuota? Seperti dijelaskan oleh AWS Architecture & FinOps, alur kerja agentic bikin konsumsi token melonjak drastis karena satu perintah tugas bisa memicu puluhan pemanggilan model secara berantai sambil membawa konteks percakapan yang makin gendut.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Kelola Biaya Amazon Bedrock Nggak Cukup Cuma Potong Prompt?
Aplikasi AI percakapan biasa umumnya cuma butuh satu pemanggilan model per giliran obrolan pengguna. Beda ceritanya kalau kamu membangun asisten coding otomatis atau agen otonom mirip arsitektur Bedrock AgentCore. Agen bakal menyusun rencana, membaca deretan berkas, menjalankan tools eksternal, lalu mengecek hasilnya berkali-kali dalam satu tugas.
Konsumsi token akhirnya bergantung pada tingkat otonomi yang kamu kasih ke agen dan besarnya konteks data yang dibawa, bukan semata-mata jumlah ketukan jari user. Makanya, FinOps AI AWS adalah urusan disiplin arsitektur dan sistem operasi tim, bukan sekadar trik prompt engineering. Kamu nggak bisa cuma mengandalkan angka rata-rata di brosur; kamu wajib mengukur konsumsi nyata aplikasi kamu sendiri.
Solusi jangka panjangnya bukan buru-buru ganti ke model murah atau maksa prompt dipangkas habis. Kamu butuh sistem operasional lima langkah berulang yang menyematkan penanggung jawab di tiap rupiah pengeluaran, membuka visibilitas setiap panggilan API, membatasi budget sebelum jebol, dan merapikan setelan default platform secara berkala.
Tahap 1: Atribusi Setiap Dolar Sampai ke Level Pengguna
Prinsip utama FinOps sangat sederhana: kamu nggak bisa mengatur apa yang nggak bisa kamu lacak. Pondasi dari playbook ini adalah fitur atribusi biaya granular bawaan Amazon Bedrock. Fitur ini secara otomatis mencatat biaya inferensi ke entitas AWS Identity and Access Management (IAM) yang melakukan panggilan API, mencakup IAM user, IAM role, federated identities, sampai API key.
Supaya data ini muncul di laporan keuangan perusahaan, tim platform dan finance perlu menjalankan empat langkah berikut:
- Nyalakan data IAM principal di ekspor data AWS Cost and Usage Report (CUR) 2.0.
- Pasang tag dimensi bisnis pada IAM principal kamu, seperti nama tim (
team), nama aplikasi (application), dan pusat biaya (costCenter). Buat login federasi (SSO), atur identity provider (IdP) kamu supaya meneruskan nama sesi dan tag lewat klaim OIDC atau SAML. - Aktifkan tag itu sebagai Cost Allocation Tags di konsol AWS Billing atau panggil API
UpdateCostAllocationTagsStatus. - Analisis hasilnya di CUR 2.0 dengan awalan
iamPrincipal/(contohnyaiamPrincipal/team). Tag ini juga otomatis muncul di AWS Cost Explorer dalam 24 sampai 48 jam buat keperluan filter dan grouping.
Menuntaskan Masalah Shared-Role di Gateway AI
Titik rawan terbesar di banyak perusahaan adalah penggunaan gateway LLM bersama (shared-role problem). Kalau semua aplikasi memanggil Amazon Bedrock lewat satu IAM role yang sama, AWS cuma mencatat satu identitas itu saja di tagihan. Akibatnya, kamu kehilangan jejak pengguna atau tim mana yang boros.
Solusinya adalah manajemen sesi per pengguna. Gateway harus menjalankan operasi sts:AssumeRole ke role pemanggil Bedrock untuk setiap user secara spesifik, memasukkan identitas pengguna ke parameter RoleSessionName, dan menyematkan atribut tim ke dalam session tags. Kredensial sementara ini cukup dicache sampai satu jam, jadi panggilan AWS Security Token Service (STS) cuma terjadi satu kali per user per jam, bukan di tiap request.
Berikut contoh script Python menggunakan library Boto3 buat memisahkan atribusi user di balik shared gateway:
import boto3

sts = boto3.client("sts")

# Dipanggil sekali per user; simpan cache kredensial sampai 1 jam
response = sts.assume_role(
    RoleArn="arn:aws:iam::123456789012:role/BedrockRuntimeRole",
    RoleSessionName="gw-alex",  # identitas user, bukan nama gateway
    Tags=[
        {"Key": "team", "Value": "sales-ai"},
        {"Key": "application", "Value": "renewal-agent"},
        {"Key": "costCenter", "Value": "CC-2041"}
    ]
)
Hasilnya, entitas yang tercatat di laporan CUR bakal berformat rapi seperti assumed-role/BedrockRuntimeRole/gw-alex lengkap beserta tag divisinya. Kalau tim kamu memakai endpoint bedrock-mantle (Responses API atau Chat Completions API mirip format OpenAI), kamu bisa memakai fitur Bedrock Projects dan Workspaces untuk pengelompokan biaya.
Tahap 2: Bikin Setiap Request Terbaca dengan Invocation Logging
Laporan CUR memberi tahu siapa yang bayar, tapi invocation logging memberi tahu apa yang sebenarnya terjadi di balik layar. Amazon Bedrock mendukung logging pemanggilan model yang mencakup data request, response, dan metadata ke Amazon CloudWatch Logs, Amazon S3, atau keduanya sekaligus.
Pakai CloudWatch Logs untuk kebutuhan investigasi operasional yang butuh respons cepat, dan manfaatkan Amazon S3 plus Amazon Athena untuk analisis data analitik jangka panjang. Ingat, logging wajib dikelola lewat code (Infrastructure as Code) lengkap dengan retensi data dan enkripsi, jangan cuma dinyalakan manual di dashboard development.
Sematkan Request Metadata di Setiap Panggilan API
Supaya log bisa menjawab kebutuhan produk (fitur mana atau alur kerja mana yang bikin boros), pasang metadata terstruktur di setiap panggilan model. Contoh implementasi pemanggilan Anthropic Claude Sonnet 5.5 di Bedrock Converse API:
response = client.converse(
    modelId="us.anthropic.claude-sonnet-5-5",
    messages=[
        {"role": "user", "content": [{"text": "Ringkas status perpanjangan kontrak klien PT Maju Jaya."}]}
    ],
    requestMetadata={
        "application": "renewal-copilot",
        "workflow": "renewal-risk-summary",
        "tenant": "enterprise-sales",
        "agent": "renewal-agent"
    }
)
Karena Bedrock tidak mewajibkan format metadata tertentu, tim platform harus mengunci schema ini lewat SDK wrapper internal agar kuncinya seragam di semua microservice.
Buat mencari siapa atau alur kerja mana yang paling banyak menghabiskan token, kamu bisa langsung menjalankan query di CloudWatch Logs Insights berikut:
fields @timestamp, identity.arn as caller, modelId,
input.inputTokenCount as inTokens,
output.outputTokenCount as outTokens
| stats sum(inTokens + outTokens) as totalTokens,
count(*) as calls
by caller, modelId
| sort totalTokens desc
| limit 25
Ubah pengelompokan by caller menjadi by requestMetadata.application, requestMetadata.workflow saat kamu butuh menyusun leaderboard konsumsi token per fitur buat dibagikan ke product manager.
Tahap 3: Pasang Enforcement Budget Sebelum Saldo Terkuras
Punya data observabilitas rasanya percuma kalau sistem nggak bisa menghentikan pemborosan secara langsung. Berdasarkan panduan AWS, ada tiga tingkatan (tier) penegakan budget yang bisa dipilih sesuai kebutuhan:
| Tier | Mekanisme Kerja | Kelebihan | Kelemahan / Konsekuensi |
|---|---|---|---|
| Tier 1: Monitor & Alert | AWS Budgets + alert metrik CloudWatch | Sangat gampang, tanpa deploy server, latensi nol | Nggak ada proteksi hard block; respons telat setelah kejadian |
| Tier 2: Asynchronous Enforcement | Lambda agregator + DynamoDB + IAM deny policy | Proteksi langsung di level AWS IAM, tanpa proxy pihak ketiga | Ada jeda pemblokiran beberapa detik hingga hitungan menit |
| Tier 3: Synchronous Gateway | Proxy gateway di depan Bedrock (HTTP 429) | Blokir real-time sub-detik, kuota per user/tim sangat presisi | Butuh kelola server proxy tambahan di jalur lalu lintas data |
Untuk tim yang mengelola armada Claude Code dan Claude Desktop di lingkungan internal, kamu bisa memanfaatkan Claude apps gateway for AWS. Gateway resmi ini berjalan sebagai kontainer stateless berbasis PostgreSQL yang sudah terintegrasi dengan OIDC, OpenTelemetry, aturan multi-region Bedrock, dan pembatasan biaya per pengguna secara instan. Buat arsitektur multi-model mandiri, arsitektur referensi LiteLLM di atas AWS Fargate juga bisa menjadi alternatif.
Tahap 4: Optimasi Default Platform (Routing Cerdas & Prompt Caching)
Sebagian besar pemborosan token di cloud bukan karena kelalaian individu programmer, melainkan setelan bawaan platform yang dibiarkan tanpa aturan. Dua tuas penghematan terbesar berada di tangan tim platform engineering:
1. Intelligent Model Routing
Nggak semua tugas coding atau analisis butuh model paling pintar dan mahal. Tugas receh seperti formatting kode, linting, atau penulisan boilerplate bisa dialihkan ke model yang lebih hemat. Lewat evaluasi kualitas berkala, alihkan beban kerja rutin ke model yang lebih terjangkau. Menargetkan lebih dari 50% panggilan API jatuh ke model hemat adalah target yang sangat realistis buat lingkungan developer.
2. Prompt Caching
Fitur prompt caching memberikan diskon besar buat prompt panjang yang dipakai berulang kali. Berdasarkan skema tarif resmi Bedrock untuk model Anthropic Claude di region US East (N. Virginia) per Oktober 2026, biaya cache write dikenakan 1,25x lipat dari tarif input standar untuk TTL 5 menit (atau 2x lipat untuk TTL 1 jam). Namun, pembacaan cache (cache read) cuma dikenakan tarif 0,1x (diskon 90%) di Claude Sonnet 4.6 dan Claude Haiku 4.5, bahkan cuma 0,05x (diskon 95%) di Claude Sonnet 5.5 dan Claude Opus 5.5!
Dengan TTL 5 menit, satu kali pemanggilan ulang saja sudah menutup biaya penulisan cache. Kalau prompt yang sama dipanggil sepuluh kali berturut-turut, biaya inputnya anjlok hingga sekitar seperlima dari harga normal (sekitar 22% untuk pengali 0,1x, dan 17% untuk pengali 0,05x).
Kamu bisa melacak workflow mana yang layak dipasangi caching lewat query CloudWatch Logs Insights berikut:
fields requestMetadata.workflow as workflow, modelId,
input.inputTokenCount as inTokens
| stats count(*) as calls,
avg(inTokens) as avgInputTokens,
sum(inTokens) as totalInputTokens
by workflow, modelId
| filter calls > 50 and avgInputTokens > 2000
| sort totalInputTokens desc
| limit 25Berikut contoh penyusunan prompt terstruktur yang ramah cache untuk alur kerja operasional tim kamu:
[SYSTEM CONTEXT - STATIC CACHED PREFIX]Kamu adalah asisten analis biaya cloud FinOps internal perusahaan. Tugasmu adalah memeriksa metrik pemakaian token LLM, mendeteksi lonjakan anomali, dan menyusun rekomendasi mitigasi teknis berdasarkan aturan operasional platform. Aturan Evaluasi:1. Model hemat harus melayani minimal 50% panggilan API rutin.2. Rasio cache hit harus berada di atas 60% untuk alur kerja repetitif.3. Laporkan unit ekonomi berbasis biaya per hasil sukses, bukan sekadar biaya per panggilan API. [USER QUERY - DYNAMIC DATA]Analisis data log penggunaan berikut dan berikan rekomendasi aksi:{{data_log_pemakaian}}
Tahap 5: Jalankan Review Cadence & Pantau Scorecard Biaya
Data melimpah nggak ada artinya kalau nggak diubah menjadi keputusan bisnis. FinOps dan platform engineering perlu duduk bersama meninjau performa biaya secara berkala (seminggu sekali untuk tim skala besar, atau dua minggu sekali untuk skala menengah).
Gunakan acuan kartu skor (scorecard) kesehatan biaya berikut sebagai titik awal evaluasi:
| Dimensi Evaluasi | Metrik Utama | Kategori Aman (Hijau) | Perlu Waspada (Kuning) | Bahaya (Merah) |
|---|---|---|---|---|
| Unit Economics | Biaya per hasil kerja sukses (outcome) | ≤ target budget | 1x – 1,5x budget | > 1,5x budget |
| Biaya per Dev | Pengeluaran harian per software engineer | < $100 | $100 – $300 | > $300 |
| Model Routing | Porsi panggilan ke model efisien | > 50% | 30% – 50% | < 30% |
| Cache Efficiency | Rasio hit pembacaan cache | > 60% | 30% – 60% | < 30% |
Kalau metrik kamu mulai masuk zona kuning atau merah, perbaikannya dilakukan lewat pembaruan kebijakan platform (memperketat routing rules, membatasi limit token, mewajibkan metadata), bukan sekadar mengirim email teguran meminta tim developer berhemat.
Alternatif Kelola Biaya AI Tanpa Ribet Kartu Kredit Luar Negeri
Membangun arsitektur enterprise di AWS Bedrock memang sangat tangguh buat korporasi besar, tapi setup infrastruktur IAM, CUR 2.0, dan gateway kontainer mandiri butuh alokasi waktu engineering yang nggak sedikit. Kalau tim kamu ingin langsung mengeksplorasi model frontier kelas dunia tanpa keribetan konfigurasi cloud yang kompleks, kamu bisa mencoba alternatif gateway terpadu lewat Classai Router.
Lewat Classai Router, kamu cukup memakai satu API key yang kompatibel langsung dengan SDK Anthropic maupun OpenAI. Kamu bisa memanggil model canggih seperti Claude Sonnet 5.5 (Rp3.600 / Rp18.000 per 1 juta token input/output), model hemat seperti Claude Haiku 4.5 (Rp900 / Rp4.500), atau model penalaran ekonomis seperti DeepSeek V4.1 Flash (Rp1.155 / Rp4.200).
Semua request tercatat rapi metrik latensi dan konsumsi tokennya di dashboard tanpa perlu repot membangun pipeline data sendiri. Pembayarannya pun sangat ramah buat ekosistem Indonesia: top up saldo mulai Rp10.000 memakai QRIS atau transfer virtual account bank lokal tanpa pusing memikirkan kartu kredit valas korporat. Buat kamu yang ingin mendalami integrasi teknisnya di aplikasi backend, simak panduan praktisnya di kelas Tutorial Router Coding atau pelajari implementasi AI untuk tim engineering di kelas AI untuk Developer.
Sumber & referensi
- 01
AWS · 31 Oktober 2026
Managing Amazon Bedrock costs end to end: A playbook for FinOps and platform teams
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu FinOps AI dalam pengelolaan Amazon Bedrock?
FinOps AI adalah disiplin operasional dan arsitektur untuk mengontrol biaya AI generatif. Tujuannya memastikan setiap pengeluaran token memiliki pemilik yang jelas, termonitor secara real-time, dan dibatasi sebelum melebihi anggaran.
Bagaimana cara memisahkan biaya per user di gateway Bedrock bersama?
Gunakan session tags pada operasi STS AssumeRole. Gateway memanggil role Bedrock per user dengan menyematkan identitas di RoleSessionName serta atribut tim pada tags, lalu mencache kredensialnya hingga 1 jam.
Berapa besar penghematan prompt caching di Amazon Bedrock?
Fitur prompt caching Claude di Bedrock memberikan diskon pembacaan cache hingga 90% pada Claude Sonnet 4.6 dan Haiku 4.5, serta diskon hingga 95% pada Claude Sonnet 5.5 dan Opus 5.5 dibanding tarif input standar.
Apa beda enforcement Tier 1, Tier 2, dan Tier 3 di Bedrock?
Tier 1 hanya memantau dan mengirim notifikasi via AWS Budgets. Tier 2 memblokir akses secara asinkron via IAM Deny Policy, sedangkan Tier 3 menggunakan proxy gateway untuk memblokir panggilan secara real-time (HTTP 429).
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.