Phonon TTS Rilis: Model Suara Ringan Kencang Bebas Internet
Phonon TTS bikin gebrakan di dunia speech AI: ukurannya cuma 65 MB, jalan langsung di perangkat tanpa kuota internet, dan punya latensi awal cuma 28 milidetik.
· 8 menit baca
Inti singkat
- Phonon TTS adalah model text-to-speech on-device berukuran 65 MB dan 75 MB yang berjalan tanpa server.
- Model Phonon 31m dirilis dengan lisensi open source Apache 2.0 sehingga bebas dipakai untuk kebutuhan komersial.
- Di benchmark Hugging Face, Phonon memimpin kecepatan CPU streaming dengan time-to-first audio cuma 28 milidetik.
- Dukungan backend sangat luas lewat framework ptts dan integrasi bawaan di pustaka Transformers v5.21.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
Phonon TTS resmi meluncur sebagai model pengubah teks ke suara yang berjalan langsung di perangkat tanpa butuh server maupun koneksi internet sama sekali. Model rilisan tim Gradium ini langsung mencuri perhatian komunitas pengembang karena ukurannya yang super mungil—cuma sekitar 65 MB dan 75 MB—namun berhasil merajai peringkat pengujian terbuka di Hugging Face.
Sebagian besar teknologi suara berbasis kecerdasan buatan yang kita pakai saat ini mengandalkan pemrosesan di cloud. Setiap kali kamu mengetik kalimat, teks harus dikirim bolak-balik ke server jauh, yang memakan waktu dan berisiko bikin data privasimu bocor ke pihak ketiga. Nah, seperti diungkapkan dalam artikel resmi Hugging Face, Phonon mendobrak kebiasaan ini dengan memindahkan seluruh proses sintesis suara ke mesin lokal milikmu sendiri.
Dalam dua minggu pertamanya saja, model ini sudah diunduh lebih dari 200.000 kali dan langsung nangkring di daftar tren Hugging Face Hub. Buat developer yang sedang membangun aplikasi interaktif, asisten suara, maupun game, terobosan ini membuka peluang baru yang menarik banget buat diulik.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu Phonon TTS dan Kenapa Bikin Heboh?
Phonon TTS adalah model text-to-speech (TTS) berukuran mini yang dirancang spesifik untuk komputasi di sisi pengguna (on-device). Model ini merupakan penerus dari lini Pocket TTS dan memanfaatkan teknik pemodelan bernama flow matching buat menghasilkan gelombang audio. Pendekatan ini beda banget dibanding teknik pemodelan autoregresif audio tradisional yang biasanya makan memori gede.
Bikin model suara berkualitas tinggi di perangkat kecil selama ini selalu jadi mimpi buruk buat para engineer. Kalau ukurannya dikecilkan biar muat di memori ponsel, kualitas suaranya biasanya kaku kayak robot jadul. Sebaliknya, kalau suaranya dibuat natural dan empuk, ukuran bobot modelnya bisa bengkak sampai ratusan megabyte bahkan gigabyte.
Tim pengembangnya pertama kali mengumumkan konsep Phonon pada April dan menghabiskan waktu enam bulan berikutnya untuk memoles model ini bareng para mitra dan pengguna awal. Proses latihannya sempat mengalami kendala ketidakstabilan numerik sebelum akhirnya mereka menemukan serangkaian trik teknis buat menghasilkan suara yang jernih dan stabil di berbagai bahasa.
Kerennya lagi, Phonon nggak gampang bingung saat membaca format teks rumit. Hal-hal yang sering bikin model TTS lain tersandung—seperti deretan nomor telepon, penanggalan, singkatan, sampai baris kode pemrograman—bisa dilafalkan dengan mulus.
Performa di Hugging Face Open TTS Leaderboard
Bukan cuma klaim sepihak di atas kertas, kehebatan Phonon langsung diuji di Open TTS Leaderboard milik Hugging Face. Papan peringkat yang mengevaluasi lebih dari 9.000 model TTS ini menguji performa model berdasarkan kejelasan pengucapan (word error rate atau WER), kecepatan respons, serta tingkat kealamian suara (lewat metrik UTMOS dan KOMOS).
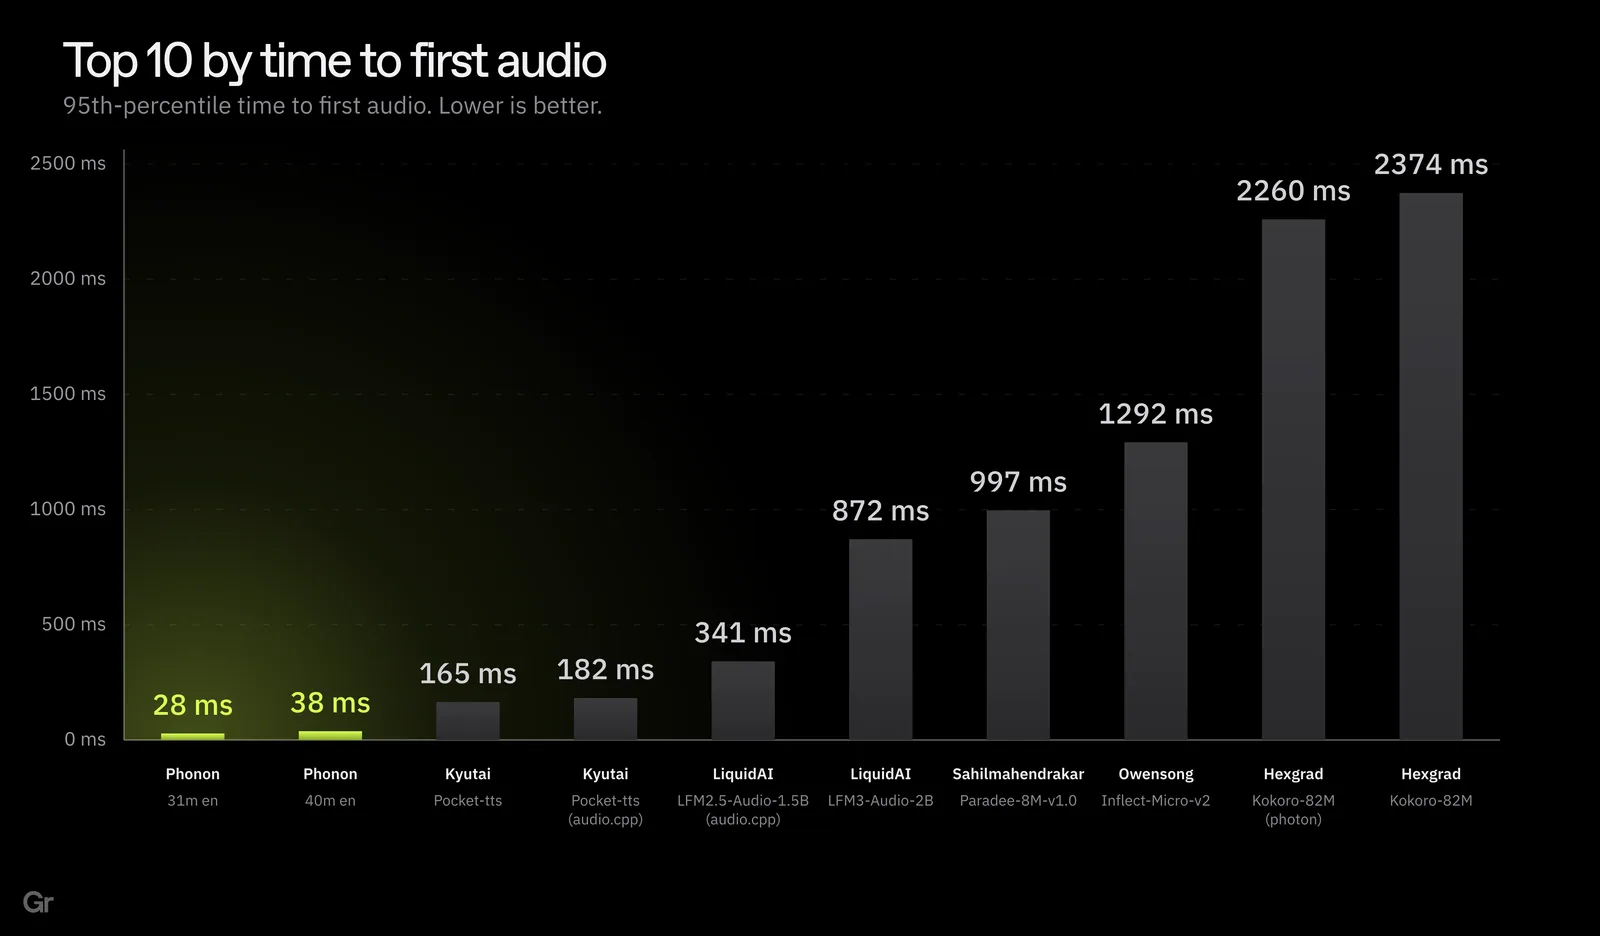
Hasilnya bikin kaget banyak pihak. Pada metrik kejelasan kata (intelligibility), Phonon sukses merebut posisi pertama untuk bahasa Jerman dan Spanyol. Bahkan untuk semua bahasa yang diuji, model mungil ini konsisten masuk tiga besar dunia, bersaing ketat melawan model-model raksasa lain yang ukurannya sampai 100 kali lebih gede.
Di sektor kecepatan, keunggulannya makin telak. Pada pengujian streaming di prosesor (CPU), Phonon memimpin peringkat pengujian untuk metrik waktu tunggu sampai audio pertama keluar (time-to-first audio atau TTFA):
| Model TTS | Latensi TTFA (Persentil ke-95) | Lisensi |
|---|---|---|
| Phonon 31m en | 28 ms | Apache 2.0 |
| Phonon 40m en | 38 ms | CC BY-NC |
| Pocket TTS | 165 ms | - |
Angka 28 milidetik ini luar biasa cepat. Begitu sistem menerima input teks, suaranya sudah mulai terdengar hampir seketika di telinga pengguna, bikin jeda percakapan terasa sangat alami seperti ngobrol langsung.
Ukuran Model, Lisensi, dan Dukungan Bahasa
Phonon hadir dalam dua varian utama yang bisa kamu pilih sesuai kebutuhan proyekmu. Masing-masing varian punya spesifikasi dan aturan pemakaian yang jelas:
- Phonon 31m: Varian ini berukuran sekitar 65 MB dengan jumlah parameter sekitar 30,7 juta untuk model utama dan 10,3 juta untuk audio tokenizer. Model ini fokus berbicara dalam bahasa Inggris dan dirilis penuh memakai lisensi open source Apache 2.0. Artinya, kamu bebas memakainya untuk proyek pribadi maupun produk komersial tanpa bayar royalti.
- Phonon 40m: Varian dengan ukuran sekitar 75 MB ini mendukung lima bahasa sekaligus: Inggris, Prancis, Jerman, Spanyol, dan Portugis. Lisensinya memakai CC BY-NC, yang artinya gratis untuk riset dan proyek non-komersial. Buat penggunaan komersial, skema biayanya dihitung berdasarkan jumlah pengguna aktif, bukan berdasarkan durasi audio yang kamu hasilkan.
Selain itu, Phonon sudah dibekali lebih dari 100 pilihan karakter suara bawaan. Kalau kamu butuh suara unik, kamu bisa merancang karakter suara baru lewat deskripsi teks atau melakukan kloning suara dari rekaman pendek (dengan persetujuan pemilik suara) melalui Gradium Studio.
Proyek Nyata: Dari Smartwatch Sampai Game Offline
Keunggulan model on-device langsung terbukti lewat beragam contoh proyek yang dipamerkan saat peluncuran. Karena nggak butuh internet dan hemat daya, Phonon bisa ditanam ke berbagai perangkat mungil:
- Apple Watch Tanpa Wi-Fi: Phonon berhasil dijalankan langsung di jam tangan pintar dengan koneksi internet mati total, bertugas memandu pengguna menyeduh kopi langkah demi langkah.
- Penghitung Repetisi di iPhone: Berjalan mulus di ponsel dalam kondisi mode pesawat tanpa sinyal, menyemangati dan menghitung repetisi olahraga pengguna di tempat gym.
- Robot Karakter Lamp: Robot meja bernama Lamp dari Autonomous dipasangi topi seleksi dan berbicara dengan karakter suara unik secara mandiri.
- Game Dinosaurus di Peramban: Mengubah game dino offline di browser jadi acara siaran radio interaktif yang dipandu oleh karakter bernama Rex.
- Game Fiksi Ilmiah: Mengisi suara dialog karakter game secara dinamis langsung di komputer milik pemain tanpa menguras sumber daya grafis utama.
Komunitas developer juga langsung tancap gas bikin porting lanjutan. Ada konversi ExecuTorch yang bikin Phonon bisa jalan di GPU pengunjung lewat web browser, pustaka Micdrop untuk integrasi ke aplikasi Node.js, hingga implementasi ruang interaktif di Hugging Face Spaces.
Arsitektur Teknis dan Mesin Inferensi ptts
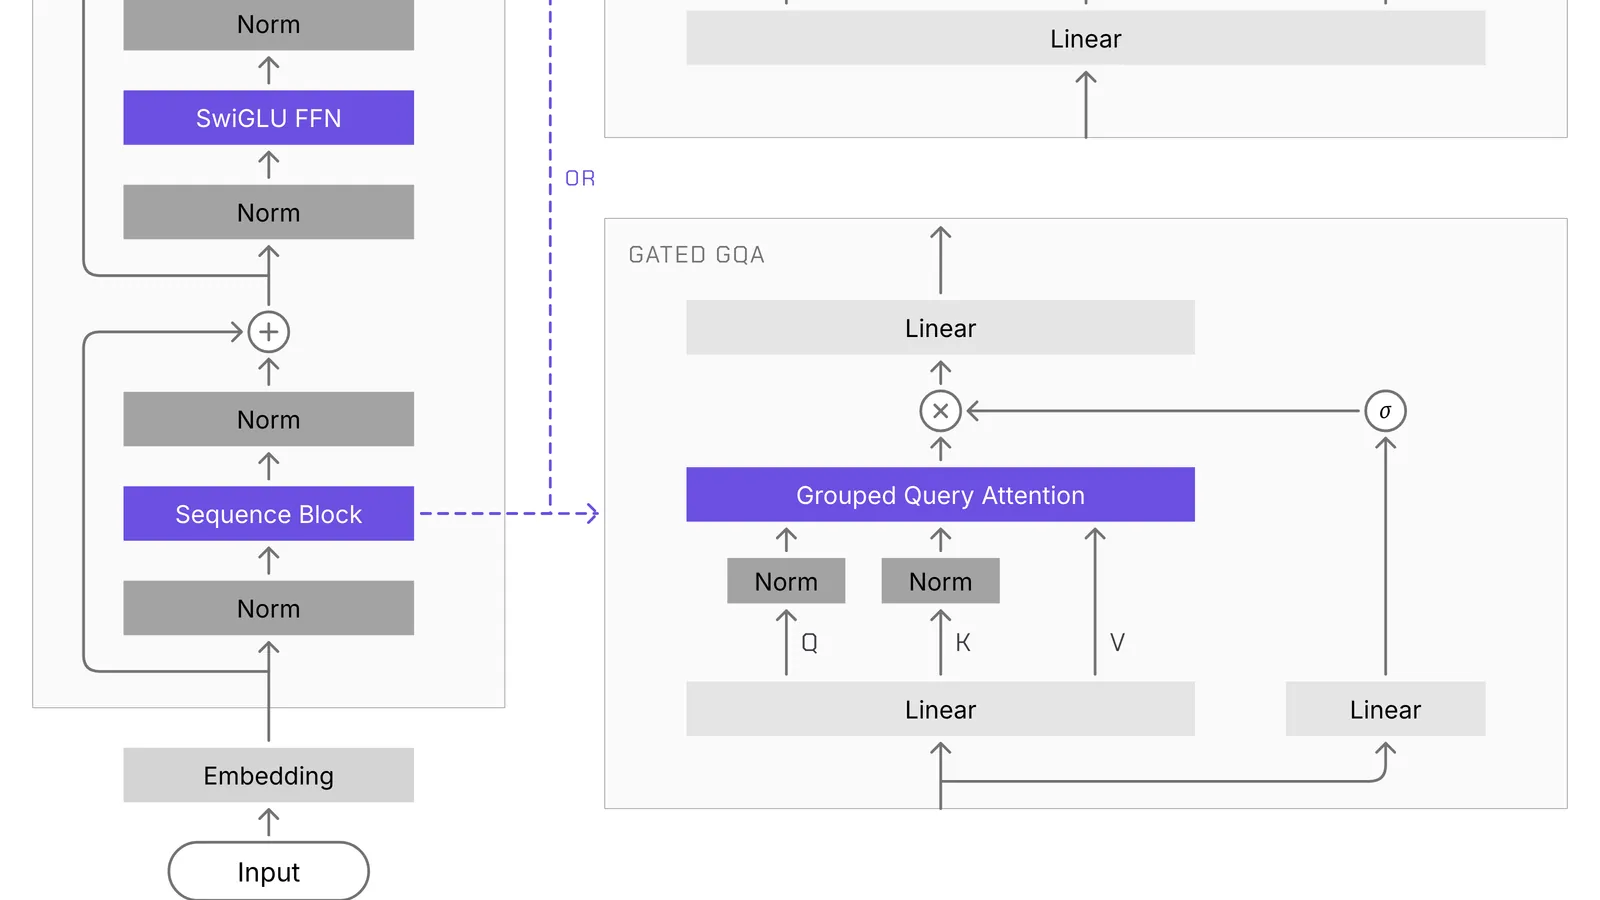
Di balik ukurannya yang ramping, Phonon membawa arsitektur yang cukup unik. Model ini menghasilkan representasi laten audio secara autoregresif. Setiap langkah menghasilkan satu nilai laten yang diumpankan kembali sebagai input berikutnya. Tokenizer audio di sini bertindak seperti tokenizer teks pada model bahasa (LLM), memetakan audio ke bentuk laten secara decoder-only.
Karakter suara di Phonon bukan berupa rekaman audio mentah berukuran besar, melainkan kumpulan tensor laten pembicara yang sudah dipra-komputasi (gradium/phonon-voices). Formatnya disimpan rapi dalam berkas .safetensors sehingga sangat cepat dimuat ke dalam memori.
Untuk urusan inferensi di berbagai perangkat keras, tim pengembang merilis framework baru bernama ptts di GitHub. Mesin inferensi ini mendukung lebih dari 10 backend sekaligus:
- CPU: Intel, Arm, dan WebAssembly (Wasm).
- GPU: NVIDIA CUDA, Vulkan, Apple Metal, dan WebGPU.
- NPU: Apple Core ML dan Qualcomm Snapdragon.
Selain ptts yang dioptimalkan buat single-stream di perangkat lokal, Phonon juga sudah terintegrasi secara resmi ke pustaka 🤗 Transformers mulai dari versi v5.21. Integrasi Transformers ini menggunakan implementasi native PyTorch dengan dukungan torch.compile dan pemrosesan batch, sangat pas kalau kamu butuh bikin dataset audio sintetis skala besar di server GPU.
Cara Mencoba Phonon TTS Pakai Python dan Transformers
Buat kamu yang terbiasa ngoding dengan ekosistem Hugging Face, memanggil Phonon TTS sangat simpel karena kodenya dirancang modular dengan penambahan sekitar 200 baris kode di atas fondasi Pocket TTS.
Berikut langkah-langkah dasar buat menjalankan Phonon 31m langsung di lingkungan Python komputermu:
1. Pasang Pustaka yang Dibutuhkan
Pastikan lingkungan kerjamu sudah menggunakan Transformers versi v5.21 atau yang lebih baru beserta pustaka pendukung Hugging Face Hub.
2. Muat Model dan Karakter Suara
Kamu bisa mengunduh bobot model dan berkas karakter suara .safetensors secara terpisah dengan skrip sederhana:
from transformers import AutoProcessor, GradiumPhononTTSForConditionalGeneration
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

# Muat model dan processor
model_id = "gradium/phonon-31m-en"
processor = AutoProcessor.from_pretrained(model_id, device_map="auto")
model = GradiumPhononTTSForConditionalGeneration.from_pretrained(model_id, device_map="auto")

# Unduh dan muat profil suara
voice_path = hf_hub_download("gradium/phonon-voices", "voices/LMDIYE0Oa377Qh6Z.safetensors")
voice = load_file(voice_path)["speaker_wavs"][0].T
3. Buat Input Percakapan dan Sintesis Suara
Phonon memakai struktur template obrolan (chat template) mirip model multimodal modern. Tempatkan wadah audio kosong di pesan pengguna, lalu proses teksnya:
# Siapkan percakapan teks
conversation = [
    {"role": "user", "content": [{"type": "audio"}, {"type": "text", "text": "Hello from Phonon. This is running locally!"}]}
]

# Siapkan tensor input
inputs = processor.apply_chat_template(
    conversation,
    tokenize=True,
    return_dict=True,
    add_generation_prompt=True,
    processor_kwargs={"audio_prompt_latents": [voice]},
).to(model.device)

# Hasilkan audio laten lalu decode jadi file suara
outputs = model.generate(**inputs)
audio = processor.decode(outputs.audio_latents, outputs.audio_latents_mask)
processor.save_audio(audio, "output_phonon.wav")Kalau kamu sedang merancang arsitektur aplikasi AI yang butuh agen pintar buat menghasilkan teks sebelum dibacakan oleh Phonon di sisi klien, kamu bisa mengombinasikannya dengan model penalaran canggih. Lewat Classai Router, kamu bisa memanggil model frontier seperti claude-sonnet-5.5 (Rp3.600 / Rp18.000 per 1 juta token) atau gpt-4o (Rp525 / Rp2.700 per 1 juta token) untuk menyusun naskah jawaban cerdas secara terpusat lewat satu API key, lalu lempar teks hasilnya ke Phonon di gadget pengguna buat disuarakan seketika.
Dampak Nyata Buat Developer dan Bisnis di Indonesia
Kehadiran model on-device sekencang Phonon memberikan dampak praktis yang cukup besar bagi lanskap teknologi di Indonesia, terutama di tiga area krusial:
- Kepatuhan Privasi Data: Dengan berlakunya regulasi perlindungan data pribadi (UU PDP), memproses data teks sensitif di perangkat pengguna jauh lebih aman dibanding mengirimkannya ke server luar negeri. Informasi pribadi seperti nomor rekening, alamat, atau rekaman medis sama sekali nggak pernah meninggalkan perangkat pengguna.
- Solusi Daerah Minim Sinyal: Wilayah Indonesia yang kepulauan sering kali menghadapi kendala koneksi internet yang nggak stabil. Aplikasi edukasi, panduan lapangan pertanian, atau asisten kesehatan kini bisa bersuara lancar di pelosok tanpa perlu takut buffering sinyal.
- Pangkas Biaya Infrastruktur: Memakai API suara komersial berbasis cloud biasanya membebankan biaya per karakter atau per menit audio yang bikin tagihan bengkak saat pengguna makin banyak. Dengan Phonon 31m, beban komputasi dipindahkan ke perangkat konsumen, bikin biaya sewa server backend kamu jadi nol rupiah untuk urusan voice synthesis.
Buat para pengembang aplikasi lokal yang mau mendalami cara integrasi model suara dan sistem AI modern ke dalam workflow kerja, kamu juga bisa melirik materi pembelajaran terstruktur di Kelas AI Developer untuk menguasai implementasi kecerdasan buatan dari hulu ke hilir.
Sumber & referensi
- 01
Hugging Face · 5 November 2026
A Closer Look at Phonon TTS. Launching High-Quality On-Device Speech That Tops the Benchmarks.
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apakah Phonon TTS bisa dijalankan tanpa koneksi internet?
Bisa banget. Phonon TTS dirancang khusus untuk berjalan langsung di perangkat lokal (on-device), sehingga proses sintesis suara dari teks bisa berfungsi normal meski perangkat dalam mode pesawat tanpa koneksi internet.
Apakah Phonon TTS gratis untuk keperluan komersial?
Varian Phonon 31m bahasa Inggris berlisensi Apache 2.0 dan sepenuhnya gratis untuk produk komersial. Sementara itu, varian Phonon 40m yang multibahasa memakai lisensi CC BY-NC khusus non-komersial dan butuh skema lisensi terpisah jika ingin dikomersialkan.
Berapa kapasitas memori yang dibutuhkan untuk menjalankan Phonon TTS?
Bobot model Phonon TTS sangat kecil, yaitu cuma sekitar 65 MB untuk varian 31m dan sekitar 75 MB untuk varian 40m, sehingga bisa berjalan lancar di ponsel pintar, laptop tipis, hingga modul single-board computer.
Bahasa apa saja yang didukung oleh Phonon TTS saat ini?
Saat peluncuran perdananya, Phonon TTS mendukung lima bahasa dunia, yaitu bahasa Inggris, Prancis, Jerman, Spanyol, dan Portugis, dengan opsi pelatihan bahasa tambahan bersama mitra desain.
Apa keunggulan Phonon TTS dibanding model TTS cloud biasa?
Keunggulan utamanya ada pada perlindungan privasi data karena teks tidak dikirim ke server luar, waktu respons super kilat dengan latensi awal hanya 28 milidetik, serta tidak adanya biaya tagihan server per pemakaian audio.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.