LFM3 Multimodal Hugging Face Rilis: Model 2B Kencang Buat Edge
Liquid AI meluncurkan LFM3 di Hugging Face. Seluruh keluarga model teks, audio, video, dan decision berbasis backbone 1,7B ini bisa jalan enteng di laptop dan single GPU.
· 10 menit baca
Inti singkat
- Liquid AI resmi merilis keluarga LFM3 di Hugging Face dengan satu backbone dasar LFM3-1.7B-Base.
- Keluarga model mencakup teks, visi video, audio real-time, omni, hingga model d1 khusus pengambilan keputusan terkalibrasi.
- Model teks hanya makan memori sekitar 1 GB pada kuantisasi 4-bit dan punya context window 256K token.
- Semua varian model LFM3 bisa di-fine-tune menggunakan single GPU untuk kebutuhan spesifik perusahaan.
- Varian LFM3-VL-2B terbukti mampu mengendalikan sistem robotik dengan latensi aksi di bawah 50 milidetik.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Liquid AI resmi merilis keluarga model LFM3 multimodal di Hugging Face yang memadukan teks, visi, audio, dan pengambilan keputusan ke dalam satu backbone ringkas kelas 2B. Peluncuran ini memungkinkan developer menjalankan model multimodal canggih langsung di laptop, perangkat edge, atau single GPU tanpa harus bergantung pada server cloud raksasa.
Kabar peluncuran ini diumumkan langsung lewat blog resmi Liquid AI di Hugging Face. Tim Liquid AI memperkenalkan Liquid Foundation Models generasi ketiga (LFM3) sebagai fondasi kecerdasan terspesialisasi. Alih-alih merilis satu model monster serba bisa yang boros komputasi, LFM3 menawarkan enam varian model yang semuanya berakar dari satu backbone 1,7 miliar parameter yang sama. Buat kamu yang sering pusing mikirin biaya server atau latensi API, kehadiran LFM3 ini bakal jadi angin segar.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu LFM3 Multimodal Hugging Face dan Kenapa Bikin Heboh?
Keluarga model LFM3 hadir untuk menjawab masalah klasik model AI saat ini: ukurannya yang kelewat raksasa bikin deploy di perangkat lokal atau edge terasa mustahil. Lewat LFM3, Liquid AI membuktikan bahwa model berukuran ringkas di kisaran 2 miliar parameter (2B) bisa punya performa setara bahkan melampaui model berukuran jauh lebih besar.
Dibandingkan generasi sebelumnya yaitu LFM2, LFM3 membawa empat perubahan besar:
- Kemampuan per parameter lebih tinggi: Arsitektur tri-hybrid baru dan resep training teranyar bikin LFM3-1.7B mampu mengalahkan performa LFM2.5-2.6B meski parameternya 35% lebih sedikit.
- Semua modalitas dalam satu backbone: Ada enam varian model kelas 2B (teks, visi, audio, omni, dan decision) yang dilatih dari LFM3-1.7B-Base, termasuk model omni perdana dan input video untuk model visi.
- Didesain khusus buat edge: Model teksnya muat di RAM sekitar 1 GB pada kuantisasi 4-bit, encoder visi dan audio baru bekerja super kencang, plus context window 256K token bikin agent AI lokal bisa jalan mulus.
- Mudah dispesialisasi: Setiap varian model dirancang agar bisa di-fine-tune hanya dengan satu GPU, jadi kamu gampang menyesuaikannya dengan data, istilah internal, dan lingkungan kerja tim kamu.
Membedah Arsitektur LFM3: Rahasia Tri-Hybrid yang Bikin Irit Memori
Salah satu keunggulan utama Liquid AI terletak pada pendekatan arsitekturnya yang tidak murni mengandalkan Transformer standar. Pada LFM2, mereka memadukan konvolusi pendek dan attention agar bisa jalan cepat di perangkat edge tanpa mengorbankan kualitas. Untuk LFM3, mereka melakukan pencarian arsitektur hardware-in-the-loop yang mencakup 14 kombinasi perangkat dan backend, mulai dari smartphone, Raspberry Pi 5, laptop, CPU cloud, GPU, hingga Qualcomm Hexagon NPU.
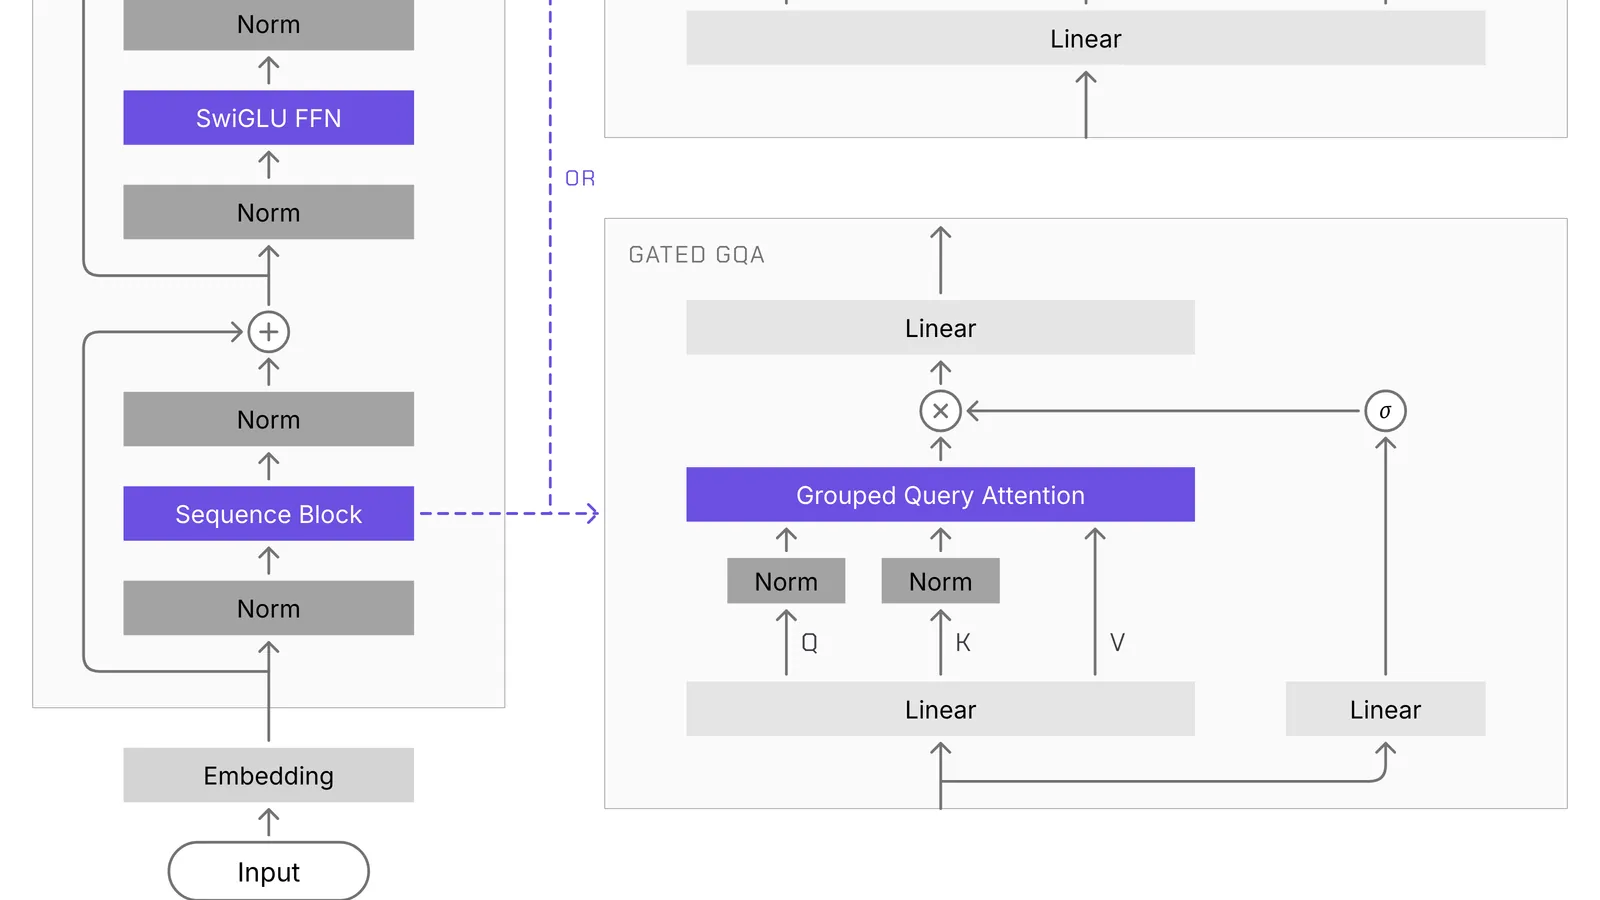
Backbone utama LFM3-1.7B-Base memiliki 24 layer dengan empat racikan teknis utama:
- Tri-hybrid layer mix: Terdiri dari 13 layer konvolusi pendek bergurat (gated short convolutions) dengan ukuran kernel 7 (naik dari kernel 3 di LFM2), 5 layer sliding-window attention (SWA) dengan jendela 256 token, dan 6 layer global attention.
- Head-wise gated attention: Gerbang sigmoid mengatur skala output tiap attention head. Kalau sebuah head tidak punya informasi penting buat ditambah, head tersebut bakal mati otomatis. Mekanisme ini ampuh meredam activation outliers yang selama ini sering merusak proses kuantisasi model kecil.
- Partial RoPE: Layer global attention hanya memutar separuh frekuensi tertinggi pada tiap head, sehingga separuh sisanya bisa mencocokkan konten tanpa terpengaruh jarak posisi token. Sementara itu, layer SWA tetap memakai RoPE penuh.
- Sandwich norm: Setiap blok menormalisasi input sekaligus outputnya untuk menjaga aktivasi bobot tetap stabil.
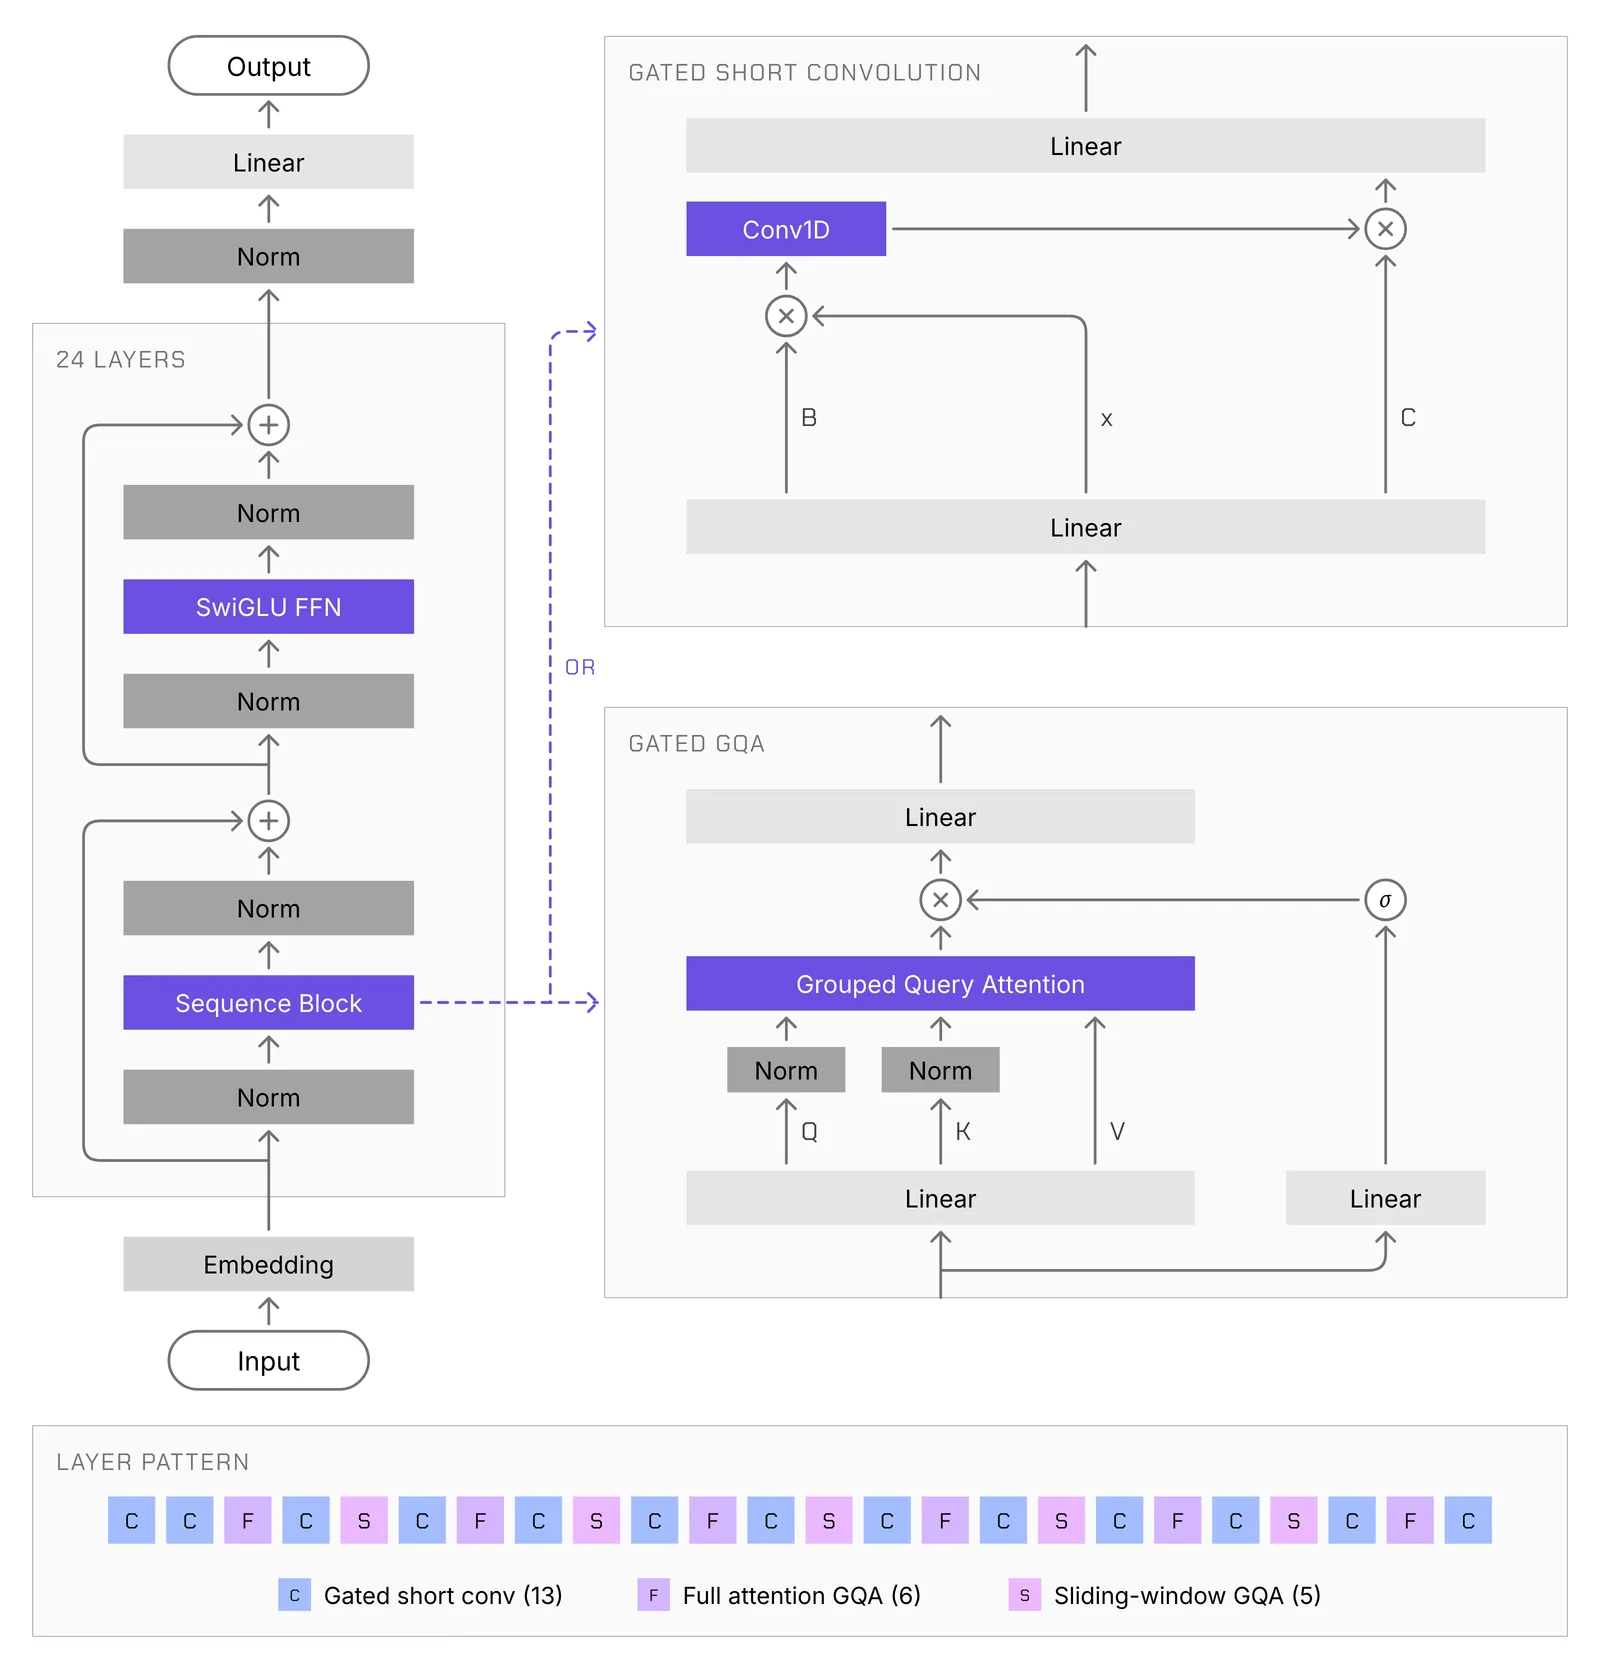
Racikan tri-hybrid ini terbukti sangat ampuh saat menangani konteks panjang. Untuk prompt pendek di perangkat edge, LFM3-1.7B menyamai kecepatan LFM2-1.2B. Namun begitu masuk ke konteks 8K token, LFM3 tercatat sekitar 25% lebih kencang. Model dasarnya dilatih pada 22 triliun (T) token dengan vocabulary 128K, di mana 3,5T token terakhir difokuskan pada data agentic traces dan tool calls yang memperpanjang context window hingga 256K token.
Satu Backbone untuk Enam Model: Dari Teks, Video, sampai Keputusan Cepat
Strategi Liquid AI di LFM3 adalah memecah model sesuai modalitas input dan output yang kamu butuhkan. Kamu nggak perlu memuat model raksasa serba ada kalau cuma butuh transkripsi audio atau membaca invoice. Semua varian dibangun di atas LFM3-1.7B-Base dengan encoder khusus bikinan internal.
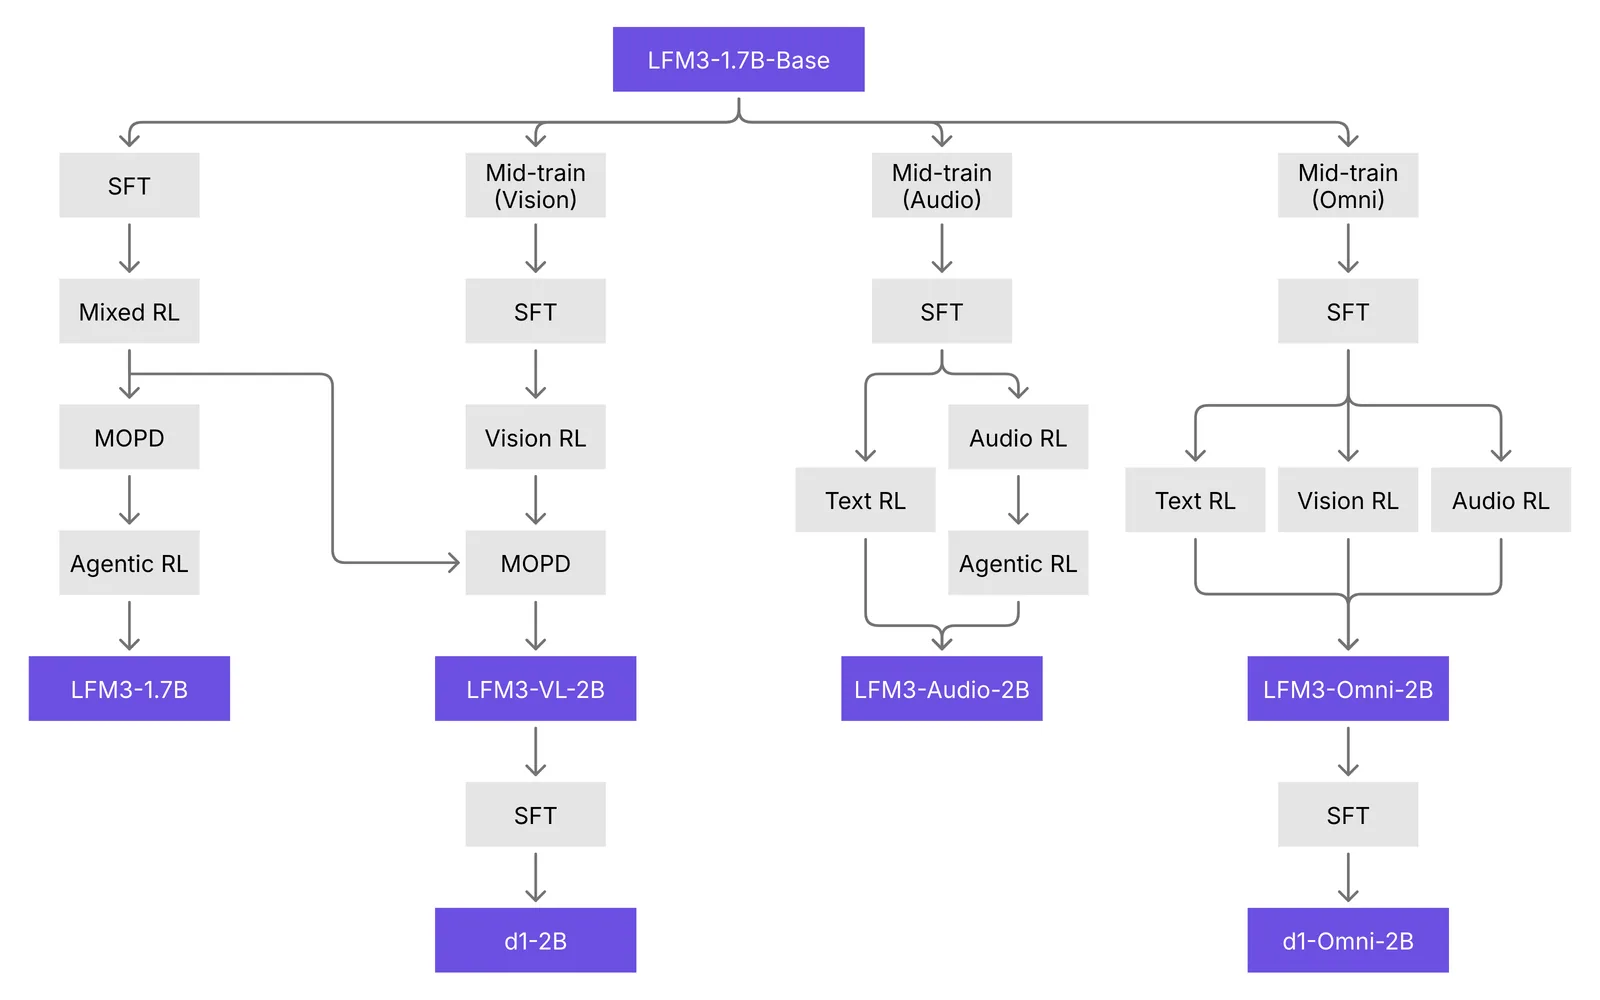
Berikut ringkasan enam model LFM3 yang dirilis secara terbuka di Hugging Face:
| Model | Input | Output | Fondasi Pembangun |
|---|---|---|---|
| LFM3-1.7B | Teks | Teks | LFM3-1.7B-Base |
| LFM3-VL-2B | Teks, gambar, video | Teks | Backbone LFM3 + vision encoder |
| LFM3-Audio-2B | Teks, audio | Teks, ucapan suara | Backbone LFM3 + audio encoder, audio decoder, LiquidCodec |
| LFM3-Omni-2B | Teks, gambar, video, audio | Teks, ucapan suara | Backbone LFM3 + vision & audio encoder + audio decoder |
| d1-2B | Teks, gambar, video | Jawaban terkalibrasi | LFM3-VL-2B |
| d1-omni-2B | Teks, gambar, video, audio | Jawaban terkalibrasi | LFM3-Omni-2B |
Vision encoder bawaan LFM3 hanya berukuran 164 juta parameter dan menggabungkan konvolusi serta attention. Encoder ini butuh komputasi 3 kali lebih hemat dibanding SigLIP2 pada model sebelumnya, serta 2,2 kali lebih hemat FLOPs dibanding vision encoder Qwen3.5-2B dengan tingkat akurasi setara. Untuk video, encoder ini menggabungkan sepasang frame sampel menjadi satu slice temporal sehingga memotong panjang sekuens hingga separuhnya.
Di sektor audio, audio encoder LFM3 bersifat fully causal dengan latensi time-to-first-token serendah 50 milidetik saat pengguna berbicara. Tokenizer barunya, LiquidCodec, mampu mengubah token hasil generate menjadi ucapan suara 87 kali lebih cepat dari real-time pada satu thread CPU Apple M4 Max dan sudah mendukung streaming decoding.
Performa Benchmark: Skor Mentereng di WebArena dan Visi Komputer
Keunggulan ukuran kecil LFM3 bukan cuma teori di atas kertas. Di berbagai pengujian benchmark, efisiensi per parameternya terlihat sangat mencolok jika dibandingkan pendahulunya maupun model kompetitor yang ukurannya berlipat ganda.
Beberapa hasil benchmark utama yang dipublikasikan tim pengembang meliputi:
- Tugas Agentic: Pada benchmark WebArena-Verified, LFM3-1.7B mencetak skor 38,42, melesat jauh dari LFM2.5-2.6B yang hanya meraih skor 3,02. Skor ini bahkan mengalahkan model Qwen3.5-9B pada tugas navigasi browser dan aplikasi bisnis yang panjang.
- Visi Komputer: LFM3-VL-2B dengan parameter 1,9B mencetak rata-rata skor 71,4 di 62 benchmark visi (naik dari 57,6 pada LFM2.5-VL-3B). Hasil ini setara dengan Gemma 4 12B yang ukurannya enam kali lipat lebih besar.
- Kualitas Audio: LFM3-Audio-2B meraih skor UTMOSv2 sebesar 3,83, jauh meningkat dibanding 3,22 pada LFM2.5-Audio-1.5B.
- Audio-Visual Omni: LFM3-Omni-2B berhasil mengungguli model berukuran hingga 10,7B parameter seperti Qwen2.5-Omni-7B pada benchmark Daily-Omni, WorldSense, dan AV-SpeakerBench.
- Decision Suite: Model d1-2B menorehkan skor 75,5 pada ImajevBench, naik drastis dari pendahulunya d1-3B yang meraih 64,0 meskipun parameternya dipangkas sepertiga lebih sedikit.
Cara Nyobain LFM3 di Python Pakai Transformers
Semua model LFM3 sudah terintegrasi langsung dengan pustaka transformers dari Hugging Face. Kamu bisa langsung mengunduh bobotnya dan menjalankannya secara lokal. Pastikan kamu memperbarui pustaka terlebih dahulu.
1. Menjalankan Model Teks LFM3-1.7B
Untuk tugas tool calling, structured output, atau agent lokal, pasang versi transformers terbaru:
pip install -U transformersLalu jalankan pipeline sederhana berikut:
from transformers import pipeline

generator = pipeline(
    "text-generation",
    model="LiquidAI/LFM3-1.7B",
    trust_remote_code=True,
)

messages = [{"role": "user", "content": "Apa itu C. elegans?"}]
output = generator(
    messages,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.1,
    max_new_tokens=2048,
)
print(output[0]["generated_text"][-1]["content"])
2. Memproses Gambar dan Video dengan LFM3-VL-2B
Model visi ini butuh dependensi pemrosesan gambar dan transformers>=5.21.0:
pip install "transformers>=5.21.0" torch torchvision pillowContoh inferensi gambar lokal:
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "LiquidAI/LFM3-VL-2B"
model = AutoModelForImageTextToText.from_pretrained(
    model_id, dtype=torch.bfloat16, device_map="auto", trust_remote_code=True
)
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)

messages = [{
    "role": "user",
    "content": [
        {"type": "image", "url": "https://placecats.com/300/200"},
        {"type": "text", "text": "Deskripsikan gambar ini secara detail."},
    ],
}]

inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt"
).to(model.device)

with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        do_sample=True,
        temperature=0.1,
        top_k=50,
        repetition_penalty=1.1,
        max_new_tokens=16384,
    )

generated_ids = output_ids[:, inputs["input_ids"].shape[1] :]
print(processor.batch_decode(generated_ids, skip_special_tokens=True)[0])
3. Klasifikasi Cepat Tiket Layanan Pelanggan dengan d1-2B
Model d1-2B cocok untuk kamu yang butuh ekstraksi data terstruktur tanpa membuang waktu generate token kata per kata. Dalam satu forward pass, model bisa menjawab beberapa pertanyaan sekaligus lengkap dengan nilai probabilitasnya:
import torch
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.float32 if device == "cpu" else torch.bfloat16
model = AutoModel.from_pretrained("LiquidAI/d1-2B", trust_remote_code=True, dtype=dtype).to(device)

questions = {
    "refund": {"type": "noul", "instructions": "Apakah pelanggan meminta pengembalian dana?"},
    "team": {"type": "choice", "instructions": "Tim mana yang harus menangani tiket ini?",
             "criteria": {"billing": "Tagihan dan refund", "shipping": "Pengiriman paket", "technical": "Kendala aplikasi"}},
    "urgency": {"type": "score", "instructions": "Seberapa mendesak tiket ini?", "criteria": ["low", "medium", "high"]},
}

out = model.system_one("Saya ditagih dua kali dan paket saya belum sampai. Tolong refund salah satu tagihan.", questions)
print(out["answers"])Integrasi Agen AI dan Kemampuan Kontrol Robotik
Salah satu kelebihan LFM3-1.7B adalah kesiapannya untuk langsung dipasangkan ke berbagai kerangka kerja agen otonom. Model ini sudah dioptimalkan untuk berjalan di agent harness populer seperti Hermes Agent, Pi, dan OpenClaw. Kalau kamu tertarik mendalami bagaimana agen otonom bekerja di perangkat lokal, kamu bisa intip kelas Kenalan dengan OpenClaw & Hermes di Classai.
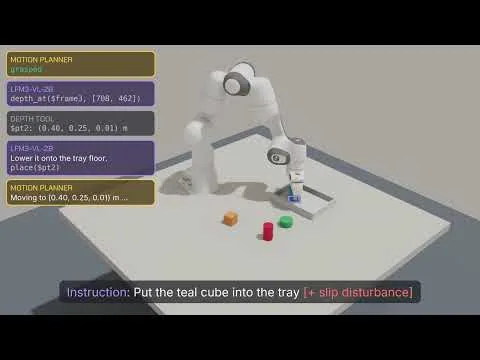
Bukan cuma agen software di browser, LFM3-VL-2B juga diuji langsung untuk kebutuhan sistem fisik dan robotik. Liquid AI mengadaptasi model visi ini menjadi tiga modul robotik:
- Orchestrator: Mengoperasikan lengan robot lewat tool calling, mendeteksi objek dengan bounding/pointing, mengukur dimensi objek dengan alat sensor kedalaman, dan memeriksa hasil kerja lewat kamera.
- Navigator: Menjalankan rute berdasarkan deskripsi teks dan input kamera RGB, lalu memprediksi target spasial serta koordinat waypoint hanya dalam lima token.
- VLA (Vision-Language-Action): Memetakan gambar, instruksi bahasa, dan status robot menjadi delapan langkah aksi fisik berkelanjutan dalam satu forward pass.
Saat dilatih bersama pada 15 platform fisik, model VLA berbasis LFM3-VL-2B ini meraih rata-rata keberhasilan 96,2% di empat suite LIBERO dan 45,7% pada tugas meja RoboCasa-GR1. Hebatnya lagi, aksi fisik tersebut dihasilkan dalam waktu di bawah 50 milidetik di hardware tertanam Nvidia Jetson AGX Orin menggunakan TensorRT FP16.
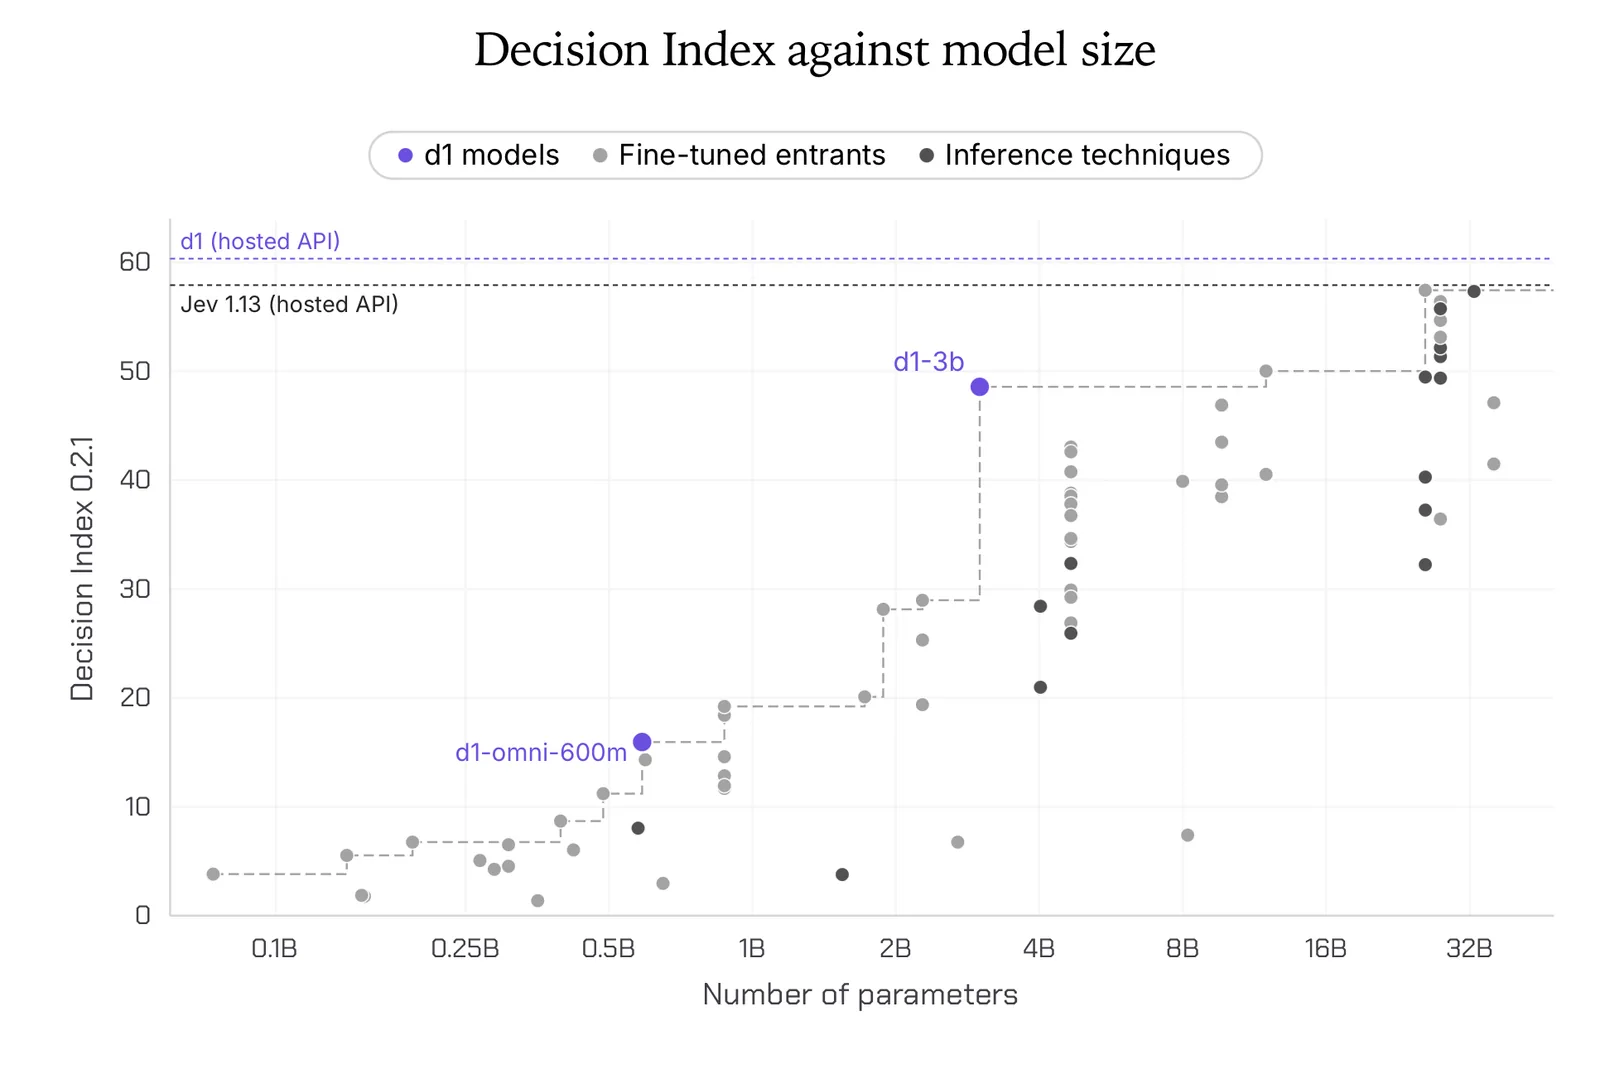
Fine-Tuning Mandiri Pakai Single GPU: Cocok Buat Kebutuhan Khusus
Liquid AI secara tegas memposisikan LFM3 sebagai fondasi awal untuk spesialisasi data. Model-model frontier raksasa memang pintar menjawab segala hal, tapi mereka belum tentu memahami terminologi unik bisnis atau SOP internal perusahaanmu.
Liquid AI menyediakan berbagai notebook Colab gratis untuk fine-tuning berbagai skenario tugas:
- LFM3-1.7B (SFT): Ekstraksi data JSON terstruktur dari dokumen berantakan.
- LFM3-1.7B (DPO): Menjawab pertanyaan berbasis dokumen RAG atau memilih menolak jika data tidak ditemukan.
- LFM3-1.7B (GRPO): Menjalankan tool calling yang tepat pada aplikasi smartphone berisi 108 tools.
- LFM3-1.7B (CPT): Mempelajari bahasa baru (seperti bahasa Turki) dari kumpulan teks mentah.
- LFM3-VL-2B (SFT & GRPO): Membaca struk belanja ke format JSON dan mengubah gambar rumus matematika menjadi kode LaTeX.
- LFM3-Audio-2B & Omni-2B (SFT): Mengubah perintah suara smart-home menjadi function call, melatih suara baru, hingga menjawab pertanyaan suara seputar gambar medis.
Semua notebook tersebut bisa kamu akses langsung lewat repositori GitHub cookbook Liquid4All.
Dampak Nyata untuk Developer dan Industri di Indonesia
Buat ekosistem teknologi di Indonesia, hadirnya model open-weight berukuran 2B dengan performa frontier membawa beberapa keuntungan praktis:
- Kepatuhan Privasi Data dan UU PDP: Perusahaan perbankan, fintech, dan fasilitas kesehatan di Indonesia kini bisa menjalankan model klasifikasi data (seperti d1-2B) atau pemrosesan dokumen langsung di server on-premise tanpa mengirim data nasabah ke API pihak ketiga di luar negeri.
- Solusi Perangkat Kasir dan Edge IoT: Karena model teksnya hanya butuh memori sekitar 1 GB pada kuantisasi 4-bit, model ini bisa disematkan langsung di mesin kasir (POS), perangkat Android industri, atau mini PC seperti Raspberry Pi 5 tanpa internet kencang.
- Efisiensi Biaya Operasional: Developer startup tidak perlu lagi membayar tagihan API per token yang membengkak untuk tugas-tugas berulang seperti ekstraksi invoice, routing email komplain, atau bot transkripsi customer service.
Kalau aplikasi kamu masih membutuhkan model frontier raksasa di cloud untuk tugas penalaran yang sangat kompleks dan ingin memadukannya dengan eksekusi model lokal, kamu bisa memakai Classai Router. Lewat Classai Router, kamu bisa mengakses model kelas atas seperti DeepSeek V4.1 Flash (Rp1.155 / Rp4.200 per 1 juta token) atau GPT-4o mini (Rp945 / Rp3.750 per 1 juta token) menggunakan satu API key dan pembayaran rupiah tanpa perlu kartu kredit luar negeri.
Untuk mempelajari lebih jauh mengenai integrasi sistem AI dan arsitektur pengembangannya, kamu juga bisa melihat panduan di kelas AI untuk Developer di platform Classai.
Sumber & referensi
- 01
Hugging Face · 28 Oktober 2026
Build specialized multimodal models with LFM3
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu LFM3 yang dirilis di Hugging Face?
LFM3 adalah generasi ketiga Liquid Foundation Models dari Liquid AI yang dirilis secara open-weight di Hugging Face. Model ini berukuran di kelas 2 miliar parameter dan mencakup model teks, visi video, audio, omni, hingga model khusus pengambil keputusan (decision).
Berapa spesifikasi RAM yang dibutuhkan untuk menjalankan LFM3-1.7B?
Model teks LFM3-1.7B hanya membutuhkan memori sekitar 1 GB pada kuantisasi 4-bit. Ukuran yang sangat ringkas ini memungkinkan model berjalan lancar di perangkat laptop standar, smartphone, hingga komputer papan tunggal seperti Raspberry Pi 5.
Apakah LFM3 bisa di-fine-tune dengan data sendiri?
Bisa banget. Seluruh varian LFM3 dirancang khusus untuk dispesialisasi dan dapat di-fine-tune menggunakan single GPU saja. Liquid AI juga menyediakan notebook panduan resmi untuk metode SFT, DPO, GRPO, hingga continual pre-training.
Apa perbedaan utama model d1-2B dengan model LFM3 lainnya?
Model d1-2B dirancang bukan untuk menghasilkan teks panjang, melainkan memberikan jawaban terstruktur dan keputusan terkalibrasi secara instan dalam satu forward pass. Model ini sangat pas untuk ekstraksi data dokumen, penentuan rute komplain tiket, dan verifikasi kondisi visual.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.