LFM 2.5 24B A2B Rilis: Agent AI Privat Kencang di Laptop
Liquid AI ngerilis LFM 2.5 24B A2B, model penalaran open-weight yang cuma butuh 2B parameter aktif buat jalanin AI agent lokal yang super kencang dan privat.
· 8 menit baca
Inti singkat
- LFM 2.5 24B A2B punya total 24 miliar parameter tapi cuma mengaktifkan 2 miliar parameter per token.
- Model ini selalu berpikir runtut sebelum menjawab dan dirancang khusus buat menjalankan tugas multi-langkah serta tool calling.
- Kecepatan decoding tembus 184 token per detik di Apple M5 Max dan 21 ribu token per detik di GPU NVIDIA B300.
- Bobot model dirilis secara terbuka di Hugging Face dan langsung mendukung ekosistem seperti llama.cpp, vLLM, dan MLX.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
Liquid AI resmi meluncurkan LFM 2.5 24B A2B, model penalaran berbasis Mixture-of-Experts (MoE) yang dirancang khusus buat menjalankan AI agent lokal secara cepat dan privat langsung di perangkat pengguna. Berkat efisiensi arsitekturnya yang cuma mengaktifkan 2 miliar parameter per token dari total 24 miliar parameter, model ini bikin ongkos komputasi lokal jadi enteng banget tanpa mengorbankan ketajaman bernalar.
Kabar gembira ini diumumkan langsung lewat pengumuman resmi di Hugging Face. Isu privasi data emang makin krusial belakangan ini, terutama pas kita ngebahas privasi AI agent yang sering kali mengharuskan pengiriman data rahasia perusahaan ke server pihak ketiga. Nah, kehadiran LFM 2.5 24B A2B nawarin jalan keluar yang pas: kamu bisa jalanin agent mandiri di laptop atau server kantor sendiri secara mandiri tanpa bocor ke mana-mana.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu LFM 2.5 24B A2B dan Kenapa Menarik Perhatian?
LFM singkatan dari Liquid Foundation Model. Varian terbaru berkode LFM 2.5 24B A2B ini fokus utamanya adalah menjadi reasoning model alias model penalaran yang selalu menghasilkan chain of thought eksplisit sebelum ngasih jawaban akhir ke pengguna. Nggak cuma modal ngomong doang, model ini dilatih khusus buat manggil fungsi eksternal (tool use) dan memecahkan masalah multi-tahap di dalam berbagai agent harness populer.
Keunikan terbesarnya terletak pada label "A2B" atau 2B Active. Model ini punya 24 miliar total parameter, tapi mesin inferensi cuma membangunkan 2 miliar parameter pas memproses tiap token. Artinya, setiap langkah pemikiran (reasoning token) berjalan sangat ringan di perangkat keras biasa.
Selain versi instruksi LFM2.5-24B-A2B, Liquid AI juga ngerilis bobot dasar LFM2.5-24B-A2B-Base di Hugging Face. Dua-duanya berstatus open-weight, jadi developer bebas ngulik, ngedistribusiin, sampai ngelakuin fine-tuning sesuai kebutuhan proyek masing-masing.
Arsitektur Hybrid Unik: Rahasia di Balik 2 Miliar Parameter Aktif
Model ini dibangun di atas fondasi pendahulunya, LFM2-24B-A2B, dengan tetap mempertahankan formula arsitektur hibrida: 40 layer, 64 experts di tiap blok MoE dengan mekanisme top-4 routing, serta gabungan unik antara gated short convolutions dan Grouped-Query Attention (GQA). Pendekatan konvolusi pendek ini ngebantu proses sekuensial jadi jauh lebih hemat memori dibanding Transformer standar murni.
Ada sejumlah pembaruan teknis gede yang disuntikkan ke LFM 2.5:
- Konteks melompat ke 131K token: Sebelumnya cuma mentok di 32K token, kini jendela konteksnya melebar sampai 131.072 token buat nampung log obrolan panjang dan berkas kode tebal.
- Ekspansi tokenizer dua kali lipat: Kosakata tokenizer diperbesar dari 65K menjadi 128K token lewat in-place expansion. Pembaruan ini penting banget biar pemrosesan teks non-Latin jadi jauh lebih efisien dan hemat token.
- Fase pre-training skala raksasa: Skala pra-pelatihan dinaikkan dari ~17 triliun menjadi sekitar 33 triliun token.
- Mid-training terarah: Ditambahkan 2 triliun token pada jendela 32K (fokus ke penalaran, matematika, kode, kepatuhan instruksi, dan teks multibahasa) plus 300 miliar token pada jendela 131K konteks panjang.
- Post-training lima tahap: Diolah lewat Supervised Fine-Tuning (SFT), Teacher Specialization, dua tahap Multi-domain On-Policy Distillation (MOPD) non-agentic dan agentic, lalu ditutup dengan Agentic Reinforcement Learning (Agentic RL) langsung di dalam lingkungan seperti OpenClaw, Hermes Agent, Pi, dan OpenCode.
Hasil Benchmark: Seberapa Jago Lawan Model yang Lebih Gede?
Tim peneliti menguji LFM 2.5 24B A2B melawan tiga model MoE lain yang ukurannya sekitar 50% lebih gede, yaitu Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it, dan Nemotron-3.5-Lightning (30B-A3B). Evaluasi dijalankan menggunakan vLLM di 16 tolok ukur standar industri.
| Tolok Ukur (Benchmark) | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verified (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
Dari data di atas kelihatan jelas: LFM 2.5 memimpin atau mengimbangi pesaingnya pada 5 dari 8 benchmark penggunaan alat dan alur kerja agen (AutomationBench, BFCLv4, ToolSandbox, LiveClaw, dan τ³-Bench Banking). Malah di AutomationBench, skornya tembus lebih dari tiga kali lipat dibanding model terbaik berikutnya.
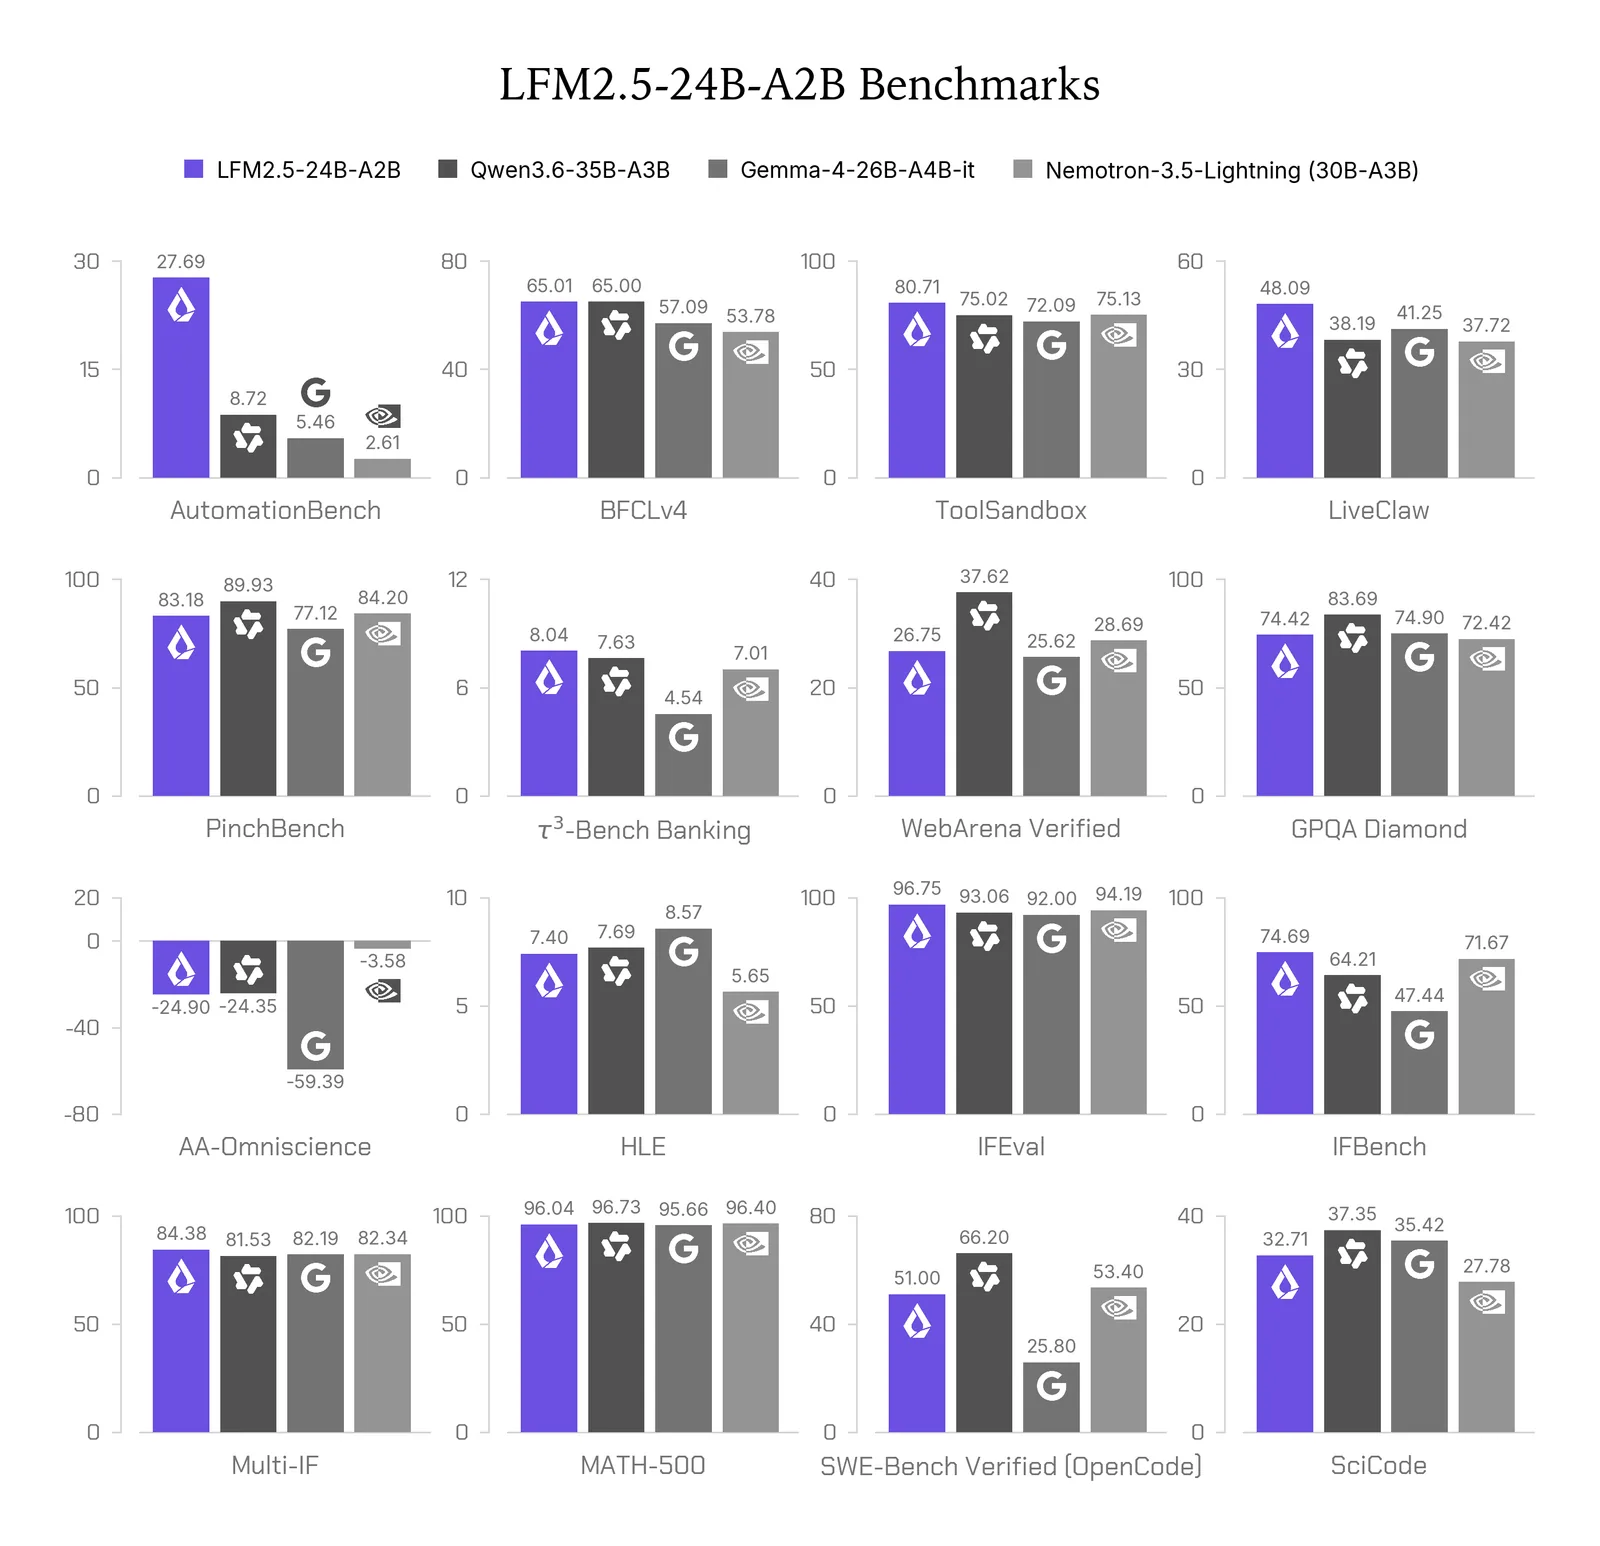
Kekuatan lain yang menonjol adalah kepatuhan instruksi (instruction following), di mana model ini menyapu bersih peringkat pertama di IFEval (96.75), IFBench (74.69), dan Multi-IF (84.38).
Kecepatan Inference di Laptop dan Server: M5 Max Tembus 184 Tok/s
Kelebihan utama arsitektur 2B active kerasa banget di pengujian kecepatan putar token (inference speed). Liquid AI memastikan dukungan day-one di berbagai mesin komputasi lokal terpopuler, mulai dari llama.cpp, MLX, vLLM, SGLang, hingga ONNX. Kamu bahkan bisa mempelajari teknik deployment model efisien semacam ini di panduan deploy model dengan llama.cpp.
Pada pengujian perangkat edge alias komputer lokal:
- Apple M5 Max: Mencapai kecepatan decoding 184 token per detik.
- AMD Ryzen AI Max+ 395: Menghasilkan 114 token per detik.
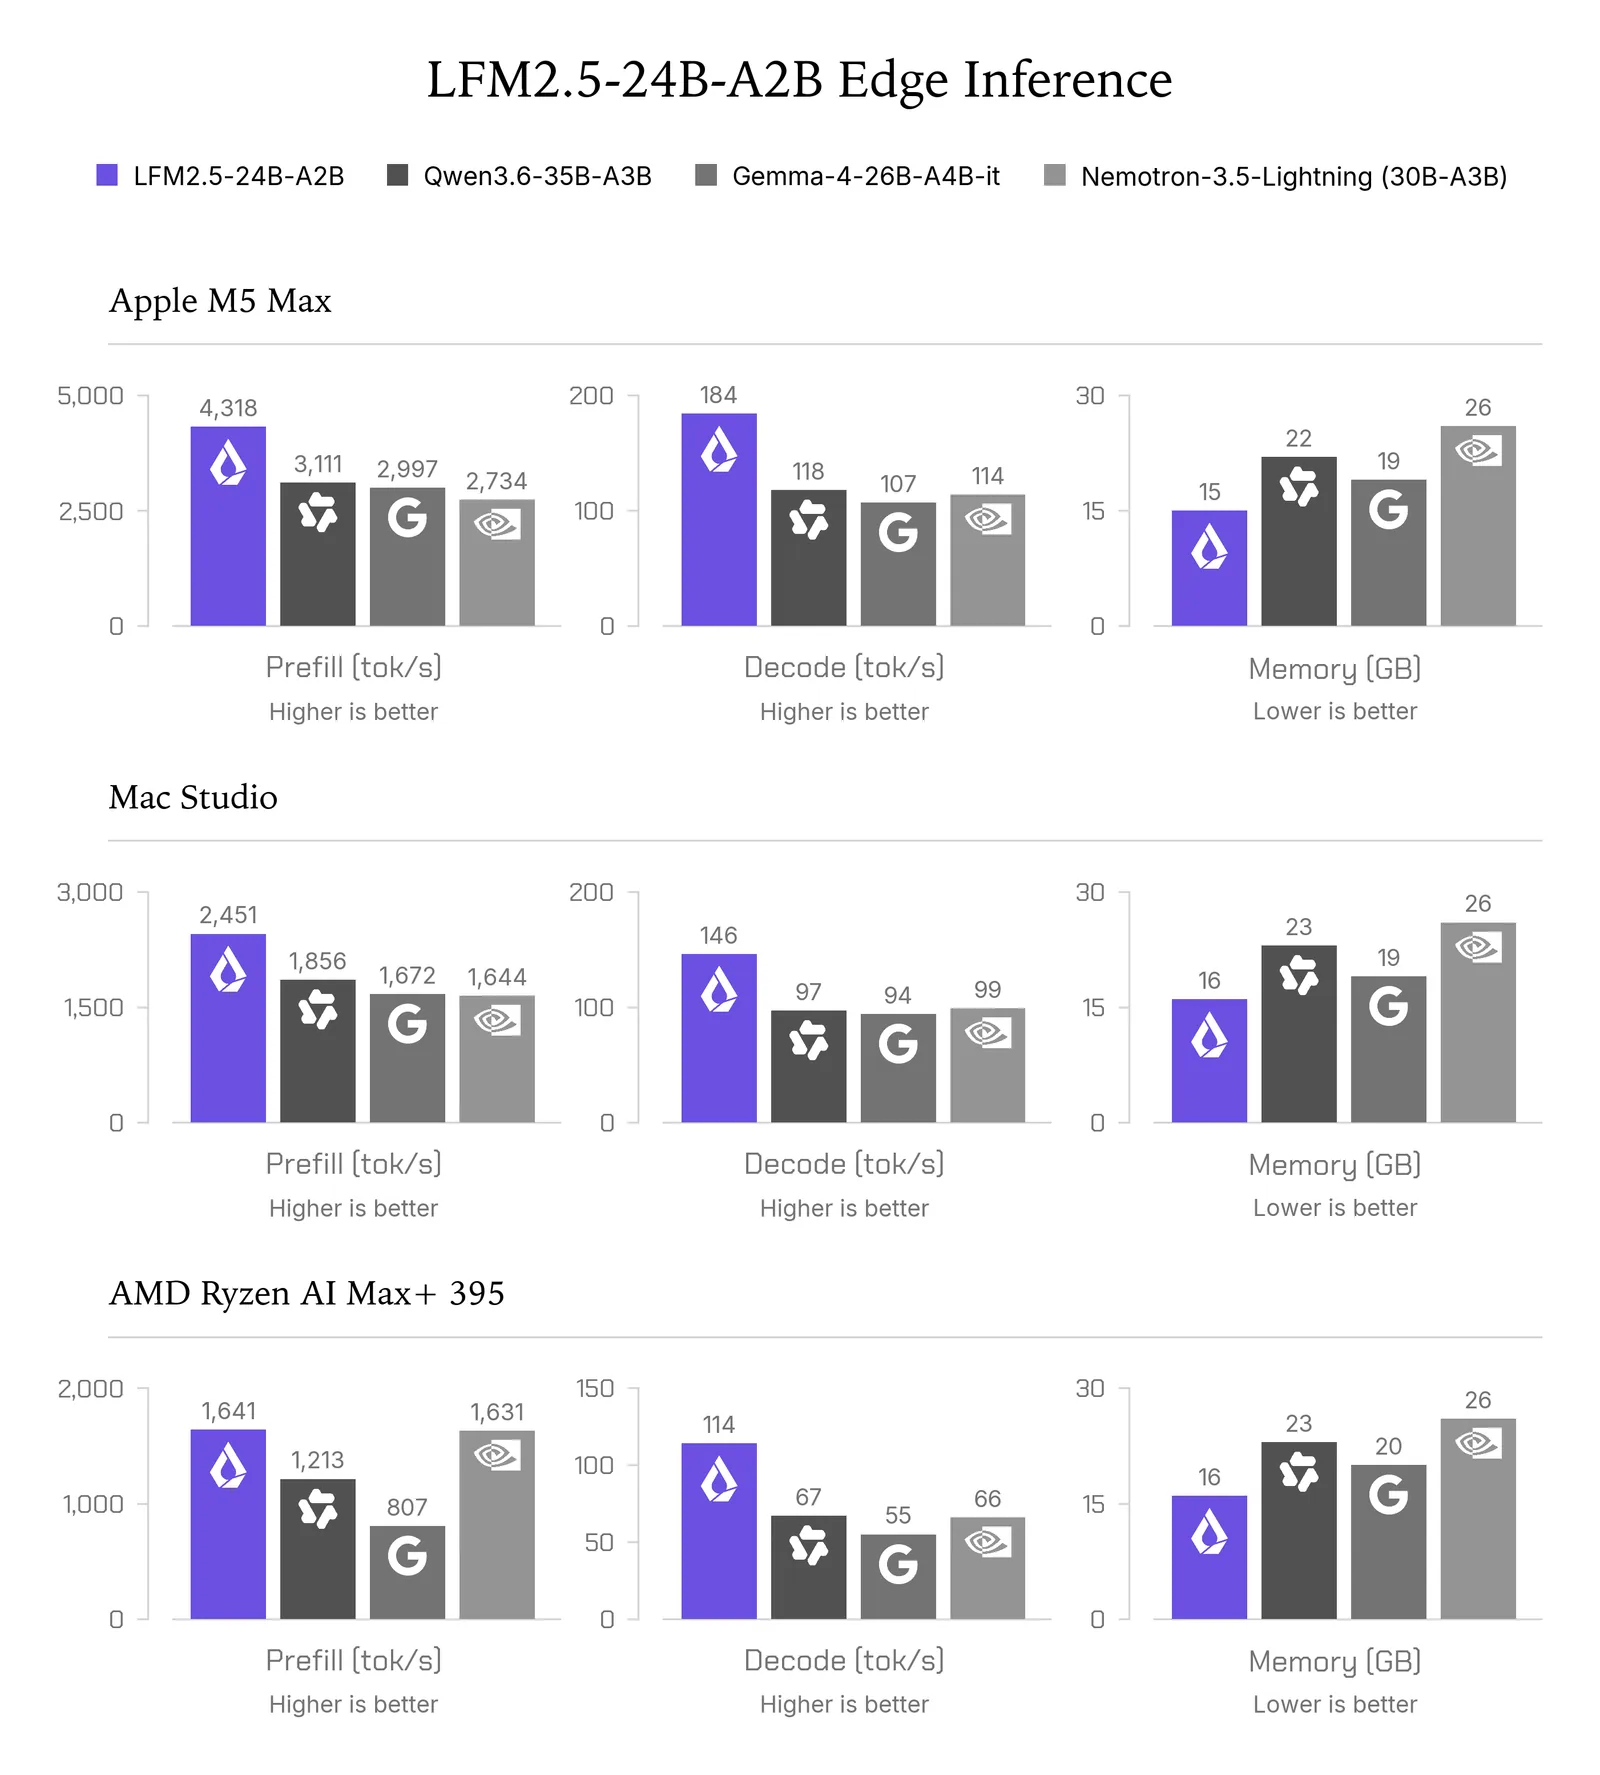
Catatan tersebut membuktikan performanya hingga 1,7 kali lebih kencang dibanding model pembanding, dengan konsumsi memori paling irit di kelasnya.
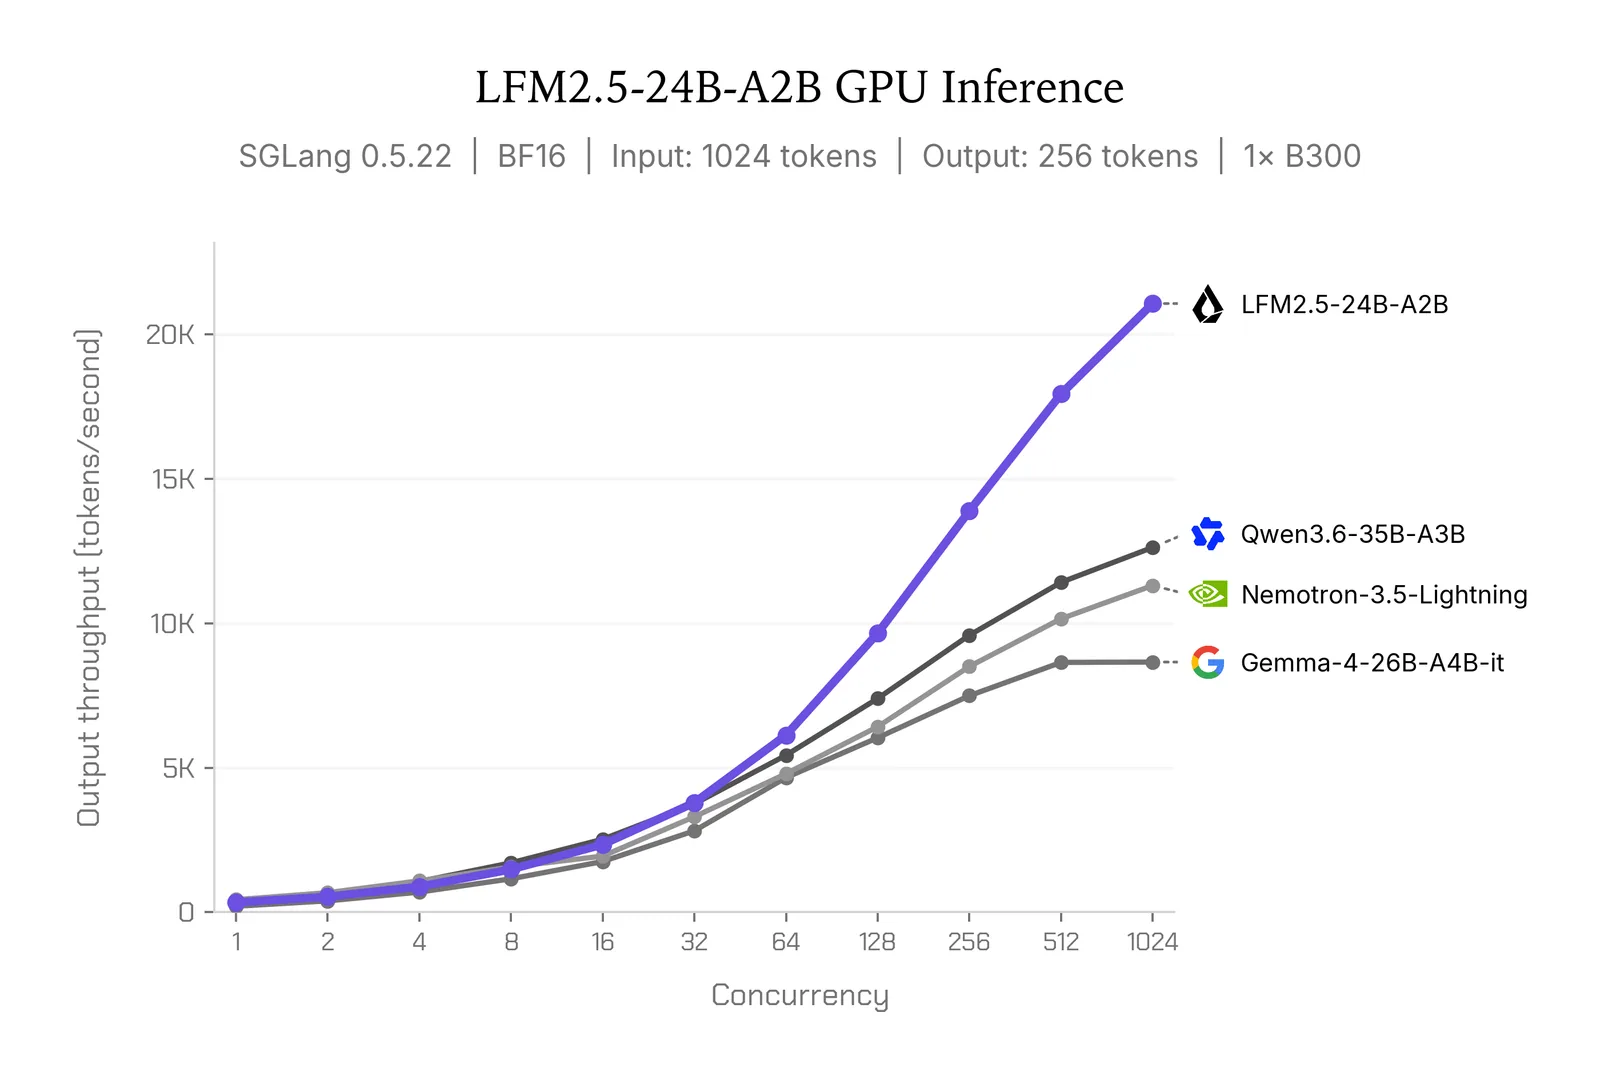
Sementara buat kebutuhan skala server besar dengan concurrency tinggi, inferensi menggunakan satu GPU NVIDIA B300 sanggup menyemburkan keluaran hingga lebih dari 21.000 output token per detik.
Cara Mencoba LFM 2.5 24B A2B di Komputer Sendiri
Penasaran pengin langsung nyobain? Kamu bisa memulainya lewat pustaka Python transformers atau menghubungkannya ke framework agent mandiri.
1. Menjalankan Model Pakai Python Transformers
Pastikan lingkungan Python kamu sudah memasang versi pustaka terbaru (minimal transformers>=5.0.0):
pip install -U transformersSetelah itu, jalankan skrip Python sederhana ini untuk mengeksekusi inferensi dasar:
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
    # attn_implementation="flash_attention_2" # Aktifkan baris ini kalau GPU mendukung
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "Jelaskan apa itu C. elegans secara singkat dan kenapa penting di riset biologi?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_new_tokens=512,
    streamer=streamer,
)
2. Integrasi ke Agent Harness (Hermes Agent)
Kalau kamu pengin membangun asisten otomatis yang bisa menjalankan fungsi terminal atau API, kamu cukup menyajikan model ini di backend lokal yang kompatibel dengan protokol OpenAI (seperti llama.cpp atau vLLM), lalu hubungkan ke harness seperti Hermes Agent lewat perintah konfigurasi CLI:
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
Sebagai catatan, port default tergantung server yang kamu pakai: llama.cpp dan MLX memakai 8080, vLLM memakai 8000, SGLang memakai 30000, sedangkan LM Studio memakai 1234. Dokumentasi pengaturan lengkap bisa kamu cek langsung di panduan harness Liquid AI dan repo tutorial fine-tuning.
Berikut contoh format prompt yang pas buat menguji kapabilitas penalaran dan pemanggilan alatnya:
Kamu adalah agen AI asisten database lokal. Tugasmu: analisa log galat server berikut, cari biang kerok kegagalan koneksi, lalu tentukan tindakan perbaikan bertahap.Berpikirlah secara terstruktur langkah demi langkah sebelum memberikan rekomendasi akhir. Log:[2026-10-14 10:12:01] ERROR db_pool: Connection timeout after 5000ms (host: 10.0.4.12:5432)[2026-10-14 10:12:05] WARN worker_agent: Retry attempt 1 failed. Queue capacity at 98%.
Kapan Sebaiknya Memilih Model Cloud Dibandingkan LFM 2.5?
Walaupun skor eksekusi perintah dan pemanggilan alatnya sangat tinggi, LFM 2.5 24B A2B punya beberapa batasan yang perlu kamu perhatikan secara jujur.
Kalau kamu butuh model dengan kapasitas nalar raksasa tanpa mau repot menyiapkan perangkat keras lokal, memakai API komersial lewat router tetap jadi pilihan yang paling masuk akal. Lewat layanan Classai Router, kamu bisa langsung mengakses model penalaran alternatif super hemat seperti DeepSeek V4.1 Flash (deepseek-v4.1-flash) seharga Rp1.155 / Rp4.200 per 1 juta token, Kimi K3 (kimi-k3) seharga Rp2.925 / Rp14.580 per 1 juta token, atau Qwen 3.7 Plus (qwen3.7-plus) seharga Rp810 / Rp3.630 per 1 juta token dengan saldo rupiah dan tanpa langganan wajib.
Dampak Nyata Buat Ekosistem Developer di Indonesia
Kehadiran model open-weight yang kencang di laptop membuka peluang besar buat industri teknologi di tanah air, khususnya pada aspek-aspek berikut:
- Kepatuhan Regulasi dan Privasi (UU PDP): Sektor perbankan, instrumen finansial, dan layanan kesehatan di Indonesia terikat aturan ketat soal perlindungan data pribadi. Menjalankan agen AI on-device di server lokal kantor memastikan data nasabah nggak pernah mampir ke jaringan luar negeri.
- Solusi Internet Lemot dan Tidak Stabil: Banyak lokasi operasional bisnis di daerah pinggiran atau perkebunan yang konektivitas internetnya pas-pasan. Model cerdas yang bisa mikir langsung di laptop lapangan bikin otomasi sistem tetap jalan tanpa bergantung sinyal seluler.
- Efisiensi Anggaran Infrastruktur: Daripada menyewa kluster cloud GPU berbiaya ribuan dolar per bulan cuma buat menjalankan agen berulang, kantor rintisan atau instansi lokal bisa memanfaatkan workstation berbasis Mac Silicon atau prosesor PC modern dengan pengeluaran listrik yang sangat minim.
Kalau kamu pengin memperdalam keterampilan merancang agen AI mandiri dan mengintegrasikan model bahasa ke alur kerja perangkat lunak modern, kamu bisa bergabung di kelas AI untuk Developer di Classai untuk belajar langsung dari para praktisi industri.
Sumber & referensi
- 01
Hugging Face · 14 Oktober 2026
Run fast, private agents on-device with LFM2.5-24B-A2B
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa keunggulan utama LFM 2.5 24B A2B?
Keunggulan utamanya adalah kemampuan penalaran agen yang kencang dengan kebutuhan komputasi ringan. Model ini punya 24 miliar total parameter tetapi hanya mengaktifkan 2 miliar parameter per token, sehingga sangat hemat memori dan bisa berjalan ngebut di laptop lokal.
Berapa kecepatan inferensi LFM 2.5 24B A2B di komputer lokal?
Kecepatan decoding-nya mencapai 184 token per detik pada chip Apple M5 Max dan 114 token per detik pada AMD Ryzen AI Max+ 395. Performa ini tercatat hingga 1,7 kali lebih kencang dibandingkan model MoE kompetitor di kelas ukuran yang sama.
Apakah LFM 2.5 24B A2B gratis dan open source?
Bobot model LFM 2.5 24B A2B dan varian dasarnya dirilis secara open-weight di platform Hugging Face. Pengembang dan perusahaan bebas mengunduh, menjalankan secara privat di perangkat sendiri, serta melakukan fine-tuning sesuai kebutuhan tanpa biaya lisensi per token.
Kapan sebaiknya tidak memakai LFM 2.5 24B A2B?
Hindari mengandalkan model ini sendirian untuk tugas yang menuntut bank data fakta sangat luas atau perbaikan bug kode kompleks setara SWE-Bench tanpa sistem RAG. Untuk skenario kaya pengetahuan, model ini wajib dipadukan dengan mesin pencari eksternal atau database referensi.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.