Llama.cpp di SageMaker: Panduan Deploy Decision Model Keren
AWS resmi ngerilis panduan deploy llama.cpp di Amazon SageMaker AI. Sekarang kamu bisa ngejalanin decision model GGUF hemat biaya di CPU maupun GPU.
· 9 menit baca
Inti singkat
- AWS ngerilis Deep Learning Container resmi buat ngejalanin model GGUF llama.cpp di Amazon SageMaker AI.
- Adaptor SemIf langsung ngebaca probabilitas logits tanpa nunggu decoding token jawaban yang bikin lama.
- Uji benchmark Qwen3.5-4B buktiin inferensi GPU ml.g6e.xlarge 32 kali lebih ngebut di p95 dibanding CPU.
- Fitur instance pool ngebantu SageMaker milih GPU cadangan otomatis pas kuota tipe utama lagi penuh.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
AWS resmi ngasih cara baru buat deploy model terkuantisasi pakai AWS Deep Learning Containers (DLC) untuk llama.cpp di Amazon SageMaker AI. Lewat racikan ini, kamu bisa ngejalanin model format GGUF di CPU atau GPU terkelola buat urusan chat biasa maupun decision model terstruktur.
Selama ini, kita sering banget pakai model bahasa gede (LLM) cuma buat ngerjain hal sepele kayak milih satu opsi dari daftar baku. Contohnya nih, pas nentuin tiket komplain nasabah masuk ke divisi mana, ngecek kepatuhan transaksi, atau nentuin langkah agen AI selanjutnya. Masalahnya, kalau kamu nyuruh LLM ngeluarin jawaban teks biasa, prosesnya jadi lambat, buang token, dan rawan bikin pusing pas teksnya di-parse di backend aplikasi. Nah, seperti dilaporkan panduan resmi AWS Machine Learning Blog, sekarang kamu bisa ngejalanin llama.cpp di SageMaker AI bareng adaptor SemIf buat ngebaca probabilitas alias logits langsung tanpa nunggu model ngetik kata per kata.
Langkah ini nerusin rangkaian AWS Deep Learning Container khusus inferensi AI generatif, setelah sebelumnya AWS ngebahas container buat WhisperX dan vLLM-Omni. Penasaran gimana cara kerjanya dan seberapa ngebut performanya pas dipasang di cloud? Yuk, kita bedah bareng-bareng!
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Decision Model Lebih Pas Dibanding Chat Biasa?
Di banyak aplikasi modern, model AI sebetulnya nggak butuh ngarang cerita panjang lebar. Yang kamu butuhin cuma keputusan pasti dari pilihan yang udah disiapin sistem dari awal. Bayangin aplikasi perbankan kamu lagi nerima keluhan: kamu cuma pengin tahu pesan itu masuk kategori akun, tagihan, atau komplain umum. Kalau kamu minta LLM ngejawab pakai kalimat bebas kayak "Permasalahan ini masuk ke bagian akun", aplikasi kamu terpaksa nungguin tiap token teks selesai diketik, terus backend kamu harus repot nge-parse teks itu lagi.
Di sinilah konsep decision model kepakai banget. Model tipe ini bertugas ngasih skor probabilitas buat daftar pilihan yang udah kamu tentuin, langsung dari teks konteks yang belum terstruktur. Selain SemIf (yang dulunya bernama OpenJev), pola semacam ini juga ada di model lain kayak Jev (lewat API /v1/systemone bikinan TypeSafe), Kev, sampai Strands Decider 2B.
SemIf sendiri jalan sebagai adaptor di atas runtime llama.cpp. Bedanya sama chat biasa, SemIf nggak ngerjain decoding token jawaban sama sekali. Adaptor ini langsung ngecek nilai last-position logits pas token terakhir dan cuma ngebatesin hitungannya ke daftar opsi yang kamu kirim. Hasilnya keren banget: latensi kepangkas lumayan gede, responsnya stabil, dan sistem kamu nggak bakal kena eror akibat format JSON teks yang ngaco.
Memahami Dua Jalur Deploy di SageMaker AI
Biar fleksibel, AWS nyiapin dua jalur deploy berbeda dari satu paket model GGUF yang sama di Amazon S3. Kamu tinggal pilih mana yang paling pas buat kebutuhan sistem kamu.
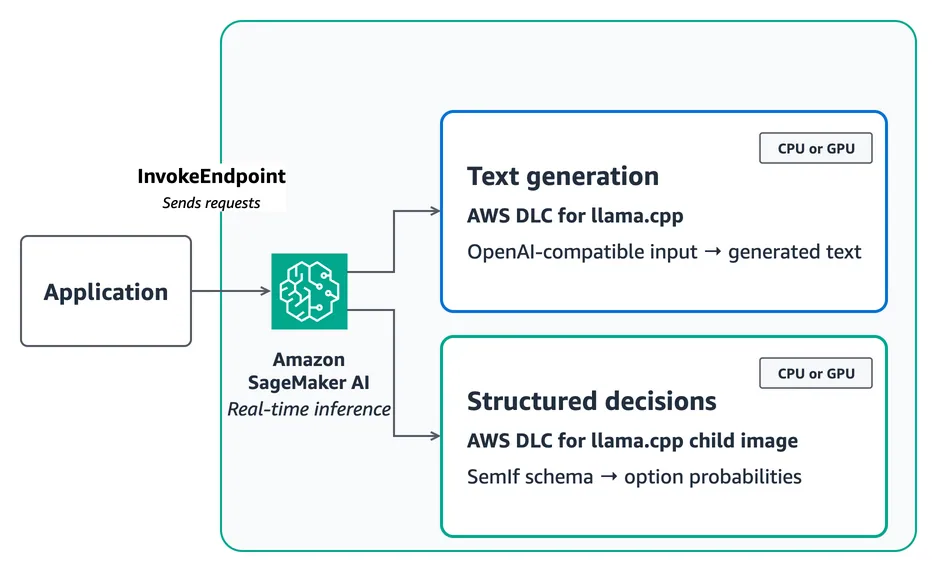
Mari kita bedah perbedaan kedua alur kerja yang kelihatan di diagram atas:
- Standard Text-Generation Path: Jalur ini langsung pakai image AWS DLC bawaan buat llama.cpp. File model kamu dibungkus jadi
model.tar.gzdi S3. Di dalam container, endpointPOST /invocationspunya SageMaker bakal dipetain otomatis ke endpoint/v1/chat/completionspunyallama-server. Format request dan responsnya udah kompatibel penuh sama standar OpenAI Chat Completions. - Structured-Decision Path: Karena HTTP API bawaan
llama-serverbelum ngasih akses langsung ke logits posisi akhir dan state internal model, kamu butuh bikin child image pakai bantuan AWS CodeBuild. Image turunan ini tetap nyimpen pustaka kompilasi CPU atau CUDA bawaan DLC AWS, tapi entry point-nya diganti pakai adaptor SemIf yang udah siap nerima kontrak inferensi SageMaker.
Enaknya jalur kedua ini, kamu dapet performa kencang dari pustaka native llama.cpp, tapi tetap dapet kontrol penuh buat ngambil angka probabilitas mentah tanpa ribet bikin container dari nol.
Skema Request: Beda Chat Biasa sama SemIf
Biar nggak bingung pas ngoding, kamu harus tahu bedanya format kirim data di kedua jalur ini. Di jalur teks standar, format request-nya mirip banget sama API OpenAI biasa, isinya pesan percakapan berurutan:
{
  "messages": [
    {
      "role": "user",
      "content": "A customer cannot receive a password reset email. Reply with the best support queue."
    }
  ],
  "max_tokens": 64,
  "stream": false
}
Responsnya juga standar, teks jawabannya tinggal kamu ambil dari field choices[0].message.content.
Tapi kalau kamu pakai SemIf buat ngambil keputusan terstruktur, format yang dikirim bakal beda. Kamu ngirim objek keputusan yang isinya ID unik, state teks konteks, pertanyaan penentu, sama daftar pilihan opsi yang dibolehin:
{
  "decision": {
    "id": "support-route",
    "state": "The customer cannot receive a password reset email.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access support."},
      {"id": "billing", "description": "Billing support."}
    ]
  }
}
Nah, respons yang dibalikin sama SemIf bukan kalimat curhat model, tapi data terstruktur yang rapi: ada option_ids, angka probabilities, nilai mentah option_logits, sampai hash metadata prompt. Pas dapet probabilitas pasti (misalnya 0.99996 buat opsi akses akun lawan 0.00003 buat tagihan), backend aplikasi kamu bisa langsung nentuin aksi lanjutan secara otomatis.
Benchmark CPU vs GPU: Seberapa Jauh Bedanya?
Pertanyaan paling umum pas mau nyobain llama.cpp di cloud: mending pakai instans CPU yang murah atau langsung sewa GPU? Biar dapet gambaran jelas, AWS ngetes model Qwen3.5-4B kuantisasi Q4_K_M pakai 231 tugas uji publik di JevBench secara berurutan. Hasilnya lumayan bikin kaget!
Berikut rangkuman angka pengujian antara CPU dan GPU:
| Konfigurasi Hardware | AWS DLC yang Dipakai | Respons Valid | Akurasi | Klien Latensi p50 | Klien Latensi p95 |
|---|---|---|---|---|---|
| ml.c6i.8xlarge (CPU 32 threads) | llama-cpp:server-sagemaker-cpu-v1 | 231/231 | 179/231 (77,5%) | 1,715 detik | 19,291 detik |
| ml.g6e.xlarge (Full GPU offload L40S) | llama-cpp:server-sagemaker-cuda-v1 | 231/231 | 180/231 (77,9%) | 0,352 detik | 0,599 detik |
Kalau kamu perhatiin tabel tadi, di median (p50), GPU emang udah 4,9 kali lebih ngebut dibanding CPU. Tapi jurang performa paling gila ada di latensi ekor (p95): GPU sanggup beres cuma dalam waktu 0,599 detik, sedangkan CPU ngos-ngosan sampai nembus 19,291 detik. Artinya, GPU 32,2 kali lebih ngebut di p95!
Semua 34 layer model Qwen3.5-4B berhasil di-offload penuh ke VRAM NVIDIA L40S pada instans ml.g6e.xlarge. Terus gimana soal beda akurasi satu jawaban (179 vs 180)? AWS ngejelasin kalau itu murni variasi runtime akibat beda build pustaka matematika llama.cpp antara versi CPU dan CUDA, bukan berarti GPU bikin model jadi lebih pinter.
AWS juga sempat nyobain model yang ukurannya lebih kecil kayak varian 2B dan 0.8B. Emang sih latensinya lebih singkat, tapi akurasinya anjlok parah ke angka 66,7 persen dan 58,4 persen. Makanya, model 4B dengan kuantisasi Q4_K_M dipasang jadi standar bawaan paling seimbang antara kecepatan sama ketepatan logika.
Langkah Praktis: Cara Deploy Llama.cpp di SageMaker AI
Penasaran pengin nyobain sendiri di akun AWS kamu? Kamu bisa ngikutin langkah-langkah praktis ini. Pastikan kamu udah nyiapin Python 3.10 ke atas, Git, AWS CLI, serta IAM Role yang dibutuhin buat SageMaker dan CodeBuild.
1. Clone Repositori dan Siapkan Dependensi
Pertama, clone repositori sampel resmi dari AWS dan pasang pustaka pendukungnya di environment lokal kamu:
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git
cd sagemaker-genai-hosting-examples/03-features/semif-decision-model
python3 -m venv .venv
source .venv/bin/activate
python3 -m pip install -r deploy/requirements.txt
Lanjut setel variabel lingkungan akun AWS kamu biar gampang dipanggil di skrip:
export AWS_REGION="ap-southeast-1"
export ARTIFACT_BUCKET=amzn-s3-demo-semif-artifacts
export CODEBUILD_ROLE_ARN=arn:aws:iam::111122223333:role/semif-codebuild-role
export SAGEMAKER_ROLE_ARN=arn:aws:iam::111122223333:role/semif-sagemaker-role
export STANDARD_ENDPOINT_NAME=llamacpp-gguf
export SEMIF_ENDPOINT_NAME=semif-decision-workflows
2. Siapkan dan Kemas Model GGUF ke S3
Jalankan skrip persiapan model. Langkah ini bakal ngejalanin CodeBuild buat ngecek checksum model GGUF dan nyimpen arsipnya ke S3:
python deploy/prepare_model_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --model-s3-uri "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz"
Skrip ini bakal mastiin checksum file GGUF kamu cocok sama manifest. Selain cara ini, kamu sebetulnya bisa juga ngisi parameter SM_LLAMA_CPP_HF_REPO dan SM_LLAMA_CPP_HF_FILE kalau endpoint kamu dibolehin download file langsung dari Hugging Face pas baru nyala.
3. Deploy Endpoint Teks Standar
Kalau kamu cuma butuh inferensi chat biasa, kamu nggak perlu repot bikin Dockerfile. Cukup ambil URI image CPU resmi AWS DLC dan deploy langsung:
export STANDARD_IMAGE_URI="<published-llama-cpp-cpu-image>@sha256:<digest>"

python deploy/deploy_standard_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$STANDARD_IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-type ml.c6i.2xlarge \
  --name "$STANDARD_ENDPOINT_NAME"
Tunggu sampai status endpoint berubah jadi InService, terus kamu bisa langsung nyobain kirim request chat via skrip deploy/invoke_standard_endpoint.py.
4. Bikin Image SemIf dan Pasang GPU Instance Pool
Buat jalur decision model berbasis SemIf di GPU, rakit dulu image CUDA-nya lewat CodeBuild:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --dockerfile Dockerfile.gpu \
  --image-tag "gpu-$(date +%Y%m%d%H%M%S)"
Setelah build selesai, ambil digest image immutable dari Amazon ECR, lalu jalankan skrip deploy dengan fitur instance pool bertingkat:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-pool ml.g6e.xlarge \
  --instance-pool ml.g6.2xlarge \
  --instance-pool ml.g5.2xlarge \
  --instance-pool ml.g4dn.2xlarge \
  --gpu-layers=-1 \
  --provision-timeout 1200 \
  --name "$SEMIF_ENDPOINT_NAME"
Fitur instance pool ini keren banget karena bertindak sebagai daftar cadangan otomatis. Jadi semisal tipe ml.g6e.xlarge lagi kehabisan stok di data center AWS, sistem bakal otomatis nyari tipe berikutnya (g6, g5, terus g4dn). Opsi --gpu-layers=-1 bakal mastiin seluruh layer model dipindahin ke memori GPU.
Manajemen pembagian resource komputasi di cloud kayak gini punya konsep mirip sama optimasi cluster di artikel SageMaker HyperPod Multi-Team yang pernah kita bahas sebelumnya.
Kapan Mending Pilih CPU dan Kapan Wajib GPU?
Biar nggak boncos pas bayar tagihan cloud bulanan, kamu harus pintar-pintar milih hardware yang sesuai sama kebutuhan aplikasi:
- Pilih CPU (misalnya ml.c6i.8xlarge atau c6i.2xlarge): Cocok banget buat tugas latar belakang (background jobs), pipeline batch data malam hari, klasifikasi dokumen arsip, atau aplikasi internal kantor yang trafiknya santai dan nggak masalah kalau harus nunggu beberapa detik.
- Wajib GPU (misalnya ml.g6e.xlarge atau g5): Pilihan mutlak buat sistem interaktif yang ditungguin langsung sama pengguna, alur kerja bot customer support real-time, dokumen dengan prompt panjang, atau sistem yang punya target SLA ketat di bawah satu detik.
Kalau aplikasi kamu sering nentuin beberapa hal sekaligus dari satu dokumen yang sama, kamu bisa gabungin beberapa opsi keputusan ke dalam satu request. Adaptor SemIf bakal nggunain ulang awalan prompt yang sama, jadi proses penilaian berikutnya bisa jauh lebih hemat waktu.
Efeknya Buat Developer dan Bisnis di Indonesia
Buat teman-teman software engineer dan startup di Indonesia, hadirnya panduan deploy llama.cpp terkelola di Amazon SageMaker AI ini ngebawa angin segar:
- Hemat Biaya Cloud: Banyak tim engineering buru-buru nyewa instans GPU raksasa cuma buat ngejalanin LLM biasa. Padahal, pakai kuantisasi GGUF 4-bit, model lincah kayak Qwen3.5-4B udah bisa jalan ngebut di instans GPU kecil atau bahkan CPU biasa tanpa bikin kantong jebol.
- Logika Agen AI Jadi Nggak Gampang Rusak: Sering banget agen AI gagal jalan gara-gara format JSON dari LLM berantakan atau halusinasi. Karena SemIf langsung ngembaliin probabilitas dari ID opsi yang udah fix, masalah integrasi logika rapuh — kayak yang sempat dibahas pas bikin pembayaran mandiri agen AI di Bedrock — bisa diberesin sejak awal.
- Aman Buat Aturan Privasi dan UU PDP: Buat perusahaan fintech, perbankan, atau asuransi di Indonesia yang ketat soal perlindungan data nasabah, kamu bisa ngejalanin seluruh alur inferensi di dalam VPC privat SageMaker milik sendiri tanpa perlu lempar data mentah ke server pihak ketiga di luar negeri.
Tapi kalau kamu ngerasa ngurus infrastruktur container di AWS itu masih keribetan dan tim kamu cuma butuh API siap pakai buat nyoba berbagai model AI top dunia, kamu bisa lirik Classai Router. Cukup pakai satu API key yang kompatibel sama SDK OpenAI, kamu bisa langsung gonta-ganti model tanpa pusing mikirin server.
Buat kamu yang pengin makin jago ngerancang arsitektur aplikasi berbasis kecerdasan buatan, kamu juga bisa gabung dan belajar bareng di Kelas AI untuk Developer.
Sumber & referensi
- 01
AWS · 12 Oktober 2026
Deploy decision models with llama.cpp on Amazon SageMaker AI
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa enaknya deploy llama.cpp di SageMaker AI dibanding VPS biasa?
Di SageMaker AI, kamu dapet container resmi AWS DLC yang udah terkelola penuh, lengkap bareng auto-scaling otomatis, monitoring CloudWatch bawaan, dan keamanan jaringan VPC privat. Kamu nggak perlu pusing ngurus update OS server atau kompilasi driver CUDA manual.
Kenapa SemIf bisa jauh lebih kencang dibanding minta format JSON ke LLM?
SemIf langsung ngebaca probabilitas logits pas token posisi paling akhir buat opsi yang kamu daftarin. Langkah ini nge-skip proses decoding token kata per kata yang biasanya bikin lama, jadi backend langsung dapet angka probabilitas pasti.
Apakah instance pool di SageMaker AI itu buat bagi beban trafik?
Bukan, fitur instance pool itu urutan prioritas cadangan hardware pas bikin endpoint. Kalau tipe GPU pilihan pertama kamu lagi habis di data center AWS, SageMaker bakal otomatis milih tipe cadangan berikutnya yang ada di daftar pool kamu.
Berapa ukuran model GGUF paling pas buat decision model begini?
Dari hasil tes AWS di JevBench, model 4B dengan kuantisasi Q4_K_M jadi pilihan paling ideal dengan akurasi 77,9%. Model yang lebih mungil kayak 2B dan 0.8B akurasinya jeblok ke 66,7% dan 58,4%.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.