SageMaker HyperPod Multi-Team: Trik Berbagi GPU Cluster
Punya cluster GPU mahal tapi rebutan antar-tim? Simak cara mengatur arsitektur multi-team di Amazon SageMaker HyperPod biar pemakaian adil dan aman.
· 9 menit baca
Inti singkat
- Arsitektur multi-team Amazon SageMaker HyperPod memungkinkan banyak tim berbagi satu cluster GPU EKS secara adil dan terisolasi.
- AWS IAM Identity Center terhubung dengan IdP eksternal seperti Microsoft Entra ID untuk mengelola akses SSO dan izin tim otomatis.
- Isolasi beban kerja diatur lewat namespace Kubernetes dan EKS access entries, sementara NetworkPolicy membatasi lalu lintas jaringan pod.
- HyperPod Task Governance mengatur kuota komputasi dan prioritas penjadwalan agar tidak ada tim yang memonopoli GPU cluster.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Amazon Web Services membagikan arsitektur acuan SageMaker HyperPod multi-team berbasis Amazon EKS agar banyak tim bisa berbagi cluster GPU mahal secara terisolasi dan adil. Lewat integrasi IAM Identity Center, namespace Kubernetes, dan Task Governance, kamu bisa mencegah rebutan komputasi sekaligus melacak pengeluaran per tim dengan rapi.
Di banyak perusahaan, urusan komputasi AI generatif sering bikin pusing tim infrastruktur. Tim data science lagi asyik nge-train model bahasa besar, tim computer vision butuh GPU buat inferensi, sementara tim riset sibuk uji coba arsitektur baru. Kalau masing-masing dibikinkan cluster sendiri, biayanya pasti langsung boncos. Tapi kalau digabung tanpa aturan, siap-siap aja ada tim yang boros komputasi dan bikin kerjaan tim lain macet.
Untuk mengatasi masalah itu, AWS merilis panduan arsitektur acuan resmi lewat artikel yang ditulis oleh Giuseppe Angelo Porcelli di blog AWS Machine Learning. Solusi ini memanfaatkan Amazon SageMaker HyperPod yang diorkestrasi oleh Amazon EKS. Buat kamu yang sebelumnya sempat membaca ulasan kami soal optimasi komputasi di /developer/sagemaker-ai-inference-agent-optimasi-gpu, arsitektur berbagi ini bakal melengkapi kebutuhan operasional AI tim kamu dari hulu ke hilir.
Yuk, kita bedah arsitektur dan langkah-langkah praktisnya bareng-bareng!
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Bagaimana Arsitektur Multi-Team SageMaker HyperPod Bekerja?
Prinsip kerja arsitektur ini menghubungkan alur identitas pengguna dari ujung kiri ke eksekusi beban kerja di sisi kanan cluster. Pengguna dari tiap tim—misalnya Tim A dan Tim B—bisa masuk lewat dua jalur: terminal CLI via aws sso login atau browser web menuju portal SageMaker Studio.
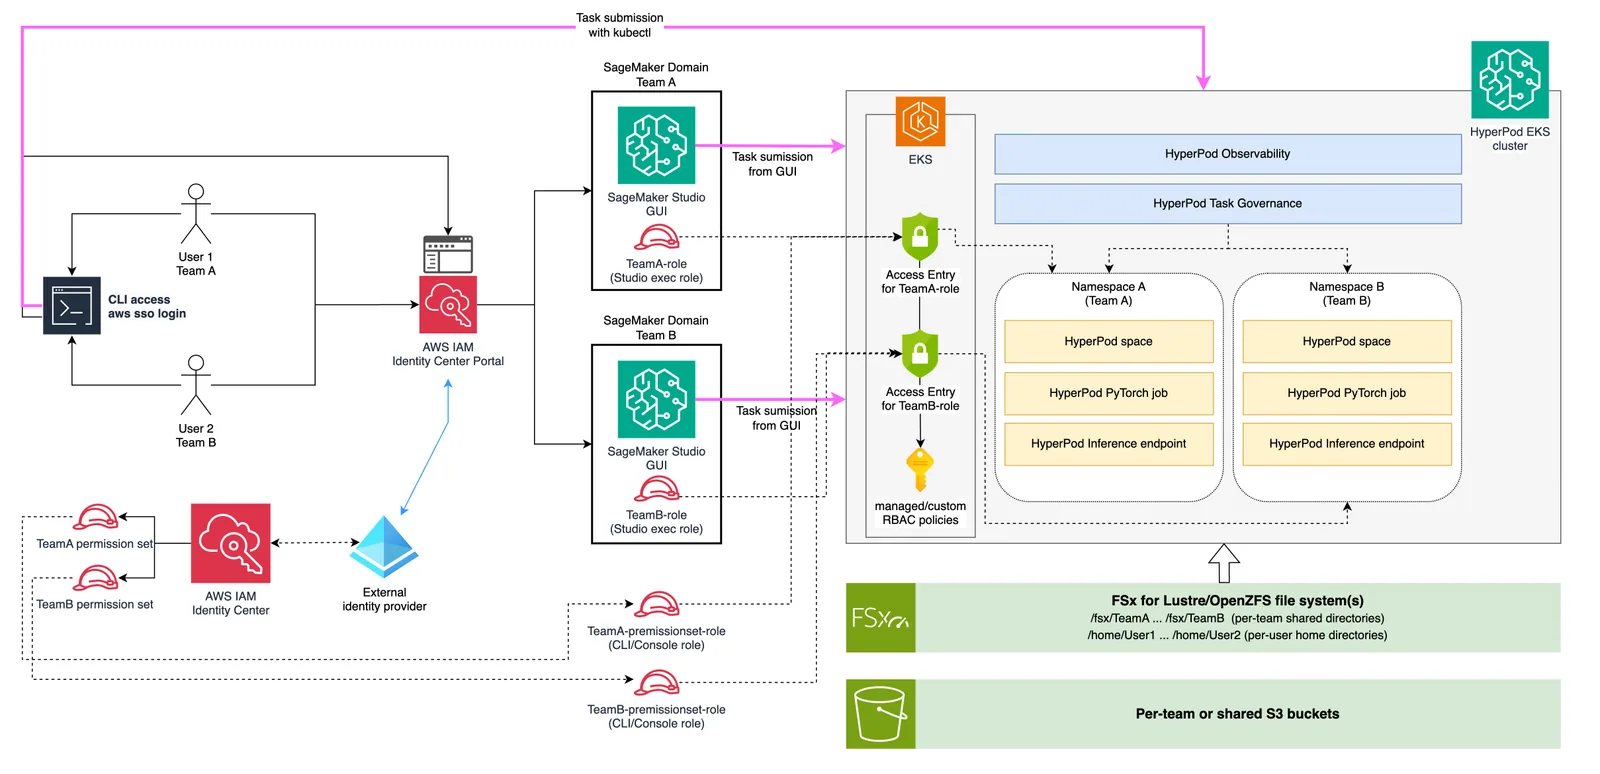
Kedua jalur ini diautentikasi terpusat lewat AWS IAM Identity Center yang terhubung dengan penyedia identitas kantor. Setelah lolos autentikasi, pengguna diarahkan ke SageMaker AI domain milik tim mereka masing-masing. Di level cluster EKS, pemetaan hak akses memastikan perintah dari GUI maupun CLI cuma bisa menyentuh namespace Kubernetes tim yang bersangkutan.
Di lapisan atas cluster, HyperPod Observability dan HyperPod Task Governance bertugas memantau metrik serta membagi kuota GPU secara adil. Di bawahnya, beban kerja seperti HyperPod Spaces, job pelatihan PyTorch, dan endpoint inferensi berjalan terpisah di namespace masing-masing.
Mengatur Autentikasi Terpusat Lewat AWS IAM Identity Center
Fondasi utama dari sistem multi-tenant adalah memastikan siapa yang masuk sebelum mereka menyentuh server komputasi. AWS IAM Identity Center menjadi pusat kontrol identitas karyawan di seluruh akun dan aplikasi AWS.
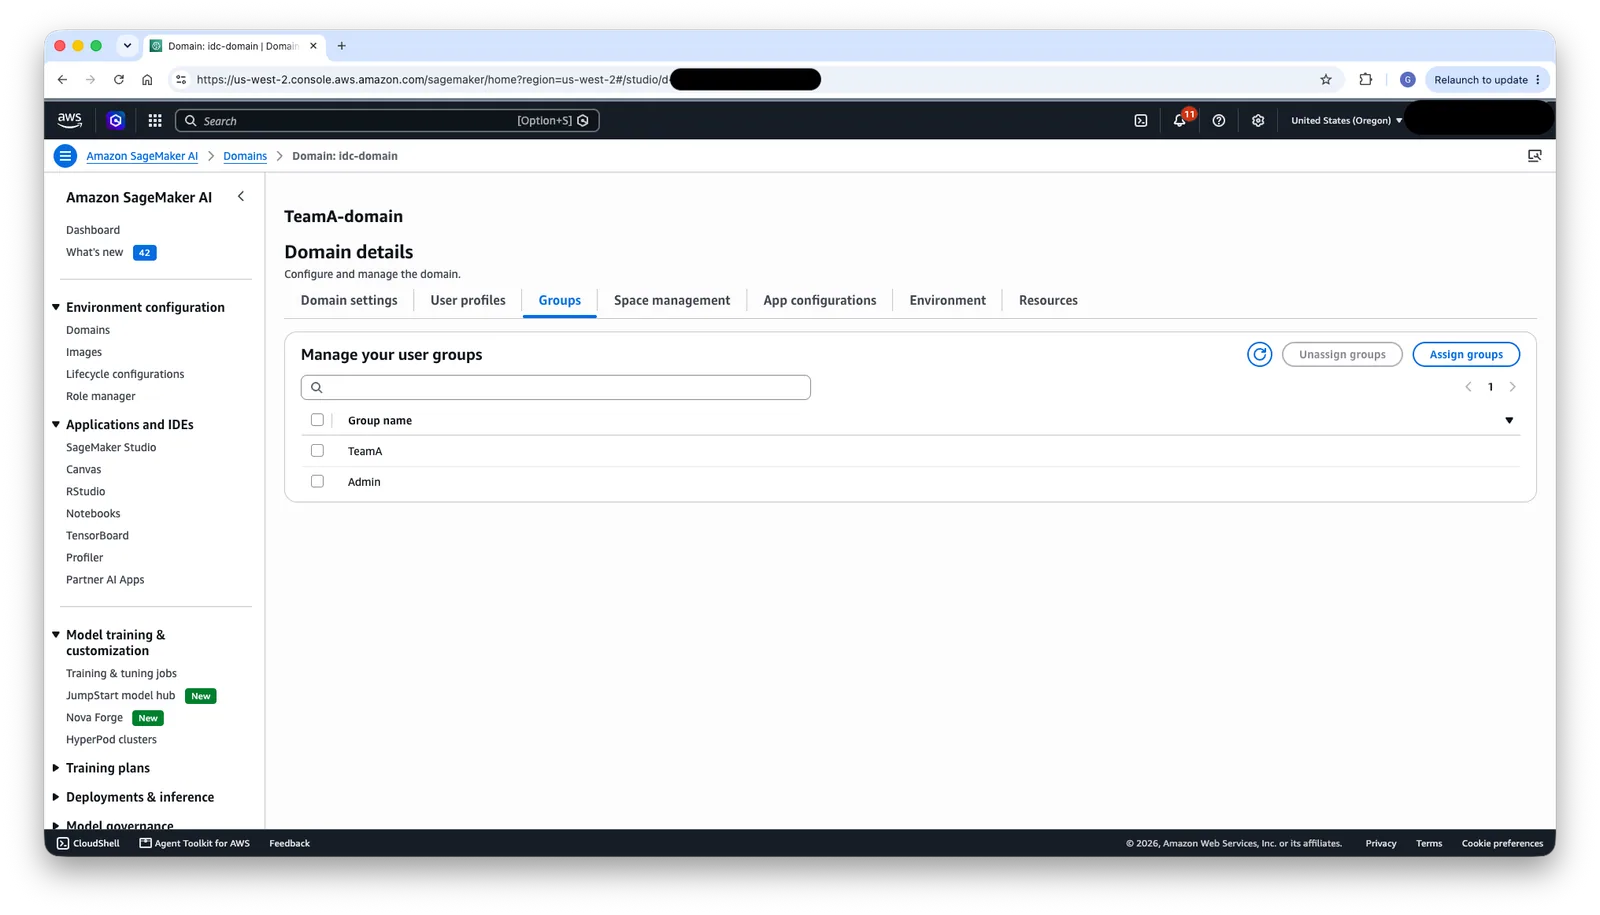
Dalam panduan arsitektur ini, Microsoft Entra ID (dulu Azure AD) dipakai sebagai penyedia identitas eksternal berbasis SAML 2.0. Kamu cukup membuat grup organisasi seperti TeamA, TeamB, dan Admin di dalam Entra ID.
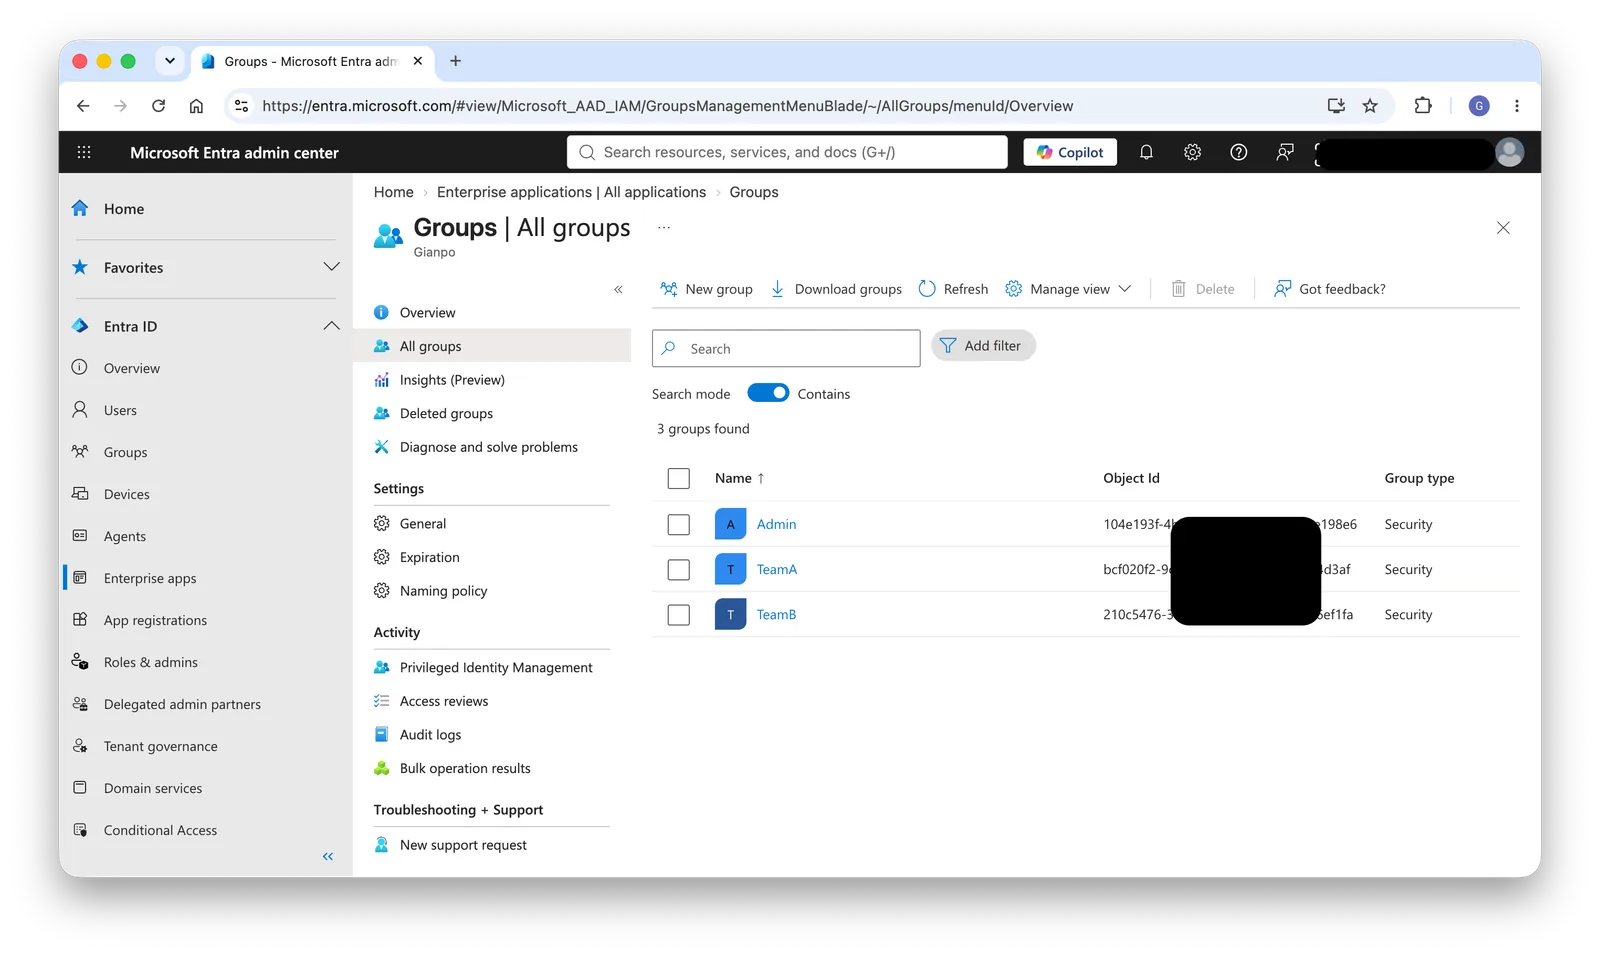
Sinkronisasi pengguna berjalan otomatis menggunakan protokol SCIM (System for Cross-domain Identity Management). Jadi, kalau ada engineer baru masuk ke grup TeamA di Entra ID, akunnya langsung tersinkronisasi ke IAM Identity Center tanpa perlu dibikinkan kredensial manual.
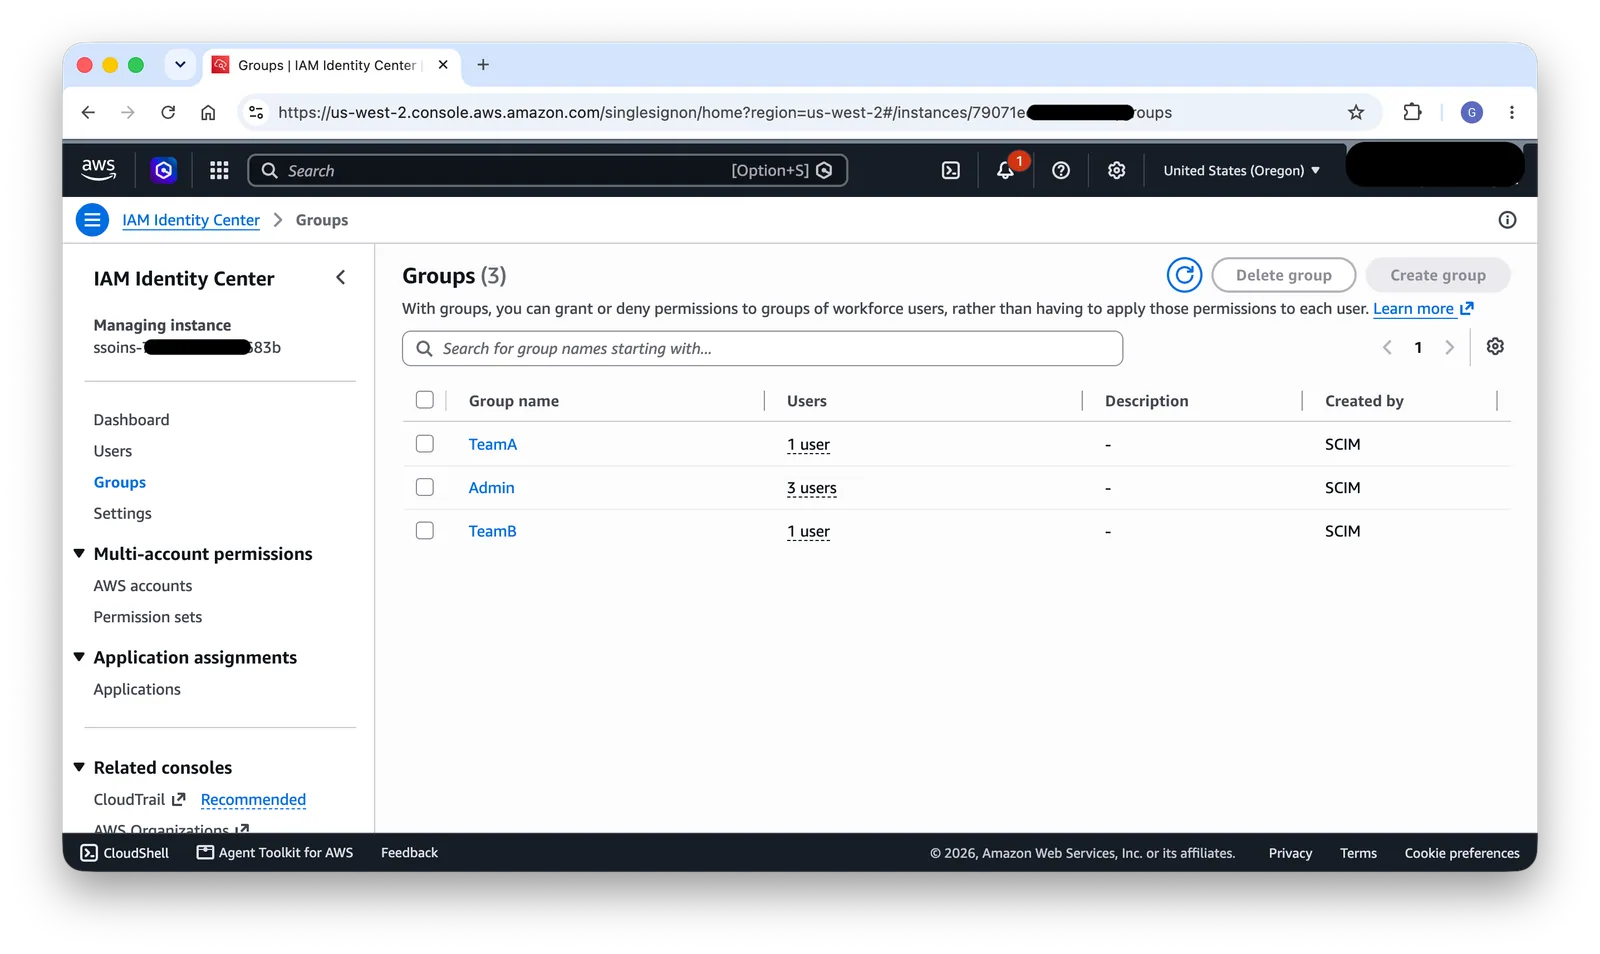
Keuntungan lainnya, IAM Identity Center ini juga jadi syarat utama kalau tim kamu mau mengaktifkan Amazon Managed Grafana buat memantau dashboard cluster.
Otorisasi Berlapis: IAM Role dan Akses CLI
Setelah urusan login beres, tahap berikutnya adalah otorisasi. Di arsitektur ini, kontrol akses dibagi dua: level layanan AWS lewat IAM, dan level cluster lewat Kubernetes RBAC.
Setiap tim punya IAM role tersendiri yang bertindak sebagai execution role domain SageMaker AI. Role ini membatasi akses ke bucket Amazon S3 (hanya prefix tim mereka), log Amazon CloudWatch, serta izin eks:AccessKubernetesApi dan eks:MutateViaKubernetesApi agar GUI SageMaker Studio bisa memanggil API Kubernetes.
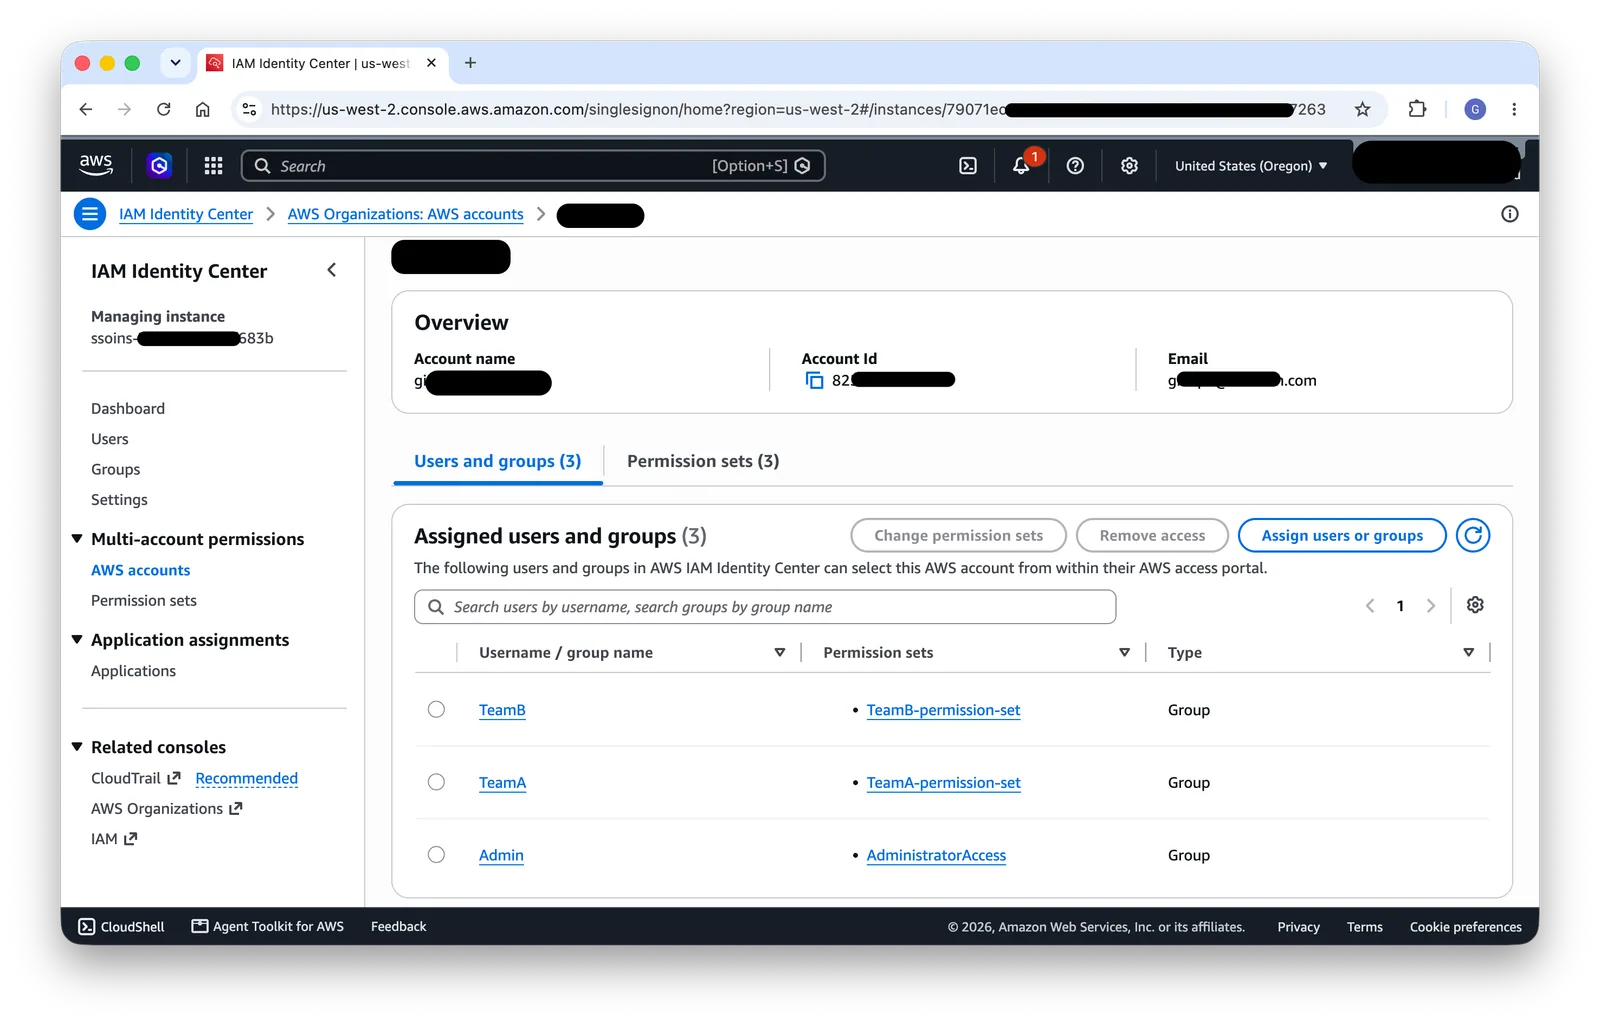
Untuk anggota tim yang lebih suka kerja lewat terminal, administrator menyiapkan permission set terpisah di Identity Center. Konfigurasi CLI diatur lewat berkas ~/.aws/config seperti ini:
[sso-session my-sso]
sso_start_url = https://d-xxxxxxxxxx.awsapps.com/start
sso_region = us-west-2
sso_registration_scopes = sso:account:access

[default]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = OpsAdmin
region = us-west-2

[profile team-a]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = TeamA-permission-set
region = us-west-2

[profile team-b]
sso_session = my-sso
sso_account_id = 123456789012
sso_role_name = TeamB-permission-set
region = us-west-2
Developer tinggal menjalankan perintah aws sso login --profile team-a buat menarik kredensial sementara saat mau mengontrol cluster pakai kubectl.
Membatasi Lingkungan Kerja dengan SageMaker AI Domains
Membuat satu SageMaker AI domain terpisah untuk setiap tim adalah pola standar yang sangat direkomendasikan AWS. Tiap domain mengusung konfigurasi peran eksekusinya sendiri dan langsung terikat ke grup Identity Center tim terkait.
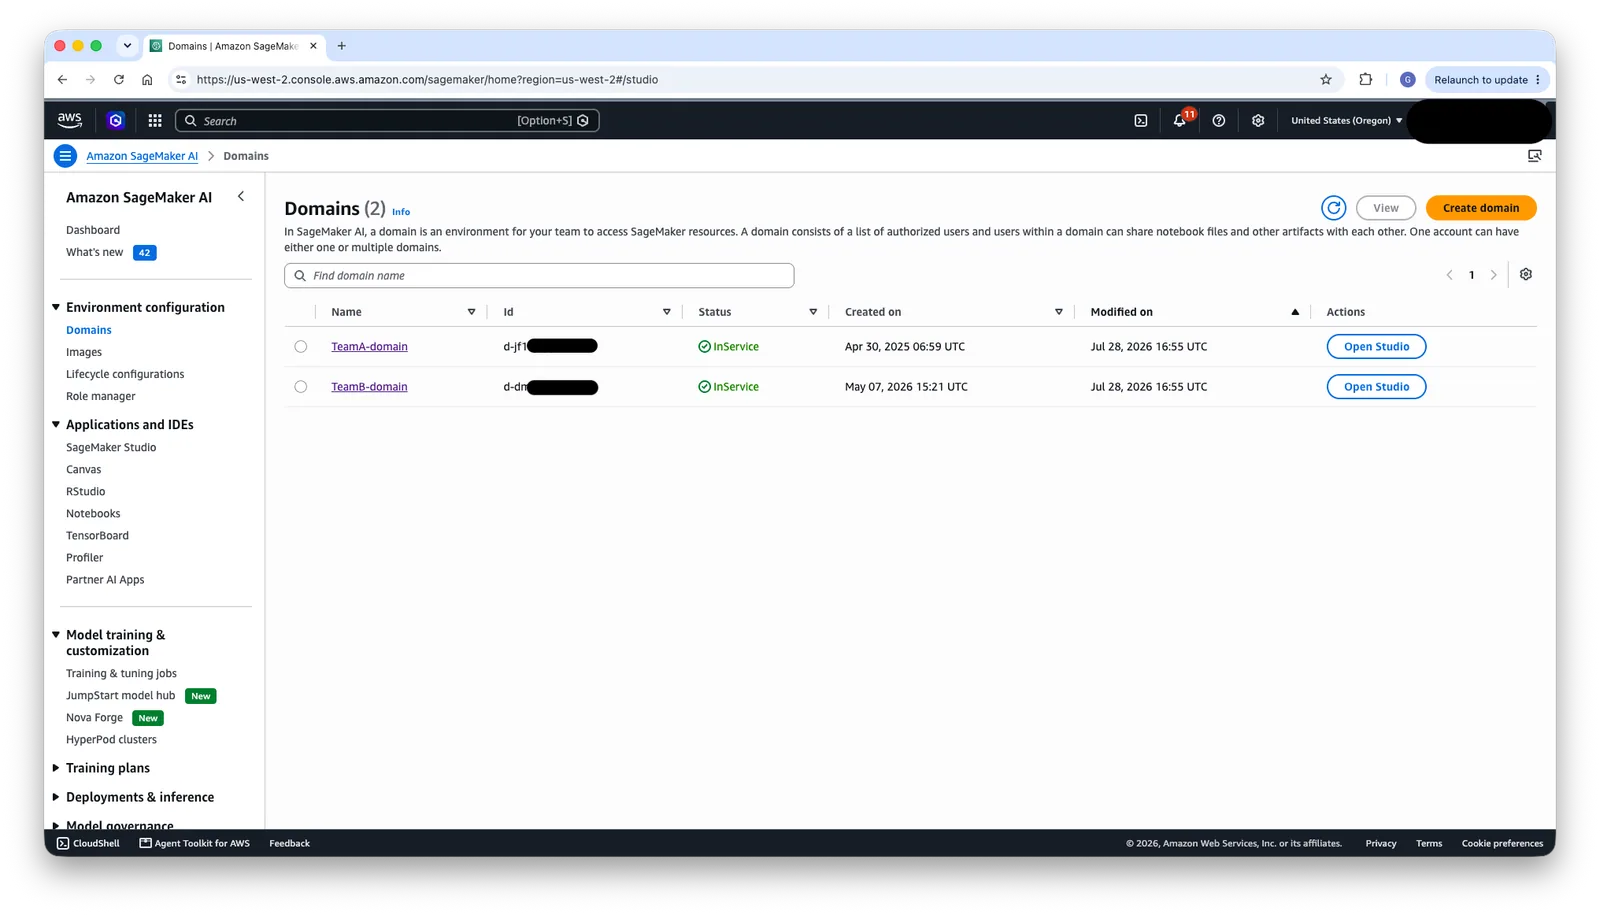
Administrator juga bisa menyesuaikan menu navigasi di dalam domain. Menu-menu yang nggak ada kaitannya dengan HyperPod bisa disembunyikan biar tampilan Studio tetap simpel dan nggak bikin bingung anggota tim.
Isolasi Beban Kerja di HyperPod Kubernetes EKS
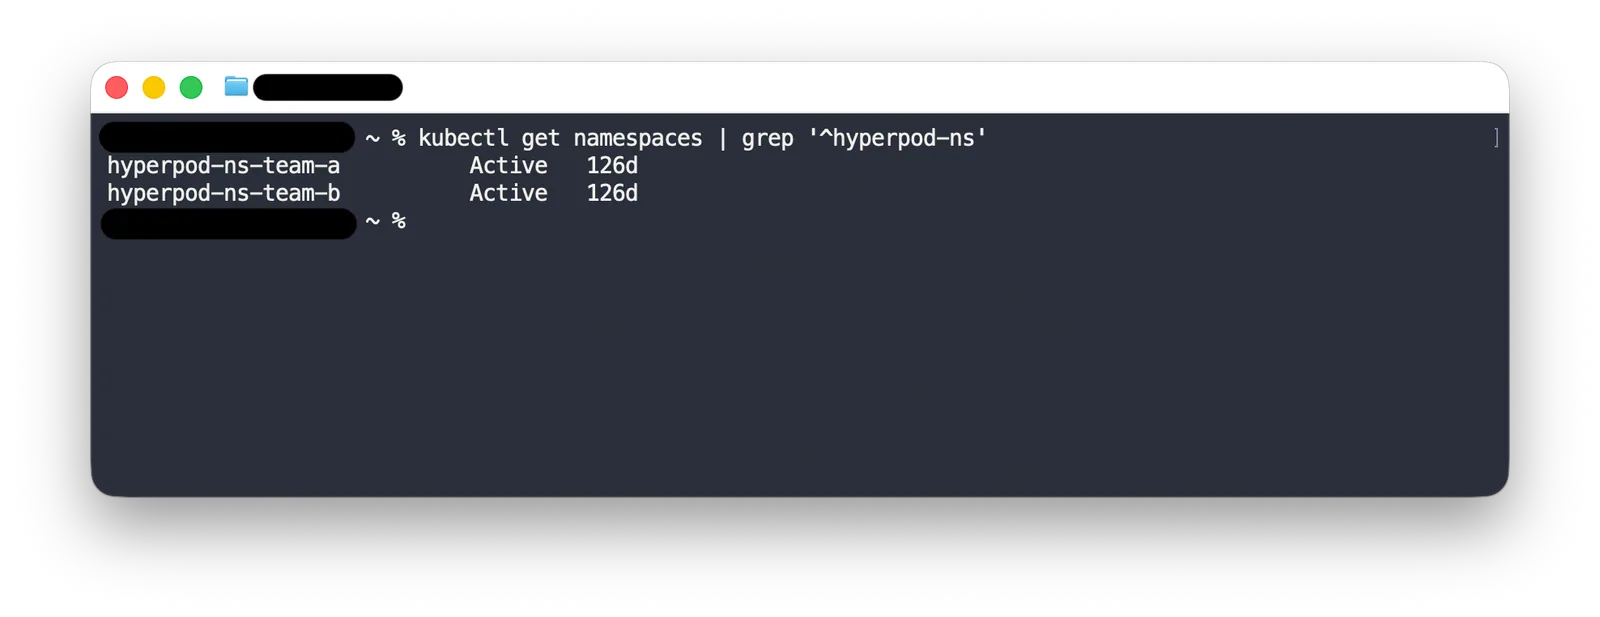
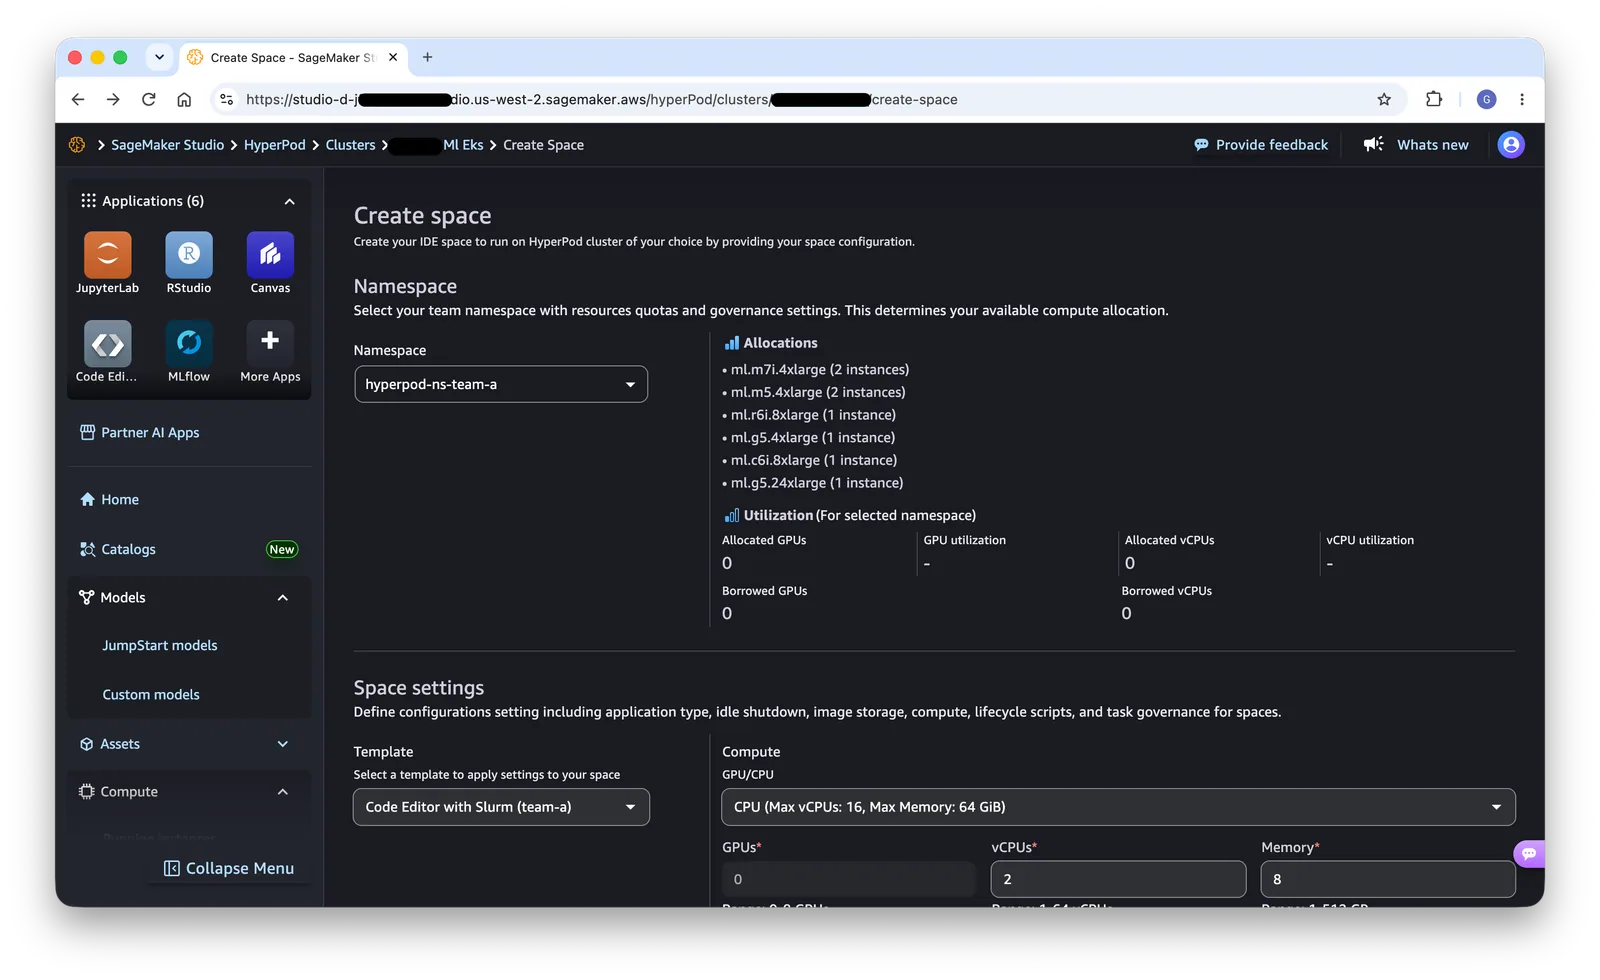
Di tingkat cluster fisik, beban kerja dipisahkan menggunakan namespace Kubernetes, misalnya hyperpod-ns-team-a dan hyperpod-ns-team-b. Namespace ini bisa dibuat manual via kubectl atau di-provision otomatis oleh HyperPod Task Governance.
Isolasi Jaringan Pakai NetworkPolicy
Secara default, jaringan Kubernetes itu datar: pod di satu namespace bisa nge-ping pod di namespace lain. Supaya lalu lintas jaringan terkunci di dalam tim, kamu perlu memasang Kubernetes NetworkPolicy dengan aturan default-deny:
# 1. Tolak semua lalu lintas ingress di namespace tim
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
  namespace: hyperpod-ns-team-a
spec:
  podSelector: {}
  policyTypes:
    - Ingress
---
# 2. Izinkan ingress hanya dari pod di namespace yang sama
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-same-namespace
  namespace: hyperpod-ns-team-a
spec:
  podSelector: {}
  policyTypes:
    - Ingress
  ingress:
    - from:
        - podSelector: {}
Aturan ini mewajibkan CNI cluster kamu mendukung penegakan kebijakan, seperti Amazon VPC CNI dengan fitur network policy aktif.
EKS Access Entries
Untuk menjembatani IAM role AWS dengan RBAC Kubernetes, kamu memakai EKS access entries. Tiap tim butuh dua entri: satu untuk Studio execution role, dan satu lagi untuk CLI role bawaan SSO.
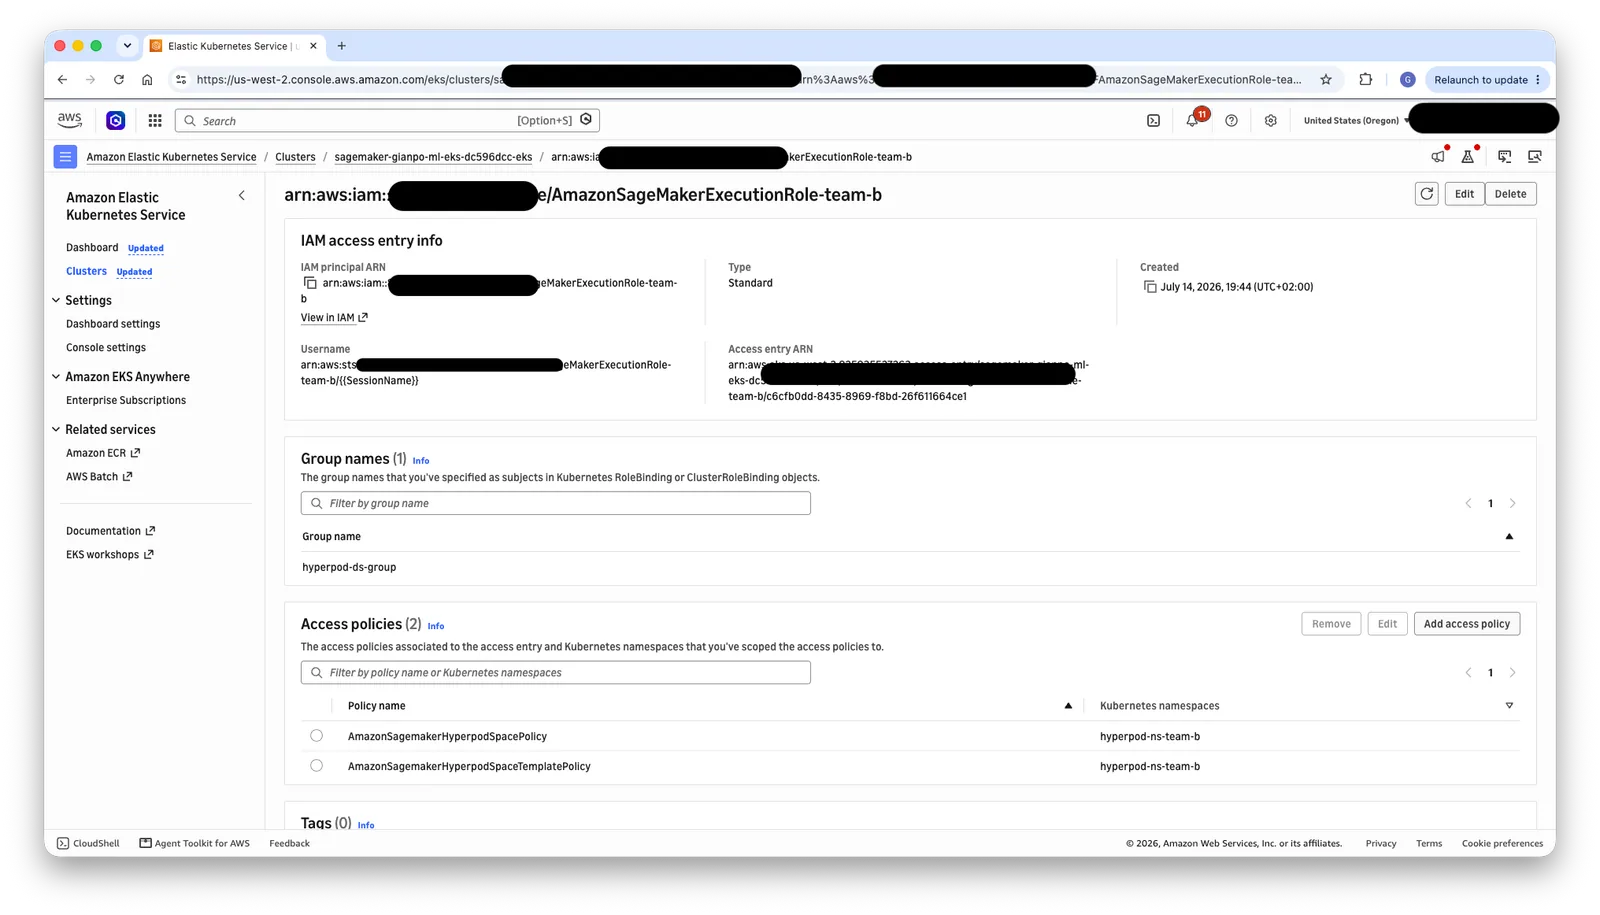
Kedua entri ini dibatasi cakupannya hanya ke namespace tim. Kalau ada developer dari Tim A iseng mengutak-atik resource di namespace Tim B, Kubernetes bakal langsung menolak dengan pesan Forbidden.
Manajemen Kuota HyperPod Task Governance
Masalah paling umum saat berbagi cluster GPU adalah rebutan kapasitas saat jam sibuk. Fitur HyperPod Task Governance hadir untuk membereskan masalah ini secara sistematis.
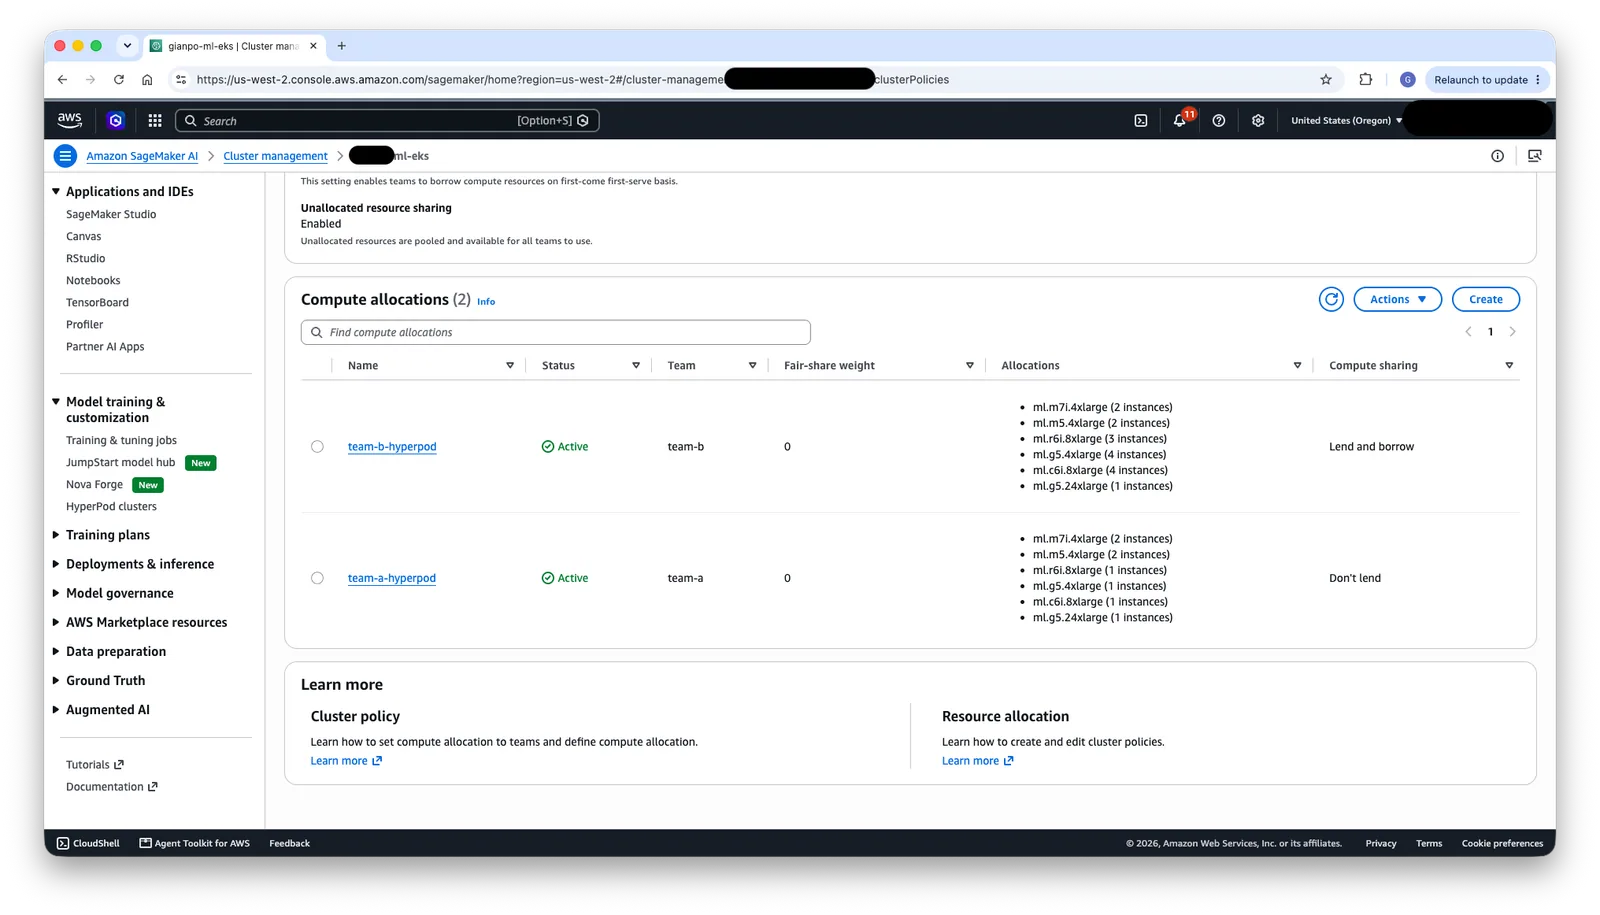
Ada tiga fungsi utama Task Governance yang bikin operasional tenang:
- Compute quotas: Membatasi kuota maksimal GPU dan CPU per tim agar nggak ada yang memonopoli sumber daya.
- Prioritas: Menentukan beban kerja mana yang harus didahulukan. Misalnya, endpoint inferensi produksi bisa menyela (preempt) job pelatihan eksperimen jika kapasitas penuh.
- Fair scheduling: Menghindari sistem siapa cepat dia dapat dengan pembagian antrean yang adil berdasarkan kebijakan yang sudah disetel.
Strategi Penyimpanan: FSx Lustre dan S3
Pelatihan model AI butuh throughput penyimpanan yang luar biasa kencang. Dalam arsitektur ini, penyimpanan dibagi dua kategori:
| Jenis Penyimpanan | Rekomendasi Layanan | Skenario Penggunaan | Model Isolasi |
|---|---|---|---|
| File System POSIX | Amazon FSx for Lustre / OpenZFS / EFS | Dataset pelatihan terdistribusi & checkpoint model | Direktori bersama tim (/fsx/TeamA) & home folder per pengguna (/home/User1) |
| Object Storage | Amazon S3 | Simpanan artefak model, log, & raw dataset | IAM Execution Role & EKS Pod Identity / IRSA |
Untuk file system POSIX, hak akses dikunci memakai UID dan GID Linux. AWS menyarankan pemasangan Kubernetes mutating admission webhook. Webhook ini bertugas mencocokkan identitas pengguna pemanggil dari STS session name, mengambil data UID/GID dari tabel pemetaan (seperti DynamoDB), lalu menempelkannya ke spec.securityContext pod yang dijalankan:
# Contoh logika mutating admission webhook sederhana
def build_security_context_patch(pod, posix):
    return [{
        "op": "add",
        "path": "/spec/securityContext",
        "value": {
            "runAsUser": posix["uid"],
            "runAsGroup": posix["gid"],
            "fsGroup": posix["gid"],
            "supplementalGroups": posix["supplementalGroups"],
        },
    }]
Pengalaman Kerja Tim: Studio, Spaces, dan Visibilitas Biaya
Ketika semua komponen terpasang rapi, alur kerja tim sehari-hari bakal terasa mulus banget. Dari portal akses AWS, pengguna tinggal memilih aplikasi SageMaker Studio atau Amazon Managed Grafana yang sudah ditentukan.
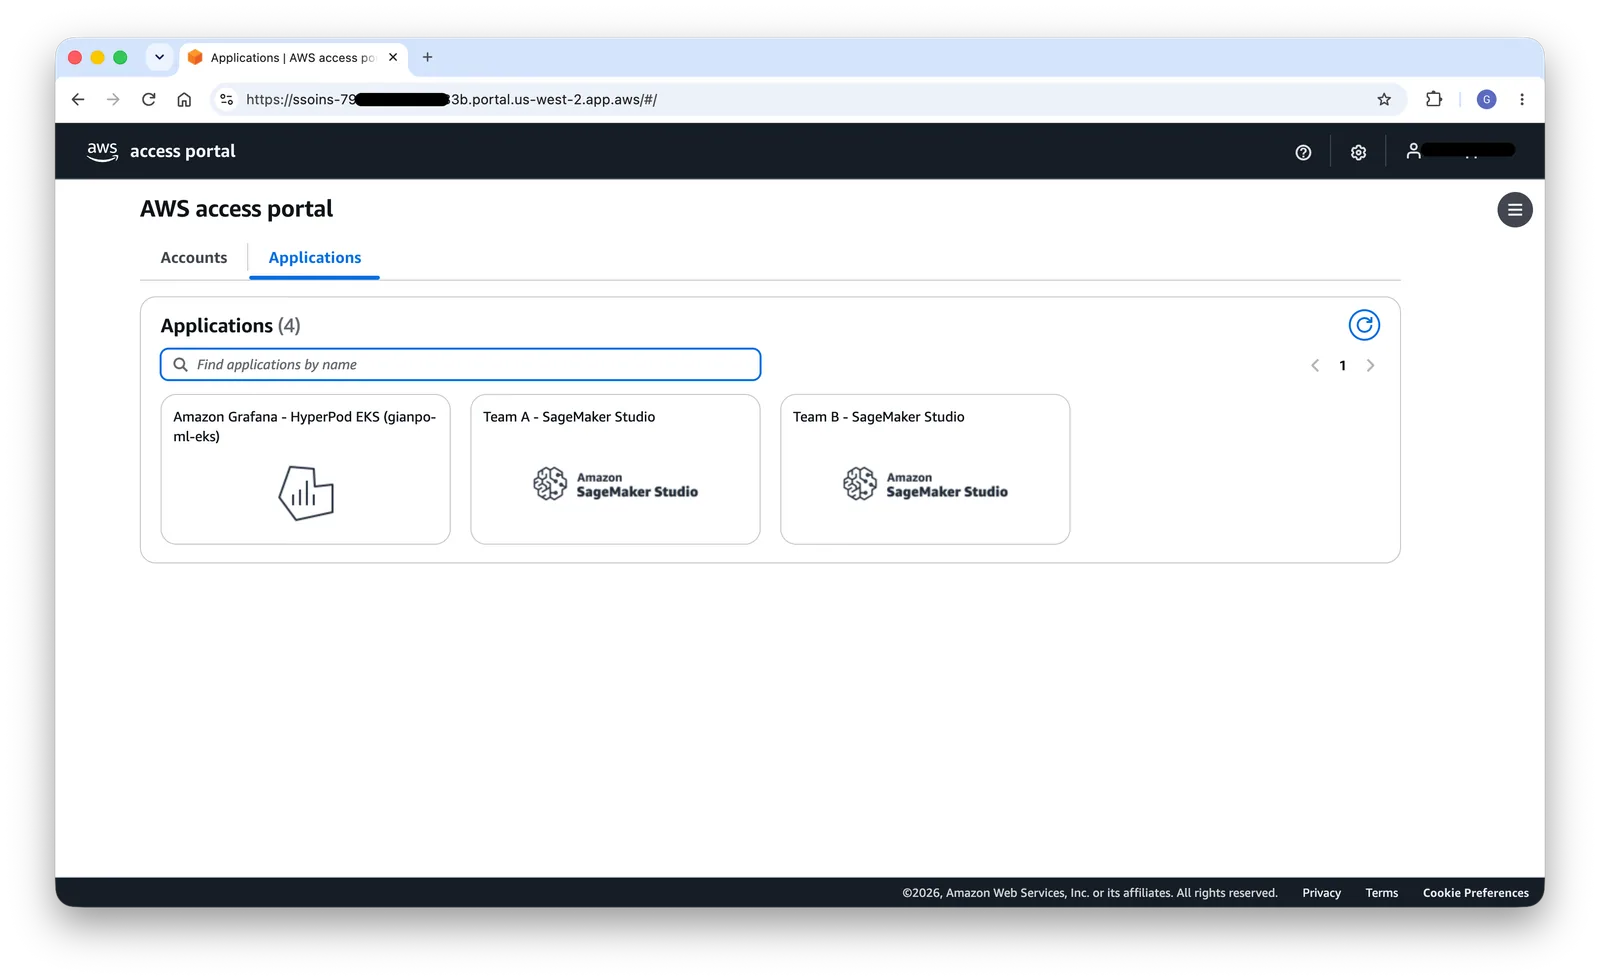
Di dalam SageMaker Studio, anggota tim bisa membuka HyperPod Spaces untuk koding interaktif menggunakan JupyterLab. Administrator menyediakan template Space yang sudah dikunci ke namespace tim dan otomatis ditempeli label Task Governance.
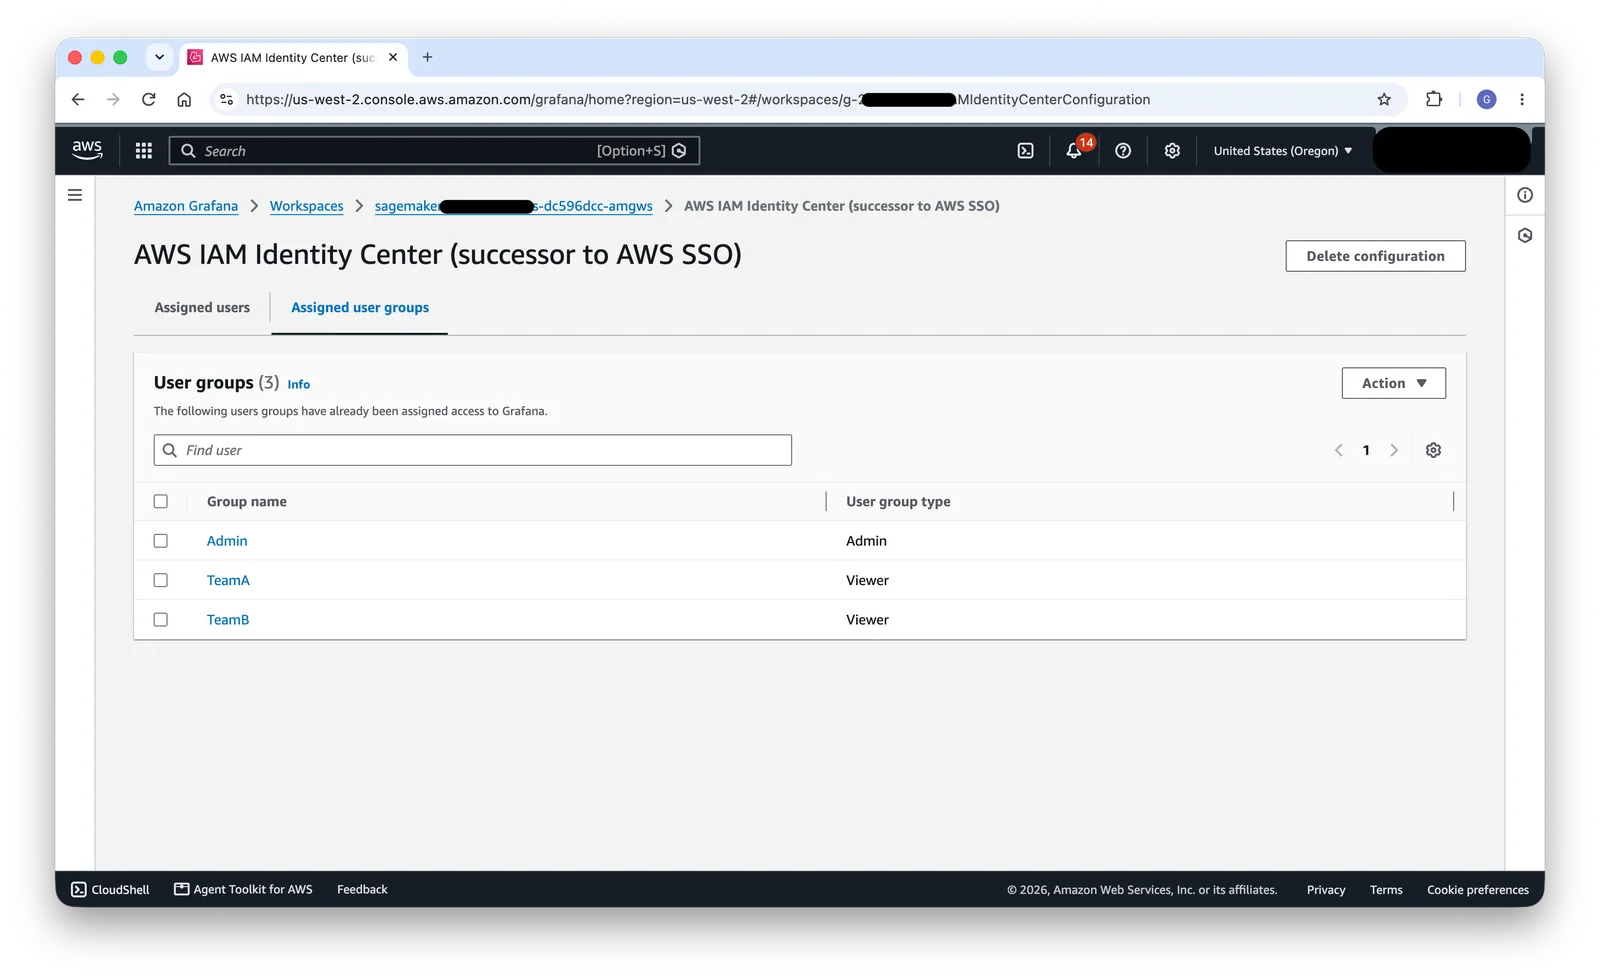
Untuk pemantauan cluster, grup tim dipetakan sebagai Viewer di Amazon Managed Grafana, sementara hak Admin dipegang tim platform ops.
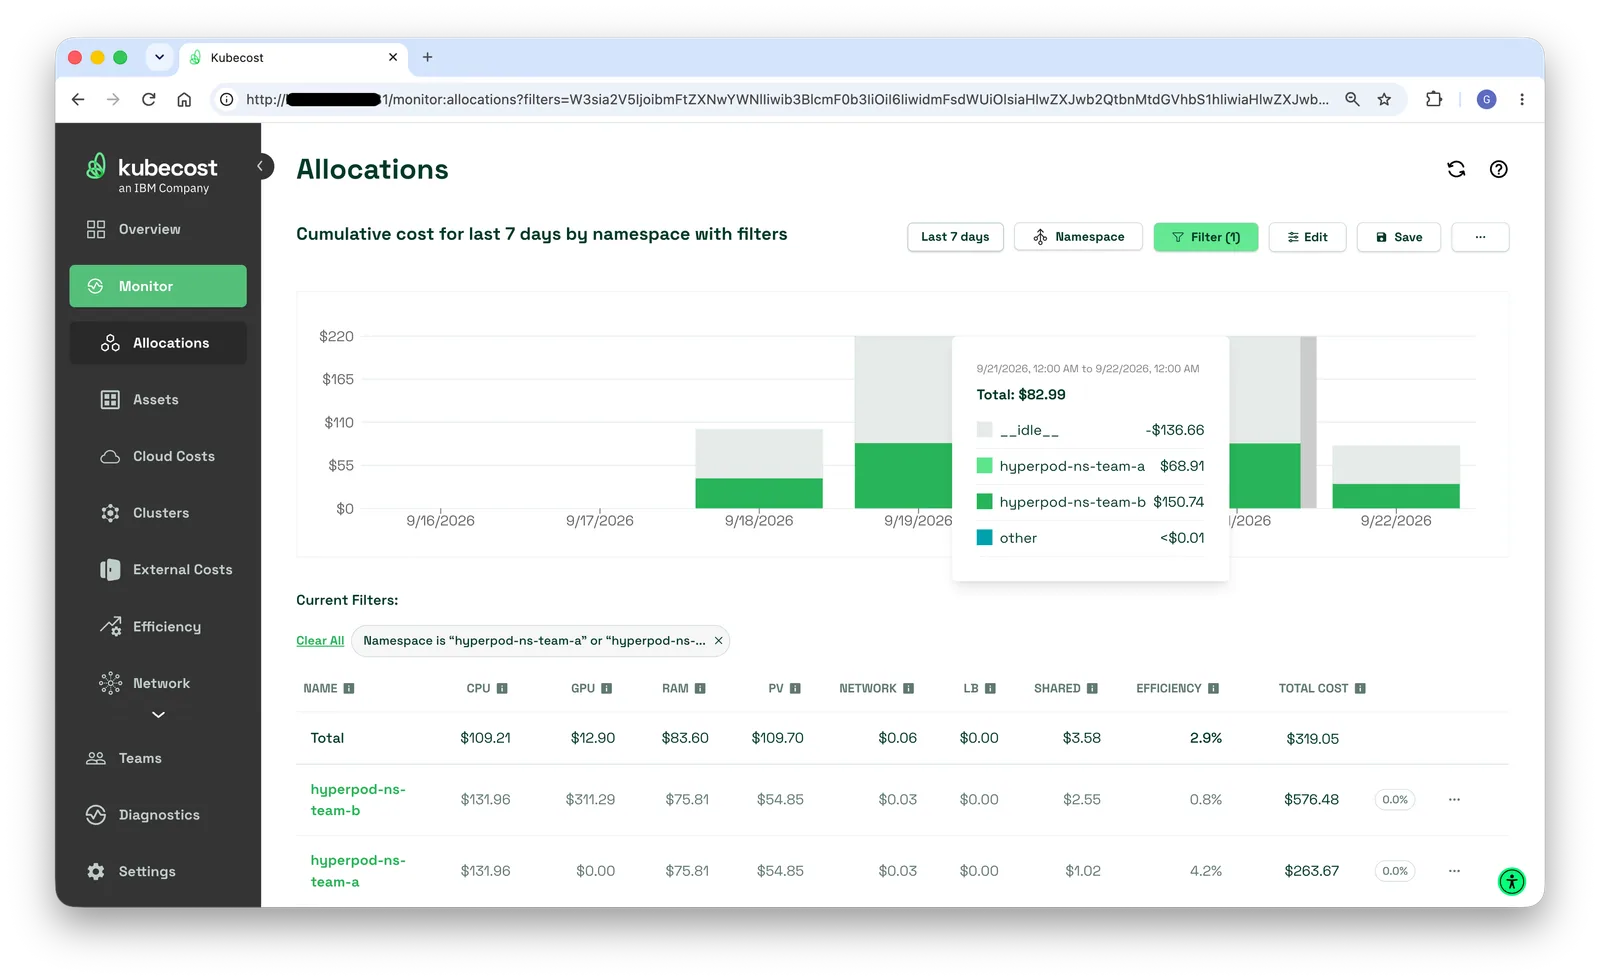
Urusan pembagian tagihan juga jadi transparan. Dengan memasang Kubecost di cluster EKS, pengeluaran komputasi per namespace selama 7 hari bisa langsung kelihatan di dashboard Kubecost Allocations. Jadi, urusan chargeback biaya GPU ke anggaran masing-masing divisi nggak lagi pakai tebak-tebakan.
Dampak Buat Tim Engineering di Indonesia
Bagi perusahaan teknologi, startup, maupun korporasi di Indonesia yang sedang gencar mengembangkan model AI in-house, sewa GPU cloud adalah salah satu komponen biaya paling besar. Membangun cluster terpisah untuk tim data science, tim riset, dan tim produk sering kali bikin anggaran cloud jebol karena utilisasi yang naik-turun.
Dengan pola multi-team ini, perusahaan di Indonesia bisa mengonsolidasikan anggaran komputasi ke dalam satu cluster HyperPod EKS yang dipakai bersama. Pemisahan data lewat namespace, network policy, dan isolasi POSIX storage juga membantu tim IT memenuhi standar tata kelola perlindungan data internal perusahaan tanpa harus mengorbankan kecepatan riset developer.
Kalau tim kamu butuh bereksperimen dengan model-model LLM frontier tanpa repot mengelola cluster GPU sendiri dari nol, kamu bisa memanfaatkan Classai Router. Cukup pakai satu API key yang kompatibel dengan format SDK OpenAI maupun Anthropic, kamu bisa langsung memanggil model seperti DeepSeek V4.1 Flash (Rp160 input / Rp800 output per 1M token), Kimi K3 (Rp4.000 input / Rp5.000 output per 1M token), atau Claude Sonnet 5 (Rp160 input / Rp800 output per 1M token) dengan pembayaran praktis via QRIS dan saldo rupiah tanpa kartu kredit luar negeri.
Sumber & referensi
- 01
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu arsitektur multi-team di Amazon SageMaker HyperPod?
Arsitektur multi-team adalah pola konfigurasi yang membagi satu cluster komputasi GPU HyperPod EKS ke beberapa tim sekaligus secara terisolasi. Pendekatan ini memakai namespace Kubernetes, IAM Identity Center, dan HyperPod Task Governance agar pemakaian adil dan biaya transparan.
Apakah namespace Kubernetes aman untuk memisahkan tim berbeda di HyperPod?
Namespace Kubernetes efektif sebagai batas isolasi antar-tim internal dalam satu organisasi yang memiliki rasa saling percaya. Namun, namespace bukan dinding keamanan mutlak untuk pihak ketiga yang tidak saling percaya karena pod masih berbagi node dan kernel yang sama.
Bagaimana cara HyperPod Task Governance mencegah tim memonopoli GPU?
HyperPod Task Governance menerapkan kuota komputasi ketat dan prioritas penjadwalan pada setiap namespace tim. Jika kapasitas komputasi penuh, tugas dengan prioritas lebih tinggi seperti inferensi produksi dapat menyela tugas eksperimen yang sedang berjalan.
Layanan penyimpanan apa yang paling cocok untuk HyperPod multi-team?
Penyimpanan POSIX seperti Amazon FSx for Lustre atau OpenZFS sangat cocok untuk dataset pelatihan bersama dan checkpoint karena throughput-nya tinggi. Untuk penyimpanan artefak jangka panjang, Amazon S3 digunakan dengan pembatasan hak akses berbasis prefix per tim.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.