AWS Bongkar Cara Fine-Tuning Search Agent di SageMaker
AWS bagiin cara fine-tuning search agent pakai multi-turn RL di Amazon SageMaker AI — tingkat gagalnya turun dari 22,89% jadi cuma 0,68%.
· 10 menit baca
Inti singkat
- AWS pakai multi-turn RL (MTRL) di Amazon SageMaker AI buat fine-tuning search agent berbasis Qwen3.6-27B.
- Hasilnya, nDCG@10 naik sampai +23,7% di BrowseComp-Plus dan +18,4% di WixQA.
- Tingkat gagal si agent turun drastis dari 22,89% jadi 0,68% di BrowseComp-Plus.
- Setup training cuma butuh ubah tiga hyperparameter, sisanya pakai default.
- MTRL dipakai bareng model kecil biar dapet kecepatan dan biaya murah tanpa ngorbanin keandalan.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
AWS baru ngasih panduan lengkap soal cara fine-tuning search agent pakai teknik multi-turn reinforcement learning (MTRL) di Amazon SageMaker AI — dan hasilnya, tingkat gagal si agent turun drastis dari 22,89% jadi cuma 0,68%. Artinya, model kecil yang dilatih dengan cara ini bisa seandal model gede tapi jauh lebih murah dan cepat dipakai.
Menurut blog resmi AWS Machine Learning, tim mereka nyobain fine-tuning model Qwen3.6-27B jadi search agent yang bisa milih sendiri mau pakai lexical search atau vector search, berapa kali harus nyari ulang, dan kapan harus berhenti. Biasanya ini susah dilatih karena butuh contoh percakapan ideal yang jarang ada. AWS nunjukin jalan lain yang katanya lebih masuk akal.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu Search Agent dan Kenapa Susah Dilatih?
Search agent itu sistem berbasis LLM yang nggak cuma nunggu kamu nulis query sempurna. Dia sendiri yang nentuin mau nyari apa, pakai strategi pencarian apa, dan kapan berhenti nyari — semuanya lewat beberapa ronde interaksi, sambil ngulik ulang pendekatannya berdasarkan hasil yang udah ketemu.
Masalahnya, bikin perilaku multi-langkah kayak gini jalan dengan bener itu susah. Nggak ada model dasar yang langsung ngerti tools dan environment kamu. Kalau kamu prompt model kecil, hasilnya sering nggak konsisten di tengah-tengah proses multi-turn. Kalau prompt model frontier yang gede, biasanya kerja, tapi kamu bayar mahal lewat latensi dan biaya.
Fine-tuning jadi jalan ketiga: kamu ajarin model kecil soal tools dan environment kamu langsung. Hasilnya, kecepatan dan biaya model kecil, tapi keandalan yang biasanya cuma bisa didapat dari model frontier.
Sayangnya, cara lama juga ada celahnya. Supervised fine-tuning (SFT) butuh contoh trayektori multi-turn ideal yang mahal dikumpulin dan jarang ada buat kasus spesifik kamu. Single-turn reinforcement learning kayak RLVR cuma nilai satu respons sekaligus, padahal search agent bikin keputusan yang saling berkaitan di tiap ronde. Nilai satu langkah doang bikin hubungan antar-langkah itu keliatan hilang.
Fine-Tuning Search Agent di Amazon SageMaker AI itu Apa Sih?
Di sinilah multi-turn RL (MTRL) masuk. Teknik ini ngelatih agent buat bikin keputusan bagus di sepanjang rangkaian langkah, bukan cuma satu langkah doang. Reward-nya cuma perlu nunjukin apakah hasil akhirnya bagus atau nggak — nggak perlu dirinciin tiap langkah.
Amazon SageMaker AI MTRL ngasih beberapa hal penting buat nerapin ini:
- Interface agent-environment modular — kamu bisa definiin reward custom, loop tool custom, dan bentuk percakapan multi-turn sendiri dengan integrasi low-code.
- Eksekusi serverless — kamu dapet RL agentic skala produksi dengan harga per-token, tanpa perlu nyiapin atau ngurus cluster GPU sendiri.
- Rollout dan pengumpulan trayektori asinkron — generation dan update gradient jalan paralel, jadi training tetep cepat tanpa terlalu jauh dari policy yang sekarang.
- Library algoritma native — ada PPO, CISPO, dan importance-sampling losses, dipadu estimator advantage berbasis grup kayak GRPO, GRPO pass@k, dan RLOO.
- Training yang bisa dilanjutin (resumable) — training panjang bisa dibagi ke beberapa job biar nggak kena limit waktu satu job.
- Observabilitas trayektori dan reward — kamu bisa ngecek apa yang dilakuin agent tiap turn dan tiap langkah training lewat MLflow yang dikelola SageMaker AI.
- Evaluation job — kamu bisa liat reward, pass@k, dan metrik trayektori sebelum deploy ke endpoint SageMaker AI atau Amazon Bedrock.
Kenapa cocok buat search agent? Karena ada reward yang jelas (kualitas retrieval), ada loop interaksi multi-turn (agent nanya terus terima hasil), dan environment yang jelas definisinya (tools pencarian). Kalau kamu mau paham lebih dalem soal konsep API dan endpoint yang dipakai di sini, artikel kami soal API AI bisa jadi pemanasan.
Cara AWS Nyetting Eksperimen Fine-Tuning LLM Ini
AWS pakai model Qwen3.6-27B yang tersedia di region US West (Oregon), dan ngasih dia dua tools:
- Lexical search (BM25) — buat nyari kecocokan kata kunci persis, pas buat query dengan istilah atau identifier spesifik.
- Vector search — ngubah query dan dokumen jadi embedding vector lalu ngitung kesamaan, direkomendasiin buat query yang sifatnya semantik atau konseptual.
Jumlah turn (satu ronde interaksi user-assistant) dibatasi, biar agent nggak ngasih respons kepanjangan dan tetep efisien nyarinya.
Buat data latihan, mereka pakai enam dataset: FRAMES (QA multi-hop lintas artikel Wikipedia), BRIGHT (retrieval yang butuh penalaran di 12 domain), Enterprise RAG (500 ribuan dokumen sintetis perusahaan), ESCI (data pencarian produk multibahasa), Musique (QA multi-hop dari pertanyaan single-hop), dan MLQA (QA ekstraktif lintas bahasa). Buat tes, mereka pakai empat dataset lain yang nggak dipakai saat training: FreshStack, WixQA, BrowseComp-Plus, dan Wands.
Metrik utamanya nDCG@10 (Normalized Discounted Cumulative Gain di rank 10) — ngukur seberapa bagus 10 dokumen teratas yang diambil cocok sama urutan ideal. Skor 1,0 artinya rankingnya sempurna, 0,0 artinya nggak ada dokumen relevan yang ketemu. Skor ini langsung dipakai sebagai reward function di level trayektori — jadi reward-nya dihitung setelah agent nyelesain seluruh pencarian multi-turn-nya.
Kalau agent kena limit turn maksimal atau limit token di satu turn, dia dapet reward -1. Cara ini efektif ngajarin model buat ngehindarin kegagalan tanpa perlu bikin reward perantara yang ribet.
Soal konfigurasi job, AWS cuma ubah tiga hyperparameter dan sisanya pakai default:
from sagemaker.modules.train import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
 model_id="qwen3.6-27b",
 agent_endpoint="<your-agent-endpoint>",
 training_dataset_s3_uri="s3://amzn-s3-demo-bucket/datasets/train/",
 validation_dataset_s3_uri="s3://amzn-s3-demo-bucket/datasets/validation/",
 hyperparameters={
 "max_epochs": 1,
 "global_batch_size": 128,
 "rollout_max_concurrency": 32,
 },
 output_s3_uri="s3://amzn-s3-demo-bucket/output/",
)

trainer.train()
Tiga hyperparameter yang diubah cuma max_epochs (berapa kali lewatin seluruh data training), global_batch_size (jumlah prompt per langkah training), dan rollout_max_concurrency (berapa rollout yang jalan paralel saat ngumpulin trayektori). Pilihan algoritma, estimator advantage, sampai batas off-policy staleness, semuanya tetep pakai default.
Hasil Fine-Tuning: Search Agent Makin Jitu dan Jarang Gagal
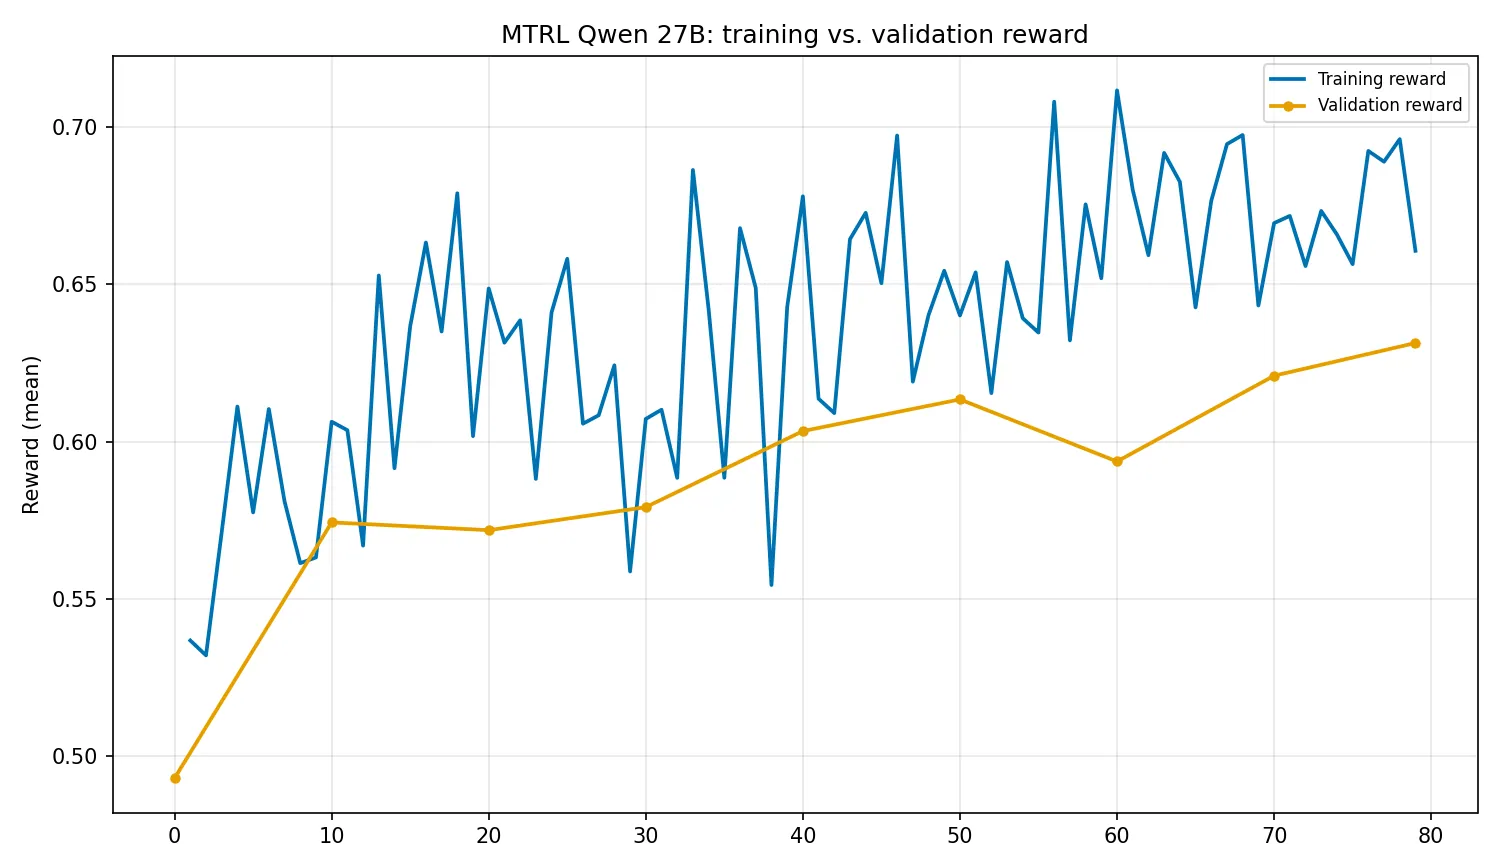
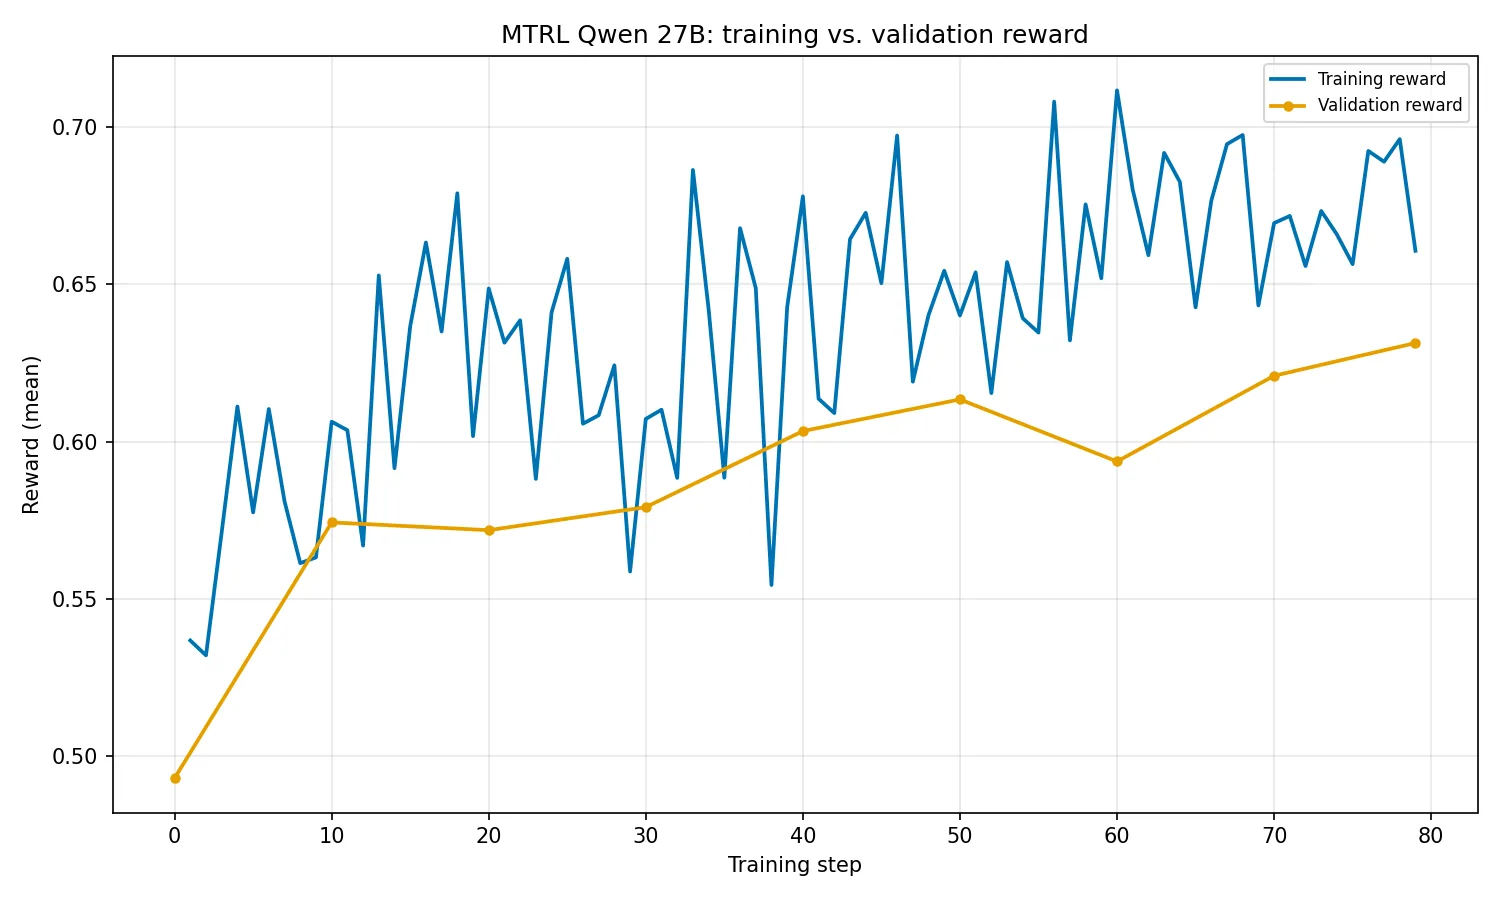
Selama training, reward (nDCG@10) di data training dan validasi dipantau terus. Dua kurva ini naik stabil sebelum akhirnya mendatar di akhir training — tanda kalau nambah training lagi kemungkinan udah nggak banyak ngubah apa-apa.
Hasil akhirnya dibandingin antara model asli Qwen3.6-27B sama versi yang udah di-fine-tune, di empat dataset tes:
| Benchmark | Jumlah Soal | Model | nDCG@10 | Tingkat Gagal | Rata-rata Turn |
|---|---|---|---|---|---|
| WixQA | 400 | Qwen3.6-27B | 0,5725 | 0,67% | 4,3 |
| WixQA | 400 | Qwen3.6-27B (fine-tune) | 0,6781 | 0,17% | 4,5 |
| Wands | 147 | Qwen3.6-27B | 0,5762 | 0,00% | 2,2 |
| Wands | 147 | Qwen3.6-27B (fine-tune) | 0,6112 | 0,00% | 2,9 |
| FreshStack | 672 | Qwen3.6-27B | 0,4112 | 0,20% | 3,1 |
| FreshStack | 672 | Qwen3.6-27B (fine-tune) | 0,4089 | 0,05% | 2,8 |
| BrowseComp-Plus | 830 | Qwen3.6-27B | 0,5136 | 22,89% | 7,0 |
| BrowseComp-Plus | 830 | Qwen3.6-27B (fine-tune) | 0,6354 | 0,68% | 6,3 |
MTRL bikin kualitas pencarian naik di tiga dari empat benchmark: WixQA naik 18,4% (0,5725 → 0,6781), BrowseComp-Plus naik 23,7% (0,5136 → 0,6354), dan Wands naik 6% (0,5762 → 0,6112). Di FreshStack malah turun sedikit (0,4112 → 0,4089) — jadi nggak semua kasus otomatis membaik.
Yang paling kerasa justru soal keandalan. Di BrowseComp-Plus, tingkat gagal turun dari 22,89% jadi cuma 0,68%. Artinya agent nggak cuma belajar nyari lebih bagus, tapi juga belajar nyelesain tugas dalam batas turn dan token yang dikasih — dampak langsung dari penalti -1 yang didesain buat ngajarin model ngehindarin kegagalan.
Fine-Tuning LLM vs Prompting Model Gede: Mana yang Lebih Masuk Akal?
Kalau kamu lagi mikir, "ngapain repot fine-tuning, tinggal prompt model gede aja kan jalan?" — jawabannya emang bisa jalan, tapi ada ongkosnya. Prompt model frontier biasanya ngasih hasil yang reliable, tapi kamu bayar lebih di latensi dan biaya per request, apalagi kalau search agent kamu dipanggil ribuan kali sehari.
Fine-tuning LLM kecil pakai MTRL nawarin trade-off yang beda: kamu investasiin waktu training sekali, dapet model yang ngerti tools dan environment kamu secara spesifik, lalu inference-nya jadi lebih cepet dan murah buat jangka panjang. Buat kasus kayak search agent enterprise yang dipanggil terus-terusan, ini kemungkinan lebih masuk akal secara biaya operasional — meski tetep butuh effort awal buat nyiapin dataset dan reward function.
Cara Mulai Nyoba Multi-Turn RL buat Search Agent Kamu Sendiri
AWS ngasih beberapa langkah awal kalau kamu mau nerapin pendekatan ini:
- Baca dulu dokumentasi Amazon SageMaker AI MTRL buat paham cara kerja dan opsi konfigurasinya.
- Siapin dataset training dan validasi dalam format yang diperlukan, lalu upload ke Amazon S3.
- Deploy agent endpoint yang ngasih akses ke tools pencarian kamu (BM25, vector search, atau tools lain), dan definiin reward function berdasarkan metrik task spesifik kamu — nDCG@10 kayak contoh di atas, atau metrik lain yang relevan.
- Mulai dengan konfigurasi default dulu — sesuai pengalaman AWS, default ini udah cukup bagus buat start.
- Evaluasi hasilnya pakai evaluation job, cek trayektori lewat MLflow, lalu iterasi kalau perlu.
Kalau training panjang kena limit waktu (default 24 jam, bisa diubah lewat CreateJob JSON schema), kamu bisa lanjutin dari checkpoint sebelumnya tanpa mulai dari nol lagi.
Kalau kamu lagi nulis script reward function atau kode Python buat eksperimen kayak gini, bisa dibantu model coding dulu lewat Classai Router — misalnya Kimi K2.7 Code (Rp3.700/Rp6.000 per 1 juta token input/output) atau DeepSeek V4 Pro (Rp2.000/Rp4.000) buat draf kode awal sebelum dites beneran di SageMaker.
Saya mau bikin reward function buat search agent pakai nDCG@10, dengan penalti -1 kalau agent kena limit turn atau token maksimal. Tolong bikinin skeleton kode Python-nya pakai dokumen ground truth dan hasil retrieval sebagai input, lengkap dengan komentar penjelasan tiap bagian.Keterbatasan yang Perlu Kamu Tahu
Bukan berarti MTRL selalu bikin semua angka naik. Di FreshStack, nDCG@10 malah turun sedikit (0,4112 → 0,4089), meski tingkat gagalnya tetep membaik (0,20% → 0,05%). Artinya hasil fine-tuning bisa beda-beda tergantung karakteristik dataset dan task-nya.
Setup di studi ini juga spesifik: dua tools (BM25 dan vector search), satu model base (Qwen3.6-27B), dan environment enterprise search. Kalau kasus kamu beda — tools-nya lebih banyak, atau domainnya jauh beda dari dataset yang dipakai AWS — hasilnya bisa aja beda juga. Training MTRL juga butuh waktu (bisa berhari-hari) dan tetep ada biaya infrastruktur selama proses rollout dan training jalan, meski modelnya serverless dan dibayar per-token.
Dampak Buat Developer dan Bisnis di Indonesia
Buat tim developer di Indonesia yang lagi bangun search agent — buat customer support, pencarian produk e-commerce, atau RAG internal perusahaan — pendekatan ini kasih opsi baru selain cuma pasrah pakai model frontier yang mahal. Kalau volume request kamu udah tinggi, fine-tuning model kecil pakai MTRL bisa jadi cara nurunin biaya inference jangka panjang tanpa ngorbanin kualitas pencarian.
Sifat serverless dari SageMaker AI MTRL juga ngurangin hambatan teknis — tim nggak perlu provisioning atau ngurus cluster GPU sendiri, cukup bayar per-token selama training. Ini relevan buat perusahaan menengah yang pengen eksperimen RL tanpa harus punya tim infra khusus.
Kalau kamu baru mulai eksplorasi dunia search agent dan RAG, artikel kami soal konversi sales pakai AI bandit di Amazon SageMaker juga bisa jadi referensi lain soal gimana AWS nerapin machine learning buat kasus bisnis nyata.
Untuk soal keamanan data, karena setup ini jalan di infrastruktur AWS milik kamu sendiri (bukan layanan pihak ketiga yang nyimpen data kamu), kontrol data tetep ada di tangan tim kamu — tapi tetep perlu dicek sendiri kebijakan region dan compliance yang relevan buat data perusahaan, apalagi kalau nyangkut data pelanggan sesuai aturan UU PDP di Indonesia.
Sumber & referensi
- 01
AWS · 2 Oktober 2026
Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu search agent dalam konteks AI?
Search agent adalah sistem berbasis LLM yang nyari sendiri informasi lewat beberapa ronde pencarian, bukan cuma nunggu query sempurna dari user. Dia milih strategi pencarian, ngulang kalau hasilnya belum pas, dan nentuin sendiri kapan harus berhenti nyari.
Apa itu multi-turn RL (MTRL) dan bedanya sama fine-tuning biasa?
MTRL adalah teknik reinforcement learning yang ngelatih agent berdasarkan hasil akhir dari seluruh rangkaian interaksi, bukan cuma satu respons tunggal. Beda sama supervised fine-tuning yang butuh contoh percakapan ideal, MTRL cukup butuh reward di akhir trayektori, kayak skor nDCG@10 di studi AWS ini.
Apakah fine-tuning search agent di Amazon SageMaker AI mahal?
Sumber AWS nggak nyebut harga spesifik, tapi MTRL di SageMaker AI jalan serverless dengan skema bayar per-token, jadi kamu nggak perlu provisioning cluster GPU sendiri. Biaya pastinya tergantung ukuran dataset, jumlah epoch, dan lama training.
Model apa yang dipakai AWS buat fine-tuning search agent ini?
AWS pakai model Qwen3.6-27B yang dilatih jadi search agent dengan dua tools pencarian, yaitu lexical search (BM25) dan vector search. Model ini dipilih karena ukurannya relatif kecil tapi bisa dilatih biar seandal model yang lebih gede.
Gimana cara mulai nyoba multi-turn RL buat proyek sendiri?
Mulai dengan baca dokumentasi resmi Amazon SageMaker AI MTRL, siapin dataset training dalam format yang ditentukan, deploy agent endpoint dengan reward function sesuai metrik task kamu, lalu jalanin training pakai konfigurasi default dulu sebelum iterasi lebih jauh.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.