AutoSynthData: ServiceNow Bikin AI Belajar dari Kegagalannya
ServiceNow bikin AutoSynthData, sistem yang otomatis bikin data latihan dari kegagalan agen AI biar makin jago di sistem internal perusahaan—nggak cuma pintar secara umum.
· 10 menit baca
Inti singkat
- AutoSynthData bikinan ServiceNow CoreAI, sistem yang bikin data latihan sendiri buat agen AI enterprise dari kegagalan model.
- Di eksperimen domain Hybrid, Pass@1 naik 7,2 poin (35% relatif) dan nutup 59% gap ke model referensi.
- Di domain ITSM, Pass@1 naik dari 18,77% jadi 27,18% pakai DeepSeek-V4.1-Flash sebagai teacher.
- Tiap task sintetis dicek lewat verifikasi positif, negatif, dan repair sebelum dipakai buat training.
- Target latihan terus bergerak—task yang udah dikuasai model nggak lagi berguna buat siklus belajar selanjutnya.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
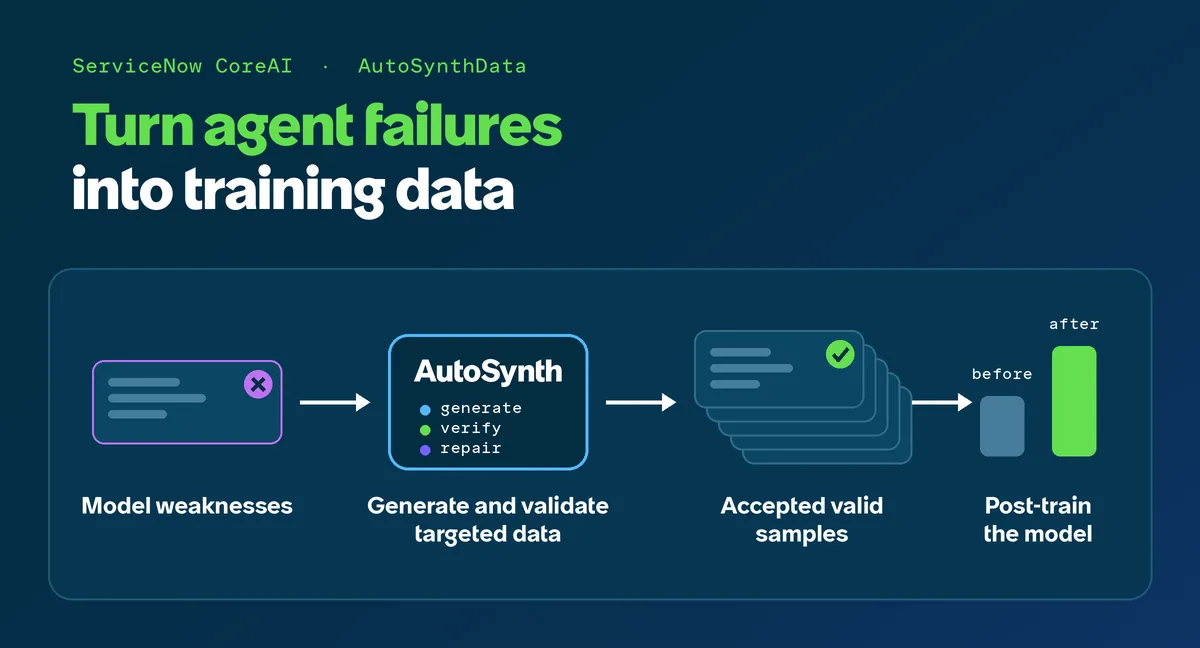
AutoSynthData, sistem bikinan tim ServiceNow CoreAI, bisa bikin data latihan sendiri buat ngajarin agen AI enterprise biar makin jago ngerjain tugas yang tadinya sering gagal mereka kerjain. Caranya: liat dulu di mana agen itu sering gagal, minta model yang lebih pintar (disebut teacher) buat nunjukin cara benernya, lalu generate ribuan task baru yang mirip biar si agen makin terlatih di kasus-kasus itu.
Buat kamu yang kerja di dunia developer atau lagi ngulik agen AI buat kantor, pengumuman resmi tim ServiceNow-AI di Hugging Face ini menarik dibahas. Soalnya masalah yang mereka coba selesain emang kerasa banget: model AI yang pintar secara umum, begitu dipasang di sistem internal perusahaan—dengan aturan, tools, dan data yang beda-beda tiap tempat—sering jadi oon. Nah, gimana caranya ngasih "pelajaran tambahan" yang pas buat tiap perusahaan? Itu yang dijawab AutoSynthData.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu AutoSynthData dan Kenapa Agen AI Enterprise Butuh Latihan Khusus?
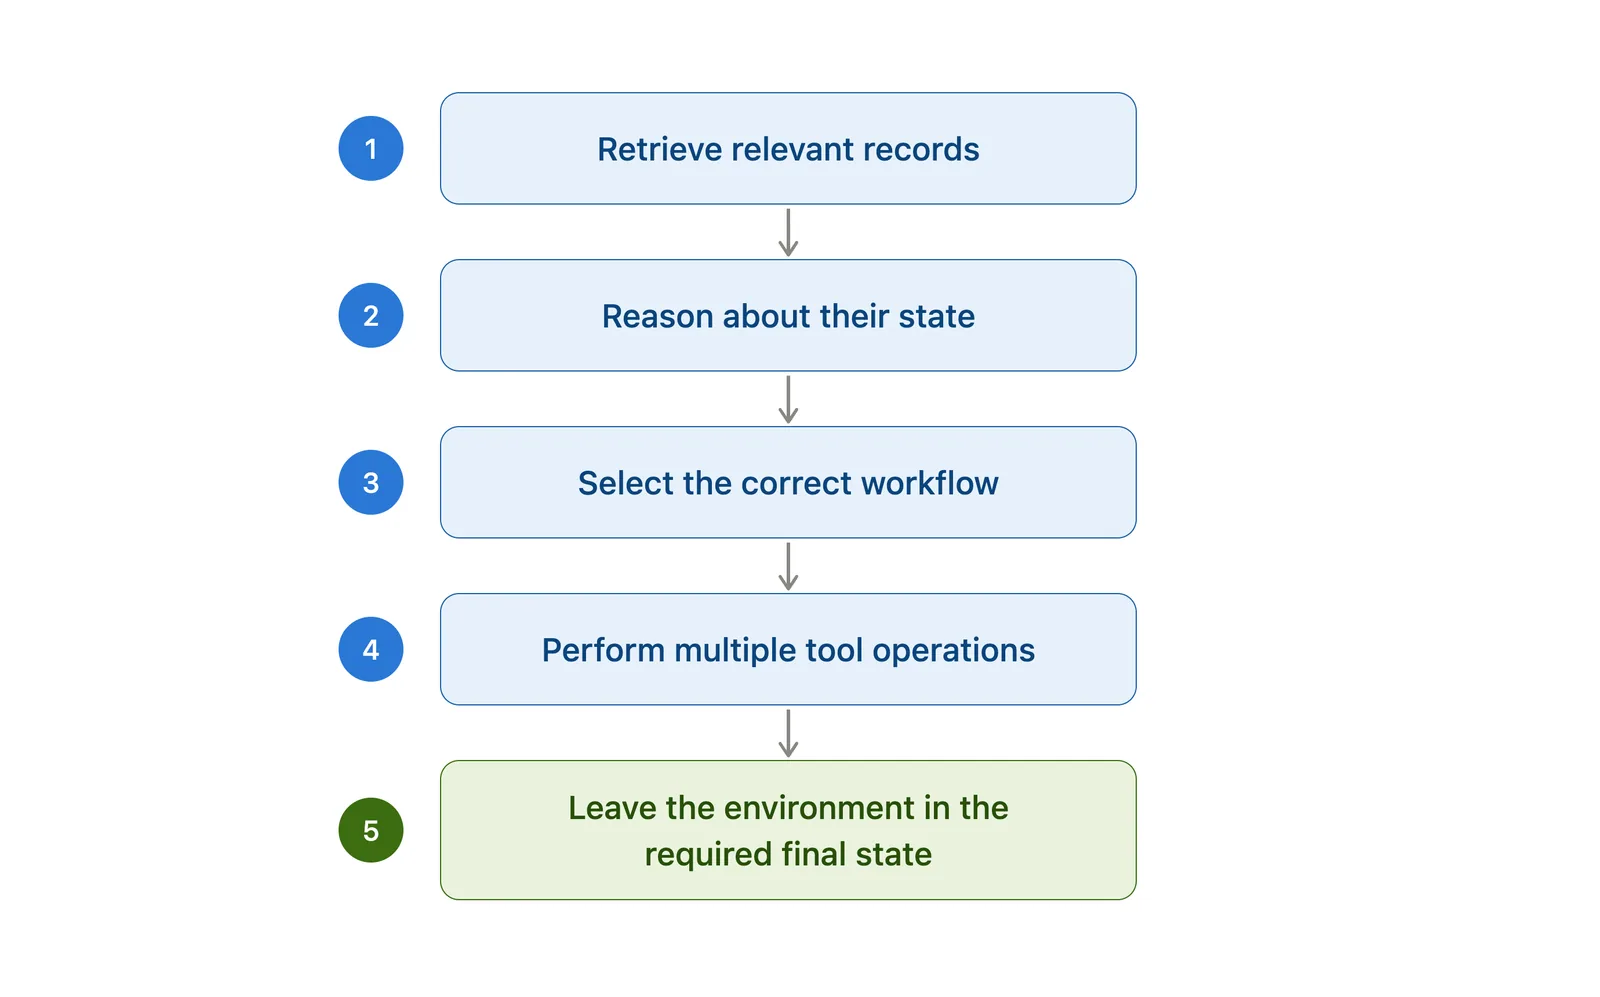
Model AI yang kelihatannya capable secara umum bisa aja struggle di environment tertentu: ada workflow yang ditangani asal-asalan, kombinasi tools yang salah dipakai, atau aturan perusahaan yang malah dilanggar. Masalahnya bukan cuma "model-nya kurang pintar", tapi gimana ubah kelemahan spesifik itu jadi data latihan yang beneran berguna.
Satu kegagalan cuma ngasih tahu satu hal doang. Buat ngelatih model, kamu butuh banyak variasi task yang ngelatih kemampuan yang sama di situasi berbeda. Tiap task itu juga harus memenuhi tiga hal: bisa dikerjain di environment-nya (feasible), mirip permintaan yang beneran bakal diminta user (realistis), dan ada cara pasti buat ngecek berhasil atau nggak (verifier).
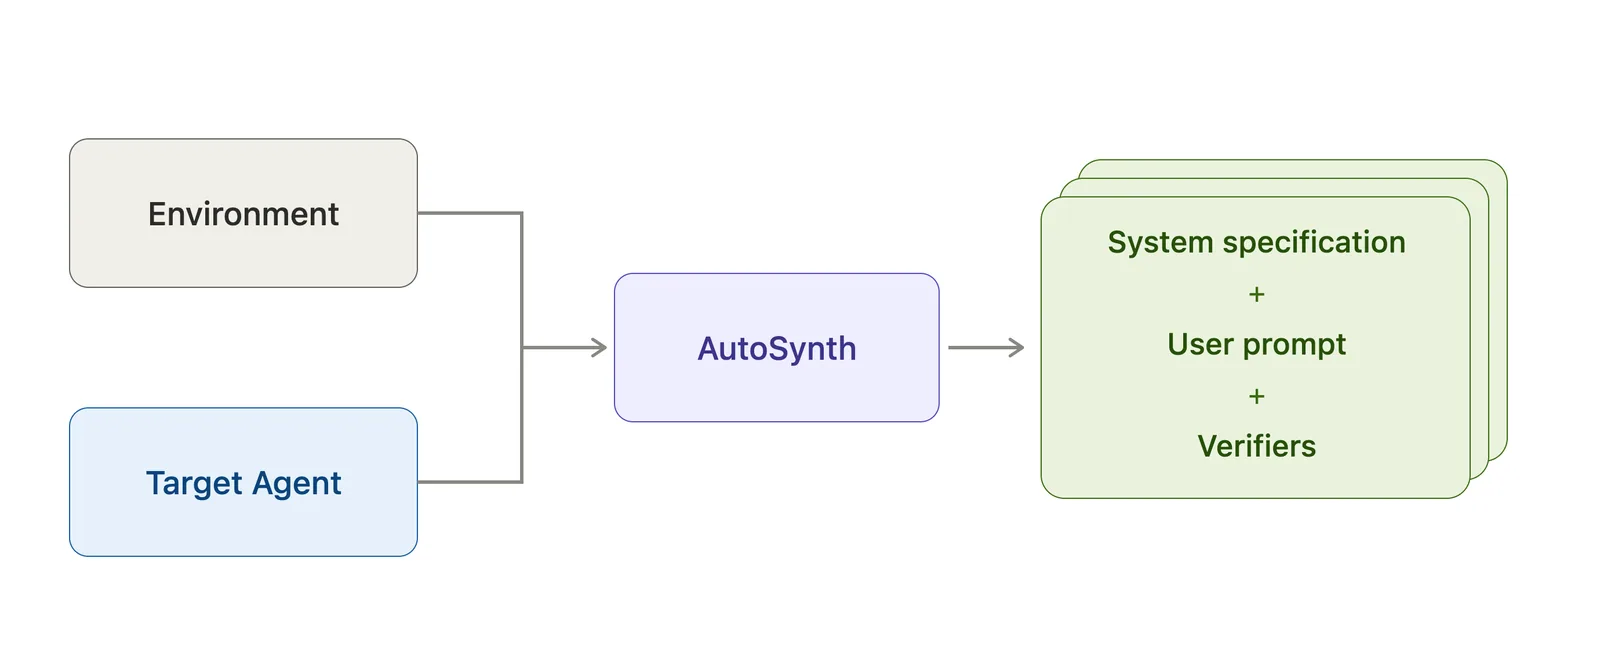
AutoSynthData ngerumusin satu task sebagai tiga komponen: spesifikasi sistem (aturan dan kondisi environment), prompt dari sisi user (apa yang diminta), dan verifier (penentu berhasil-tidaknya). Ketiganya harus nyambung—verifier yang kebanyakan ngasih sukses bakal ngajarin perilaku salah, sementara verifier yang terlalu ketat malah nolak jawaban yang sebenarnya bener.
Gimana AutoSynthData Ngubah Kegagalan Jadi Data Latihan?
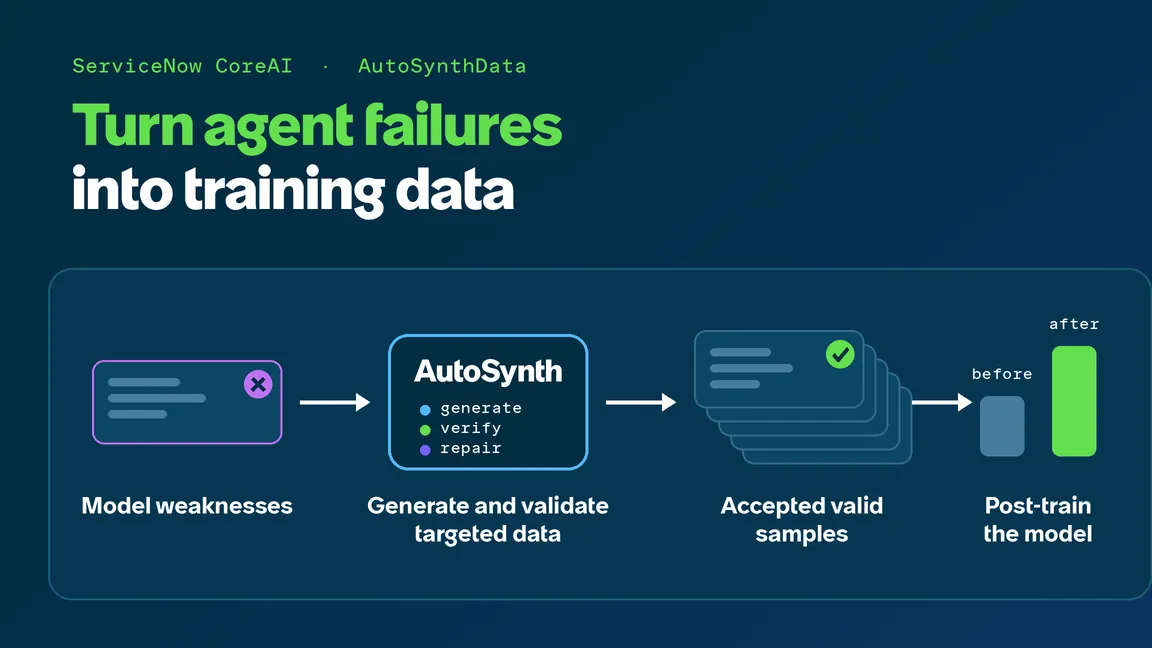
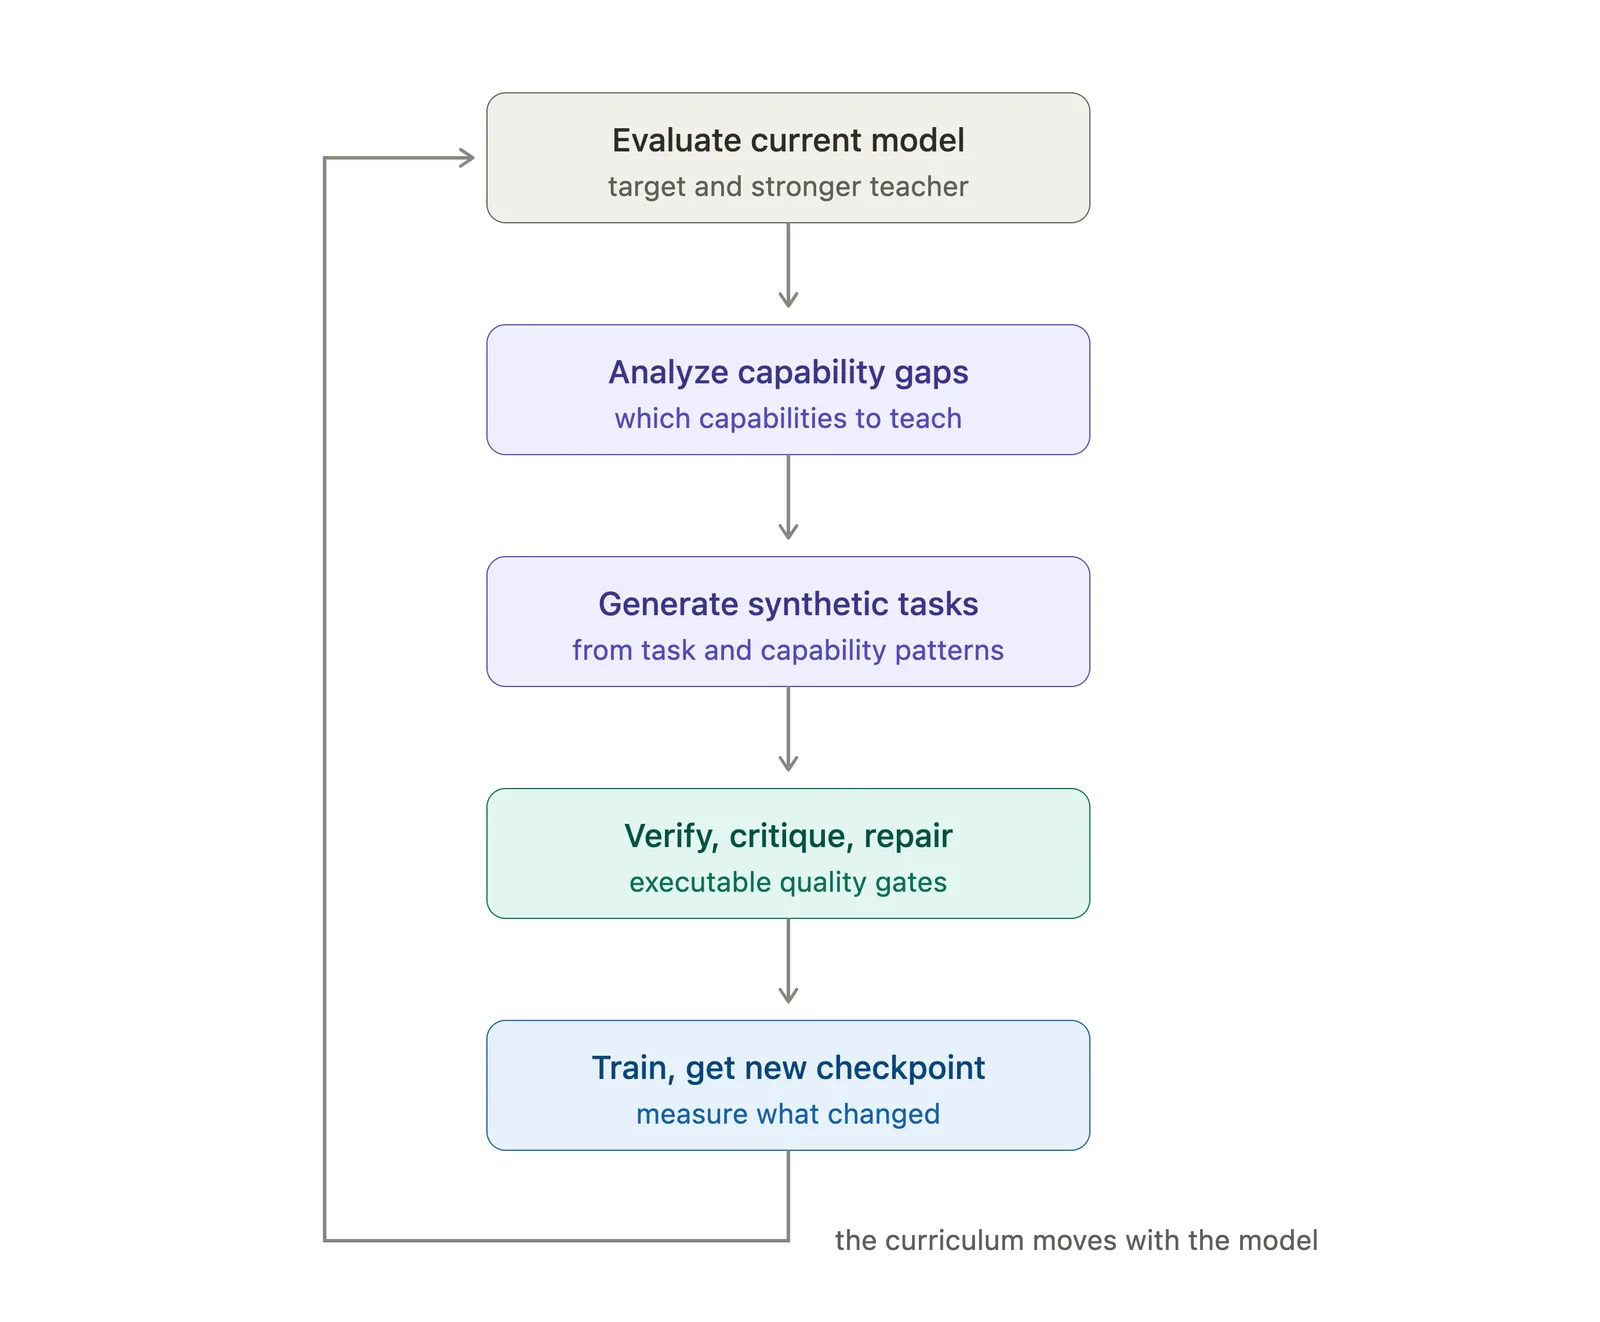
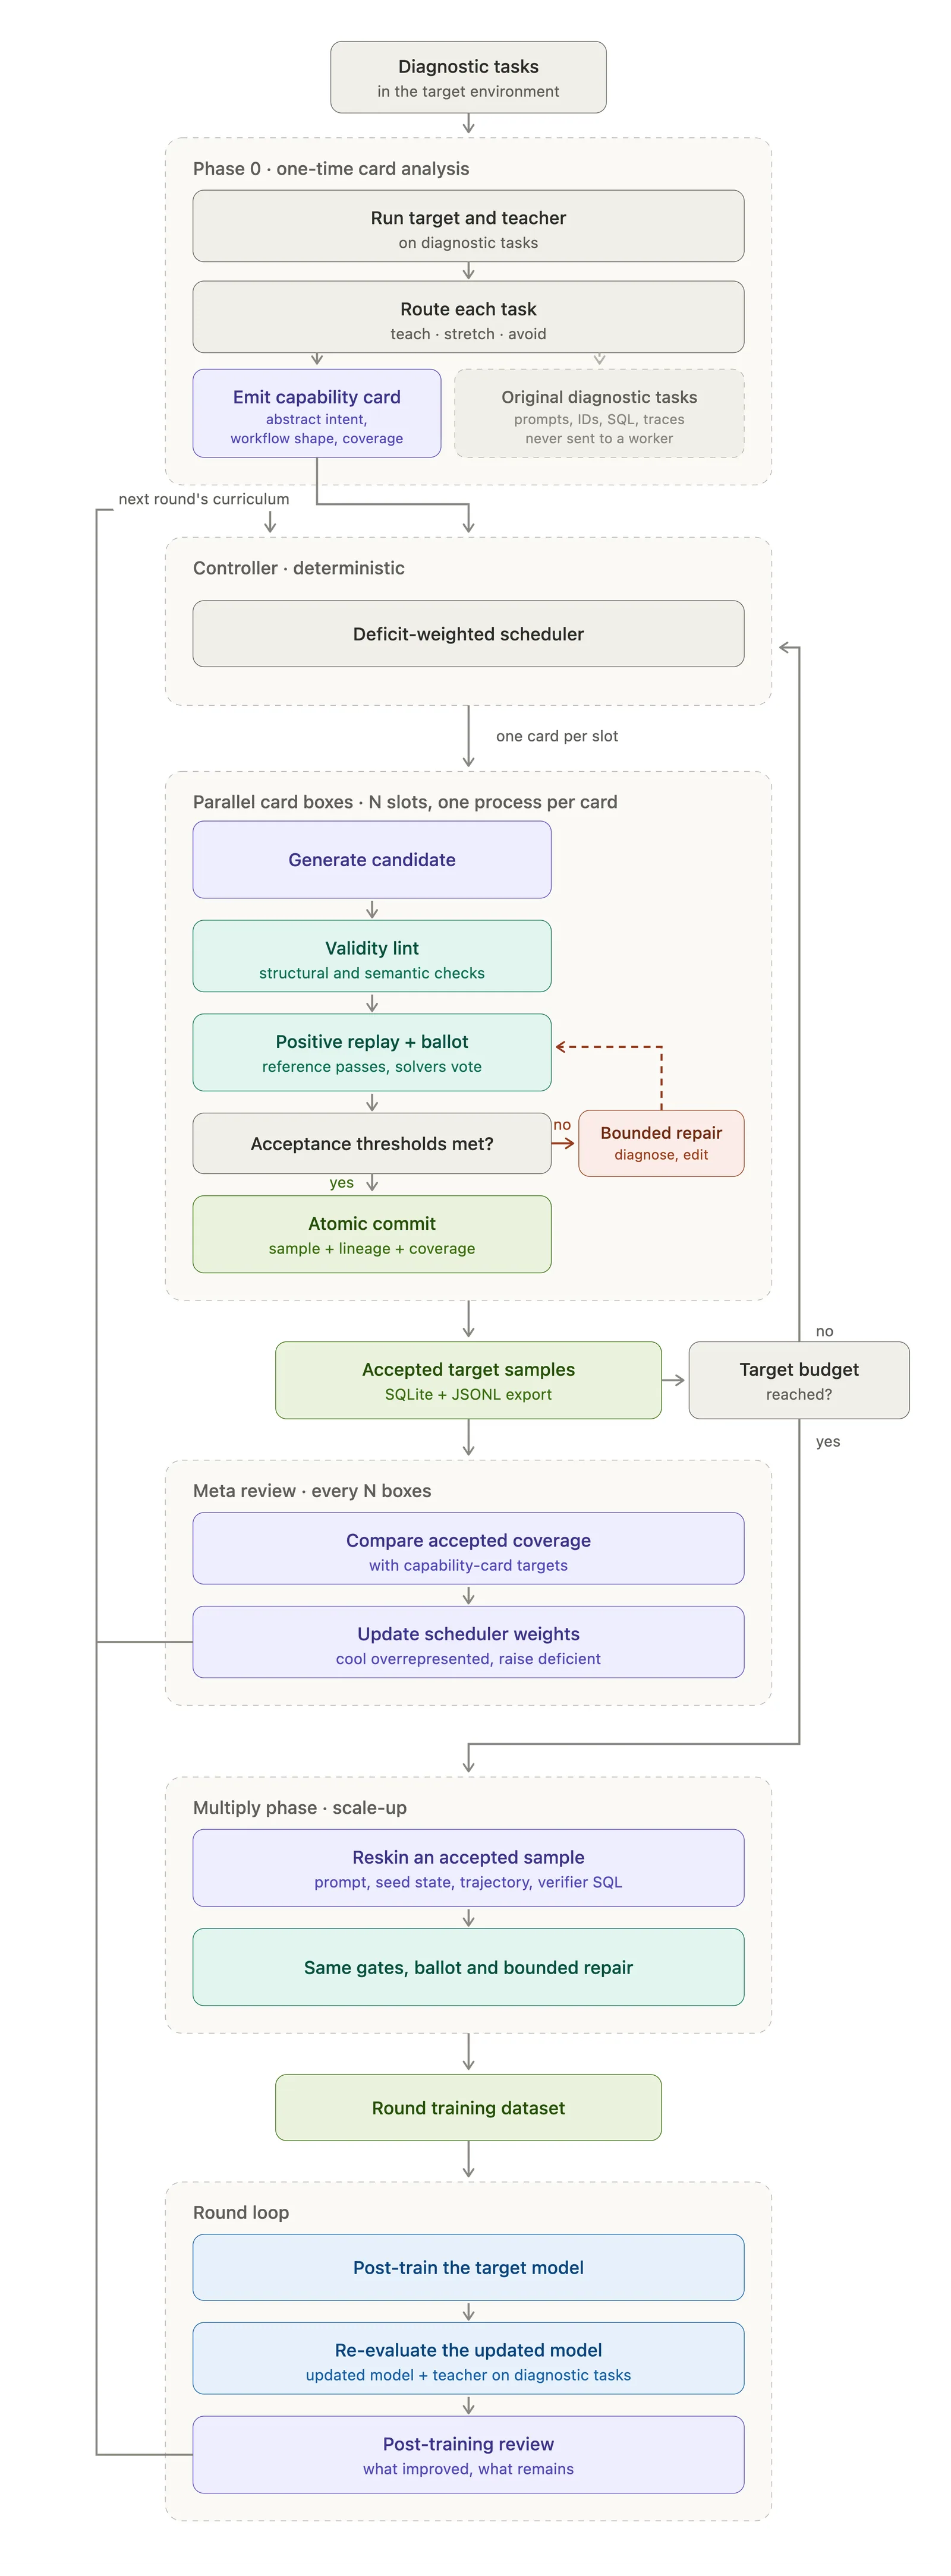
Secara garis besar, prosesnya begini: AutoSynthData dulu ngetes target model di environment-nya pakai task diagnostik, lalu nyari pola di mana model itu sering gagal. Model teacher yang lebih kuat dipakai buat ngecek mana dari kegagalan itu yang sebenarnya bisa diselesaikan, dan gimana cara nyelesaiinnya dengan benar.
Dari situ, AutoSynthData generate task-task baru yang ngelatih kemampuan yang sama, cek validitasnya langsung di environment, lalu ambil yang lolos buat proses supervised fine-tuning (SFT)—istilah buat nerusin training model pakai contoh jawaban yang udah benar. Model yang udah diupdate dievaluasi ulang buat liat kelemahan apa yang masih nyisa, dan siklus ini berulang terus.
Dari Kegagalan Jadi "Kurikulum": Kartu Spesifikasi Kemampuan
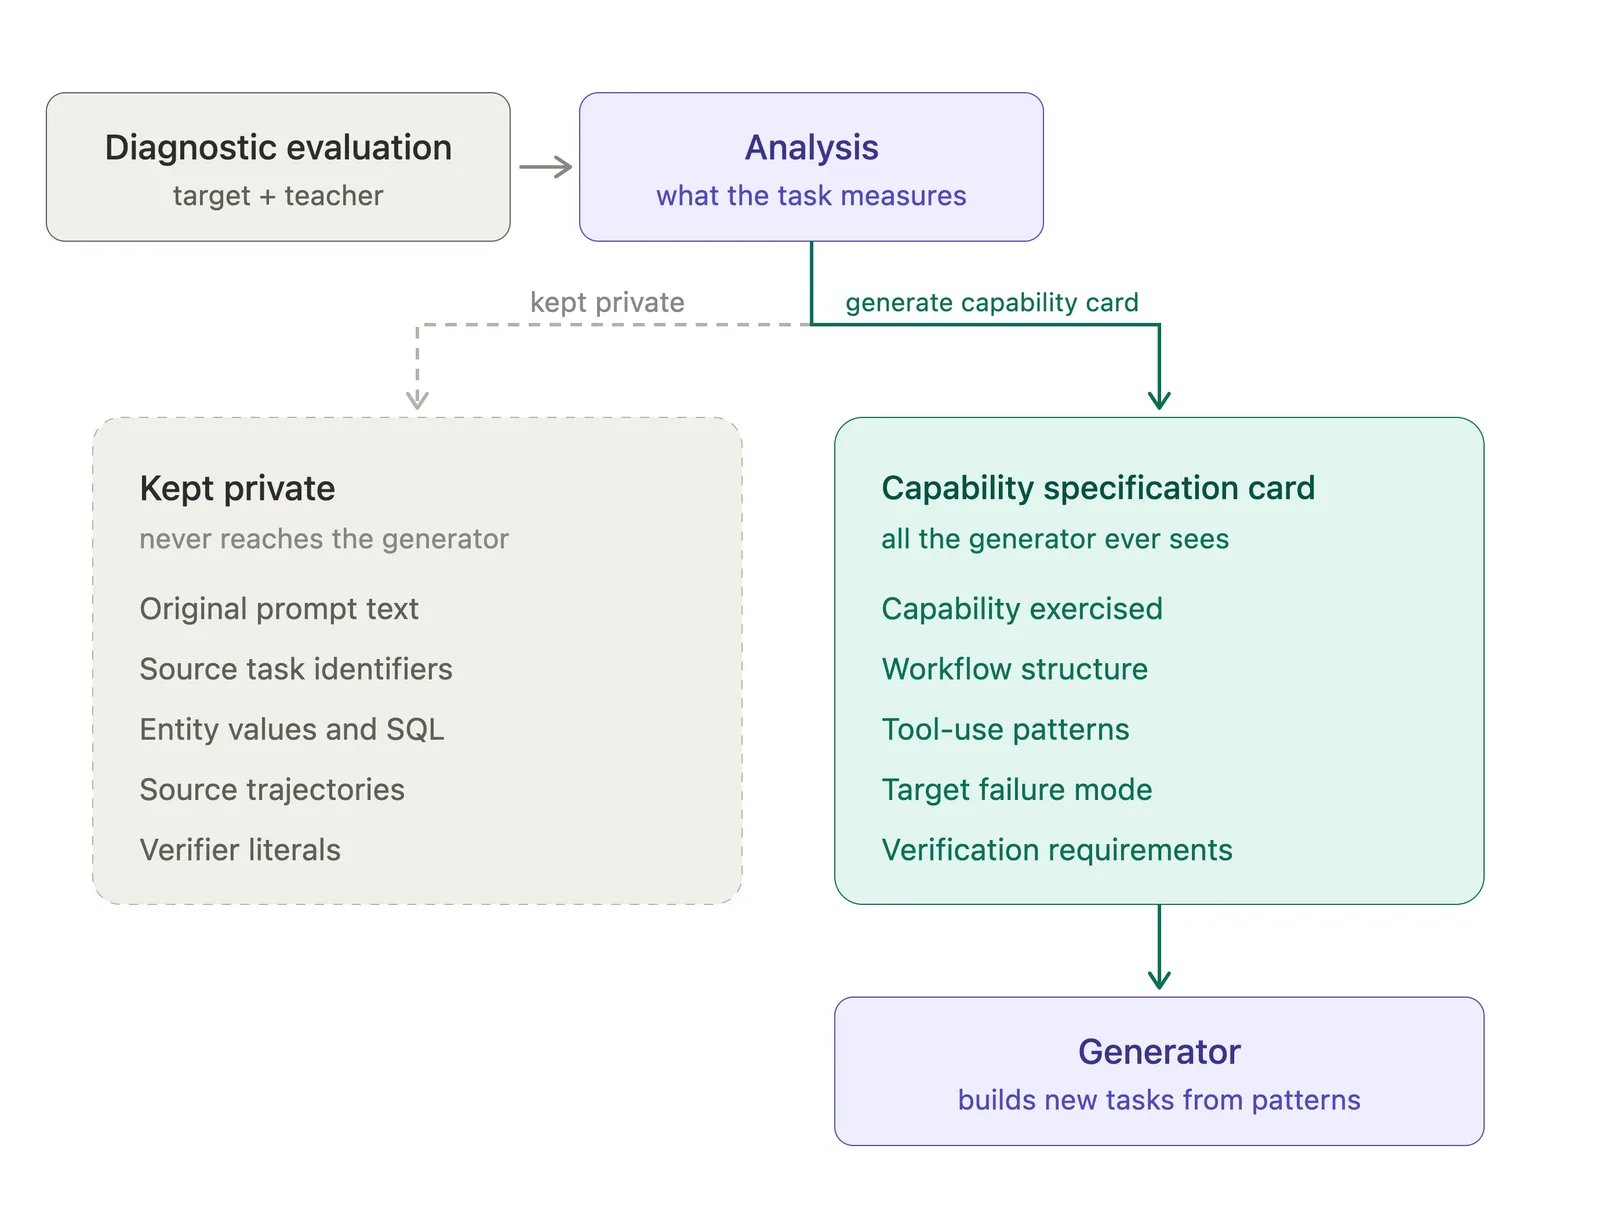
Buat nentuin apa yang perlu dipelajari model selanjutnya, tim ServiceNow nggak cuma ngasih contoh kegagalan mentah ke generator. Mereka nyaring hasil evaluasi jadi capability specification cards—catatan yang ngejelasin kemampuan apa yang diuji, tools dan struktur workflow yang terlibat, di mana target model gagal dan gimana teacher berhasil, serta dimensi apa yang bisa divariasikan tanpa ngilangin inti kemampuan yang mau dilatih.
Yang menarik, generator task baru nggak dapet prompt asli, entitas asli, atau trajectory asli dari evaluasi. Dia cuma dapet kartu spesifikasi itu, lalu bikin task dari nol dengan prompt, state, dan jalur penyelesaian yang beda. Jadi hasilnya beneran variasi baru, bukan nyontek ulang soal yang sama.
Dua Fase Generate Data: Target dan Multiply
Setelah tahu apa yang mau diajarin, AutoSynthData bikin dataset lewat dua fase.
Fase Target bikin set inti sample training dari kartu spesifikasi kemampuan. Beberapa worker bikin task secara paralel, dan tiap kandidat harus lewat validasi, eksekusi, evaluasi solver, sampai proses repair sebelum diterima.
Fase Multiply memperbanyak dataset dengan bikin variasi baru dari sample yang udah lolos di fase Target. Tiap variant punya permintaan user, state environment, konfigurasi entitas, trajectory referensi, dan verifier sendiri-sendiri—tapi tetap harus lolos cek yang sama. Satu hal penting: sample hasil Multiply nggak bisa dipakai lagi buat bikin variant lain, biar dataset-nya nggak makin ngalor-ngidul jauh dari task inti yang udah divalidasi.
Semua ini jalan lewat satu controller yang ngatur generation, quality control, coverage, dan penyusunan dataset, sementara bagian adapter yang spesifik tiap environment ngurus eksekusi task, manajemen state, replay trajectory referensi, verifikasi, sampai profiling hasil.
Jangan Asal Generate: Verifikasi Berlapis Biar Data Nggak Ngaco
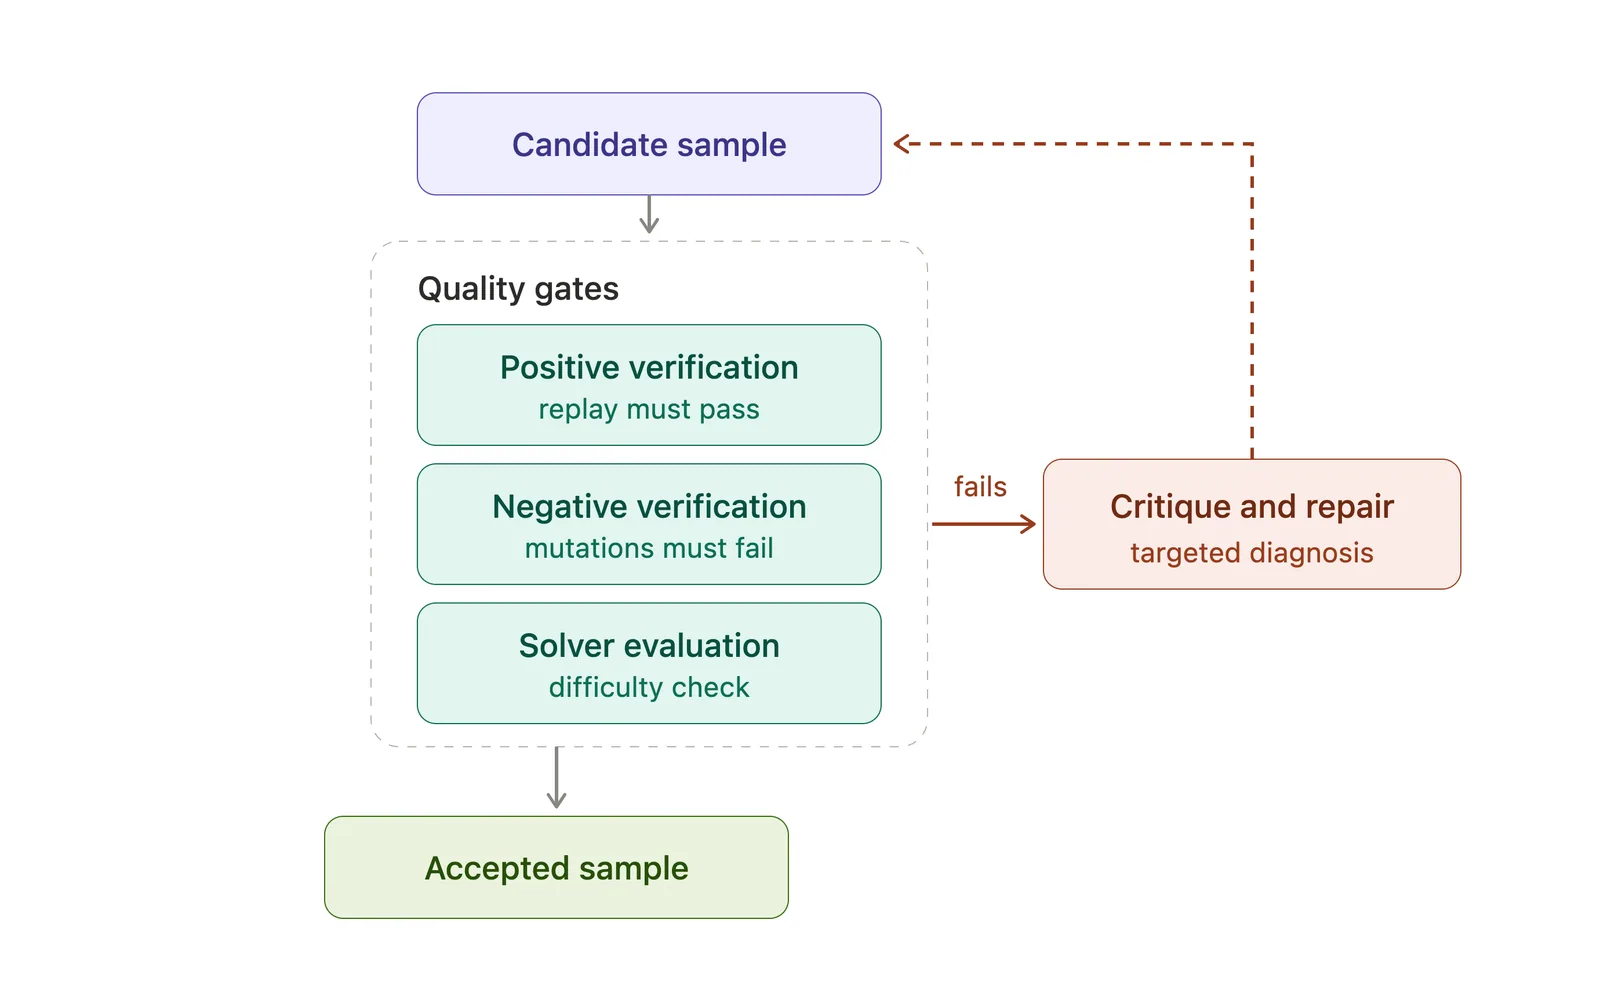
Bikin prompt yang kelihatan masuk akal aja nggak cukup. Task bisa aja ternyata mustahil dikerjain di environment-nya, solusi referensinya gagal kalau dijalanin, atau verifier-nya malah ngasih nilai bener buat state yang salah. AutoSynthData ngecek semua ini sebelum satu task diterima masuk dataset.
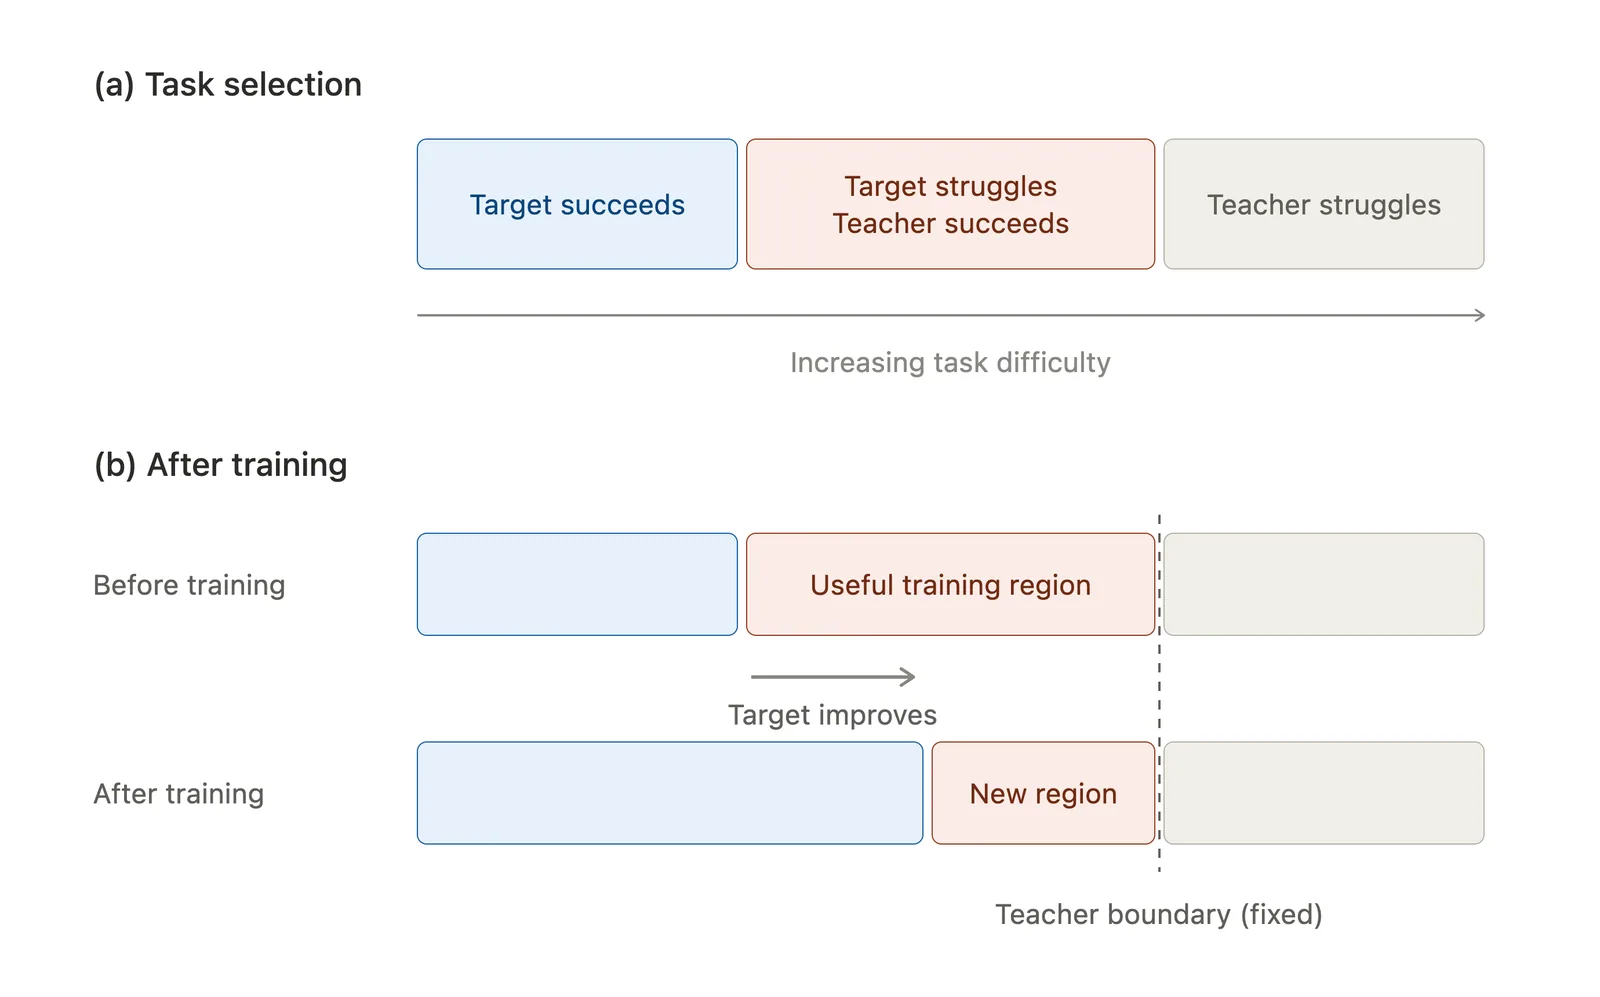
Tiap kandidat task dulu diukur tingkat kesulitannya lewat solver evaluation. Standar yang dipakai: task dianggap berguna kalau target model cuma berhasil nyelesein maksimal 1 dari 3 percobaan, sementara teacher yang lebih kuat berhasil minimal 2 dari 3 percobaan. Artinya task itu susah buat model yang mau dilatih, tapi masih bisa dicontohin dengan reliable oleh teacher.
Setelah itu ada dua gate tambahan. Verifikasi positif ngejalanin trajectory referensi di environment dan ngecek apakah hasilnya sesuai verifier—buat nemuin ketidakcocokan antara prompt, state awal, solusi, dan kriteria sukses. Verifikasi negatif sebaliknya, ngubah sedikit hasil yang seharusnya salah, lalu mastiin verifier beneran nolak hasil itu—biar ketahuan kalau ada verifier yang terlalu gampang ngasih status "berhasil".
Kalau ada kandidat yang gagal, dia nggak langsung dibuang. Ada proses critique and repair: sebuah critic nganalisis kenapa gagal—entah state-nya nggak konsisten, workflow-nya mustahil, atau logic verifier-nya lemah—lalu ngasih arahan buat perbaikan, dengan batas jumlah percobaan ulang yang tetap.
Selain cek per-task, ada juga meta-review di level batch—buat ngecek apakah ada task family yang kebanyakan muncul, kemampuan yang justru kelewat, atau pola generation yang terus gagal. Dari situ, controller ngatur ulang arah generation ke bagian yang masih kurang.
Target Latihan yang Terus Gerak Ikutin Kemampuan Model
Hal yang bikin AutoSynthData beda dari sekadar generate data sintetis sekali jadi: distribusi task yang berguna itu ikut berubah pas model makin pintar. Task yang udah bisa diselesaikan model dengan reliable jadi kurang berguna buat ronde training selanjutnya, sementara kegagalan yang masih nongol nunjukin kemampuan yang masih perlu digarap.
Setelah satu ronde fine-tuning, model yang udah diupdate dievaluasi lagi di environment yang sama. Hasilnya dipakai buat nentuin arah generasi task berikutnya. Eksperimen di artikel ini fokus di SFT, tapi tim ServiceNow bilang mekanisme yang sama berpotensi dipakai juga buat reinforcement learning (RL)—generate task yang nantang policy model saat ini, latih, lalu gerakin lagi target generasi pakai policy yang baru.
Hasil Nyata: Uji Coba di EnterpriseOps Gym
Tim ServiceNow nguji pendekatan ini di EnterpriseOps Gym, benchmark environment enterprise yang stateful, di dua domain: Hybrid dan ITSM (tiket dan workflow IT support).
Di domain Hybrid, mereka pakai Gemma-4-26B-A4B-it sebagai target model dan Qwen3.8-27B sebagai teacher. AutoSynthData generate 2.000 sample training sintetis dalam sekitar 18 jam, lalu model di-fine-tune pakai dataset itu—checkpoint terbaik ada di epoch 5.
Di domain ITSM, target model-nya sama (Gemma-4-26B-A4B-it), tapi teacher-nya DeepSeek-V4.1-Flash. Mereka generate 1.994 sample dalam 66 jam—lebih lama ketimbang run Hybrid, soalnya teacher-nya lebih besar dan proses ini dijalanin sebelum ada optimasi pipeline yang bikin throughput-nya naik.
| Domain | Model target | Teacher | Jumlah sample sintetis | Waktu generate | Hasil setelah SFT |
|---|---|---|---|---|---|
| Hybrid | Gemma-4-26B-A4B-it | Qwen3.8-27B | 2.000 | ~18 jam | Pass@1 naik 7,2 poin (35% relatif); verifier success 63,01% → 68,55%; nutup 59% gap ke model referensi |
| ITSM | Gemma-4-26B-A4B-it | DeepSeek-V4.1-Flash | 1.994 | 66 jam | Pass@1 naik dari 18,77% jadi 27,18% |
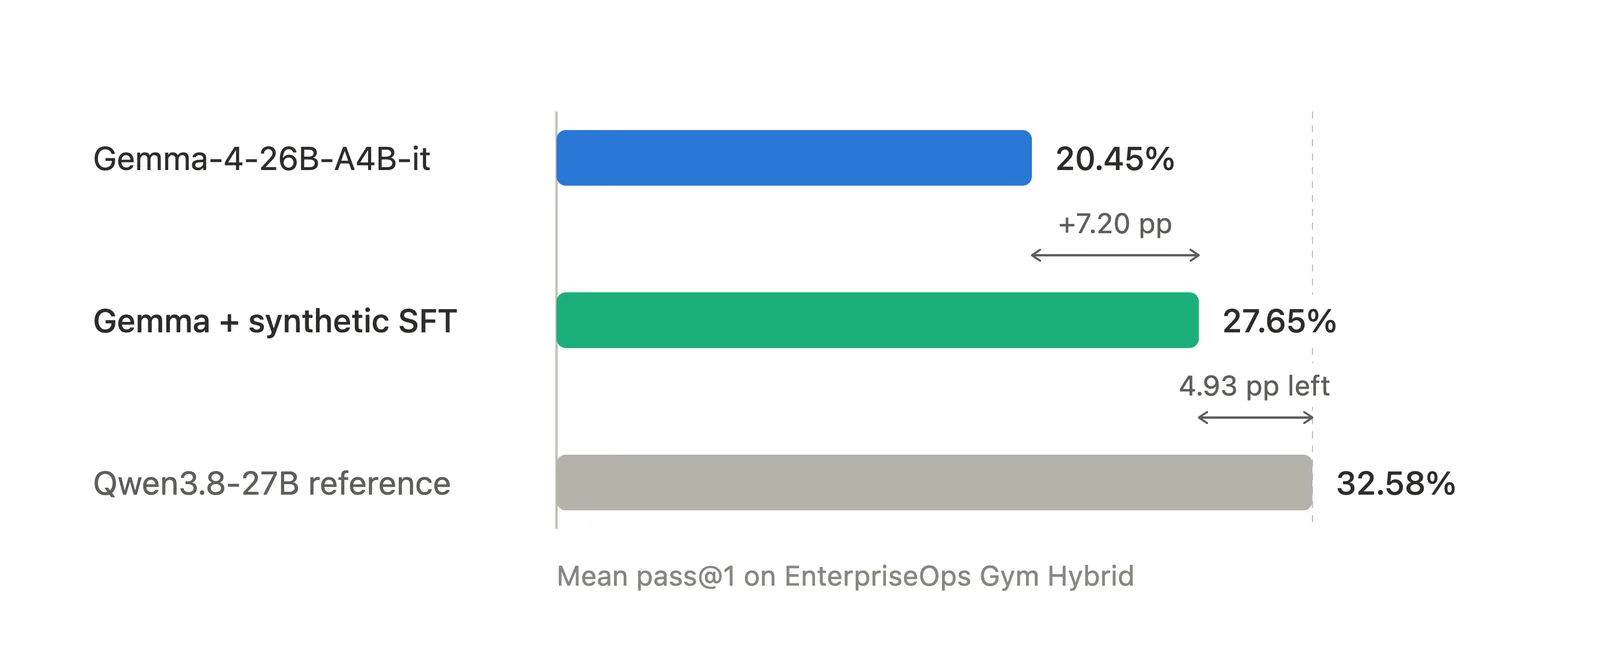
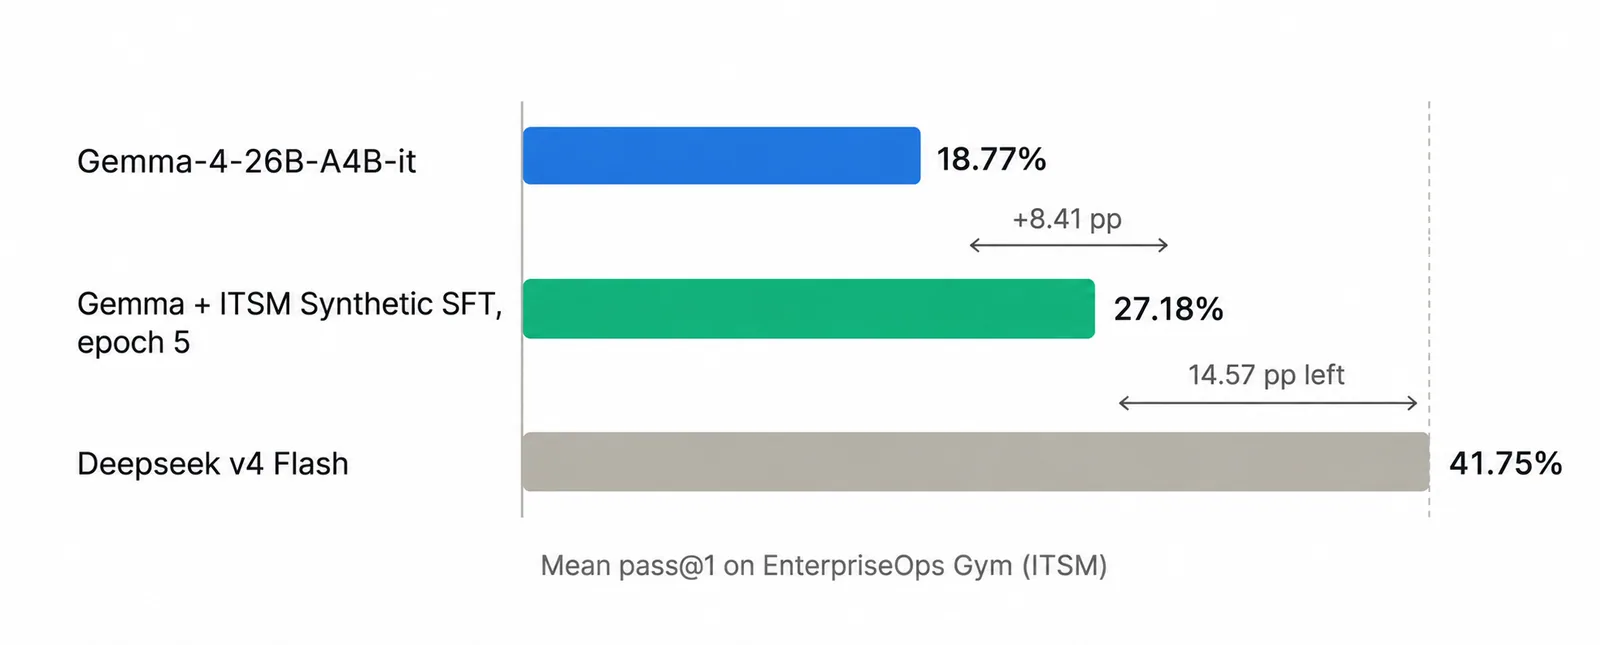
Penting dicatat, task latihan yang dipakai itu digenerate dari kartu spesifikasi kemampuan, bukan dari soal evaluasi aslinya—jadi perbaikan ini beneran karena model belajar kemampuan baru, bukan cuma hafal soal yang mirip.
Apa Artinya Buat Developer dan Bisnis di Indonesia?
Banyak perusahaan di Indonesia sekarang mulai pasang agen AI buat customer service, helpdesk IT, atau otomasi proses internal. Masalah yang sering muncul sama persis kayak yang dibahas riset ini: model umum kayak GPT, Claude, atau Gemini emang pintar, tapi belum "paham" SOP internal, sistem tiket, atau aturan khusus perusahaan kamu.
Pendekatan AutoSynthData ngasih gambaran kalau solusinya bukan selalu ganti ke model yang lebih mahal, tapi kasih data latihan yang presisi sesuai kelemahan nyata model di sistem kamu sendiri. Buat tim developer, ini juga berarti investasi di verifier yang bener-bener ketat jadi sepenting investasi di data—verifier yang lemah bisa bikin training malah ngajarin kebiasaan yang salah.
Dari sisi keamanan data, pola bikin synthetic data kayak ini juga relevan buat UU PDP: karena task dan state-nya digenerate ulang (bukan nyalin data pelanggan asli), risiko kebocoran data pribadi pas proses training jadi lebih kecil—asal proses validasinya tetap dijaga supaya nggak ngarang informasi yang nggak sesuai kondisi asli sistem.
Buat kamu yang mau coba pola teacher-student kayak di eksperimen ITSM di atas, salah satu teacher model yang dipakai—DeepSeek V4.1 Flash—kebetulan ada di Classai Router dengan harga Rp160 per 1 juta token input dan Rp800 per 1 juta token output. Jadi kamu bisa langsung uji coba pola "model kuat ngajarin model kecil" ini tanpa modal besar, cukup ganti satu string model di kode kamu.
Buat yang mau belajar lebih dalam soal bikin dan ngatur agent AI dari sisi developer, kelas AI untuk Developer dari Classai bisa jadi titik awal yang pas. Kamu juga bisa baca panduan API AI buat pemula atau lihat gimana AWS bikin pola fine-tuning serupa di search agent SageMaker buat perbandingan pendekatan.
Cara Mulai Eksplorasi Synthetic Data Buat Agent Kamu Sendiri
Kalau kamu kepincut buat nyobain pola serupa di tim kamu, ini langkah praktis yang bisa diambil dari cara kerja AutoSynthData:
- Petakan environment agen kamu dulu. Tentuin apa aja tools, API, dan state yang bisa diakses agent, biar jelas task apa yang sebenarnya feasible dikerjain.
- Jalankan evaluasi sebelum ngelatih apa-apa. Kumpulin task diagnostik, lihat di mana model kamu gagal, dan catat pola kegagalannya—bukan cuma "gagal", tapi gagal di jenis workflow apa.
- Pakai model yang lebih kuat sebagai pembanding. Jalankan task yang sama pakai teacher model, biar kelihatan mana yang sebenarnya bisa diselesaikan dan gimana solusinya.
- Bangun verifier yang ketat dari awal. Pastiin verifier kamu bisa nolak jawaban salah (bukan cuma nerima jawaban bener)—ini sering jadi bagian yang paling dilewatin tim yang buru-buru.
- Generate dan validasi bertahap, jangan sekali gede. Mulai dari batch kecil, cek kualitasnya, baru perbesar skala generation-nya.
- Ulangi siklusnya. Setelah fine-tuning, evaluasi ulang model dan lihat gap mana yang masih nyisa buat jadi fokus ronde berikutnya.
Contoh prompt sederhana buat bikin "kartu spesifikasi kemampuan" dari hasil evaluasi kamu sendiri:
Saya punya log evaluasi agent AI yang gagal di task [deskripsikan singkat jenis tugasnya].Tolong rangkum jadi kartu spesifikasi kemampuan yang isinya:1) kemampuan apa yang diuji,2) tools/workflow yang terlibat,3) di titik mana agent gagal dan kenapa,4) kriteria yang harus dipenuhi di hasil akhir yang benar,5) dimensi apa yang bisa divariasikan (entitas, state awal, urutan langkah) tanpa mengubah kemampuan inti yang diuji.Jangan sertakan prompt atau data asli, cukup pola dan kriterianya saja.
Pola ini bisa kamu kombinasikan dengan model-model di Classai Router sesuai kebutuhan—mau yang murah buat generate task massal atau yang lebih kuat buat jadi teacher.
Sumber & referensi
- 01
Hugging Face · 2 Oktober 2026
AutoSynthData: Generating Training Data for Enterprise Agents
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu AutoSynthData?
AutoSynthData adalah sistem bikinan ServiceNow CoreAI yang otomatis bikin data latihan baru buat agen AI enterprise. Caranya dengan ngeliat kegagalan model, minta model teacher yang lebih kuat nunjukin solusi benernya, lalu generate dan validasi task baru dari situ buat proses fine-tuning.
Gimana AutoSynthData beda dari bikin data sintetis biasa?
Bedanya ada di proses verifikasi berlapis—tiap task dicek lewat verifikasi positif, verifikasi negatif, dan proses repair sebelum dipakai buat training. Selain itu ada meta-review di level batch biar dataset-nya nggak numpuk di task yang mirip-mirip terus.
Model apa yang dipakai di eksperimen EnterpriseOps Gym?
Target model-nya Gemma-4-26B-A4B-it di dua domain. Teacher-nya beda: Qwen3.8-27B buat domain Hybrid, dan DeepSeek-V4.1-Flash buat domain ITSM, yang kebetulan juga tersedia di Classai Router.
Apakah AutoSynthData bisa langsung dipakai developer di Indonesia?
Sumbernya nggak menyebut rilis tools AutoSynthData buat publik—yang dibahas adalah metode dan hasil eksperimennya di EnterpriseOps Gym. Developer bisa belajar pola kerjanya (evaluasi, teacher-student, verifikasi berlapis) buat dibangun sendiri di environment masing-masing.
Seberapa besar peningkatan yang didapat dari AutoSynthData?
Di domain Hybrid, Pass@1 naik 7,2 poin atau 35% secara relatif, dan menutup 59% gap ke model referensi. Di domain ITSM, Pass@1 naik dari 18,77% jadi 27,18% setelah fine-tuning pakai data sintetis.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.