NVIDIA Rilis Nemotron 3.5 Transcribe: Model AI Suara Baru
NVIDIA meluncurkan Nemotron 3.5 Transcribe dan Granary v2. Model speech-to-text open-weight ini bisa transkripsi 40 bahasa, tandai 8 pembicara, dan diatur pakai prompt.
· 10 menit baca
Inti singkat
- Nemotron 3.5 Transcribe adalah model AI suara open-weight 30B parameter dengan 4B parameter aktif berkat hybrid Mamba-Transformer.
- Mampu transkripsi 40 bahasa, terjemahkan 31 bahasa, dan membedakan 8 pembicara sekaligus dalam rekaman hingga satu jam.
- Bisa diarahkan memakai prompt teks biasa untuk mengatur gaya penulisan, istilah khusus, atau tanya jawab rekaman.
- NVIDIA merilis pipeline kurasi Granary v2 dengan dataset 463.062 jam audio di 48 bahasa untuk kebutuhan adaptasi domain.
- Memuncaki peringkat Hugging Face Open ASR Leaderboard bahasa Inggris dan mencatat error terendah di benchmark David AI.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
NVIDIA resmi ngerilis Nemotron 3.5 Transcribe bareng Granary v2, model kecerdasan buatan sumber terbuka buat transkripsi suara multibahasa yang bisa kamu atur langsung pakai prompt teks biasa. Rilis ini bikin heboh komunitas pengembang karena menggabungkan fitur transkripsi, pemisahan suara pembicara (diarization), penerjemahan bahasa, sampai audio Q&A langsung ke dalam satu model tanpa perlu instal banyak tool terpisah.
Menurut laporan resmi di Hugging Face Blog dan ulasan dari TechCrunch, model ini sudah tersedia secara terbuka di Hugging Face dan ModelScope. Siapa aja bisa langsung download checkpoint-nya buat dijalankan di server sendiri, tanpa terikat langganan API berbayar dari platform luar yang bikin biaya membengkak.
Kehadiran model ini melengkapi ramainya inovasi teknologi suara, mulai dari tool transkripsi macam TurboScribe sampai model multimodal ringkas buat perangkat edge seperti LFM3 Multimodal. Yuk, kita bedah bareng-bareng apa aja keunggulannya, hasil pengujian benchmark, dan gimana cara pakainya.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu NVIDIA Nemotron 3.5 Transcribe?
NVIDIA Nemotron 3.5 Transcribe adalah model AI suara open-weight yang punya total ukuran 30 miliar (30B) parameter. Menariknya, model ini memadukan encoder audio dengan arsitektur hybrid Mamba–Transformer mixture-of-experts (MoE). Lewat teknik MoE ini, cuma sekitar 4 miliar (4B) parameter yang aktif tiap kali memproses token, jadi komputasinya jauh lebih enteng tapi hasilnya tetap akurat banget.
Model ini sanggup melahap rekaman audio sampai durasi satu jam penuh dalam sekali jalan. Ada empat fungsi utama yang langsung dibungkus rapi di dalamnya:
- Transkripsi multibahasa: Mengenali ucapan dalam 40 bahasa sekaligus.
- Penerjemahan dua arah: Menerjemahkan 31 bahasa ke bahasa Inggris atau sebaliknya.
- Pemisahan pembicara (speaker diarization): Membedakan dan ngasih label sampai delapan pembicara di 13 bahasa.
- Tanya jawab audio (audio Q&A): Menjawab pertanyaan seputar isi rekaman langsung dalam bahasa Inggris.
Perlu dicatat, model ini dirancang khusus buat rekaman audio utuh (pre-recorded), bukan buat percakapan streaming langsung. Modelnya bisa jalan di satu chip GPU aja, mulai dari perangkat lokal seperti RTX Spark, DGX Spark, Jetson AGX Thor, sampai server data center berbasis Blackwell.
Atur Hasil Transkripsi Cukup Pakai Prompt Teks
Masalah yang sering bikin kesal pas pakai speech-to-text biasa adalah hasil teksnya yang kaku. Kadang kita pengin transkrip bersih tanpa kata gumaman ("uh" atau "hmm"), kadang butuh transkrip kata demi kata persis aslinya (verbatim), dan sering juga AI salah nulis istilah teknis. Nemotron 3.5 Transcribe mengatasi masalah ini lewat konsep promptable ASR.
Kamu cukup ngasih instruksi dalam bahasa Inggris sebelum audio diproses. Model yang sama bisa ngeluarin catatan rapat lengkap dengan label pembicara, bikin terjemahan kilat, atau menyarikan keputusan penting dari diskusi. Contoh kemampuannya kelihatan jelas pas NVIDIA menguji model ini di adegan film komedi klasik His Girl Friday (1940), yang terkenal punya tempo dialog super cepat dan saling menimpa.
Model ini terbukti sukses membedakan siapa yang ngomong meskipun suaranya saling tumpang tindih. Selain itu, ada dukungan penanda waktu per kata (word-level timestamps). Fitur ini sudah dicoba oleh platform Agora buat nampilin teks berjalan otomatis di rekaman kelas online, jadi siswa bisa langsung ngecek kapan suatu materi dibahas.
Kalau rekaman kamu memuat banyak istilah medis atau jargon kantor yang nggak umum, kamu tinggal selipin contekan istilah di prompt:
Transcribe this medical discussion in the original language. Possible terms: HbA1c, metformin. Use these terms only when supported by the audio. Preserve standard medical spelling and write numbers in conventional written form.Juara di Papan Peringkat Transkripsi dan Diarization
NVIDIA nggak cuma ngomong doang soal performa. Di pengujian benchmark independen, Nemotron 3.5 Transcribe sukses nangkring di posisi teratas buat kategori model open-weight.
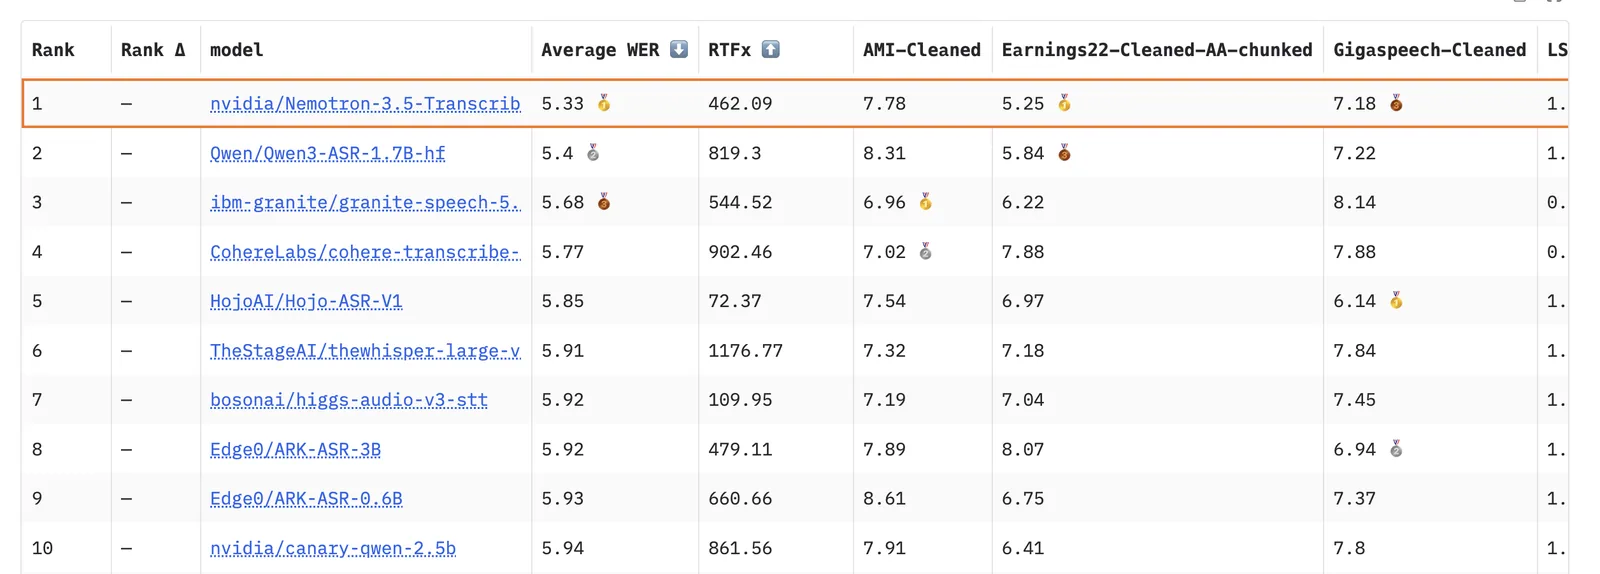
Pada Hugging Face Open ASR Leaderboard, model ini menyabet posisi nomor satu untuk transkripsi bahasa Inggris dengan tingkat kesalahan kata (word error rate atau WER) cuma 5,33%. Di kategori multibahasa pada tujuh bahasa uji, rata-rata WER-nya cuma 4,62%, dan di kategori rekaman panjang (long-form) mencatat 10,98%—keduanya paling rendah dibanding model sekelasnya.
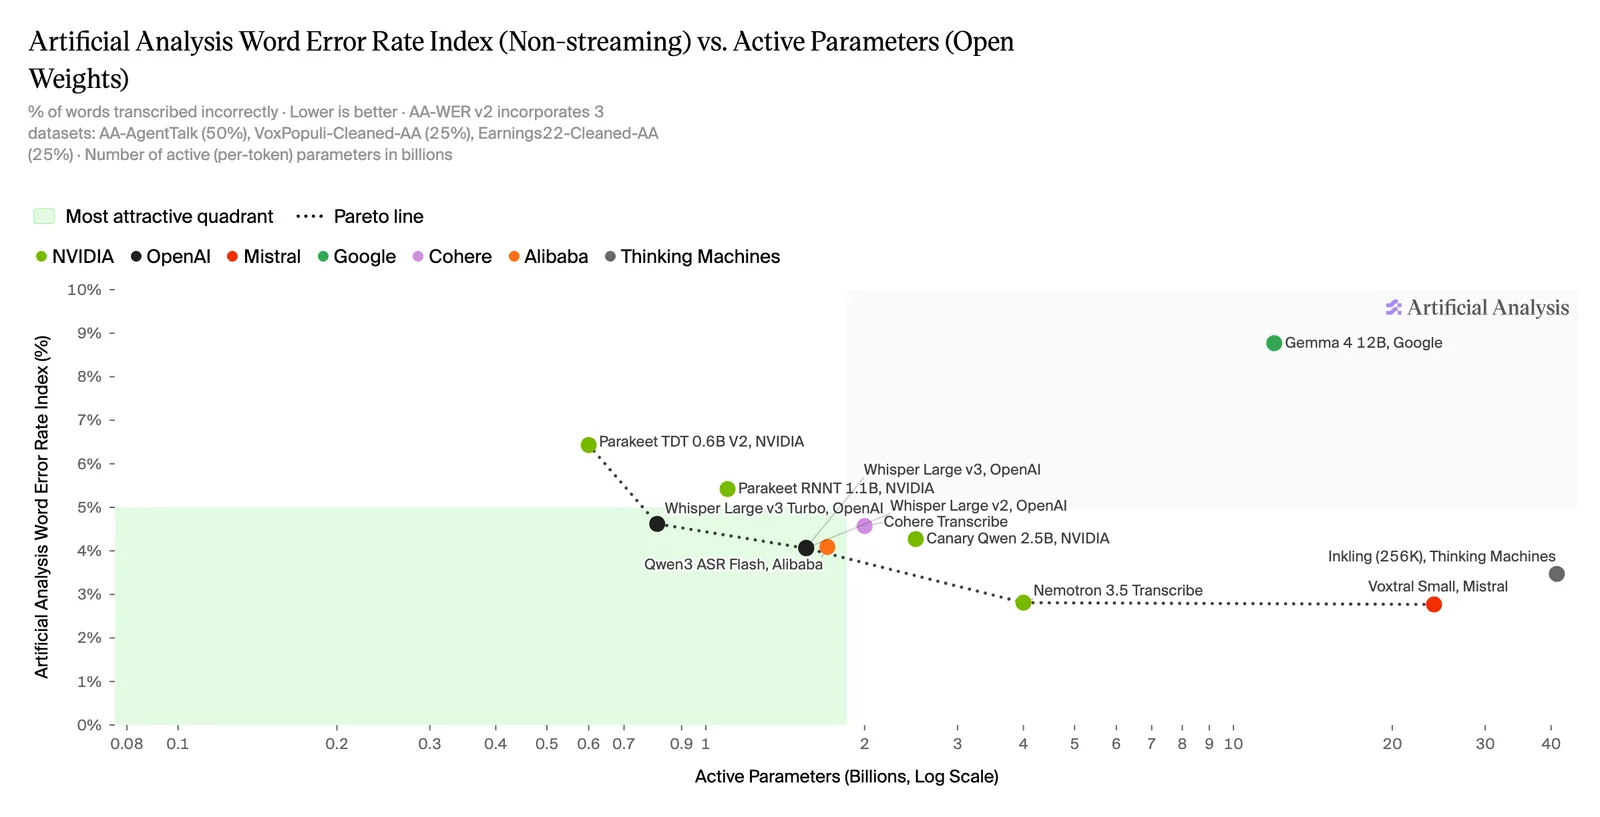
Evaluasi independen dari Artificial Analysis juga menempatkan model ini di posisi puncak bareng model lain di angka 2,8% AA-WER. Bedanya, Nemotron cuma butuh 4B parameter aktif per token, sedangkan model saingannya butuh 24B parameter. Di tes AA-AgentTalk yang menguji percakapan agen suara, WER model ini tembus 1,8%.
Buat urusan pemisahan pembicara, NVIDIA menyematkan teknologi Sortformer yang ngirim sinyal pembicara barengan sama fitur suara ke model bahasa. Teks transkrip pun langsung dapet label pembicara pas proses generate berlangsung.
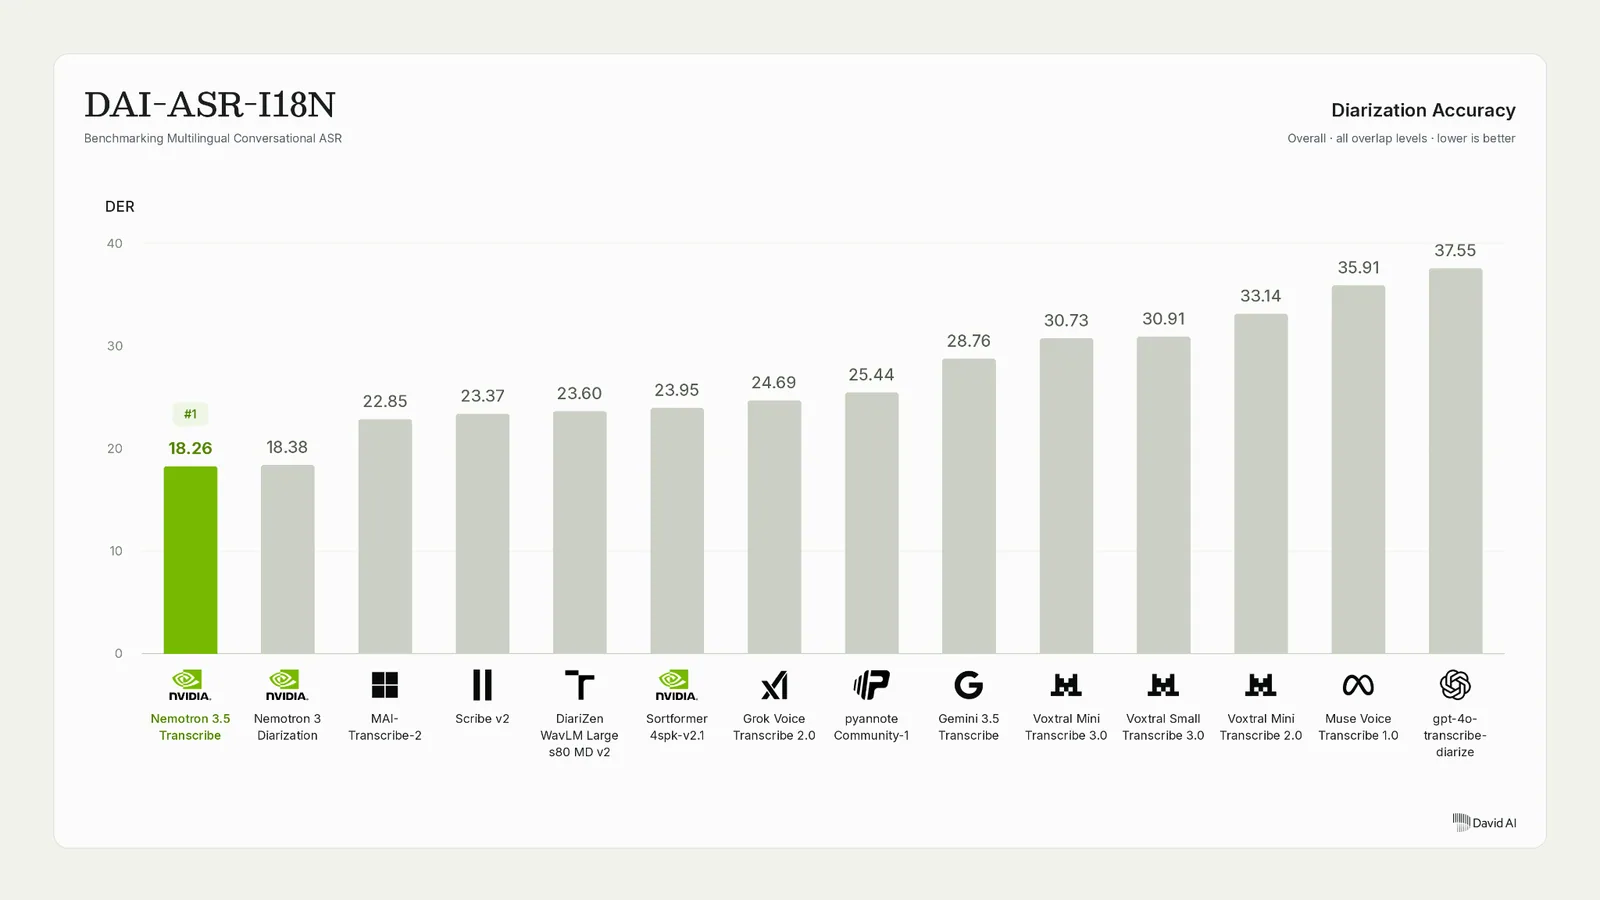
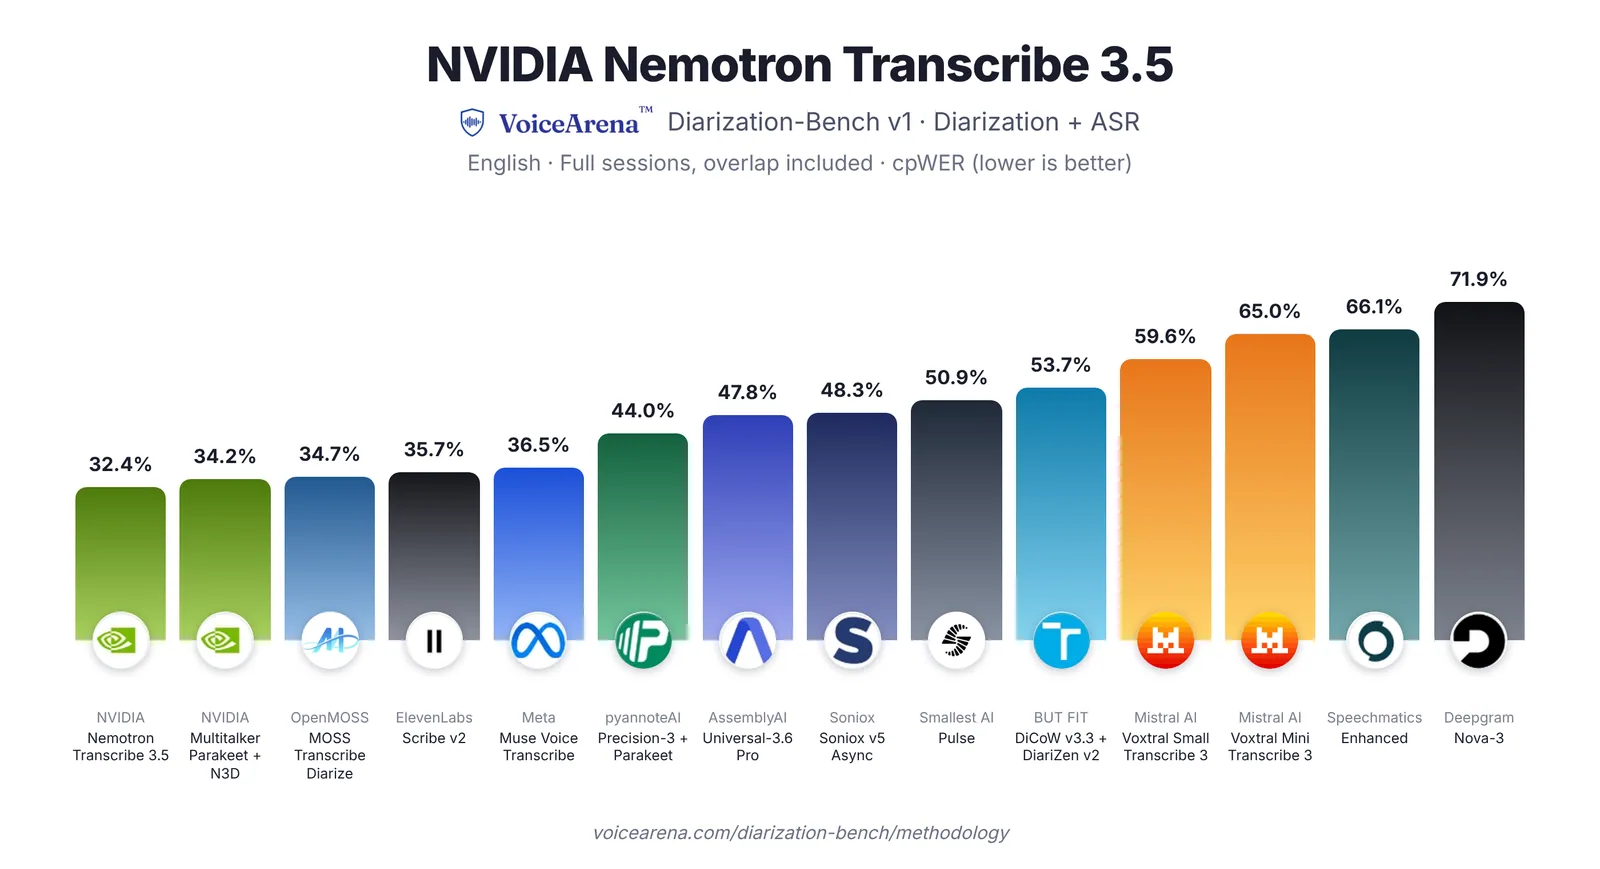
Di benchmark David AI DAI-ASR-I18N yang menguji diarization di 21 bahasa, Nemotron 3.5 Transcribe mencatatkan diarization error rate (DER) terendah di angka 18,26%. Begitu juga di VoiceArena Diarization-Bench v1 yang menguji sesi obrolan 2 sampai 8 orang dengan suara saling timpa; model ini memimpin dengan skor cpWER 32,4% dan tingkat kata yang hilang cuma 8,32% (jauh lebih bagus dari rata-rata sistem lain di kisaran 31%).
Berikut ringkasan hasil benchmark Nemotron 3.5 Transcribe di berbagai papan pengujian:
| Benchmark | Metrik Pengujian | Skor Nemotron 3.5 | Posisi / Catatan |
|---|---|---|---|
| Hugging Face Open ASR (EN) | Word Error Rate (WER) | 5,33% | Peringkat 1 (Open-Weight) |
| Hugging Face Open ASR (Multilingual) | Rata-rata WER (7 Bahasa) | 4,62% | Peringkat 1 (Open-Weight) |
| Artificial Analysis | AA-WER Index | 2,80% | Peringkat 1 bareng (~4B parameter aktif) |
| AA-AgentTalk | Word Error Rate (WER) | 1,80% | Terbaik di kategori open-weight |
| David AI (21 Bahasa) | Diarization Error Rate (DER) | 18,26% | Peringkat 1 (Error paling kecil dari 14 sistem) |
| VoiceArena Diarization-Bench v1 | cpWER (Sesi Bahasa Inggris) | 32,40% | Peringkat 1 (Kata hilang cuma 8,32%) |
Dalam uji kecepatan pemrosesan, versi kuantisasi NVFP4 yang bakal segera keluar sanggup ngerjain 100 jam audio dalam waktu kurang dari tiga menit aja di satu GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Mengenal Granary v2: Dapur Data di Balik Nemotron
Biar model AI bisa paham format teks dari prompt, data latihannya harus bener-bener terstruktur. Bersamaan dengan model ini, NVIDIA ngerilis Granary v2, kumpulan data dan pipeline kurasi yang dibangun pakai NVIDIA NeMo Curator di Hugging Face dan ModelScope.
Manifest publik Granary v2 menyediakan 463.062 jam audio dari 48 bahasa dan 16 sumber data (naik tajam dibanding Granary v1 yang cuma 25 bahasa). Pipeline ini otomatis ngubah satu rekaman audio jadi tiga variasi teks yang berbeda:
| Format Target | Contoh Transkrip Hasil Olahan | | :--- | : | | Text-normalized, verbatim | I paid, uh, twenty-five euros. | | Inverse text normalization, with disfluencies | I paid, uh, €25. | | Inverse text normalization, without disfluencies | I paid €25. |
Proses kurasi di Granary v2 jalan lewat empat tahapan utama:
- Audio Preparation (Metadata): Memotong segmen rekaman panjang, melacak giliran bicara, dan mendeteksi bahasa serta noise latar.
- Transcription (ASR): Menerjemahkan suara lewat model utama dan model cadangan, lengkap dengan filter deteksi halusinasi.
- Task Label Generation (Text): Bikin variasi format teks dan memeriksa kecocokan teks dengan referensi manusia.
- High Fidelity (HiFi): Membuang rekaman yang bising, suara pecah (clipping), atau suara tumpang tindih. Di dataset VoxPopuli, tahap ini menyaring 354 ribu jam audio jadi 111 ribu jam rekaman yang bener-bener bersih.
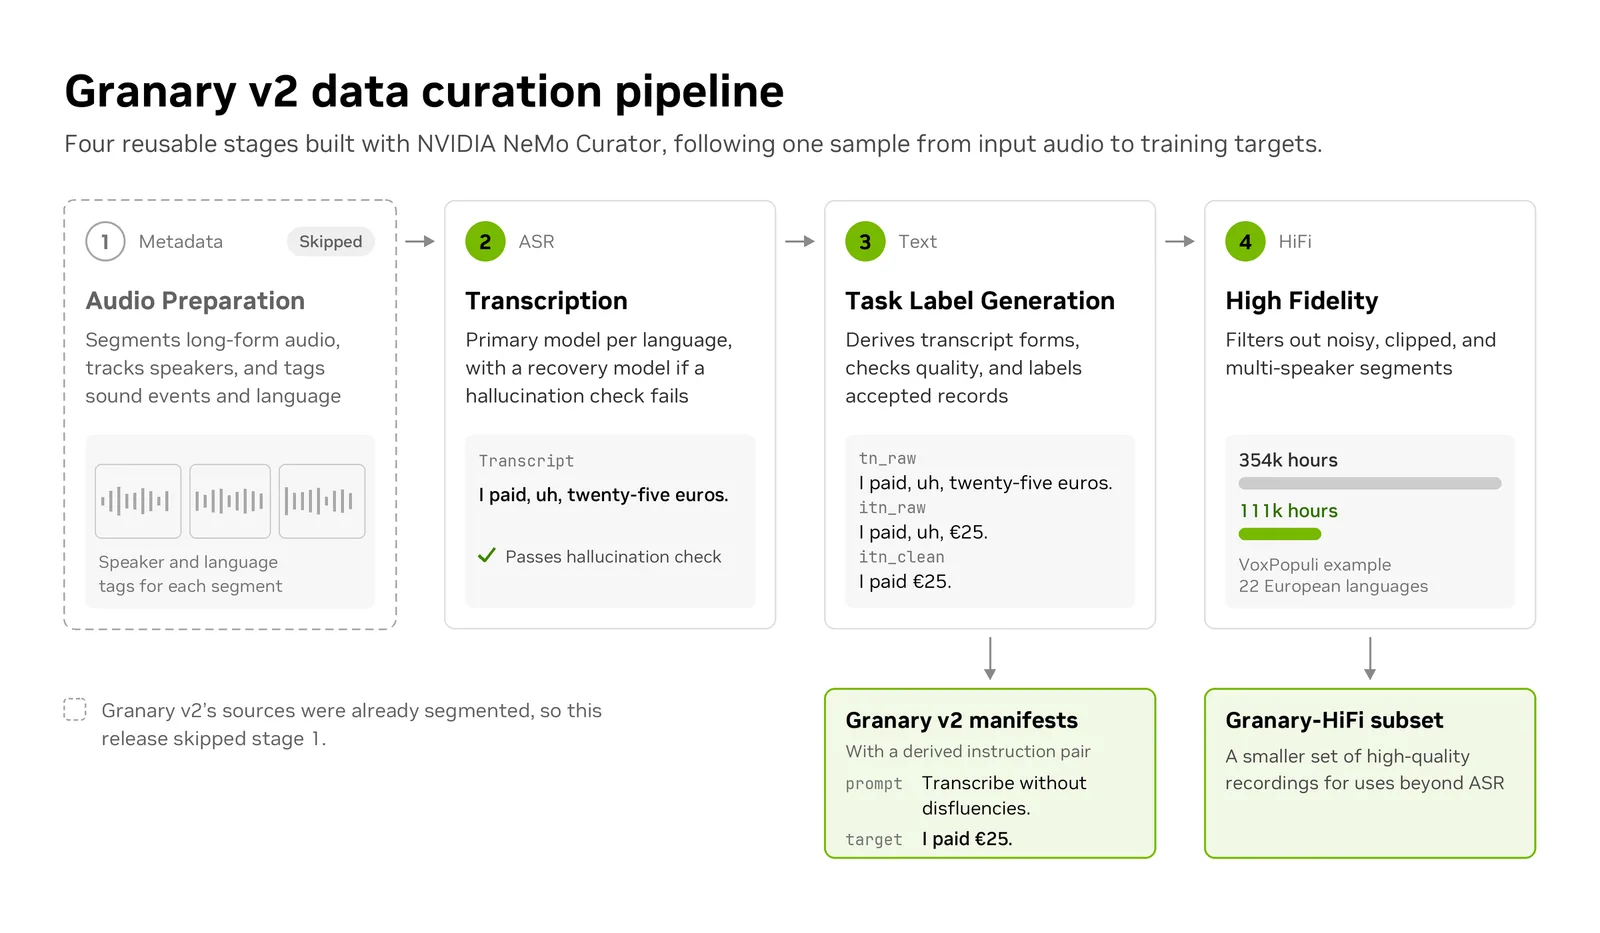
Kamu bisa menjalankan pipeline NeMo Curator ini pakai backend Ray dan NVIDIA Dynamo buat membersihkan data rekaman internal milik bisnismu sendiri.
Adaptasi Domain Medis: Pangkas Tingkat Error 45,8%
Gimana kalau model ini dipakai buat bidang yang istilahnya super ribet, kayak percakapan dokter dan pasien? NVIDIA nunjukin studi kasus adaptasi NeMo Speech pakai benchmark terbuka Eka Care, yang berisi rekaman suara dokter dan mahasiswa kedokteran di India dengan aksen kental dan nama obat kompleks.
Tanpa fine-tuning sama sekali, prompt biasa menghasilkan tingkat error (WER) sebesar 30,8%. Cuma dengan memperbaiki prompt (menyebut bahasa Inggris dan alfabet Latin secara gamblang), tingkat error langsung turun jadi 23,8%.
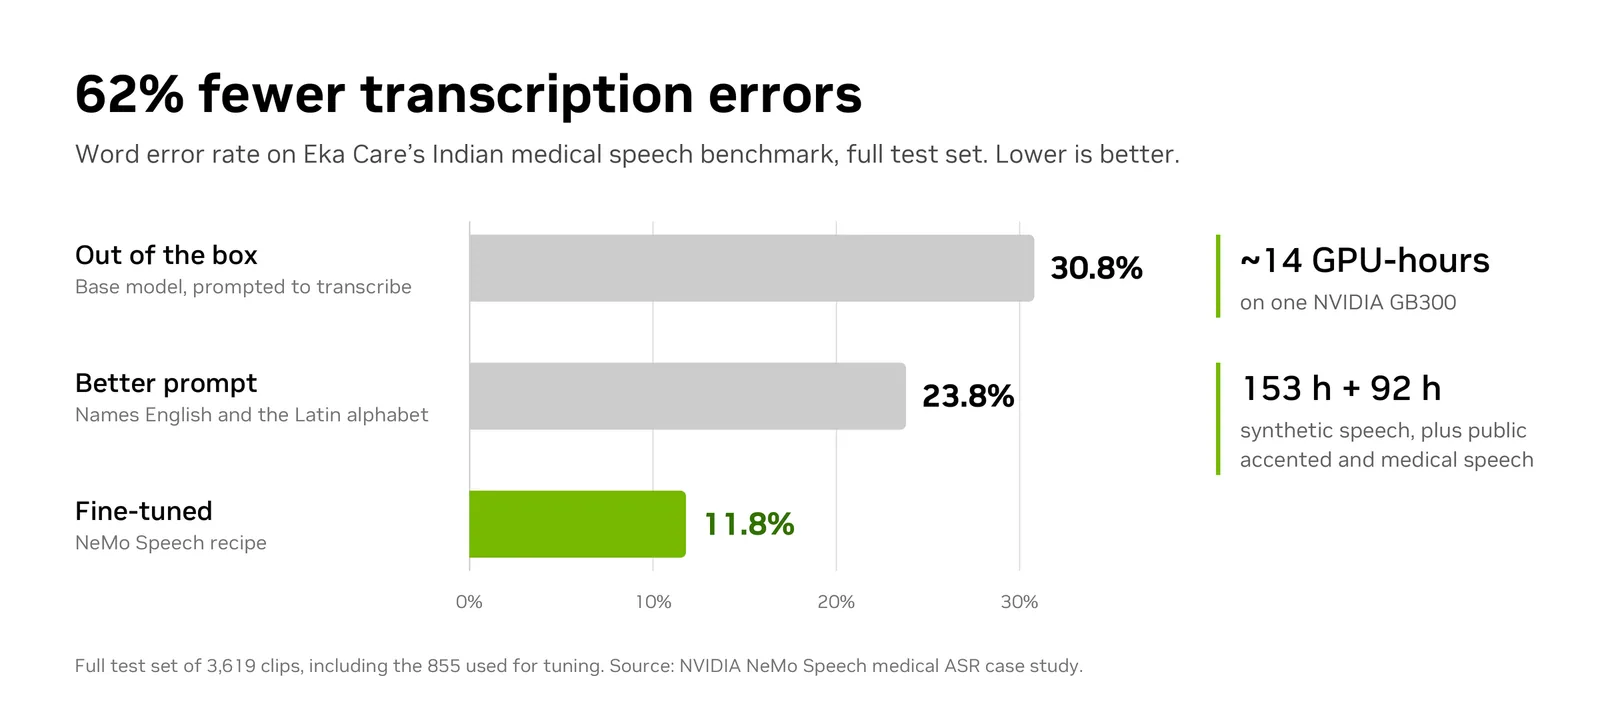
Setelah itu, NVIDIA ngelakuin fine-tuning ringan memakai NeMo Speech. Latihan ini memakai campuran 153 jam suara sintetis, 29 jam rekaman beraksen dari Common Voice, dan 63 jam rekaman medis MultiMed. Encoder suara dilatih bareng lapisan proyeksi, sementara model bahasanya diadaptasi pakai LoRA. Seluruh proses adaptasi ini cuma makan waktu sekitar 14 jam GPU di satu chip NVIDIA GB300.
Hasilnya mantap banget: waktu diuji ke 2.764 rekaman dokter baru (held-out clips) pakai sistem penilaian KARMA, nilai WER turun dari 22,44% jadi cuma 12,17%. Itu artinya ada penurunan error relatif sebesar 45,8%. Angka 12,17% ini bahkan sukses ngalahin model AI spesialis medis lain (13,79%) dan model ASR umum ternama (14,92%).
Cara Mencoba dan Menjalankan Nemotron 3.5 Transcribe
Penasaran pengin nyobain sendiri? Ada beberapa jalur gampang yang bisa kamu ambil sesuai kebutuhan sistem kamu:
- Tes Langsung di Browser: Kamu bisa coba demo interaktifnya tanpa bayar dan tanpa instalasi lewat Hugging Face Spaces atau ModelScope Studios.
- Self-Hosted di Server Sendiri: Kalau kamu punya server GPU mandiri, model ini sudah didukung sejak hari pertama rilis oleh inference engine kencang seperti vLLM dan SGLang-Omni.
- Pakai Endpoint Siap Pakai: Buat yang nggak mau ribet mikirin maintenance server, layanan hosting seperti Baseten, DeepInfra, dan Simplismart sudah nyediain API endpoint model ini.
- Jalankan di Laptop atau PC Lokal: NVIDIA bakal segera ngerilis NeMo-Speech.cpp bareng format kuantisasi NVFP4 biar bisa jalan enteng di GPU RTX laptop dan PC desktop.
Kalau hasil transkripsi suara kamu mau langsung dianalisis lebih lanjut—misalnya buat dirangkum jadi laporan, dicari poin kesepakatannya, atau diekstrak datanya—kamu bisa ngirim teksnya ke model bahasa cerdas lewat Classai Router. Pakai satu API key yang kompatibel dengan format OpenAI maupun Anthropic, kamu bisa mengoper teks transkrip ke model hemat seperti DeepSeek V4.1 Flash (Rp1.155 / 1 juta token input) atau GPT-4o mini (Rp945 / 1 juta token input) tanpa ribet gonta-ganti kodingan.
Kalau kamu seorang software engineer yang pengin mendalami cara menghubungkan model AI ke dalam alur kerja aplikasi nyata, kamu bisa belajar langkah demi langkahnya di kelas AI untuk Developer di Classai.
Dampak Nyata Buat Developer dan Bisnis di Indonesia
Kehadiran model AI suara berbobot terbuka kayak Nemotron 3.5 Transcribe ngasih beberapa solusi konkret buat kita di Indonesia:
- Keamanan Data dan Kepatuhan UU PDP: Rumah sakit, bank, dan kantor hukum di Indonesia terikat aturan ketat soal privasi data. Dengan model open-weight, semua rekaman sensitif bisa diproses di server lokal kantor sendiri tanpa perlu dikirim ke server luar negeri.
- Notula Rapat Campur Bahasa: Kebiasaan orang kantor di Indonesia yang sering campur bahasa Indonesia dan istilah Inggris (code-switching) terbantu banget lewat fitur penanda pembicara dan penerjemah otomatis.
- Efisiensi Biaya Operasional Call Center: Rekaman layanan pelanggan ribuan jam bisa ditranskrip dan dicek kualitasnya secara massal dengan biaya komputasi mandiri yang jauh lebih murah ketimbang langganan API tertutup per menit.
Langkah NVIDIA membuka bobot model dan resep pelatihannya bikin teknologi AI suara makin gampang dimanfaatkan. Sekarang giliran kamu buat nyobain dan buktiin sendiri di proyek aplikasimu berikutnya.
Sumber & referensi
- 01
Hugging Face · 28 Oktober 2026
NVIDIA Nemotron 3.5 Transcribe and Granary v2: Intelligent Multilingual Transcription You Can Prompt and Adapt - 02
TechCrunch · 28 Oktober 2026
Voice AI in vogue: Nvidia releases new open transcription model
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu NVIDIA Nemotron 3.5 Transcribe?
NVIDIA Nemotron 3.5 Transcribe adalah model AI pengenal suara (speech-to-text) open-weight berukuran 30 miliar parameter dengan 4 miliar parameter aktif. Model ini bisa mentranskripsi 40 bahasa, membedakan sampai 8 pembicara dalam 13 bahasa, menerjemahkan bahasa, dan menjawab pertanyaan audio lewat instruksi prompt teks.
Apakah Nemotron 3.5 Transcribe gratis digunakan?
Ya, model ini dirilis secara open-weight sehingga bisa diunduh dan digunakan gratis lewat platform Hugging Face dan ModelScope. Kamu bisa memasangnya di server GPU sendiri atau mencoba demo interaktifnya langsung lewat peramban web tanpa biaya.
Apakah Nemotron 3.5 Transcribe bisa untuk audio streaming real-time?
Tidak, model ini dirancang khusus untuk memproses berkas rekaman suara yang sudah tersimpan dengan durasi hingga satu jam. Nemotron 3.5 Transcribe belum mendukung pemrosesan percakapan langsung atau streaming suara berlatensi rendah.
Bagaimana cara menjalankan Nemotron 3.5 Transcribe?
Kamu bisa menjalankannya di server sendiri menggunakan inference engine vLLM atau SGLang-Omni. Untuk penggunaan lokal di komputer dengan kartu grafis NVIDIA RTX, NVIDIA segera merilis dukungan NeMo-Speech.cpp dengan format kuantisasi NVFP4.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.