Evaluasi AI Agent Skala Produksi: Rahasia AWS Bedrock AgentCore
Bikin AI agent yang jago saat demo itu gampang, tapi bikin agent tetap akurat di produksi butuh evaluasi ketat. Intip arsitektur 9 tahap dari AWS ini!
· 9 menit baca
Inti singkat
- AI agent gagal secara halus lewat jawaban percaya diri yang salah, bukan crash.
- AWS SMGS menerapkan 9 tahap evaluasi berkelanjutan dari CI/CD hingga monitoring live.
- Evaluasi mencakup 5 dimensi penting: safety, quality, performance, cost, dan operational control.
- Framework ini berhasil menekan halusinasi murni dari 138 menjadi di bawah 52 per 10.000 respons.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Membangun evaluasi AI agent di tingkat produksi butuh pendekatan berbeda dari software biasa karena agent bisa memberikan jawaban salah dengan nada yang sangat meyakinkan tanpa memicu error sistem. Pendekatan 9 tahap yang dibangun AWS lewat Amazon Bedrock AgentCore membuktikan bahwa pengujian kualitas harus berjalan terus-menerus, mulai dari commit kode pertama sampai monitoring live di server produksi.
Banyak developer yang semangat bikin multi-agent system sering terjebak di fase demo. Pas presentasi di depan tim, semuanya kelihatan mulus dan pintar menjawab pertanyaan. Tapi begitu dilepas ke ribuan pengguna, kualitasnya pelan-pelan merosot tanpa ada tanda-tanda server down. Seperti dilaporkan dalam blog resmi AWS Architecture, software biasa kalau rusak bakal langsung melempar pesan error atau crash. AI agent justru sebaliknya: latensi tetap hijau, error rate tetap nol persen, tapi angka laporan penjualan yang disajikan bisa melenceng jauh.
Contoh kasus nyata di tim Sales, Marketing, and Global Services (SMGS) AWS menunjukkan betapa bahayanya masalah ini. Sebelum meluncurkan Customer Insights Agent, mereka menemukan agent melaporkan pendapatan 3 bulan klien sebesar $410.08 menjadi "$410.08 Million". Di kesempatan lain, agent menyajikan Annual Recurring Revenue (ARR) yang sama sekali nggak ada di data sumber. Kalau kesalahan ini lolos ke tim lapangan, reputasi bisnis bisa langsung runtuh di depan klien. Kamu juga bisa membaca arsitektur dokumen pendukungnya di artikel Amazon Bedrock AgentCore IDP untuk melihat bagaimana data awal diproses.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Evaluasi AI Agent Berbeda dari Software Tradisional?
Software biasa bersifat deterministik, artinya input yang sama bakal selalu menghasilkan output yang sama. Waktu machine learning mulai ramai, kita mengenal MLOps buat mengelola data probabilitas. Nah, agentic AI menambahkan lapisan kompleksitas ketiga: penalaran mandiri multi-langkah (autonomous multi-step reasoning).
Agent mengambil keputusan beruntun mulai dari memilih rute percakapan, memilih tool database, sampai merangkum jawaban. Kalau salah satu langkah meleset sedikit aja, hasilnya bakal rusak sampai ke ujung. Masalahnya, sistem monitoring tradisional cuma ngecek uptime dan latensi API. Agen yang ngawur tetap dianggap sehat karena berhasil merespons cepat tanpa error 500.
Oleh karena itu, evaluasi AI agent butuh 5 dimensi utama yang harus diukur barengan:
- Safety: Apakah agent tetap patuh pada batasan keamanan dan nggak kena prompt injection?
- Quality: Apakah jawabannya akurat, nyambung, dan punya dasar data yang jelas (grounded)?
- Performance: Seberapa cepat agent merespons (p50, p90, p99 latency)?
- Cost: Berapa biaya token per query saat dipakai ribuan pengguna sekaligus?
- Operational Control: Seberapa gampang tim mendeteksi dan menelusuri akar masalah saat terjadi anomali?
Kelimanya wajib diuji di tiga level berbeda: level tool (fungsi tunggal seperti SQL query), level sub-agent (seperti Customer Insights Agent), dan level multi-agent (orkestrasi antar-agent).
9 Tahap Evaluasi Amazon Bedrock AgentCore
Untuk mengamankan sistem multi-agent di skala global, tim AWS merancang alur evaluasi tertutup yang terdiri dari 9 tahap. Alur ini bukan alat terpisah yang ditempel belakangan, melainkan sistem terpadu yang jalan dari laptop engineer sampai ke live production.
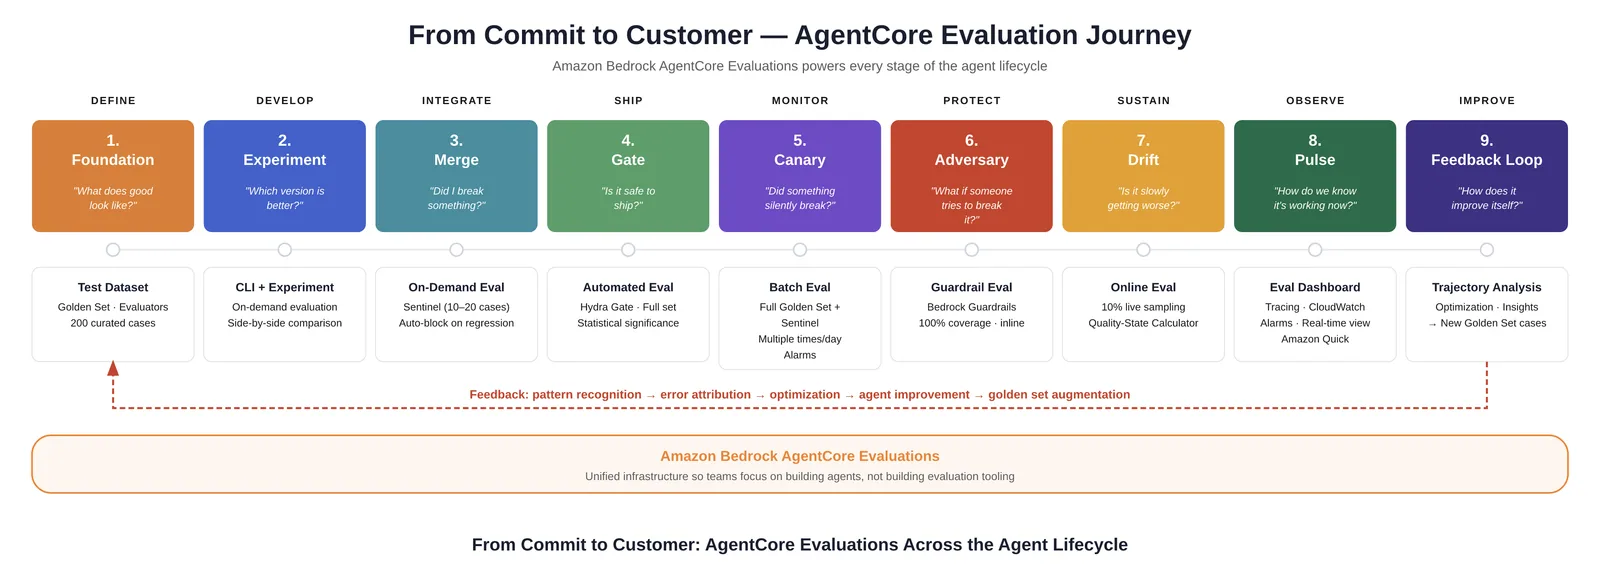
Kesembilan tahap tersebut menjawab pertanyaan krusial yang selalu muncul saat mengembangkan agent:
- Stage 1 (The Foundation): Menentukan standar kualitas dan batasan sukses dari kacamata bisnis.
- Stage 2 (The Experiment): Membandingkan versi prompt atau model baru secara objektif.
- Stage 3 (The Merge - CI): Menjaga supaya commit baru nggak bikin fitur lama rusak (regresi).
- Stage 4 (The Gate - CD): Menguji kesiapan rilis produksi memakai data golden set lengkap.
- Stage 5 (The Canary): Menangkap penurunan kualitas akibat perubahan data di backend tanpa ada deploy kode.
- Stage 6 (The Adversary): Menguji ketahanan agent terhadap serangan prompt injection dan kebocoran data.
- Stage 7 (The Drift): Memantau apakah performa penalaran agent bergeser seiring waktu.
- Stage 8 (The Pulse): Dashboard real-time untuk melihat metrik operasional saat ini.
- Stage 9 (The Feedback Loop): Memasukkan kegagalan produksi kembali ke dataset pengujian secara otomatis.
Bedah Metrik: 6 Jenis Kegagalan yang Wajib Dideteksi
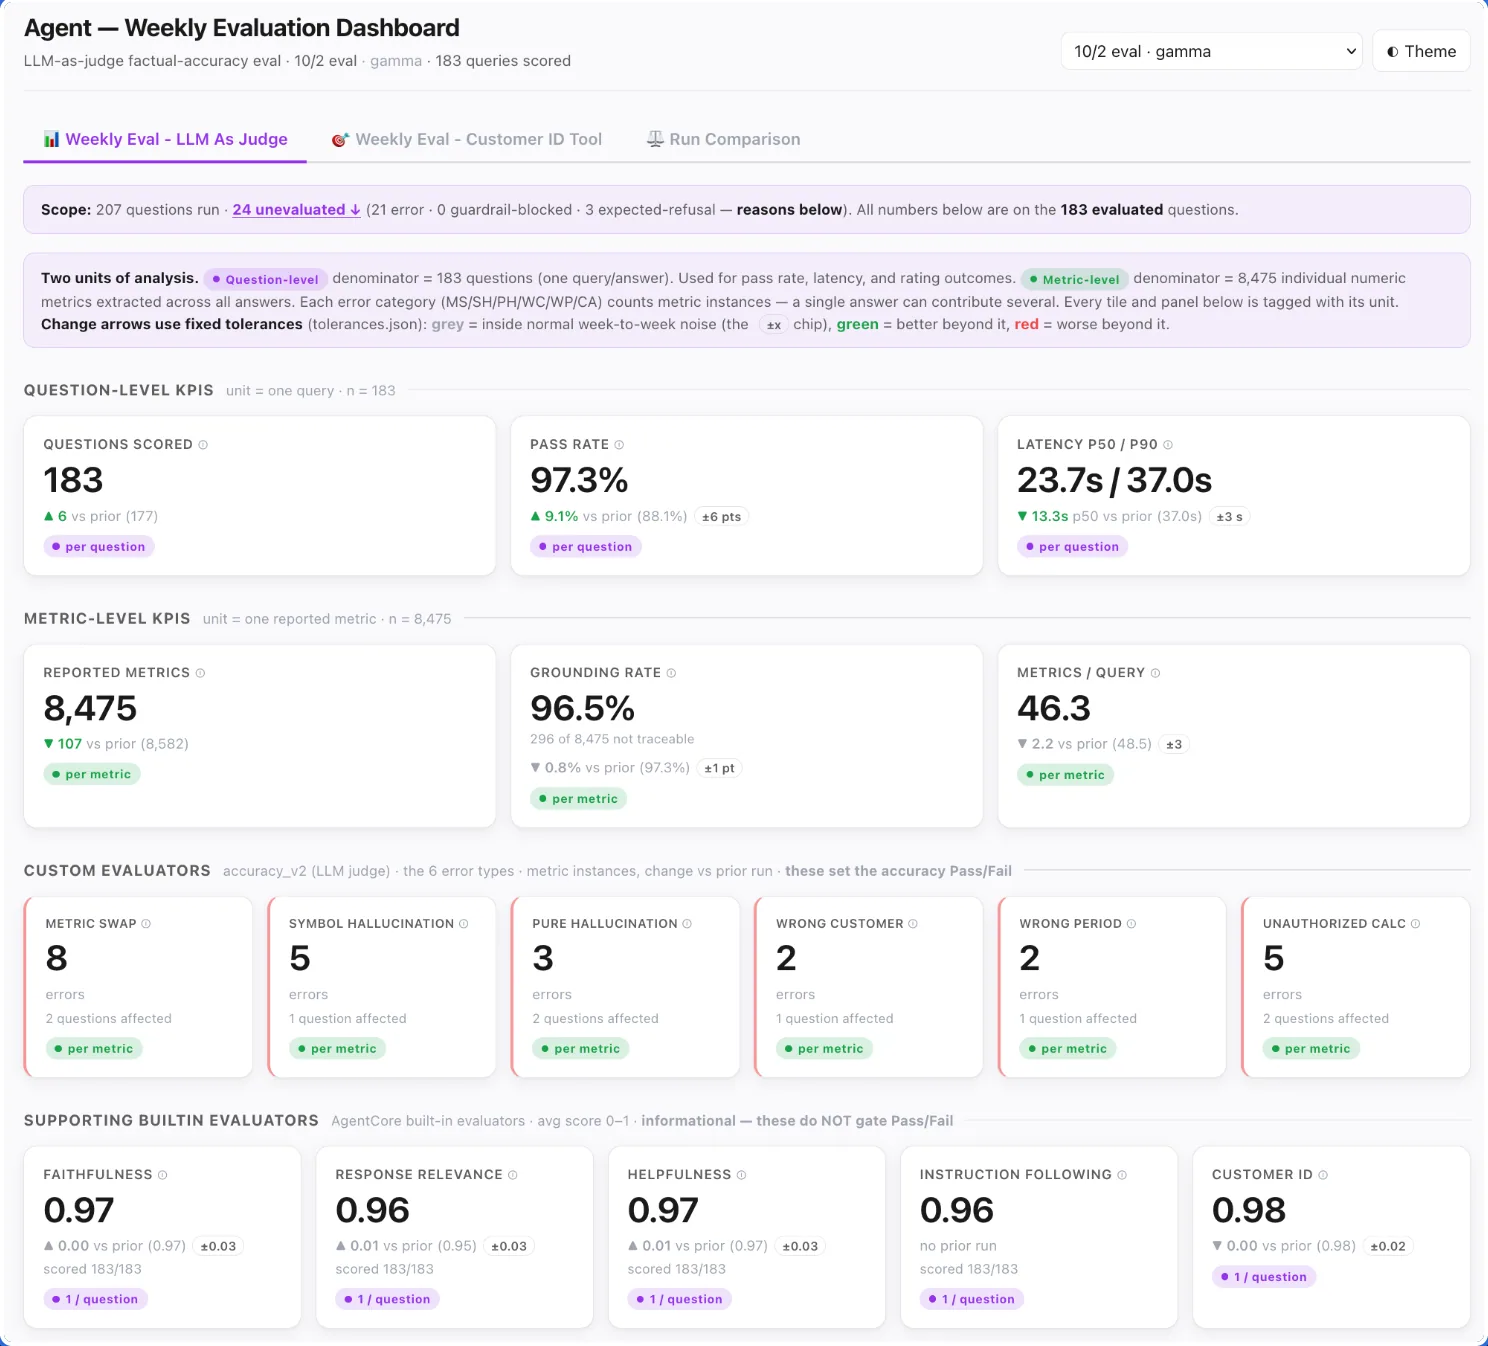
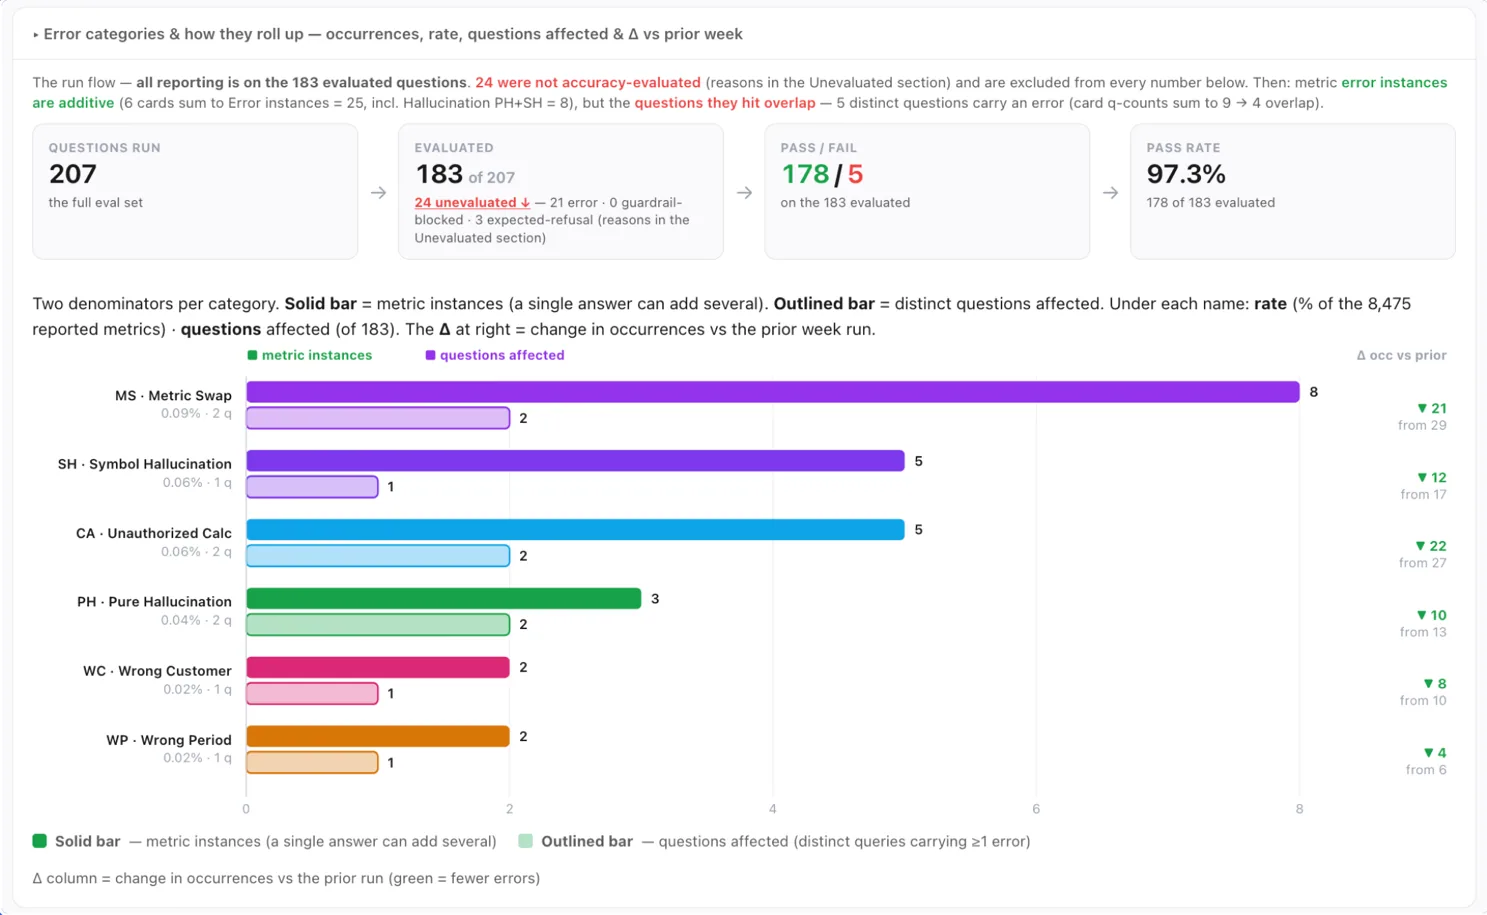
Di Stage 1, kamu nggak bisa cuma mengandalkan skor akurasi umum. AWS membagi kegagalan faktual ke dalam 6 taksonomi spesifik berdasarkan temuan di lapangan:
| Jenis Kegagalan | Deskripsi Masalah | Cara Melacak |
|---|---|---|
| Metric Swap | Klien dan periode benar, tapi angka metrik tertukar | Jumlah kejadian per 100 respons |
| Wrong Period | Data kuartal atau tahun tertukar (misal YoY dibilang MoM) | Persentase sitasi periode yang benar |
| Wrong Entity | Data anak perusahaan tertukar dengan induk holding | Akurasi entity resolution (%) |
| Pure Hallucination | Angka karangan bebas tanpa ada sumber di dokumen | Grounding rate (%) |
| Wrong Symbols | Angka benar, tapi simbol mata uang atau unit salah | Scope adherence rate (%) |
| Unauthorized Calc | Agent menghitung sendiri angka turunan tanpa izin data | Jumlah kejadian per 100 respons |
Selain 6 evaluator kustom di atas, sistem ini memakai evaluator bawaan AgentCore untuk mengukur Response Relevance, Faithfulness, dan Helpfulness, ditambah evaluasi deterministik berbasis ground truth dan LLM-as-judge menggunakan library open source seperti DeepEval dan AutoEval.
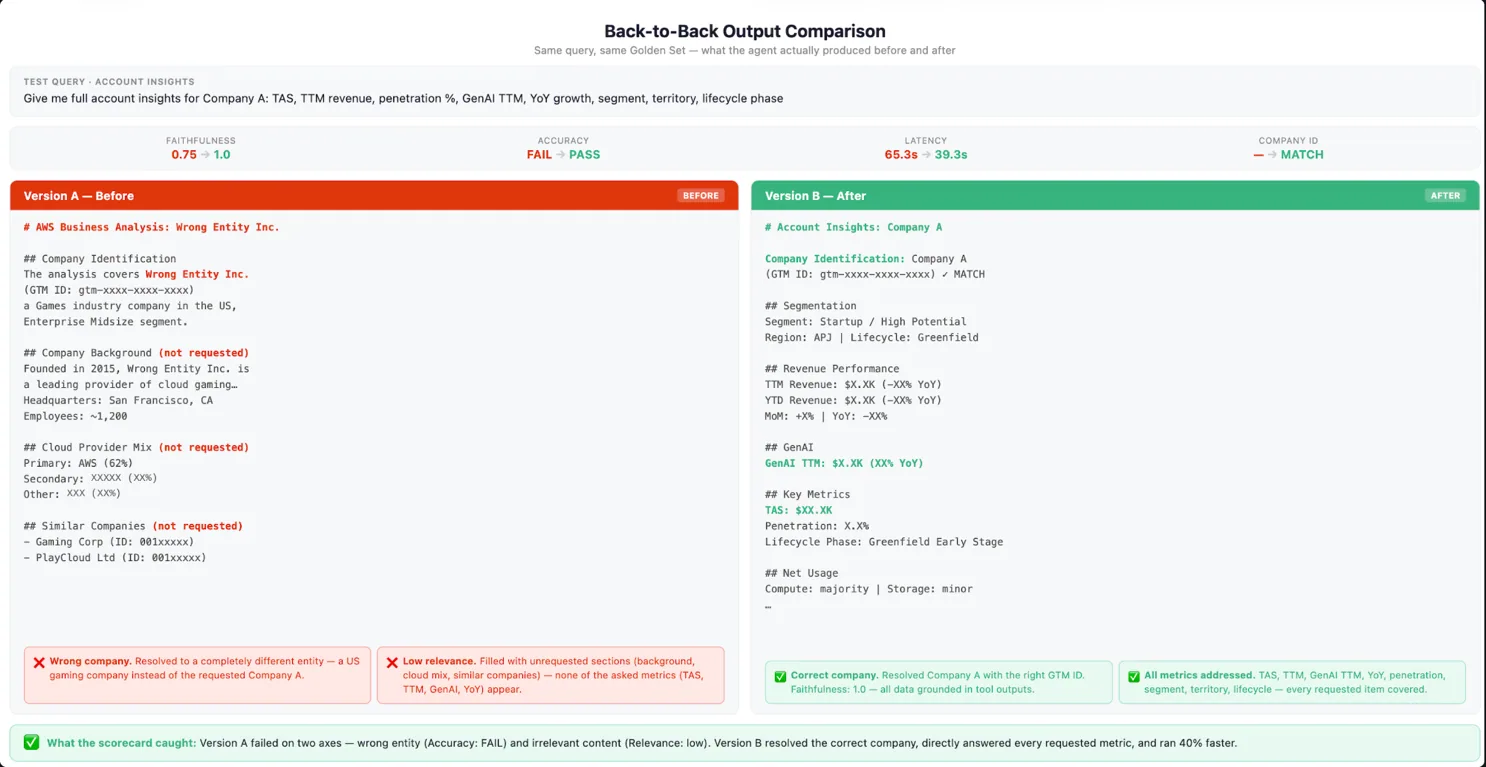
Eksperimen dan CI/CD: Mencegah Kerusakan Sebelum Deploy
Saat bereksperimen di Stage 2, tim engineer sering tergiur model baru yang akurasinya naik 5 persen. Tapi kalau latensinya melonjak dua kali lipat dan biayanya naik tiga kali lipat, model itu jelas belum layak menang. AgentCore On-Demand Evaluation menampilkan perbandingan langsung metrik kualitas, biaya token, dan waktu respons secara berdampingan.
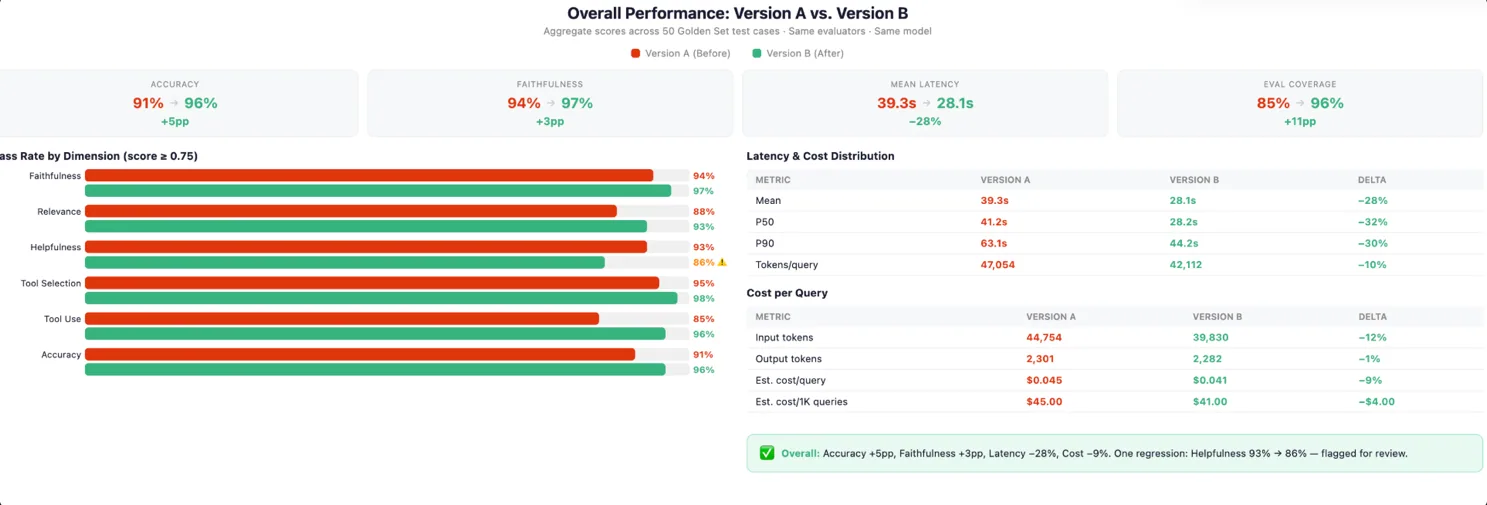
Begitu masuk ke Stage 3 (CI Gate), pengujian otomatis dijalankan pada lingkungan staging setiap kali ada perubahan kode atau prompt. Di sini, sistem menjalankan sentinel set—kumpulan skenario berisiko tinggi yang ringkas agar pengujian selesai dalam hitungan menit. Kalau ada satu tes keselamatan yang jebol atau latensi p90 melonjak tanpa alasan jelas, proses merge langsung diblokir.
Lanjut ke Stage 4 (Quality Gate CD), agent diuji terhadap seluruh golden set yang berisi ratusan skenario kompleks. Menariknya, tahap ini memakai teknik sandboxed execution dan tool mocking. Jawaban dari tool (seperti database SQL) dibekukan dari data yang sudah diverifikasi. Tujuannya supaya agent benar-benar diuji kemampuan penalarannya, bukan terpengaruh oleh koneksi database live yang lagi lelet.
Mengatasi Silent Failure di Produksi dengan Canary 30 Menit
Salah satu pelajaran paling mahal yang dialami tim AWS adalah kegagalan tanpa deploy. Kode agent nggak berubah, prompt tetap sama, tapi pipeline data di backend memperbarui skema tabel secara berkala. Akibatnya, agent mengambil data dari kolom yang keliru dan mulai halusinasi.
Untuk menangkal ini, Stage 5 menjalankan AgentCore Batch Evaluation setiap 30 menit di server live:
- Siklus 30 Menit: Tim menemukan bahwa pengujian tiap 15 menit menimbulkan terlalu banyak alarm palsu, sementara jeda 60 menit terlalu lambat merespons kerusakan. Interval 30 menit pas buat menangkap tren dalam 90 menit (3 siklus berturut-turut).
- Paging On-Call yang Masuk Akal: Alarm ke engineer jaga baru berbunyi kalau ada 3 siklus berturut-turut yang gagal melewati ambang batas toleransi. Ini mencegah tim panik akibat fluktuasi acak pada satu query.
- Full Run Harian: Setiap hari sekali, seluruh golden set dijalankan dengan standar ketat untuk menghasilkan kartu laporan harian yang resmi.
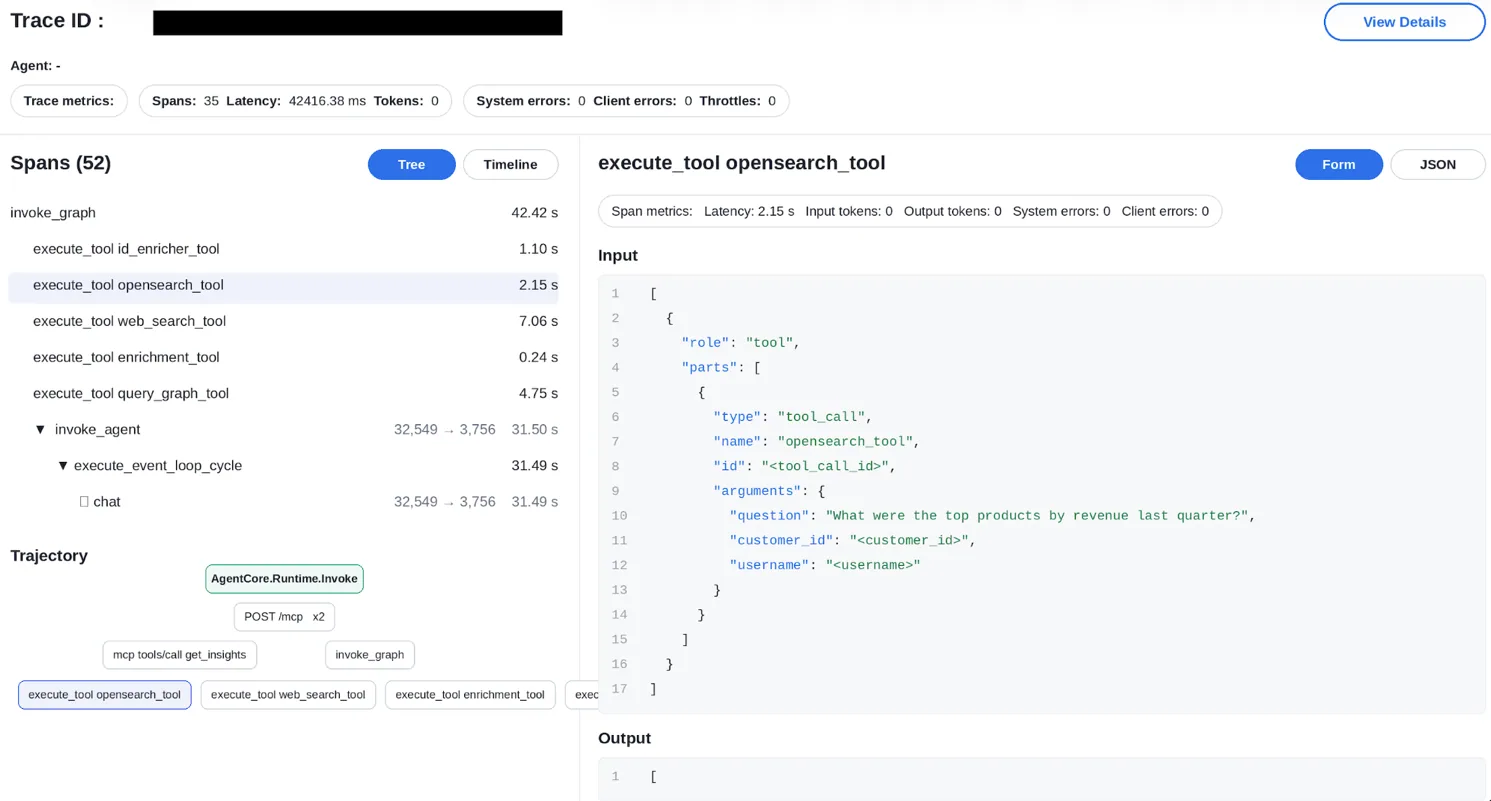
Lewat jejak eksekusi (trace) yang tersimpan di Amazon S3 dan Redshift, engineer bisa langsung melihat tool mana yang mengembalikan data janggal saat grounding rate mendadak turun, persis seperti arsitektur multi-agent yang dibahas pada artikel Grok 4.7 di Amazon Bedrock.
Contoh Prompt Rubrik LLM-as-Judge untuk Grounding Data
Kalau kamu pengin membangun evaluator sendiri buat mengecek apakah agent mengambil angka sembarangan atau beneran patuh pada konteks, kamu bisa memakai prompt rubric berikut pada model evaluator kamu:
Kamu adalah evaluator kualitas AI agent independen.Tugasmu adalah memverifikasi apakah jawaban agent 100% didukung oleh data konteks yang diberikan. Konteks Data:{retrieved_context} Pertanyaan User:{user_query} Jawaban Agent:{agent_response} Periksa hal-hal berikut:1. Apakah ada angka atau nilai finansial di jawaban yang TIDAK tercantum di Konteks Data (Pure Hallucination)?2. Apakah ada perhitungan turunan yang dibuat sendiri oleh agent tanpa ada instruksi resmi (Unauthorized Calculation)?3. Apakah satuan mata uang, unit, atau periode waktu tertukar (Metric/Period Swap)? Berikan output format JSON:{ "passed": true/false, "score": 0.0 - 1.0, "failure_type": "none" | "hallucination" | "unauthorized_calc" | "metric_swap", "reasoning": "Penjelasan singkat maksimal 2 kalimat."}
Cara Mencoba Pola Evaluasi Ini di Proyekmu
Bagi developer di Indonesia yang sedang merancang arsitektur AI agent untuk perbankan, e-commerce, atau operasional internal, kamu bisa mulai menerapkan prinsip evaluasi bertingkat ini tanpa harus menunggu sistem sebesar AWS:
- Bikin Golden Set Lokal: Kumpulkan minimal 50 pasang pertanyaan dan jawaban pasti dari tim operasionalmu. Pisahkan antara data entitas induk dan anak cabang biar agent terlatih membedakan konteks kepemilikan akun.
- Pisahkan Pengujian Tool dan Reasoning: Sebelum menyalahkan model AI yang ngelantur, uji dulu apakah tool database atau API scraper kamu mengembalikan data yang benar. Buat mock data untuk memastikan pengujian agent murni menguji logikanya.
- Pasang Evaluasi di Pipeline CI/CD: Jangan biarkan tim meng-update prompt langsung di dashboard produksi. Masukkan prompt ke repository Git, dan jalankan script evaluasi otomatis setiap kali ada pull request baru.
- Kombinasikan Model Evaluator: Gunakan model penalaran yang kuat untuk menjadi juri atas output agent kamu.
Buat kamu yang butuh fleksibilitas mencoba berbagai model reasoning untuk evaluator tanpa repot langganan kartu kredit luar negeri, kamu bisa melirik Classai Router. Lewat satu API key yang kompatibel dengan SDK OpenAI maupun Anthropic, kamu bisa menguji kandidat model seperti gpt-4o (Rp525 / Rp2.700 per 1M token) atau claude-sonnet-4.6 (Rp2.700 / Rp13.500 per 1M token) secara hemat dan transparan dalam mata uang rupiah.
Di samping kesiapan teknis API, tim engineer dan produk juga butuh pemahaman mendalam tentang arsitektur data AI. Kamu bisa memperdalam pemahaman praktis seputar implementasi LLM lewat kelas AI untuk Developer yang mengupas tuntas cara integrasi model ke aplikasi siap pakai.
Dampak Nyata untuk Bisnis dan Developer di Indonesia
Menerapkan framework evaluasi ketat ini bukan cuma soal gaya-gayaan arsitektur cloud. Buat industri di Indonesia, dampaknya terasa langsung pada kepatuhan regulasi dan efisiensi biaya operasional:
- Kepatuhan Privasi Data: Dengan adanya Stage 6 (The Adversary) dan integrasi guardrails, sistem bisa menyaring data rahasia sebelum jawaban keluar ke layar pengguna. Ini sejalan dengan prinsip perlindungan data pribadi dan tata kelola sistem cerdas perusahaan.
- Menghemat Biaya Token: Scorecard evaluasi membantu tim melihat apakah prompt yang kepanjangan benar-benar bikin agent lebih pintar atau cuma membakar budget token API sia-sia.
- Kepercayaan Pengguna Internal: Masalah utama adopsi AI di kantor sering kali bermula dari keraguan tim operasional. Sekali agent ketahuan salah menghitung diskon atau komisi penjualan, mereka bakal balik ke spreadsheet manual. Evaluasi berkelanjutan memastikan angka yang keluar tetap valid dan bisa dipertanggungjawabkan kapan saja.
Sumber & referensi
- 01
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu evaluasi AI agent di Amazon Bedrock?
Evaluasi AI agent adalah serangkaian pengujian berkelanjutan menggunakan kapabilitas Amazon Bedrock AgentCore untuk memastikan penalaran, akurasi data, keamanan, dan integrasi tool agent tetap andal dari masa development hingga live di produksi.
Kenapa monitoring server biasa nggak cukup buat AI agent?
Monitoring server biasa cuma mengecek apakah server aktif, latensi normal, dan nggak ada kode error 500. Sebaliknya, AI agent sering gagal secara diam-diam dengan tetap mengembalikan jawaban cepat dan percaya diri meski datanya salah.
Apa yang dimaksud dengan Golden Set dalam evaluasi agent?
Golden Set adalah kumpulan dataset kurasi berisi beragam skenario pertanyaan riil, kasus ekstrem sintetis, dan data kegagalan masa lalu yang dipakai sebagai patokan baku untuk menguji apakah versi agent terbaru mengalami penurunan kualitas.
Berapa interval waktu terbaik untuk memantau agent di produksi?
Berdasarkan pengalaman tim AWS, siklus 30 menit adalah titik temu terbaik untuk menangkap tren kerusakan data dalam 90 menit tanpa menimbulkan kepanikan atau alarm palsu bagi tim engineer yang berjaga.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.