Agentic Retrieval Bedrock Knowledge Base Kini Dukung Single-Shot RAG
AWS memperbarui AgenticRetrieveStream di Amazon Bedrock Knowledge Base. Sekarang kamu bisa milih single-shot RAG, agentic retrieval, atau cari dokumen murni cukup dari satu API.
· 10 menit baca
Inti singkat
- API AgenticRetrieveStream kini mendukung rentang maxAgentIteration dari 0 sampai 5 untuk mengatur proses pencarian.
- Nilai 1 menjalankan single-shot RAG tanpa ronde perencanaan, memangkas latensi dan biaya pemanggilan model bahasa.
- Nilai 0 mengembalikan potongan teks asli tanpa memanggil LLM sama sekali, setara dengan pemanggilan Retrieve API.
- Mode agentic dengan nilai 2 sampai 5 memberikan hingga n minus 1 ronde perencanaan untuk pertanyaan perbandingan yang rumit.
- Ketiga mode bisa mencari ke beberapa knowledge base sekaligus tanpa perlu membangun sistem orkestrasi terpisah.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Amazon Bedrock Managed Knowledge Base resmi mendukung single-shot RAG dan permintaan retrieval-only lewat satu API terpadu, AgenticRetrieveStream. Pembaruan ini bikin developer nggak perlu lagi bikin dua sistem terpisah cuma buat ngebedain pertanyaan simpel dan pertanyaan komparatif yang butuh banyak langkah.
Sebelum pembaruan ini rilis, developer yang mengaktifkan fitur pencarian berbasis agen sering kali harus menanggung latensi dan biaya tambahan untuk pertanyaan yang sebenarnya sangat sederhana. Seperti dilaporkan dalam pengumuman resmi AWS Machine Learning Blog, kini parameter maxAgentIteration diperluas ke rentang 0 sampai 5. Kamu bisa membaca panduan teknisnya di dokumentasi Agentic Retrieval AWS serta referensi API AgenticRetrieveStream.
Langkah ini menyederhanakan alur kerja arsitektur sistem berbasis agen yang sebelumnya sering dibahas di artikel seperti /developer/taksonomi-agen-amazon-quick. Yuk, kita bedah cara kerja fitur baru ini, detail pengaturannya, sampai contoh penerapannya di aplikasi internal.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu Agentic Retrieval Bedrock Knowledge Base?
Agentic retrieval adalah pendekatan pencarian cerdas di mana model fondasi (FM) memecah pertanyaan rumit jadi beberapa sub-pertanyaan terarah. Model bakal mencari informasi ke knowledge base, mengevaluasi apakah bukti yang didapat sudah cukup buat menjawab, lalu mengulang pencarian kalau masih ada bagian yang bolong.
Cara kerja ini punya kelebihan tersendiri:
- Mendukung pertanyaan bercabang: Pencarian dilakukan bertahap buat tiap topik bahasan, bukan memaksakan satu kata kunci umum untuk merangkum seluruh kerumitan.
- Melakukan pencarian lanjutan mandiri: Perencana (planner) di dalam sistem bisa membaca hasil pencarian pertama buat menentukan kata kunci berikutnya, bahkan menarik dokumen utuh jika potongan teks dirasa kurang lengkap.
- Jawaban lengkap dengan sitasi: Sistem menyusun jawaban akhir yang terikat langsung pada sumber dokumen pendukung beserta kutipannya.
- Bebas orkestrasi manual: Kamu nggak perlu lagi repot ngoding looping, evaluasi dokumen, dan pemanggilan berulang sendiri lewat kode aplikasi.
Meski jago banget nanganin pertanyaan rumit, cara kerja berbasis agen ini terasa terlalu berat kalau traffic aplikasi kamu cuma menanyakan hal-hal langsung seperti daftar syarat atau prosedur singkat. Di sinilah opsi single-shot RAG dan retrieval-only masuk buat melengkapi sistem.
Cara Hitung Iterasi di AgenticRetrieveStream: Rumus Biar Nggak Bingung
Kunci utama dari fleksibilitas fitur baru ini terletak pada pemahaman cara sistem menghitung iterasi. Di Bedrock Knowledge Base, satu iterasi dihitung setara dengan satu kali pemanggilan model fondasi (LLM call).
Siklus pencarian selalu diakhiri dengan tepat satu pemanggilan model untuk pembuatan jawaban (answer-generation call). Kalau kamu memberikan nilai $n$ pada parameter maxAgentIteration, aplikasi kamu membeli ruang maksimal hingga $n - 1$ ronde perencanaan (planning rounds), dengan iterasi terakhir disisihkan khusus untuk merangkum jawaban akhir.
Tiap ronde perencanaan terdiri dari satu proses penulisan ulang kueri (query rewrite) ditambah satu kali pencarian dokumen. Makin besar nilai iterasi, makin leluasa sistem membedah pertanyaan sulit, tapi waktu tunggu respon juga bakal makin panjang. Sebaliknya, makin kecil nilainya, latensi bakal makin singkat dan terprediksi.
Ada satu hal menarik yang nggak dihitung ke dalam kuota iterasi: speculative retrieval. Pencarian awal yang berjalan otomatis sebelum langkah perencanaan pertama itu murni proses retrieval data, bukan iterasi model. Langkah ini sama sekali nggak memotong kuota maxAgentIteration kamu dan fungsinya murni bikin respon pertama terasa lebih kencang.
Bedah 3 Mode Utama: Dari Tanpa LLM Sampai Agen Penuh
Dengan rentang nilai baru dari 0 sampai 5, kamu punya kendali penuh untuk menentukan seberapa dalam Bedrock Knowledge Base harus menggali data. Menariknya, semua mode ini sudah mendukung pencarian ke beberapa knowledge base sekaligus, bahkan pada setelan terendah.
Nilai maxAgentIteration | Apa yang Kamu Dapatkan | Skenario Penggunaan Terbaik |
|---|---|---|
| 0 | Satu kali pencarian, tanpa generasi teks, nol pemanggilan LLM | Menampilkan dokumen asli; cocok untuk tim yang sudah standar memakai API ini |
| 1 | Satu kali pencarian ditambah satu jawaban langsung | Single-shot RAG untuk pertanyaan terarah dan dokumen yang jelas letaknya |
| 2 sampai 5 | Hingga $n - 1$ ronde perencanaan, lalu perumusan jawaban | Pertanyaan komparatif, eksploratif, multi-bagian, dan lintas dokumen |
maxAgentIteration = 1: Single-Shot RAG (Solusi Paling Dicari)
Mode ini menjalankan pola RAG klasik: cari dokumen sekali, lalu rumuskan jawaban sekali. Nggak ada perencana yang membedah kueri, nggak ada penulisan ulang pertanyaan, dan nggak ada langkah pengecekan berulang. Model langsung mengambil data relevan dari prompt awal, membaca kutipan yang ditemukan, lalu menuliskan jawaban yang terikat pada data tersebut.
Mode ini wajib dipasangkan dengan setelan generateResponse=true. Kalau aplikasi internal kantor kamu didominasi oleh pencarian fakta harian yang sumbernya sudah pasti, jadikan setelan nilai 1 ini sebagai default agar biaya dan latensi tetap irit.
maxAgentIteration = 0: Pencarian Dokumen Murni Tanpa LLM
Di opsi ini, sistem cuma melakukan satu kali pencarian dokumen tanpa memanggil model bahasa sama sekali. Respon yang balik murni berupa potongan teks (passages) sumber aslinya. Perilaku ini persis seperti kamu memanggil Retrieve API secara langsung.
Keuntungannya, developer yang sistemnya sudah telanjur distandarisasi memakai AgenticRetrieveStream nggak perlu lagi bikin rute API berbeda saat user cuma butuh bahan bacaan mentah. Di mode ini, parameter generateResponse wajib disetel ke false. Kalau kamu nekat memasang true, sistem bakal langsung melempar kode eror 4xx karena pembuatan jawaban mustahil berjalan tanpa pemanggilan LLM.
maxAgentIteration = 2 Sampai 5: Mode Berbasis Agen Penuh
Mode ini mempertahankan fitur agen pencari yang sudah ada sebelumnya. Model fondasi bakal mengevaluasi konteks secara dinamis. Bila dokumen pertama dirasa belum menjawab seluruh aspek pertanyaan, ia bakal merumuskan kueri baru dan mengecek koleksi data lainnya.
Setelan ini sangat pas untuk kebutuhan analisis mendalam, membaca perbandingan klausul hukum, atau meneliti regulasi yang tersebar di beberapa buku panduan tebal.
Studi Kasus Asisten Bank: Kapan Pakai Tiap Pengaturan?
Untuk memahami skenario lapangannya, mari kita lihat simulasi tim operasional perbankan fiktif yang memakai asisten internal AI. Knowledge base bank ini berisi SOP pembukaan rekening, daftar berkas persyaratan, dan dokumen pedoman kepatuhan.
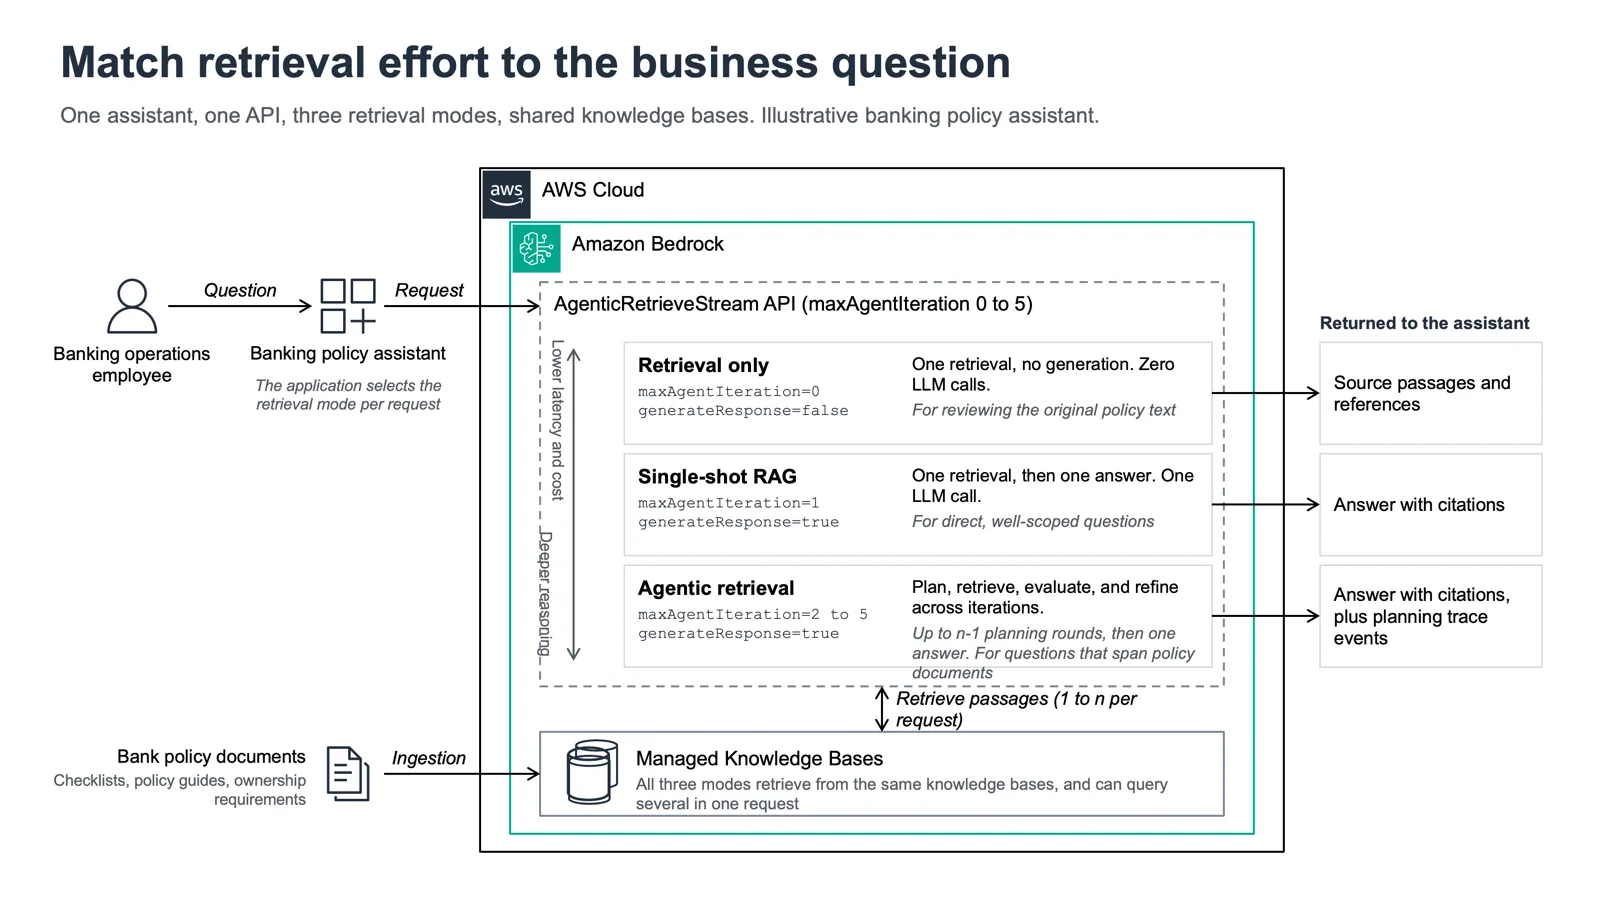
Pegawai bank berinteraksi dengan satu antarmuka obrolan yang sama, tetapi logika backend aplikasi menentukan beban pencarian yang berbeda untuk tiga situasi berikut:
1. Menjawab Pertanyaan Berkas yang Pasti
Seorang staf bertanya: "Dokumen apa saja yang dibutuhkan untuk membuka rekening giro bisnis bagi pemilik usaha perorangan?"
Karena jawaban pertanyaan ini sudah ada di dalam satu dokumen daftar periksa (checklist) standar, aplikasi menyetel maxAgentIteration=1 dan generateResponse=true. Sistem langsung menarik berkas tersebut dan merangkum isinya dalam hitungan detik tanpa membuang waktu untuk ronde perencanaan kueri.
2. Membandingkan Aturan Antar Dokumen Kebijakan
Staf lain bertanya: "Bagaimana perbedaan syarat pembukaan rekening antara usaha perorangan dan perseroan terbatas (PT), serta apa saja pemeriksaan tambahan bagi pemilik non-residen menurut kebijakan kita?"
Pertanyaan ini butuh data dari panduan verifikasi identitas, SOP kepemilikan modal, dan aturan nasabah asing. Aplikasi langsung memasang maxAgentIteration=4 dan generateResponse=true. Di sini, perencana model membagi topik menjadi tiga pencarian terpisah, mengumpulkan semua bukti pendukung, lalu menyajikan jawaban komparatif yang lengkap dengan sitasi.
3. Membaca Teks Kebijakan Asli Tanpa Parafrase AI
Seorang petugas kepatuhan butuh meninjau kata demi kata dari pasal pembukaan rekening untuk keperluan audit. Staf tersebut meminta teks kebijakan aslinya langsung, bukan ringkasan AI.
Aplikasi menerapkan maxAgentIteration=0 dan generateResponse=false. Potongan teks asli langsung dialirkan ke layar staf tanpa sentuhan parafrase model fondasi sedikit pun.
Contoh Kode Request JSON Buat Ketiga Mode
Semua skenario di atas memakai struktur payload yang mirip pada pemanggilan AgenticRetrieveStream. Perbedaannya cuma ada di parameter generateResponse dan blok agenticRetrieveConfiguration.
1. Payload untuk Single-Shot RAG (maxAgentIteration: 1)
Berikut format request buat kueri langsung yang hemat komputasi:
{
  "messages": [
    {
      "content": {
        "text": "Dokumen apa saja yang dibutuhkan untuk membuka rekening bisnis perorangan?"
      },
      "role": "user"
    }
  ],
  "retrievers": [
    {
      "description": "Knowledge base prosedur pembukaan rekening dan pedoman kebijakan",
      "configuration": {
        "knowledgeBase": {
          "knowledgeBaseId": "KB12345678"
        }
      }
    }
  ],
  "generateResponse": true,
  "agenticRetrieveConfiguration": {
    "foundationModelType": "MANAGED",
    "rerankingModelType": "MANAGED",
    "maxAgentIteration": 1
  }
}
Respon stream yang masuk ke aplikasi kamu bakal langsung berisi potongan dokumen rujukan beserta satu jawaban terstruktur, tanpa diselingi event penulisan kueri ulang (trace events).
2. Payload untuk Dokumen Mentah (maxAgentIteration: 0)
Kalau kamu cuma butuh teks aslinya tanpa keterlibatan LLM perangkum, matikan respon generasi:
{
  "messages": [
    {
      "content": {
        "text": "Tampilkan teks regulasi pembukaan rekening bisnis perorangan."
      },
      "role": "user"
    }
  ],
  "retrievers": [
    {
      "description": "Knowledge base prosedur pembukaan rekening dan pedoman kebijakan",
      "configuration": {
        "knowledgeBase": {
          "knowledgeBaseId": "KB12345678"
        }
      }
    }
  ],
  "generateResponse": false,
  "agenticRetrieveConfiguration": {
    "foundationModelType": "MANAGED",
    "rerankingModelType": "MANAGED",
    "maxAgentIteration": 0
  }
}3. Payload untuk Mode Agen Penuh (maxAgentIteration: 4)
Untuk pertanyaan lintas bab yang membutuhkan pemikiran bertahap, naikkan batas iterasinya:
{
  "messages": [
    {
      "content": {
        "text": "Bandingkan syarat rekening perorangan dan PT serta aturan pemilik non-residen."
      },
      "role": "user"
    }
  ],
  "retrievers": [
    {
      "description": "Knowledge base prosedur pembukaan rekening dan pedoman kebijakan",
      "configuration": {
        "knowledgeBase": {
          "knowledgeBaseId": "KB12345678"
        }
      }
    }
  ],
  "generateResponse": true,
  "agenticRetrieveConfiguration": {
    "foundationModelType": "MANAGED",
    "rerankingModelType": "MANAGED",
    "maxAgentIteration": 4
  }
}
Cara Mengatur Routing Mode di Aplikasi Kamu
Satu hal krusial yang perlu diingat: parameter maxAgentIteration tidak melakukan penentuan rute secara otomatis. AWS menyerahkan sepenuhnya logika pemilihan mode kepada arsitektur aplikasi kamu.
Berikut beberapa cara praktis yang bisa kamu terapkan di sisi aplikasi:
- Deteksi Berdasarkan Peran Pengguna (Role-Based): Jika sistem dipakai oleh tim audit atau legal yang memang butuh teks pasal murni, setel aplikasi untuk selalu melempar mode
maxAgentIteration=0. - Klasifikasi Kueri Sederhana di Backend: Pasang logika penggolongan cepat sebelum request dilempar ke Bedrock. Pertanyaan yang diawali kata tanya tunggal seperti "Di mana", "Kapan", atau "Berapa" bisa diarahkan ke mode single-shot (
maxAgentIteration=1). - Deteksi Kata Hubung dan Perbandingan: Kueri yang memuat kata kunci seperti "bandingkan", "perbedaan antara", atau kueri dengan beberapa tanda tanya sekaligus otomatis dilempar ke mode agen (
maxAgentIteration=3atau4). - Fallback Dinamis: Mulai pencarian pada mode single-shot terlebih dahulu. Jika tingkat keyakinan dokumen (retrieval relevance) rendah, aplikasi baru mengeksekusi ulang permintaan lewat mode agen.
Kalau kamu tertarik mendalami cara merancang arsitektur sistem cerdas berbasis instruksi koding mandiri, kamu bisa melihat panduan di /developer/claude-code-bedrock-agentcore-remote-agent atau mengikuti kelas terarah di Kelas AI untuk Developer.
Dampak Nyata Buat Developer dan Tim AI di Indonesia
Bagi tim pengembang software di Indonesia, pembaruan ini membawa efek yang sangat nyata pada efisiensi infrastruktur cloud:
- Penghematan Anggaran Server Cloud: Setiap kali model fondasi dipanggil untuk merumuskan ulang pertanyaan, ada biaya token yang harus dibayar. Mengarahkan kueri-kueri sederhana ke mode single-shot memangkas separuh pemanggilan model yang nggak perlu.
- Kesesuaian Regulasi dan Kepatuhan Data (UU PDP): Dalam kasus audit operasional di industri perbankan atau kesehatan Indonesia, ringkasan AI sering kali tidak sah sebagai bukti audit hukum. Opsi
maxAgentIteration=0memungkinkan sistem menampilkan dokumen asli secara akurat tanpa risiko halusinasi atau manipulasi teks. - Penyederhanaan Basis Kode (Codebase): Tim developer kamu nggak perlu lagi mengelola dua client terpisah antara Retrieve API biasa dan Agentic stream. Satu wrapper API di backend sudah bisa melayani semua jenis antarmuka pencarian.
Kalau kamu ingin menguji bagaimana model bahasa memproses data retrieval dengan instruksi yang ketat, kamu bisa mencoba prompt dasar berikut di antarmuka pengujianmu:
Kamu adalah asisten kebijakan internal perusahaan. Jawab pertanyaan pengguna hanya berdasarkan potongan dokumen yang diberikan di bawah ini. Jangan menambahkan asumsi di luar teks rujukan. Dokumen:[Tempelkan teks hasil retrieval di sini] Pertanyaan:[Tulis pertanyaan pengguna di sini]
Eksplorasi Model LLM Alternatif Bareng Classai
Di balik arsitektur pencarian seperti RAG, memilih model fondasi yang tepat untuk membaca dan merangkum dokumen adalah faktor penentu kualitas jawaban akhir. Selain model bawaan di ekosistem AWS, kamu bisa mengevaluasi performa model frontier lain untuk kebutuhan evaluasi dokumen lewat Classai Router.
Lewat Classai Router, kamu cukup memakai satu API key yang kompatibel langsung dengan SDK OpenAI maupun Anthropic tanpa perlu mengubah struktur kode backend. Beberapa model yang sangat andal untuk tugas membaca konteks dokumen panjang antara lain:
- Claude Sonnet 5.5 (Anthropic): Rp3.600 / 1M token input dan Rp18.000 / 1M token output.
- Claude Haiku 5.5 (Anthropic): Pilihan super kencang dan hemat untuk tugas ekstraksi, dengan tarif Rp1.620 / 1M token input dan Rp4.500 / 1M token output.
- DeepSeek V4.1 Flash (DeepSeek): Model analisis teks yang sangat terjangkau di tarif Rp1.155 / 1M token input dan Rp4.200 / 1M token output.
- GPT-5.6 Luna (OpenAI): Pilihan seimbang untuk penalaran ringkas di angka Rp1.830 / 1M token input dan Rp9.120 / 1M token output.
Kamu bisa mengisi saldo mulai dari Rp10.000 lewat QRIS atau transfer virtual account bank lokal tanpa perlu kartu kredit luar negeri, memudahkan kamu menguji ketahanan prompt RAG sebelum diimplementasikan ke skala produksi.
Sumber & referensi
- 01
AWS · 10 November 2026
Single-shot and agentic retrieval with Amazon Bedrock Managed Knowledge Base
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa bedanya single-shot RAG dan agentic retrieval di Bedrock?
Single-shot RAG hanya melakukan satu kali pencarian dokumen lalu langsung membuat jawaban tanpa perencanaan kueri ulang. Sementara agentic retrieval memecah pertanyaan rumit jadi sub-kueri, mencari data berulang kali, dan mengevaluasi kelengkapan bukti sebelum menyajikan jawaban.
Kapan sebaiknya memakai maxAgentIteration bernilai 0?
Gunakan nilai 0 saat kamu hanya membutuhkan potongan teks asli tanpa ringkasan atau parafrase dari model bahasa. Mode ini tidak memanggil LLM sama sekali sehingga bebas biaya inferensi teks dan cocok untuk kebutuhan audit regulasi.
Mengapa generateResponse disetel true pada nilai 0 menghasilkan error?
Parameter generateResponse=true mewajibkan pemanggilan model bahasa untuk menyusun jawaban. Karena maxAgentIteration=0 meniadakan pemanggilan LLM sepenuhnya, permintaan tersebut saling bertentangan dan otomatis ditolak oleh sistem dengan kode eror 4xx.
Apakah single-shot RAG di Bedrock bisa mencari ke beberapa knowledge base sekaligus?
Ya, semua mode pada AgenticRetrieveStream termasuk single-shot RAG (iterasi 1) dan retrieval-only (iterasi 0) mendukung pencarian lintas beberapa knowledge base sekaligus dalam satu permintaan.
Apakah Bedrock otomatis memilihkan mode yang tepat untuk tiap kueri?
Tidak, sistem Bedrock tidak menyediakan routing otomatis lewat parameter ini. Logika untuk menentukan kapan harus memakai nilai 0, 1, atau di atasnya harus dibangun di sisi backend aplikasi kamu berdasarkan jenis pertanyaan pengguna.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.