Grok 4.7 di Amazon Bedrock: Cara Bikin AI Agent Tangguh & Hemat
Grok 4.7 resmi meluncur di Amazon Bedrock! Cari tahu cara optimasi reasoning effort, arsitektur tool calling, dan trik hemat token buat tugas agent yang rumit.
· 9 menit baca
Inti singkat
- Grok 4.7 buatan SpaceXAI resmi tersedia di Amazon Bedrock lewat profil cross-Region inference.
- Fitur reasoning effort punya empat level yang bisa kamu atur per request buat menyeimbangkan akurasi dan biaya.
- Pada pengujian tugas rumit, level xhigh meraih akurasi 100%, sementara level low menghemat sekitar tujuh perdelapan token output.
- Eksplorasi tool calling jumlahnya mirip di semua level, yang membedakan cuma kedalaman proses evaluasi jawaban.
- Pemantauan volume token output dan frekuensi pemanggilan tool jadi sinyal operasional utama di lingkungan production.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Grok 4.7 buatan SpaceXAI resmi hadir di Amazon Bedrock dengan kemampuan penalaran panjang dan fitur verifikasi mandiri yang pas banget buat membangun AI agent. Lewat pembaruan ini, para developer sekarang punya pilihan model fondasi baru yang dirancang khusus buat ngerjain tugas multi-langkah tanpa gampang tersesat di tengah jalan.
Kabar ini dibagikan langsung lewat blog resmi AWS Machine Learning. Berbeda dari chatbot biasa yang cuma membalas pertanyaan dalam satu putaran, agen AI modern dituntut buat nyusun rencana, manggil berbagai fungsi eksternal, ngecek hasil temuan, sampai membetulkan langkahnya sendiri kalau ada yang janggal. Di artikel ini, kita bakal bedah tuntas fitur Grok 4.7, hasil pengujian performanya, sampai contoh kode praktis buat kamu pasang di sistem kamu sendiri.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa yang Baru di Grok 4.7 Buatan SpaceXAI?
Menurut laporan resmi SpaceXAI, Grok 4.7 memakai model dasar yang jauh lebih gede dibanding pendahulunya, Grok 4.6. Model ini dilatih lewat proses reinforcement learning yang lebih panjang memakai kumpulan masalah rumit yang butuh waktu berjam-jam buat dipecahkan. Hasilnya, model ini jauh lebih jago mengecek kebenaran hasil kerjanya sendiri dan mengelola konteks panjang.
Grok 4.7 dibekali context window hingga 500K token. Model ini mendukung input teks serta gambar, dengan output berupa teks. Di Amazon Bedrock, fitur penting seperti tool calling, structured output, dan pengaturan tingkat penalaran (reasoning effort) langsung didukung penuh dari hari pertama.
Peningkatan kemampuannya kelihatan jelas di berbagai pengujian standar industri yang mengukur ketahanan kerja multi-langkah:
| Benchmark | Kategori Pengujian | Skor Grok 4.6 | Skor Grok 4.7 |
|---|---|---|---|
| Terminal-Bench 4.0 | Tugas terminal berjam-jam | 20,3% | 37,6% |
| EEBench | Teknik elektro (electrical engineering) | 53,0% | 64,0% |
| Harvey Legal Agent Benchmark | Pekerjaan hukum analitis | 15,8% | 19,6% |
| CursorBench 4.0 | Tugas ngoding jangka panjang | 40,4% | 46,3% |
| HealthBench Professional | Penalaran klinis medis | 48,5% | 56,7% |
| AA Briefcase v1.1 | Tugas kantor durasi panjang | 1.546 | 1.657 |
Lonjakan terbesar ada di Terminal-Bench 4.0 yang naik hampir dua kali lipat. Ini nunjukin kalau Grok 4.7 memang dipoles buat eksekusi perintah kerja berantai yang butuh konsistensi tinggi.
Cara Akses Grok 4.7 di Amazon Bedrock dan Setup API
Buat memakai model ini, kamu mengakses endpoint bedrock-runtime lewat fitur cross-Region inference. Fitur ini otomatis mengarahkan beban request ke beberapa AWS Region sekaligus supaya kapasitas throughput kamu tetap aman tanpa pusing atur kuota per region.
Ada dua profil inferensi yang disediain:
| Profil Inferensi | Jalur Routing | Kapan Dipakai |
|---|---|---|
us.xai.grok-4.7 | Khusus wilayah Amerika Serikat | Wajib dipakai kalau sistem kamu punya kepatuhan residensi data di AS |
global.xai.grok-4.7 | Region komersial AWS global | Pilihan terbaik kalau nggak ada batasan lokasi data dan butuh kapasitas paling lega |
Grok 4.7 mendukung Bedrock Converse API serta format yang kompatibel dengan SDK OpenAI (Chat Completions dan Responses API). Kalau kamu pakai Converse API, penalaran model bakal dikirim lewat blok khusus bernama reasoningContent berdampingan dengan blok teks biasa.
Sebelum mulai ngetik kode, pastikan kamu udah nyiapin prasyarat berikut:
- Akun AWS dengan akses Amazon Bedrock yang sudah mengaktifkan model Grok 4.7.
- Python 3.9 atau versi lebih baru, lengkap dengan library
openai,boto3, danaws-bedrock-token-generator. - Izin IAM dengan aksi
bedrock:InvokeModelke ARN profil inferensi dan ke project default akun (arn:aws:bedrock:{region}:{account-id}:project/default).
Buat kebutuhan production, cara paling aman adalah membikin bearer token berumur pendek dari kredensial IAM kamu supaya nggak ada API key permanen yang tersimpan di server:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # Kita tangani retry secara manual lewat kode khusus
)Mengenal Empat Level Reasoning Effort
Salah satu kelebihan utama Grok 4.7 di Amazon Bedrock adalah fleksibilitas pengaturan reasoning_effort. Pengaturan ini menentukan seberapa dalam model bakal menganalisis dan menimbang-nimbang data sebelum menghasilkan jawaban.
Ada empat level yang didukung: low, medium, high, dan xhigh. Karena opsi ini bisa terus berkembang di masa depan, kamu bisa mengecek ketersediaannya lewat kode sederhana ini:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(
                model=MODEL_ID,
                input="Say OK.",
                reasoning={"effort": level},
                max_output_tokens=2048
            )
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported

print(supported_effort_levels())  # Menghasilkan: ['low', 'medium', 'high', 'xhigh']
Perbedaan tiap level ini kerasa banget di konsumsi token dan waktu tunggu. Makanya, kamu nggak wajib menyetel semua prompt ke level mentok.
Menguji Grok 4.7 di Amazon Bedrock untuk Tugas Rumit
Banyak evaluasi agen AI cuma nguji tugas gampang: baca data, saring baris tertentu, lalu hitung totalnya. Tugas semacam itu nggak butuh banyak mikir karena jawabannya udah terpampang di data mentah.
AWS merancang pengujian yang mewajibkan pencarian (search) mendalam lewat simulasi lingkungan 20 microservices dengan 7 tool berbeda. Setiap masalah punya tepat satu jawaban benar yang sudah divalidasi dengan metode brute force:
- Diagnosis Gangguan Dua Layanan (
two_fault_diagnosis): Dua service mati diam-diam pada pukul 03.00 dan bikin 12 service lain teriak memicu alert. Agen harus nebak 2 biang kerok aslinya dari 190 kemungkinan pasangan. Karena service yang rusak nggak ngeluarin alert sama sekali, agen harus ngerti rantai dependensi sistem. - Jadwal Pemeliharaan Server (
maintenance_schedule): Mengatur patching buat 8 service selama 4 malam (2 service per malam) dengan 10 batasan aturan plus syarat service dari tim yang sama nggak boleh di-patch di malam barengan. Dari 2.520 kombinasi, cuma ada 1 jadwal yang sah. - Optimasi Anggaran Migrasi (
migration_budget): Menentukan daftar kandidat migrasi paling optimal buat memangkas risiko dalam batasan bujet ketat, termasuk memperhitungkan ketergantungan prasyarat antar-layanan. Ada 53 kemungkinan set yang muat bujet, tapi cuma 1 yang paling maksimal.
Semua skenario ini dijalankan sebanyak 6 kali di tiap level reasoning effort, sehingga total ada 72 kali proses eksekusi agen.
Hasil Benchmark: Seberapa Efektif Reasoning Effort?
Dari total 72 kali uji coba, agen berbasis Grok 4.7 berhasil menjawab 67 kali dengan tepat. Menariknya, tingkat keberhasilan dan pengeluaran token membentuk pola yang sangat konsisten.
| Tugas Pengujian | Level low | Level medium | Level high | Level xhigh |
|---|---|---|---|---|
two_fault_diagnosis | 5 dari 6 | 6 dari 6 | 6 dari 6 | 6 dari 6 |
maintenance_schedule | 5 dari 6 | 5 dari 6 | 5 dari 6 | 6 dari 6 |
migration_budget | 5 dari 6 | 6 dari 6 | 6 dari 6 | 6 dari 6 |
| Total Benar (Semua Tugas) | 15 dari 18 | 17 dari 18 | 17 dari 18 | 18 dari 18 |
Selain dari sisi akurasi, metrik pemakaian sumber daya dan waktu juga nunjukin perbedaan tajam:
| Rata-rata per Run | Level low | Level medium | Level high | Level xhigh |
|---|---|---|---|---|
| Rata-rata token output | 1.184 | 6.430 | 6.778 | 9.147 |
| Rasio token dibanding level low | 1,0x | 5,4x | 5,7x | 7,7x |
| Rata-rata panggilan tool | 17,2 | 18,7 | 17,8 | 18,1 |
| Median durasi eksekusi | 18 detik | 98 detik | 89 detik | 106 detik |
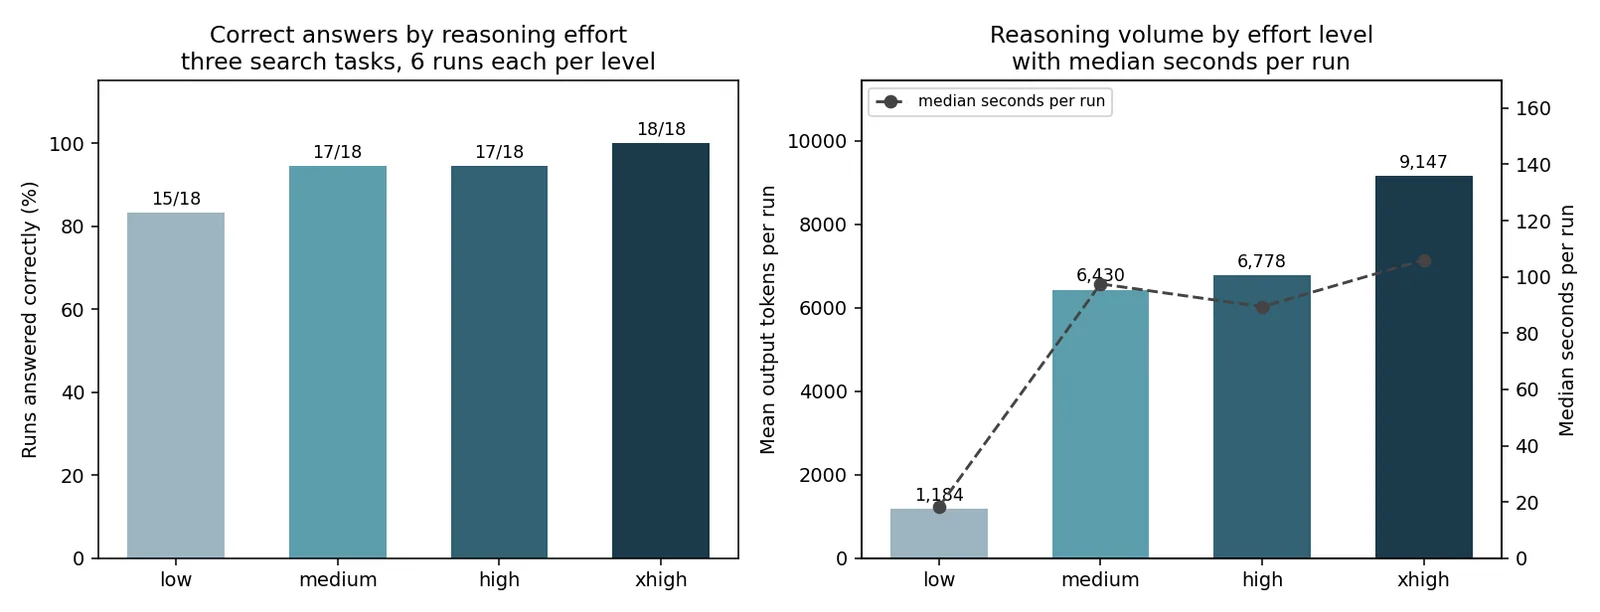
Ada tiga kesimpulan menarik dari data di atas:
- Level
xhighmeraih skor sempurna 100%: Semua 18 run berhasil diselesaikan tanpa salah satu pun. Levelmediumdanhighjuga sangat solid dengan 17 jawaban benar dari 18 percobaan. - Panggilan tool cenderung konstan: Rata-rata pemanggilan fungsi eksternal berkisar di angka 17,2 sampai 18,7 di seluruh level. Artinya, effort level nggak mengubah cara model ngumpulin data faktual, melainkan murni memperdalam cara model mencerna dan menguji hipotesis dari data yang udah dikumpulin.
- Level
lowpunya rasio biaya-kualitas juara: Model sanggup menjawab 15 dari 18 pengujian dengan benar cuma memakai seperdelapan (1/8) dari total token outputxhigh, dengan kecepatan cuma 18 detik.
Pola Penalaran: Kapan Butuh Effort Tinggi?
Karakteristik tiap level makin kelihatan pas kita telaah jenis masalah yang dihadapi. Pada tugas optimasi bujet migrasi, agen yang berpikir dangkal cenderung cuma memilih rasio terbaik satu per satu, yang berujung pada skor 9 poin di bawah batas optimal. Tapi di level medium ke atas, Grok 4.7 sukses menemukan kombinasi terbaik di seluruh percobaan.
Pada tugas jadwal pemeliharaan yang punya 10 aturan ketat, level xhigh jadi satu-satunya yang sukses mencetak akurasi 100%. Di skenario ini, model harus bolak-balik mencocokkan jadwal kandidat dengan batasan tim yang didapat dari tool.
Berikut contoh template system prompt yang dipakai AWS buat memicu kebiasaan evaluasi mandiri pada Grok 4.7:
You are an infrastructure analyst agent. Use the tools to gather facts and never guess a value you can look up. Before answering, check your answer against every rule in the task. End with the FINAL line exactly as the task specifies.Praktik Terbaik Tool Calling dan Mekanisme Retry
Biar agen AI kamu nggak gampang halusinasi atau memanggil fungsi fiktif, selalu batasi parameter tool memakai enum kalau daftar pilihannya sudah pasti. Contoh pendefinisian tool di Python:
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "get_dependencies",
            "description": "Mengambil daftar service yang menjadi dependensi langsung.",
            "parameters": {
                "type": "object",
                "properties": {
                    "service": {
                        "type": "string",
                        "enum": SERVICE_NAMES  # Membatasi pilihan nama layanan
                    }
                },
                "required": ["service"],
            },
        }
    }
]
Selain itu, sistem berbasis agen bakal mengirim banyak request dalam waktu singkat. Kalau kamu nggak pasang mekanisme penanganan kendala jaringan, satu error kecil bisa ngerusak seluruh alur kerja. Gunakan pola exponential backoff dengan jitter seperti ini:
import random
import time

RETRYABLE_STATUS = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE_STATUS or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            # Menambahkan jeda acak agar server tidak kebanjiran request serentak
            sleep_time = random.uniform(base, min(cap, base * 2 ** attempt))
            time.sleep(sleep_time)
Memantau Reasoning dan Biaya Operasional di Production
Di aplikasi nyata, kamu nggak selalu punya kunci jawaban buat menilai kebenaran output agen secara langsung. Tapi kamu punya dua metrik operasional yang sangat berharga: jumlah token output dan frekuensi pemanggilan tool.
Dari data uji coba, run yang berhasil di level medium ke atas selalu memproduksi minimal 1.739 token output. Kalau tiba-tiba ada agen yang selesai tanpa memanggil tool sama sekali, atau menghasilkan token di bawah 20% dari rata-rata normal, sistem kamu wajib memasang tanda bahaya:
def flag_for_review(run, baseline_tokens):
    """baseline_tokens: daftar jumlah token output dari run yang terbukti sukses."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("agen tidak memanggil tool sama sekali")
    if run["output_tokens"] < 0.2 * min(baseline_tokens):
        reasons.append(
            f"output token hanya {run['output_tokens']}, "
            f"di bawah 20% batas aman ({min(baseline_tokens)})"
        )
    return reasons
Buat audit berkala, kamu bisa menyalakan fitur model invocation logging di Amazon Bedrock yang bakal nyimpen rekaman percakapan lengkap ke Amazon S3 atau Amazon CloudWatch Logs. Biaya operasional juga bisa dipilah per model memakai AWS Cost Explorer.
Kalau kamu butuh integrasi model cerdas serupa atau mau membandingkan performanya dengan penyedia lain di proyek lokal, kamu juga bisa melihat ekosistem OpenAI di Amazon Bedrock atau mengecek panduan review harga Grok.
Cara Nyobain Grok 4.7 Lebih Praktis lewat Classai Router
Mengatur akun cloud skala korporat kayak AWS Bedrock kadang butuh setup kartu kredit internasional, konfigurasi IAM yang teliti, dan pengelolaan kuota inferensi yang agak ribet buat proyek awal atau tim pengembang skala kecil.
Kalau kamu pengin langsung nyobain kehebatan model ini tanpa pusing manajemen infrastruktur, kamu bisa mengakses model grok-4.7 langsung lewat Classai Router. Cukup pakai satu API key yang kompatibel dengan SDK OpenAI, arahkan base URL ke router lokal, dan kamu bisa langsung ngirim prompt maupun fungsi tool calling.
Di Classai Router, tarif model grok-4.7 dibanderol transparan sebesar Rp2.205 per 1 juta token input dan Rp9.000 per 1 juta token output. Kamu bisa top up saldo mulai dari Rp10.000 aja memakai QRIS, virtual account bank nasional, atau e-wallet tanpa perlu kartu kredit luar negeri. Setiap request bakal langsung tercatat metrik latensi dan jumlah tokennya secara rapi di dasbor.
Sumber & referensi
- 01
AWS · 13 Oktober 2026
Build long-horizon agents with Grok 4.7 on Amazon Bedrock
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa keunggulan utama Grok 4.7 di Amazon Bedrock dibanding model lain?
Grok 4.7 dirancang khusus buat menangani tugas berdurasi panjang dengan context window 500K token dan fitur evaluasi mandiri. Pengguna juga bisa mengatur level reasoning effort per request untuk menyeimbangkan kebutuhan akurasi dengan biaya token.
Berapa pilihan level reasoning effort yang tersedia di Grok 4.7?
Tersedia empat level penalaran yaitu low, medium, high, dan xhigh. Level xhigh memberikan ketelitian tertinggi untuk tugas rumit berantai, sedangkan level low sangat hemat token dan cocok untuk tugas cepat.
Apakah Grok 4.7 di Amazon Bedrock mendukung pemanggilan fungsi (tool calling)?
Ya, model ini mendukung penuh tool calling, structured output, dan input multimodal teks serta gambar. Kamu bisa mengintegrasikannya lewat Bedrock Converse API maupun format standar OpenAI SDK.
Bagaimana cara mencoba Grok 4.7 dengan pembayaran mata uang rupiah?
Kamu bisa mengakses model Grok 4.7 lewat Classai Router dengan tarif Rp2.205 per 1 juta token input dan Rp9.000 per 1 juta token output. Top up saldo bisa mulai Rp10.000 menggunakan QRIS atau transfer virtual account bank lokal.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.