OpenAI di Amazon Bedrock Resmi Hadir: GPT-6 Masuk Region Jakarta
AWS resmi membuka akses lini model OpenAI GPT-6 di Amazon Bedrock untuk wilayah Asia Tenggara, termasuk Region Jakarta. Yuk intip cara pakainya!
· 9 menit baca
Inti singkat
- Model OpenAI GPT-6 Sol dan Luna kini bisa dipanggil langsung dari AWS Region Jakarta (ap-southeast-3).
- Akses memakai global cross-Region inference untuk mencegah request kena throttling saat trafik padat.
- Tersedia endpoint kompatibel OpenAI (/openai/v1) dan integrasi langsung ke ChatGPT desktop serta Codex CLI.
- Perhitungan kuota token per menit menerapkan burndown 10x khusus untuk token output.
- Data request bisa diproses di luar negeri dan tersimpan hingga 30 hari untuk deteksi penyalahgunaan.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Pengembang aplikasi di Indonesia kini bisa mengakses model OpenAI di Amazon Bedrock langsung dari Region Jakarta lewat fitur global cross-Region inference. Kabar baik ini bikin kamu nggak perlu pusing lagi mikirin kuota lokal yang gampang mentok saat trafik lagi tinggi.
Berdasarkan pengumuman resmi AWS, AWS ngebuka jalur akses model frontier OpenAI generasi terbaru—GPT-6 Sol, GPT-6 Luna, dan GPT-6 Astra—buat lima region Asia Pasifik: Thailand, Malaysia, Singapura, Taiwan, dan tentunya Indonesia. Langkah ini ngebantu banget buat tim engineer yang pengin infrastruktur AI terpusat di satu akun cloud tanpa repot kelola tagihan terpisah.
Sebelum melangkah lebih jauh buat ngutak-ngatik kodenya, yuk kita bedah tuntas apa aja fiturnya, gimana arsitekturnya bekerja, dan cara konfigurasinya dari awal.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu OpenAI di Amazon Bedrock dan Kenapa Butuh Cross-Region Inference?
Kalau kamu biasa manggil model AI dalam satu region tunggal (single-Region), pasti pernah ngalamin kendala klasik: request tiba-tiba kena throttle atau antre panjang pas kapasitas server lokal lagi penuh. Masalah ini sering kejadian pas jam kerja sibuk.
Nah, konsep Cross-Region inference hadir buat nyelesaiin masalah itu. Alih-alih manggil ID model biasa, kamu manggil yang namanya inference profile ID. Begitu request dikirim dari region asal kamu (misalnya Jakarta), Amazon Bedrock bakal otomatis ngalirin trafik itu ke region komersial AWS lain yang kapasitas komputasinya lagi lowong.
Menariknya, urusan operasional nggak bakal bikin pusing. Tagihan, pencatatan log AWS CloudTrail, metrik Amazon CloudWatch, sampai pelacakan kuota tetap ngumpul rapi di region asal tempat kamu manggil API. Jadi kamu dapet kapasitas komputasi global, tapi urusan tata kelola tetap serasa lokal.
Mengenal Tiga Model GPT-6 di Bedrock: Sol, Luna, dan Astra
Keluarga model GPT-6 yang masuk ke Bedrock ini punya spesialisasi tugas masing-masing. Ketiganya sama-sama mendukung input teks dan gambar, pemanggilan fungsi dari sisi klien (tool use), serta prompt caching buat menghemat biaya. Bedanya ada di fokus pemakaian dan tingkat penalaran (reasoning effort):
- GPT-6 Sol: Dirancang buat tugas harian yang kompleks, mulai dari analisis logika tingkat tinggi sampai nulis kode program rumit.
- GPT-6 Luna: Pas banget buat tugas rutin bervolume gede yang butuh kecepatan tinggi dan konsistensi, kayak ekstraksi data atau klasifikasi teks berulang.
- GPT-6 Astra: Model kelas berat yang fokus ngerjain tugas super kompleks, penalaran mendalam, rekayasa kode rumit, dan analisis dokumen super panjang.
Urusan pengaturan tingkat mikir alias reasoning effort, GPT-6 Sol dan GPT-6 Luna ngasih pilihan lengkap: none, low, medium, high, xhigh, sampai max. Khusus GPT-6 Astra, kamu nggak bisa matiin penalarannya sama sekali karena opsi none otomatis ditolak oleh sistem.
| Profil Inferensi | Fokus Kemampuan | Pilihan Tingkat Penalaran | Model Card | Harga Input / Output (Classai)* |
|---|---|---|---|---|
global.openai.gpt-6-sol | Coding & penalaran tugas rumit | none sampai max | model card GPT-6 Sol | Rp3.405 / Rp15.000 |
global.openai.gpt-6-luna | Tugas repetitif skala tinggi | none sampai max | model card GPT-6 Luna | Rp1.695 / Rp8.445 |
global.openai.gpt-6-astra | Dokumen panjang & riset mendalam | low sampai max (tanpa none) | model card GPT-6 Astra | Rp9.720 / Rp48.600 |
*Catatan: Kolom harga di atas adalah tarif per 1 juta token bila kamu memakai rute alternatif lewat Classai Router.
Ketersediaan Region: Jakarta Kebagian Model Apa Aja?
Ketersediaan model ini dibagi berdasarkan region asal (source Region). Dari lima region yang diumumkan AWS, pembagian aksesnya adalah sebagai berikut:
- Asia Pacific (Jakarta)
ap-southeast-3: Mendukung profilglobal.openai.gpt-6-soldanglobal.openai.gpt-6-luna. - Asia Pacific (Singapore)
ap-southeast-1: Mendukung ketiga model sekaligus, yaituglobal.openai.gpt-6-sol,global.openai.gpt-6-luna, danglobal.openai.gpt-6-astra. - Malaysia (
ap-southeast-5), Thailand (ap-southeast-7), dan Taipei (ap-east-2): Mendukungglobal.openai.gpt-6-soldanglobal.openai.gpt-6-luna.
Buat region Jakarta, Malaysia, Thailand, dan Taipei, statusnya adalah opt-in Region. Artinya, sebelum bisa manggil endpoint Bedrock di region tersebut, administrator akun AWS kamu wajib mengaktifkan region-nya terlebih dahulu di konsol manajemen AWS.
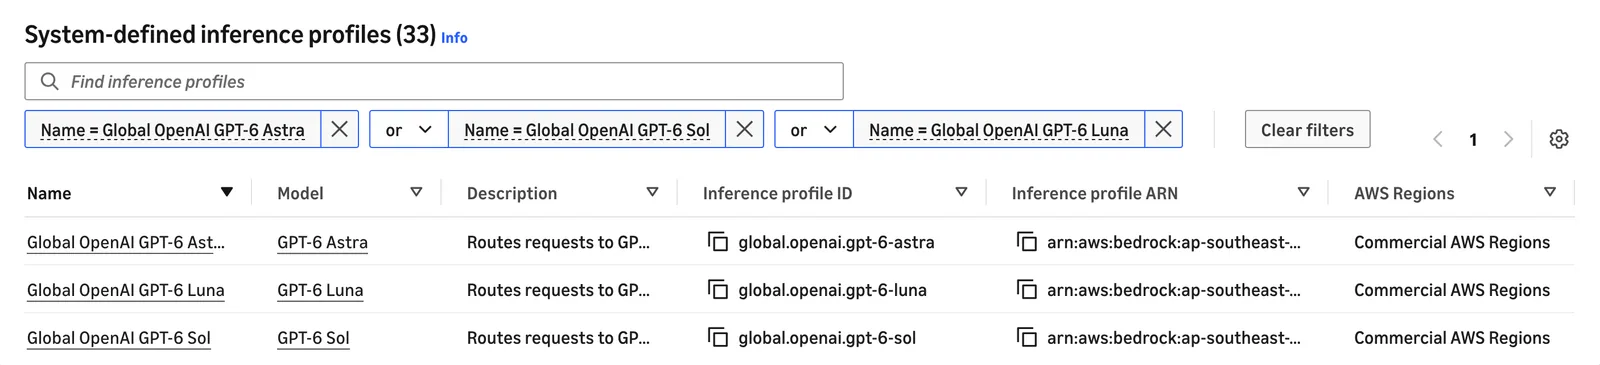
Di konsol Bedrock, ketiga profil inferensi ini langsung terdaftar di menu profil inferensi bawaan sistem (system-defined inference profiles).
Cara Mencoba OpenAI di Amazon Bedrock Lewat API
Ada tiga jalur buat manggil model ini di endpoint bedrock-runtime: Converse API bawaan AWS, OpenAI Responses API, dan OpenAI Chat Completions API. Kalau aplikasi kamu udah dirancang pakai library resmi OpenAI, kamu nggak perlu nulis ulang seluruh logika backend.
1. Pakai AWS SDK (Boto3) dan Converse API
Jalur ini cocok banget buat aplikasi yang udah jalan penuh di ekosistem AWS SDK. Kamu tinggal arahkan ID model ke string profil global cross-Region:
import logging
import os
import boto3

REGION = os.environ.get("AWS_REGION", "ap-southeast-3")
PROFILE_ID = os.environ.get("BEDROCK_PROFILE_ID", "global.openai.gpt-6-sol")
PROMPT = "Sebutkan 3 alasan kenapa aplikasi butuh antrean pesan (message queue)."

client = boto3.client("bedrock-runtime", region_name=REGION)

response = client.converse(
    modelId=PROFILE_ID,
    messages=[{"role": "user", "content": [{"text": PROMPT}]}],
    inferenceConfig={"maxTokens": 512},
    additionalModelRequestFields={"reasoning": {"effort": "low"}},
)

text = "".join(b["text"] for b in response["output"]["message"]["content"] if "text" in b)
print(text)
2. Pakai SDK OpenAI (/openai/v1)
Kalau kamu mau migrasi tanpa ganti library, pasang paket pendukung dengan perintah pip install openai aws-bedrock-token-generator boto3. Endpoint Bedrock nerima autentikasi Signature Version 4 (SigV4) atau token sementara yang berlaku hingga 12 jam:
import os
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "ap-southeast-3"
PROFILE_ID = "global.openai.gpt-6-sol"

client = OpenAI(
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    api_key=provide_token(region=REGION),
)

response = client.chat.completions.create(
    model=PROFILE_ID,
    messages=[{"role": "user", "content": "Buatkan skema JSON profil pengguna."}],
    max_completion_tokens=256,
)

print(response.choices[0].message.content)Integrasi ke ChatGPT Desktop dan Codex CLI
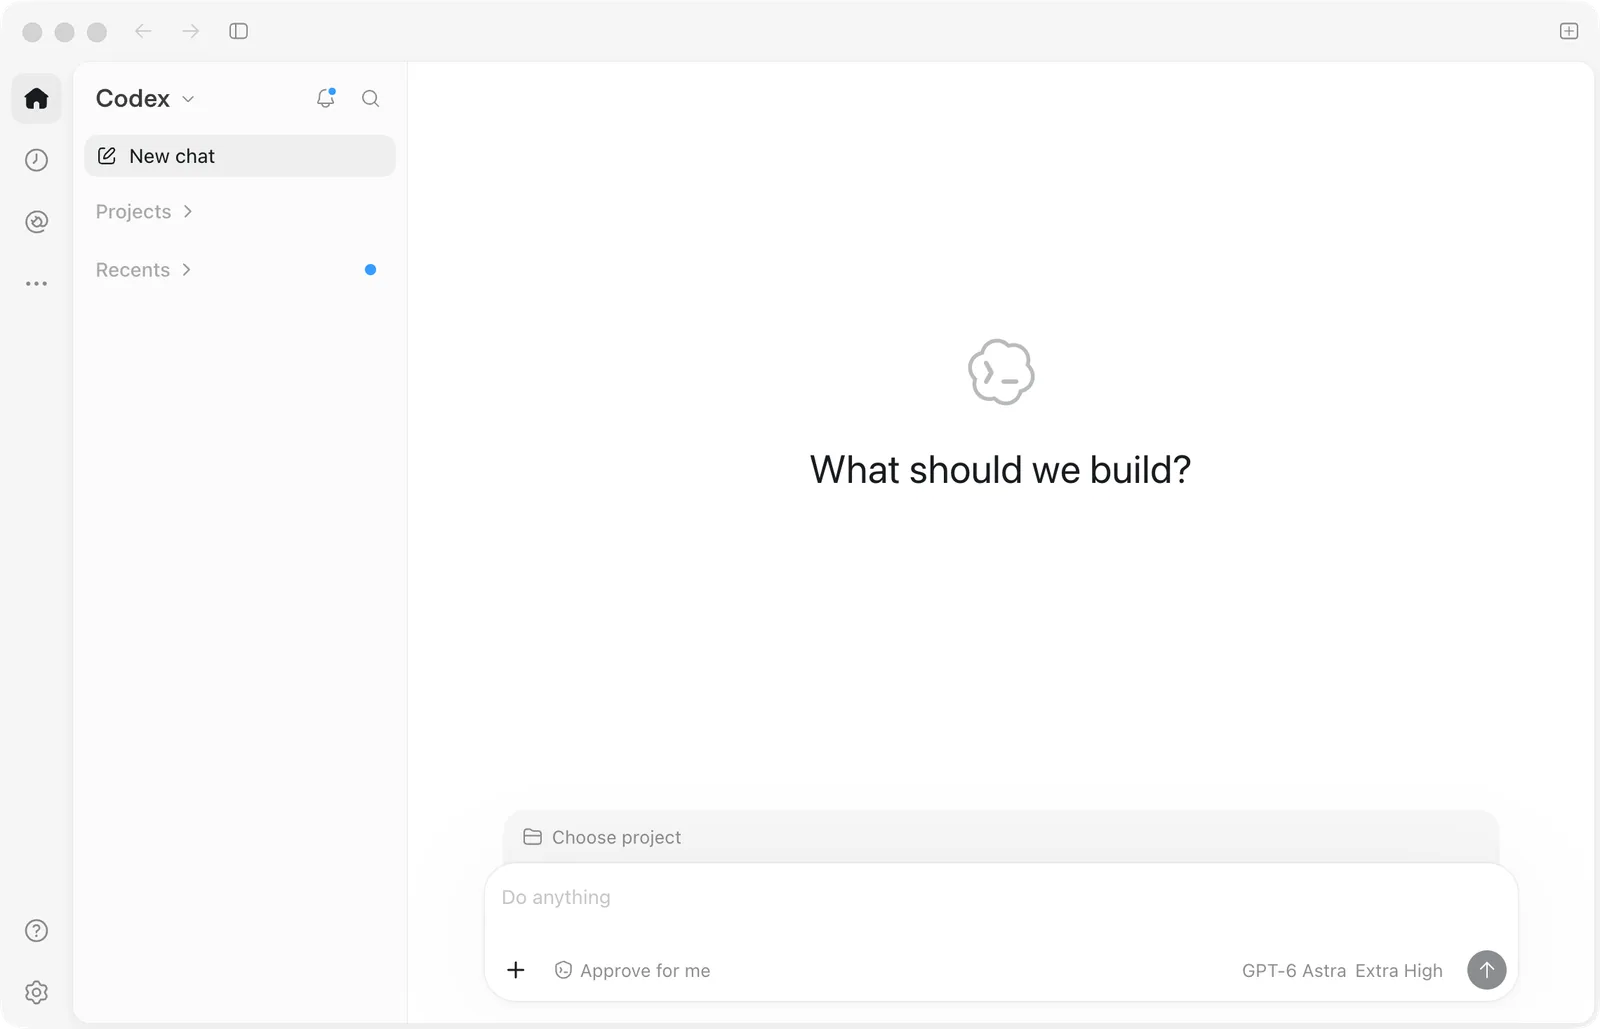
Pengembang yang terbiasa pakai alat bantu coding lokal juga dapet kemudahan. Aplikasi desktop ChatGPT dan Codex CLI berbagi file konfigurasi yang sama di ~/.codex/config.toml. Kamu cukup ngarahin penyedia model ke amazon-bedrock-runtime:
model = "global.openai.gpt-6-astra"
model_provider = "amazon-bedrock-runtime"
[model_providers.amazon-bedrock-runtime.aws]
region = "ap-southeast-1"
Karena integrasi ini memakai penandatanganan SigV4, kamu nggak perlu repot muter atau nyimpen kunci API statis di laptop. Codex CLI versi 0.148 ke atas langsung ngenalin konfigurasi ini. Buat tugas panjang, batas context window bawaan Codex sebesar 272.000 token juga bisa kamu naikkan lewat opsi model_context_window.
Konfigurasi IAM Policy dan Trik Lolos Service Control Policy (SCP)
Satu kendala yang paling sering bikin developer pemula garuk-garuk kepala pas nyobain profil global ini adalah pesan galat izin akses. Pasalnya, request cross-Region secara teknis membawa atribut aws:RequestedRegion bernilai unspecified.
Buat IAM Policy di akunmu, kamu butuh empat blok izin utama:
- Izin memanggil profil inferensi dan resource proyek default di region asalmu.
- Izin memanggil foundation model di region asal yang terikat ke profil inferensi itu.
- Izin memanggil foundation model global (
arn:aws:bedrock:::foundation-model/openai.gpt-6-sol) dengan syarataws:RequestedRegiondisetel keunspecified. - Izin
bedrock:CallWithBearerTokenkalau kamu memakai autentikasi berbasis token OpenAI.
Kalau kantormu menerapkan Service Control Policy (SCP) ketat yang membatasi region resmi (misalnya cuma ngebolehin resource dibikin di Jakarta atau Singapura), panggilan API ini bisa langsung ditolak mentah-mentah. Solusinya, jangan buka izin sembarangan ke semua layanan dengan memasukkan unspecified. Cukup tambahkan pengecualian spesifik pada SCP menggunakan kunci kondisi bedrock:InferenceProfileArn yang mengecualikan pola ARN arn:aws:bedrock:*:*:inference-profile/global.*.
Biar pemahaman arsitektur agen AI kamu makin matang pas ngehubungin backend Bedrock ini dengan sistem internal, kamu juga bisa baca ulasan teknis kami soal arsitektur AI agent di Amazon Bedrock.
Kuota Token Per Menit dan Jebakan 10x Burndown Output
Manajemen kuota di Amazon Bedrock diukur pakai satuan tokens per minute (TPM) yang dicatat di region asal pemanggilan. Nah, ada perhitungan khusus yang wajib kamu pahami biar nggak kena limit kuota di tengah jalan:
- Token input dan cache-write dihitung standar dengan rasio 1:1.
- Setiap 1 token output menguras kuota setara 10 token (10x burndown rate)!
Sebagai contoh hitungan: kalau request kamu ngirim 2.000 token input dan model ngebales dengan 1.000 token output, kuota yang langsung kesedot dari alokasi TPM kamu bukan 3.000, melainkan 12.000 token (2.000 + [1.000 × 10]).
Selain itu, Bedrock bakal langsung nge-booking kapasitas kuota di awal sebesar nilai max_tokens yang kamu pasang di konfigurasi request. Makanya, hindari masang angka max_tokens kelewat tinggi kalau kamu cuma ngekspektasi jawaban singkat.
Privasi Data, Retensi 30 Hari, dan Regulasi di Indonesia
Buat bisnis dan startup di Indonesia, kepatuhan privasi data adalah aspek krusial yang nggak boleh dilewatin, apalagi sejak berlakunya Undang-Undang Perlindungan Data Pribadi (UU PDP). Saat kamu memakai global cross-Region inference, ada konsekuensi aliran data yang harus dipahami tim legal dan keamanan sistem:
- Lokasi Pemrosesan: Trafik yang dikirim dari Jakarta bakal diproses di region AWS komersial mana pun yang mendukung penempatan model GPT-6 tersebut.
- Retensi Deteksi Penyalahgunaan: Untuk keperluan deteksi penyalahgunaan sistem (abuse detection), trafik yang ditandai oleh sistem klasifikasi otomatis bakal disimpan oleh AWS sampai maksimal 30 hari di region pemrosesan akhir.
- Opsi Zero Data Retention: Pelanggan enterprise yang memenuhi kriteria tertentu bisa mengajukan permohonan zero data retention penuh melalui tim akun AWS mereka.
Semua log pemrosesan per request tetap bisa kamu pantau dari region asal lewat AWS CloudTrail pada parameter additionalEventData.inferenceRegion. Jadi kamu tetap pegang bukti audit lengkap ke mana data diproses.
Kalau kamu lagi merancang pipeline pemrosesan dokumen perusahaan yang sensitif di atas Bedrock, pastikan juga kamu mempelajari keamanan RAG real-time di Amazon Bedrock biar hak akses berkas tetap aman terkendali.
Berikut contoh prompt siap pakai buat ngecek kemampuan penalaran GPT-6 Sol saat menganalisis kebutuhan arsitektur cloud kamu:
Kamu adalah arsitek solusi cloud senior. Analisis skenario berikut:Sebuah platform e-commerce di Indonesia ingin beralih memakai OpenAI GPT-6 Sol lewat Amazon Bedrock cross-Region inference dari Region Jakarta (ap-southeast-3).Beri rekomendasi konkret mengenai:1. Trik mitigasi kuota token per menit mengingat adanya 10x output burndown.2. Pola penanganan error timeout saat trafik dialihkan ke region komersial lintas benua.3. Checklist kepatuhan UU PDP terkait data residency dan retensi 30 hari.Sajikan rekomendasi dalam bentuk poin-poin ringkas dan langsung pada solusinya.
Solusi Alternatif: Integrasi Multi-Model Lewat Classai Router
Nyiapin konfigurasi IAM, SCP, dan aktivasi opt-in region di AWS emang ngasih kontrol enterprise yang luar biasa ketat. Tapi kalau kamu pengembang independen atau tim lincah yang pengin langsung ngegas nyobain model OpenAI tanpa repot ngurusin izin cloud yang rumit, kamu bisa manfaatin Classai Router.
Lewat Classai Router, kamu dapet satu API key buat manggil beragam model frontier sekaligus. Mau pakai gpt-6-sol (Rp3.405 / Rp15.000 per 1 juta token input/output), gpt-6-luna (Rp1.695 / Rp8.445), gpt-6-astra (Rp9.720 / Rp48.600), sampai model pesaing kayak Claude Opus 5.5, semuanya bisa dipanggil cukup dengan ganti satu baris string model di kodinganmu. Pembayarannya fleksibel pakai rupiah mulai Rp10.000 via QRIS tanpa perlu kartu kredit internasional.
Kalau tim kamu butuh panduan terstruktur dari nol buat membangun aplikasi berbasis AI dan API model bahasa modern, materi lengkapnya juga dibahas tuntas di kelas AI untuk Developer.
Sumber & referensi
- 01
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Model OpenAI apa saja yang tersedia di Amazon Bedrock Region Jakarta?
Di AWS Region Jakarta (ap-southeast-3), kamu bisa mengakses model OpenAI GPT-6 Sol dan GPT-6 Luna lewat profil global cross-Region inference. Model GPT-6 Astra saat ini hanya tersedia dari region asal Singapura (ap-southeast-1).
Apa bedanya manggil model biasa dengan cross-Region inference di Bedrock?
Cross-Region inference secara otomatis mengalihkan request ke region AWS lain yang memiliki kapasitas komputasi luang saat trafik lokal padat. Ini mencegah aplikasi terkena galat pembatasan kuota (throttling), sementara penagihan dan pencatatan log tetap berada di region asal.
Bagaimana cara kerja perhitungan kuota token per menit untuk model GPT-6?
Kuota dihitung berdasarkan tokens per minute (TPM) di region asalmu. Setiap token input dan cache-write dihitung 1:1, tetapi setiap token output yang dihasilkan menguras alokasi kuota sebesar 10 kali lipat.
Apakah data yang dikirim ke OpenAI di Bedrock aman dan sesuai regulasi Indonesia?
Data request diproses di region AWS komersial tempat model berada dan dapat disimpan hingga 30 hari untuk deteksi penyalahgunaan. Bisnis dengan aturan ketat UU PDP disarankan berkonsultasi dengan tim kepatuhan atau mengajukan opsi zero data retention ke AWS.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.