Crawl4AI Amazon Bedrock Rilis: Cara Bikin RAG Bersih Bebas Sampah Web
AWS membagikan arsitektur resmi integrasi Crawl4AI dengan Amazon Bedrock Knowledge Bases. Simak cara bikin pipeline data web bersih buat RAG tanpa sampah navigasi.
· 8 menit baca
Inti singkat
- Integrasi Crawl4AI memfilter boilerplate web sebelum masuk ke Amazon Bedrock Knowledge Bases.
- Pipeline memakai AWS Fargate dan EventBridge untuk jadwal crawling otomatis tanpa server manual.
- Dokumen Markdown disimpan bareng file metadata sidecar JSON maksimal 10 KB di Amazon S3.
- Managed knowledge base mendukung hybrid search, managed reranker, dan filter metadata otomatis.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
AWS resmi merilis panduan arsitektur integrasi Crawl4AI dengan Amazon Bedrock Knowledge Bases untuk menyaring sampah konten web sebelum masuk ke pipeline RAG. Solusi ini menjawab masalah klasik developer saat indexing website: hasil pencarian AI sering ngawur karena tercampur menu navigasi, footer, dan kode JavaScript mentah.
Dalam membangun aplikasi Retrieval-Augmented Generation (RAG), kualitas jawaban model AI sangat bergantung pada data yang kamu masukkan. Kalau datanya penuh sampah HTML atau teks iklan, jawaban yang keluar pasti ikutan berantakan. Seperti diuraikan dalam panduan resmi AWS Machine Learning Blog, sekarang developer bisa menggabungkan kecanggihan crawler open-source Crawl4AI buatan UncleCode dengan pipeline otomatis Amazon Bedrock Knowledge Bases.
Mari kita bedah arsitektur, cara kerja script crawling-nya, sampai cara deploy pipeline data ini ke akun AWS kamu.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Nggak Cukup Pakai Web Crawler Bawaan Bedrock?
Sebenarnya Amazon Bedrock Knowledge Bases sudah punya konektor bawaan bernama Amazon Bedrock Web Crawler. Fitur bawaan ini praktis banget: kamu tinggal kasih seed URL atau sitemap, atur jadwal sinkronisasi, dan Bedrock bakal crawling halaman publik secara otomatis, lengkap dengan dukungan halaman berbasis JavaScript dan kepatuhan pada robots.txt.
Masalahnya muncul saat website target punya struktur yang ramai. Web crawler bawaan menyerap seluruh isi halaman apa adanya. Alhasil, teks navigasi header, daftar link footer, disclaimer hak cipta, dan widget sidebar ikut masuk ke vector store.
Di sinilah pipeline crawl4ai amazon bedrock jadi solusi pas. Pendekatan custom preparation ini kamu butuhkan kalau:
- Butuh Markdown Bersih: Crawl4AI punya fitur
PruningContentFilteryang otomatis memangkas boilerplate web sambil mempertahankan hierarki heading, list, dan tabel. - Ekstraksi Tertarget: Kamu bisa membatasi area ekstraksi hanya pada elemen CSS tertentu (misalnya tag
<article>atau class.main-content). - Kustomisasi Metadata Sidecar: Kamu bisa menempelkan atribut khusus seperti URL sumber asli, waktu crawling, dan kategori konten buat dipakai sebagai filter pencarian.
Perlu diingat, workflow ini adalah proses batch ingestion untuk web publik yang kamu miliki atau kamu ketahui izinnya, bukan pencarian web real-time saat inferensi seperti Web Grounding milik Amazon Nova.
Cara Kerja Arsitektur Crawl4AI dan Amazon Bedrock
Arsitektur yang disediakan AWS pada repositori sample-crawl4ai-bedrock-knowledge-base memanfaatkan AWS CDK untuk mendirikan infrastruktur serverless berbasis container.
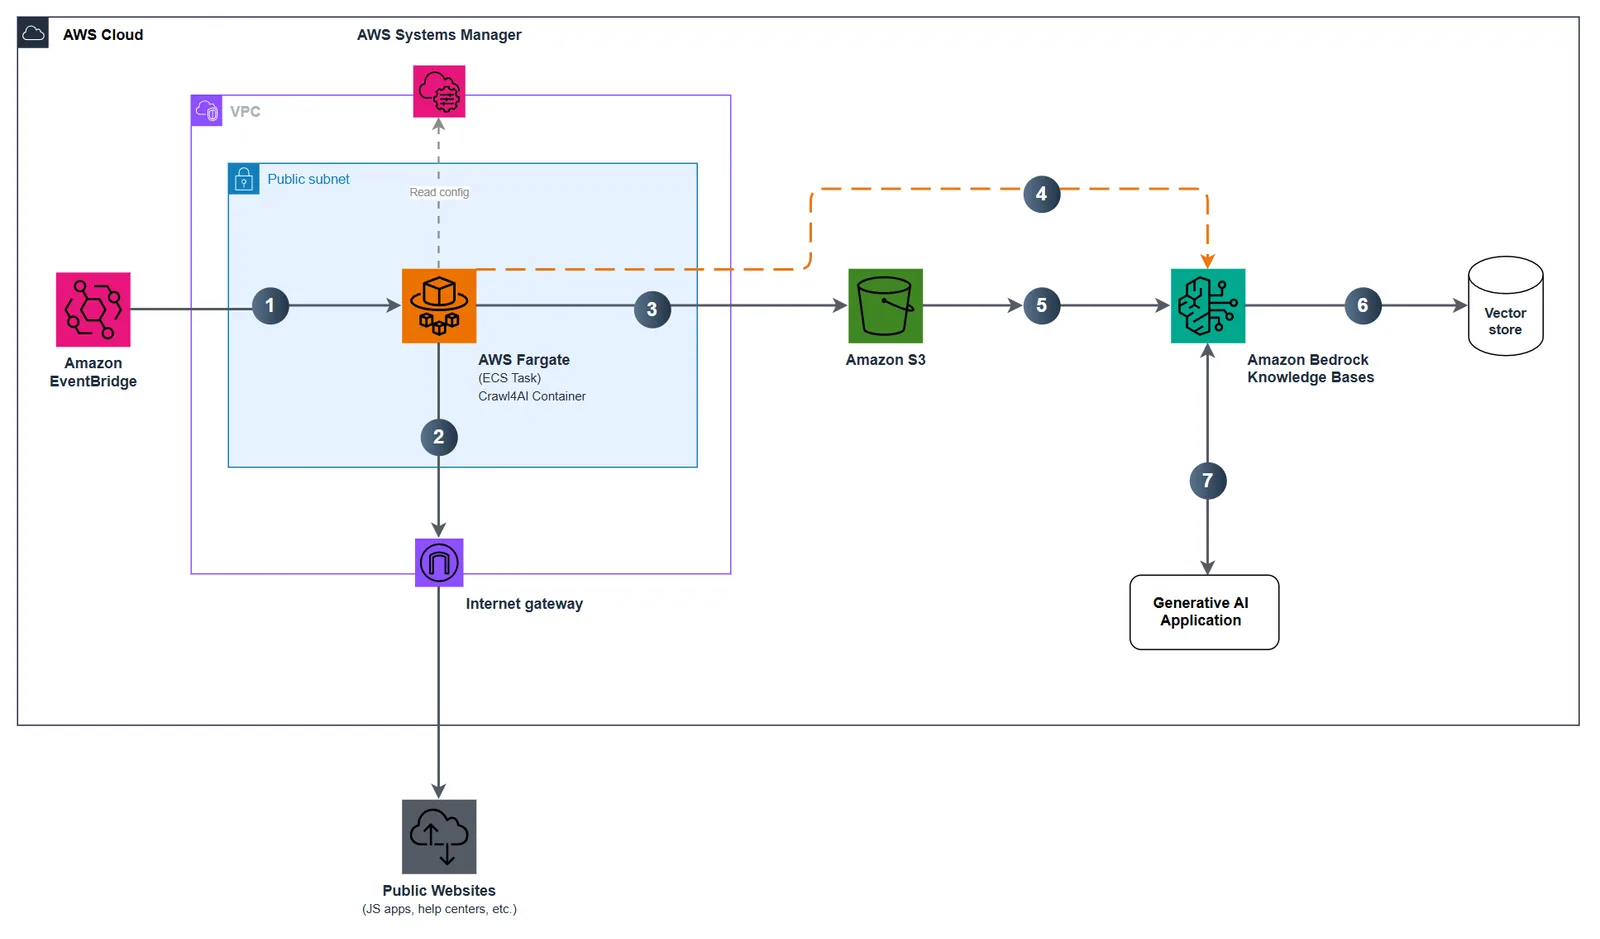
Alur kerja pipeline data bedrock ini berjalan secara berurutan:
- Pemicu Jadwal: Amazon EventBridge menjalankan container task di AWS Fargate (Amazon ECS) sesuai jadwal rutin yang diatur (misalnya tiap 24 jam).
- Crawling Mandiri: Fargate task menjalankan script Python Crawl4AI secara headless untuk menelusuri URL publik yang sudah ditentukan.
- Penyimpanan S3: Dokumen Markdown bersih hasil ekstraksi beserta file metadata sidecar JSON diunggah ke bucket Amazon S3.
- Trigger Ingestion: Task container memanggil API Bedrock Agent untuk memulai proses sinkronisasi data source.
- Indexing Otomatis: Amazon Bedrock membaca file baru dari S3, menjalankan chunking, membuat embedding vektor, dan memperbarui index.
- Query & Retrieval: Aplikasi generative AI kamu bisa langsung mengambil chunk teks yang relevan lewat API
Retrieveatau menghasilkan respon berdasar referensi lewat agentic retrieval.
Task Fargate ini mengambil konfigurasi non-rahasia dari AWS Systems Manager Parameter Store saat booting. Seluruh proses crawling difokuskan untuk halaman publik tanpa sesi login. Kalau kamu butuh crawling web internal bertiket, crawler bawaan Bedrock mendukung otentikasi basic, form, hingga SAML.
Bedah Kode: Bounded Crawling dan Ekstraksi Markdown Rapi
Jantung dari pipeline ini ada pada modul crawling Python yang membungkus Crawl4AI. Kode ini memastikan bot nggak merayap ke sembarang link di luar domain target melalui strategi Breadth-First Search (BFS).
Berikut potongan logika intinya yang disederhanakan dari file src/crawl4ai_bedrock_kb/crawl.py:
async def crawl_and_prepare(config: PipelineConfig, output_dir: str) -> list[str]:
    written, seen = [], set()
    pages_crawled = 0
    browser_config = BrowserConfig(headless=True, java_script_enabled=True)

    async with AsyncWebCrawler(config=browser_config) as crawler:
        for seed in config.seed_urls:
            remaining = config.crawl.max_pages - pages_crawled
            if remaining <= 0:
                break

            strategy = BFSDeepCrawlStrategy(
                max_depth=config.crawl.max_depth,
                max_pages=remaining,
                filter_chain=FilterChain([
                    SeedScopeFilter(seed, config.crawl.scope),
                ]),
            )
            run_config = CrawlerRunConfig(
                deep_crawl_strategy=strategy,
                markdown_generator=DefaultMarkdownGenerator(
                    content_filter=PruningContentFilter()
                ),
                css_selector=config.crawl.css_selector,
                check_robots_txt=config.crawl.check_robots_txt,
                mean_delay=config.crawl.request_delay_seconds,
                max_range=0,
                semaphore_count=1,
            )

            results = await crawler.arun(url=seed, config=run_config)
            for result in results:
                if pages_crawled >= config.crawl.max_pages:
                    break
                pages_crawled += 1
                requested_url = result.url
                source_url = getattr(result, "redirected_url", None) or requested_url
                if not SeedScopeFilter(seed, config.crawl.scope).apply(source_url):
                    continue
                canonical = _canonical_url(source_url)
                if canonical in seen:
                    continue
                seen.add(canonical)
                if not result.success or not result.markdown:
                    continue

                md_result = result.markdown
                markdown = (
                    getattr(md_result, "fit_markdown", None)
                    or getattr(md_result, "raw_markdown", None)
                    or (md_result if isinstance(md_result, str) else "")
                )
                if not markdown:
                    continue

                written.extend(
                    _write_document(
                        output_dir,
                        _base_name(source_url),
                        markdown,
                        {"source_url": source_url},
                    )
                )
    return written
Bedrock Knowledge Bases mendukung file teks, HTML, PDF, DOCX, hingga Markdown. Memilih output Markdown dari Crawl4AI adalah langkah terbaik karena struktur heading dan tabel tetap rapi tanpa membawa tag HTML kotor.
Format Metadata Sidecar dan Batasan 10 KB di Amazon S3
Kunci sukses retrieval di Bedrock ada pada file metadata pendamping yang disebut sidecar file. Kalau dokumen Markdown kamu bernama panduan-layanan.md, file metadatanya wajib bernama panduan-layanan.md.metadata.json dan diletakkan di folder S3 yang sama.
Bedrock memberlakukan batas ketat: setiap file metadata sidecar nggak boleh melebihi ukuran 10 KB. Kalau ukurannya lewat dari itu, pipeline sample akan otomatis berhenti dengan status error sebelum menulis file.
Format JSON metadata harus memiliki tipe data eksplisit yang dikenali oleh Amazon S3 connector:
{
  "metadataAttributes": {
    "source_url": {
      "value": {"type": "STRING", "stringValue": "https://www.example.com/layanan/izin-usaha"}
    },
    "crawled_at_epoch": {
      "value": {"type": "NUMBER", "numberValue": 1790640000}
    },
    "content_category": {
      "value": {"type": "STRING", "stringValue": "web"}
    }
  }
}
Atribut bertipe NUMBER seperti timestamp epoch ini berguna banget saat kamu pengin menyaring data yang kedaluwarsa sewaktu inferensi.
Strategi Chunking dan Ingestion di Managed Knowledge Bases
Begitu file masuk ke S3, task Fargate memanggil fungsi start_ingestion_job via SDK Boto3 bedrock-agent:
def start_ingestion_job(config: PipelineConfig) -> str:
    client = boto3.client("bedrock-agent", region_name=config.region)
    response = client.start_ingestion_job(
        knowledgeBaseId=config.knowledge_base_id,
        dataSourceId=config.data_source_id,
    )
    return response["ingestionJob"]["ingestionJobId"]
Di sisi Amazon Bedrock, dokumen akan diurai menggunakan managed parser bawaan. Kamu harus memilih strategi pemotongan teks (chunking strategy) saat pertama kali membuat data source, karena opsi ini nggak bisa diubah setelah data source terbentuk.
Berikut perbandingan opsi chunking pada Managed Knowledge Base:
| Strategi Chunking | Ukuran Token Default | Overlap | Skenario Terbaik |
|---|---|---|---|
| Default Chunking | 300 token | 20% | Dokumen panduan umum dan FAQ web |
| Fixed-size Chunking | Ditentukan manual | Ditentukan manual | Dokumen panjang dengan konteks spesifik |
| No Chunking | 1 file = 1 chunk | 0% | Halaman pendek yang sudah dipotong rapi saat scraping |
Kalau kamu memakai Customer-Managed Knowledge Base (misalnya menyambung ke Amazon OpenSearch Serverless mandiri), Bedrock menyediakan opsi lanjutan seperti semantic chunking dan hierarchical chunking.
Validasi Kualitas Retrieval dan Uji Filter Metadata
Setelah ingestion tuntas, kamu bisa menguji akurasi retrieval tanpa perlu memanggil model fondasi teks terlebih dahulu. Kita gunakan fungsi retrieve dari klien Boto3 bedrock-agent-runtime versi 1.43.32 ke atas.
Managed Knowledge Base memakai hybrid search (gabungan keyword dan vector) serta reranker otomatis. Kode di bawah menyaring pencarian hanya pada konten kategori web yang diambil maksimal 7 hari terakhir:
import time
import boto3

client = boto3.client("bedrock-agent-runtime", region_name="us-east-1")
week_ago = int(time.time()) - 7 * 24 * 60 * 60

response = client.retrieve(
    knowledgeBaseId="ABCDEFGHIJ",
    retrievalQuery={"text": "Bagaimana alur pengajuan izin pembangunan?"},
    retrievalConfiguration={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
            "filter": {
                "andAll": [
                    {"equals": {"key": "content_category", "value": "web"}},
                    {"greaterThan": {"key": "crawled_at_epoch", "value": week_ago}},
                ]
            },
        }
    },
)

for result in response["retrievalResults"]:
    print(result.get("metadata", {}).get("source_url"), result["content"]["text"][:200])
Kalau kamu pengin langsung memproduksi jawaban lengkap berformat sitasi, gunakan operasi AgenticRetrieveStream untuk managed knowledge base, atau RetrieveAndGenerate untuk customer-managed knowledge base. URL asli dari atribut source_url sidecar akan otomatis tercantum pada daftar sitasi jawaban.
Keamanan, Guardrails, dan Risiko Prompt Injection dari Web
Memasukkan data publik ke pipeline data RAG punya risiko keamanan yang nggak boleh kamu remehkan. Siapa pun yang bisa menyisipkan teks di halaman publik berpotensi menyusupkan prompt injection tersembunyi ke dalam sistem AI kamu.
AWS menyarankan sejumlah pengamanan wajib:
- Amazon Bedrock Guardrails: Pasang guardrail pada request retrieval untuk memblokir topik terlarang, menyaring kata sensitif, dan memvalidasi informasi pribadi (PII).
- Contextual Grounding Check: Fitur cek di Bedrock Guardrails ini otomatis memberi skor apakah respon model benar-benar didasarkan pada teks kutipan retrieval dan relevan dengan pertanyaan user. Jika skornya di bawah ambang batas, jawaban diblokir.
- Kepatuhan Scraping: Workflow ini secara otomatis mengaktifkan pengecekan file
robots.txtdi Crawl4AI tanpa opsi mematikannya lewat context flag CDK. Pastikan kamu mematuhi izin pemilik web dan mempelajari etika scraping seperti pada artikel Standar Opt Out AI Scraping. - Prinsip Least Privilege: Task Fargate hanya diberi hak IAM minimal, yaitu
s3:PutObjectpada prefix tertentu,bedrock:StartIngestionJob,bedrock:GetIngestionJob, danssm:GetParameter. Task ini nggak punya izin membaca dokumen lain di S3 atau memanggil inferensi model.
Langkah Deploy via AWS CDK dan Hitungan Biaya
Seluruh pipeline ini dikemas rapi dalam container Docker ARM64 dan di-deploy menggunakan AWS CDK v2. Berikut cara menjalankannya dari terminal kamu:
git clone https://github.com/aws-samples/sample-crawl4ai-bedrock-knowledge-base.git
cd sample-crawl4ai-bedrock-knowledge-base/deploy
python -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt

export AWS_DEFAULT_REGION=us-east-1
cdk bootstrap aws://ACCOUNT_ID/us-east-1

cdk deploy \
 -c knowledgeBaseId=ABCDEFGHIJ \
 -c dataSourceId=KLMNOPQRST \
 -c s3Bucket=nama-bucket-s3-kamu \
 -c 'seedUrls=["https://www.example.com/layanan"]' \
 -c maxDepth=1 \
 -c maxPages=25
Untuk uji coba pertama, setelan maxDepth=1 dan maxPages=25 membatasi perayapan ke 25 halaman saja. Kamu bisa menaikkan limit ini setelah memeriksa kerapian output Markdown di S3.
Terkait biaya operasional AWS, ada beberapa komponen yang perlu kamu pantau agar tagihan tetap terkontrol seperti panduan Kelola Biaya Amazon Bedrock:
- AWS Fargate: Task container default berukuran 2 vCPU dan 4 GB RAM. Task ini berjalan selama proses crawling plus masa tunggu polling job Bedrock hingga 30 menit.
- Jaringan: Default task berjalan di public subnet dengan IPv4 publik. Kalau akunmu mengaktifkan VPC Block Public Access mode ingress-only, kamu wajib menambahkan opsi
-c egressMode=natyang memunculkan biaya per jam NAT Gateway. - CloudWatch & KMS: Container Insights, VPC flow logs, dan AWS KMS key memiliki biaya bulanan tersendiri.
- Amazon S3 & Bedrock: Biaya penyimpanan file S3 dan ingestion Bedrock dihitung terpisah sesuai volume data.
Dampak Buat Tim Developer dan AI di Indonesia
Bagi engineer dan perusahaan teknologi di Indonesia, arsitektur crawl4ai amazon bedrock ini menawarkan jalan pintas yang sangat rapi untuk mengindeks situs dokumentasi produk, portal regulasi pemerintah, hingga website e-commerce lokal ke dalam bot AI internal perusahaan.
Kalau tokomu punya katalog ribuan halaman web dinamis, kamu nggak perlu lagi pusing menulis parser Beautiful Soup manual yang gampang patah tiap kali ada update CSS. Cukup pasang Crawl4AI di Fargate, atur schedule EventBridge, dan biarkan Bedrock mengurus embedding dan search-nya.
Setelah pipeline data di Bedrock siap, aplikasi chatbot kamu tentu butuh model reasoning yang gesit untuk menjawab pertanyaan user dari data retrieval tersebut. Kalau kamu ingin memadukan pipeline ini dengan beragam model frontier kelas dunia tanpa repot langganan kartu kredit luar negeri, kamu bisa menghubungkan aplikasi buatanmu ke Classai Router.
Lewat Classai Router, kamu bisa memanggil model penalaran tangguh seperti claude-sonnet-4.6 seharga Rp2.700 (input) dan Rp13.500 (output) per 1 juta token, atau gpt-4o di harga Rp525 / Rp2.700 per 1 juta token dengan satu API key terpadu yang kompatibel dengan format SDK OpenAI maupun Anthropic.
Sumber & referensi
- 01
AWS · 3 November 2026
Prepare web content for Amazon Bedrock Knowledge Bases with Crawl4AI
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa bedanya Crawl4AI dengan Web Crawler bawaan Amazon Bedrock?
Web Crawler bawaan Bedrock menyerap seluruh elemen halaman web publik apa adanya tanpa instalasi server tambahan. Sementara integrasi Crawl4AI memungkinkan kamu memangkas boilerplate HTML, memilih region CSS tertentu, dan menyematkan metadata kustom sebelum data masuk ke vector store.
Apakah crawling dengan Crawl4AI di Fargate mendukung halaman web berbasis JavaScript?
Ya, implementasi ini mengonfigurasi browser Playwright headless di Crawl4AI dengan opsi java_script_enabled=True. Ini memungkinkan browser merender aplikasi single-page (SPA) atau konten yang dimuat dinamis sebelum diekstrak menjadi Markdown.
Berapa batas ukuran file metadata sidecar di Amazon S3 untuk Bedrock Knowledge Bases?
Amazon Bedrock membatasi ukuran file metadata sidecar JSON maksimal 10 KB per dokumen. File ini harus memiliki nama yang persis sama dengan nama file Markdown utama ditambah akhiran .metadata.json dan diletakkan di prefix folder S3 yang sama.
Bagaimana cara menghapus konten web lama yang sudah terindeks di Bedrock?
Karena proses upload S3 bersifat aditif, kamu perlu menghapus file Markdown lama dan file sidecar terkait secara manual di S3. Setelah itu, jalankan sinkronisasi ulang data source di Bedrock agar index vektor diperbarui.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.