Agentic Retrieval LangChain Bedrock: Solusi RAG Multi-Part
RAG biasa sering kewalahan pas nemu pertanyaan kompleks dengan banyak variabel. Fitur agentic retrieval di Bedrock dan LangChain hadir buat beresin masalah ini.
· 7 menit baca
Inti singkat
- Agentic retrieval di Amazon Bedrock memecah pertanyaan rumit jadi beberapa sub-query otomatis.
- Pencarian vektor biasa sering melewatkan konteks penting pada pertanyaan multi-part perbandingan.
- Paket langchain-aws menyediakan fungsi agentic_retrieve dan retriever standar untuk kebutuhan pipeline RAG.
- Fitur planning loop butuh izin IAM bedrock:GetDocumentContent saat mengekspansi dokumen penuh.
- Developer disarankan memakai query router agar sistem tetap hemat biaya dan minim latensi.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Agentic retrieval di Amazon Bedrock Knowledge Bases memecah pertanyaan kompleks menjadi beberapa sub-query terarah, sehingga aplikasi RAG berbasis LangChain nggak lagi kehilangan konteks penting. Pembaruan arsitektur pencarian ini memastikan jawaban model tetap akurat meski pengguna mengajukan pertanyaan perbandingan bercabang dalam satu kalimat.
Kalau kamu pernah bikin sistem RAG (Retrieval-Augmented Generation) buat chatbot pendukung, kamu mungkin pernah nemu masalah klasik: pas user nanya pertanyaan sederhana, jawabannya tepat sasaran. Tapi pas user mulai ngebandingin dua hal dari tiga sudut pandang berbeda sekaligus, jawabannya malah ngaco atau ada poin yang hilang. Seperti dilaporkan AWS Machine Learning Blog, pencarian kesamaan vektor tunggal emang punya keterbatasan struktural pas harus nampung banyak maksud sekaligus.
AWS ngasih solusi lewat fitur baru pencarian berencana di Amazon Bedrock Managed Knowledge Bases yang sekarang udah terintegrasi mulus bareng paket langchain-aws. Yuk, kita bedah gimana cara kerjanya, tutorial implementasinya, sampai cara milih metode yang paling hemat biaya.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa RAG Biasa Sering Gagal di Pertanyaan Kompleks?
Bayangin user nanya ke bot kamu: "Bandingkan layanan checkout dan inventory dalam hal eskalasi on-call, target backup-restore, serta prosedur deployment rollback. Di mana bedanya?"
Kalimat itu kelihatannya cuma satu pertanyaan. Padahal aslinya itu gabungan dari enam pertanyaan sekaligus: dua layanan dikali tiga dimensi pembahasan. Pas kamu pakai pencarian kesamaan (similarity search) standar, sistem bakal ngubah seluruh kalimat panjang itu jadi satu vektor embedding tunggal. Hasilnya, retriever cuma ngasih tebakan rata-rata dari semua maksud tadi.
Efeknya kelihatan pas dievaluasi. Di tes yang dicoba AWS, pas sistem cuma ngambil 5 potongan teks (chunks), retriever cuma berhasil dapet 4 dari 6 informasi yang dicari—informasi on-call checkout dan restore inventory malah terlewat. Pas dinaikin jadi 10 chunks, semua topik memang tercover, tapi muncul pemborosan: ada topik yang kedobelan dan ada chunk yang nggak nyambung sama sekali. Vektor tunggal emang nggak dirancang buat nampung enam arah sekaligus tanpa ada langkah pengecekan bukti.
Mengenal Arsitektur Agentic Retrieval di Amazon Bedrock
Amazon Bedrock Managed Knowledge Bases ngilangin keribetan mengelola vector store, model embedding, dan re-ranking secara mandiri. Kamu cukup siapin sumber data di Amazon S3, terus Bedrock yang bakal ngurus chunking, embedding, sampai indexing datanya.
Di Bedrock Knowledge Bases, sekarang ada dua jalur API yang bisa kamu pakai:
- Retrieve API: Menjalankan satu kali pencarian hybrid dan langsung ngembaliin chunk dokumen dengan skor relevansi. Ini cocok buat kueri sederhana.
- AgenticRetrieveStream API: Menjalankan siklus perencanaan (planning loop). Bedrock bakal mecah pertanyaan jadi beberapa sub-query, nyari buktinya, ngecek apakah buktinya udah cukup, lalu nyari lagi kalau dirasa masih kurang.
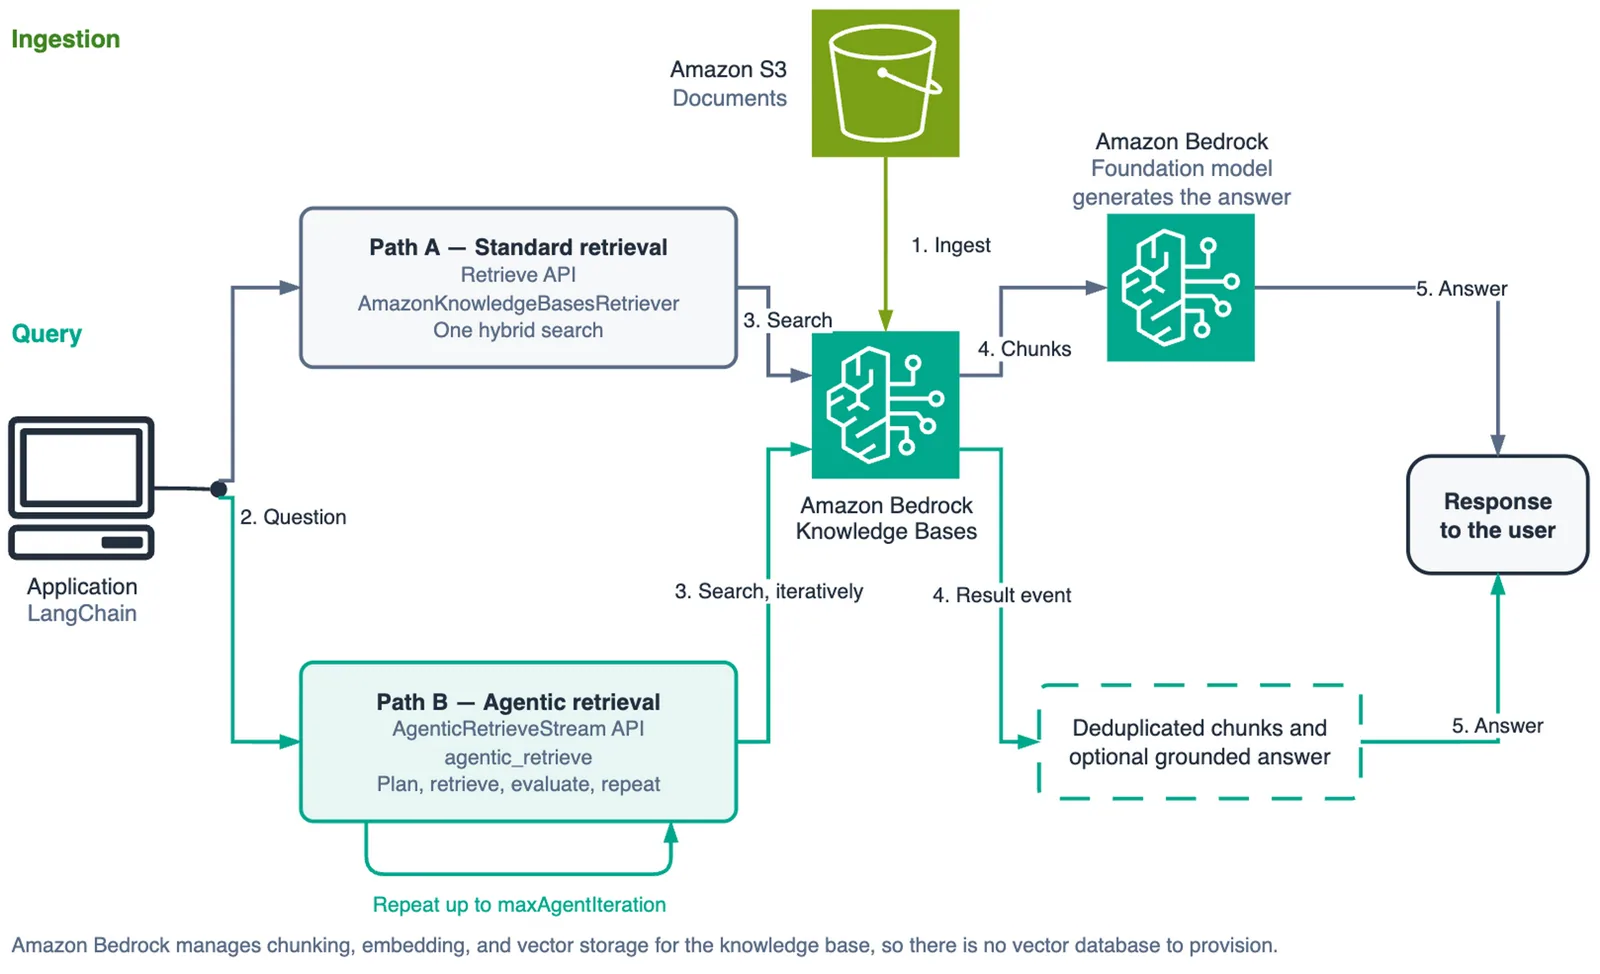
Kedua jalur ini ngembaliin potongan teks dari knowledge base yang sama, lalu dokumen itu diterusin ke model bahasa buat nyusun jawaban akhir.
Setup IAM dan Permission: Jangan Lupa GetDocumentContent
Sebelum mulai nulis kode Python, kamu butuh akun AWS dengan akses Bedrock di Region yang mendukung, misalnya US East (N. Virginia) alias us-east-1. Versi library yang dipakai juga kudu pas, minimal Python 3.12, langchain>=1.0, langchain-aws>=1.6.3, dan boto3>=1.43.32 karena API streaming ini belum ada di boto3 versi lama.
Ada dua identitas IAM yang terlibat: service role buat knowledge base, dan caller identity buat aplikasi kamu. Pisahin keduanya dengan bener.
Service role knowledge base butuh trust policy ke bedrock.amazonaws.com yang dibatasi dengan aws:SourceAccount dan aws:SourceArn. Role ini juga wajib punya izin s3:ListBucket dan s3:GetObject ke bucket S3 kamu.
Buat caller identity di sisi aplikasi, kamu butuh izin berikut:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "AgenticRetrievalAndPlannerModel",
      "Effect": "Allow",
      "Action": [
        "bedrock:AgenticRetrieveStream",
        "bedrock:InvokeModelWithResponseStream"
      ],
      "Resource": "*"
    },
    {
      "Sid": "RetrieveAndFullDocumentExpansion",
      "Effect": "Allow",
      "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
      "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
    },
    {
      "Sid": "GenerateAnswersInTheChains",
      "Effect": "Allow",
      "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
      "Resource": "*"
    }
  ]
}Tutorial LangChain RAG: Setup Knowledge Base dan Query Standar
Langkah pertama, bikin dulu knowledge base-nya lewat SDK boto3. Di sini kita pakai konfigurasi managed biar Bedrock yang ngatur embedding modelnya secara otomatis.
import boto3
import os
import time

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name="kb-demo-rag",
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
Setelah itu, sambungin bucket S3 sebagai data source dan jalanin ingestion job. Karena proses ingestion itu asynchronous, bikin loop pengecekan sampai statusnya COMPLETE.
Buat pertanyaan sederhana kayak "What is the restore time objective for the checkout service?", kamu cukup pakai retriever standar dari langchain-aws:
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever

retriever = AmazonKnowledgeBasesRetriever(
    knowledge_base_id=KB_ID,
    region_name=REGION,
    retrieval_config={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
        }
    },
)
docs = retriever.invoke("What is the restore time objective for the checkout service?")
Ingat, pakai managedSearchConfiguration, bukan vectorSearchConfiguration yang biasanya dipakai kalau kamu kelola vector store sendiri. Setiap hasil bakal balik dalam format Document LangChain lengkap bareng skor relevansi di metadata["score"].
Mengaktifkan Agentic Retrieval dan Membaca Trace Events
Agentic retrieval bukan sekadar flag di retriever biasa, melainkan fitur bawaan Bedrock. Di paket langchain-aws, fitur ini disediain lewat fungsi mandiri bernama agentic_retrieve:
from langchain_aws.retrievers.bedrock import agentic_retrieve

result = agentic_retrieve(
    knowledge_base_id=KB_ID,
    query="Bandingkan checkout dan inventory untuk on-call, restore target, dan rollback",
    region_name=REGION,
    generate_response=True,
    number_of_results=10,
)
print(result["generatedResponse"]["answer"])
Fungsi ini praktis banget karena langsung ngasih jawaban akhir berdasar rujukan dokumen. Tapi kalau kamu pengin ngintip apa yang sebenernya dipikirin sama model di balik layar, kamu bisa manggil API agentic_retrieve_stream lewat klien bedrock-agent-runtime langsung.
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}],
    retrievers=[{
        "configuration": {
            "knowledgeBase": {
                "knowledgeBaseId": KB_ID,
                "retrievalOverrides": {"maxNumberOfResults": 10},
            }
        }
    }],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        "maxAgentIteration": 5,
    },
    generateResponse=False,
)

for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f"  sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])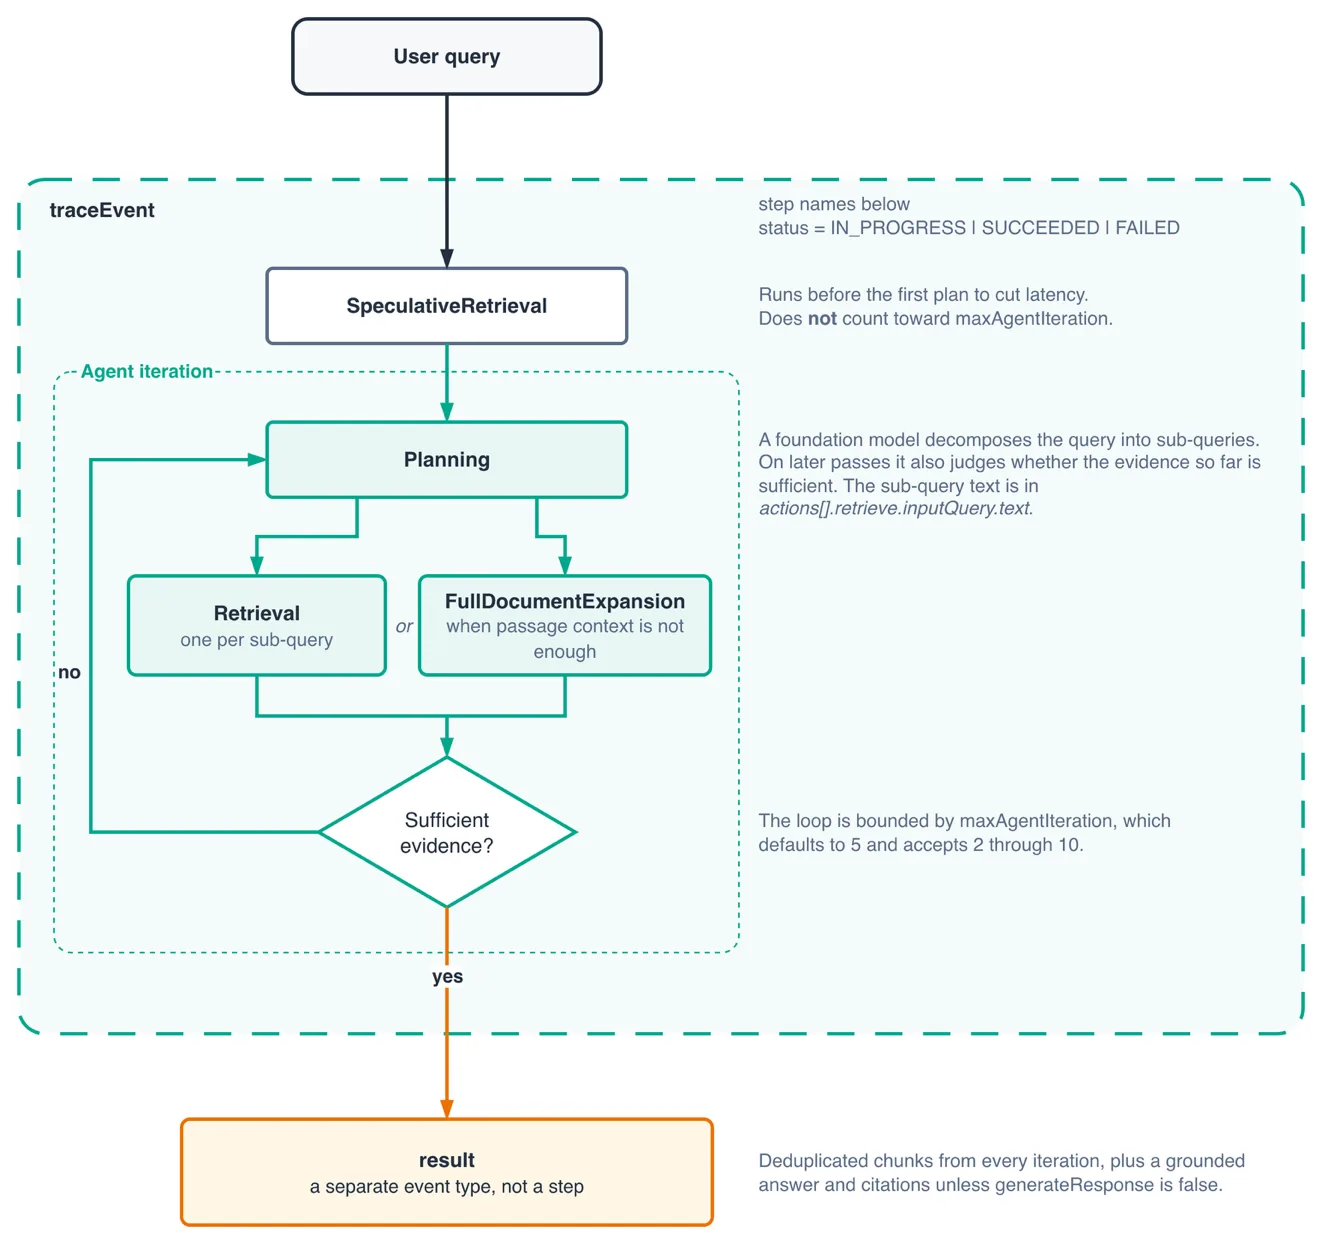
Lewat trace event itu, kamu bisa ngeliat empat tahapan utama:
- SpeculativeRetrieval: Berjalan cepat sebelum rencana dibikin biar latensi awal tetap rendah tanpa ngurangin kuota iterasi.
- Planning: Model menganalisis pertanyaan utama dan hasil awal, lalu ngerilis sub-query baru.
- Retrieval: Menjalankan pencarian untuk masing-masing sub-query.
- FullDocumentExpansion: Aktif kalau potongan teks dirasa kurang lengkap konteksnya, sehingga model narik dokumen utuh dari storage.
Ada hal penting soal data skor relevansi: kalau di Retrieve biasa ada field score, hasil dari agentic retrieval cuma nyediain content, metadata, dan sourceRetriever tanpa ada angka skor relevansi. Kalau kodemu bergantung pada filtering skor angka, ini wajib diantisipasi.
Integrasi ke RAG Chain LangChain Pakai LCEL
Kalau kamu pengin ngontrol sendiri prompt dan model generator jawabannya, kamu bisa ngegabungin fungsi agentic retrieval ke dalam rantai LangChain Expression Language (LCEL) memakai RunnableLambda:
from langchain_core.runnables import RunnableLambda, RunnablePassthrough
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_aws import ChatBedrockConverse

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

prompt = ChatPromptTemplate.from_template(
    "Jawab pertanyaan berikut berdasarkan konteks:\n\n{context}\n\nPertanyaan: {question}"
)
llm = ChatBedrockConverse(model="anthropic.claude-3-5-sonnet-20241022-v2:0", region_name=REGION)

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
Dengan pola ini, kamu dapat fleksibilitas penuh buat ngatur prompt kustom tanpa terikat format jawaban default dari Bedrock.
Kalau kamu mau bereksperimen dengan model-model LLM lain buat rantai jawaban di luar Bedrock langsung, kamu juga bisa pakai Classai Router. Cukup pakai satu API key, kamu bisa manggil model kaya Claude Sonnet 4.6 (Rp17.300/1M input token) atau DeepSeek V4.1 Flash (Rp160/1M input token) pakai format OpenAI maupun Anthropic SDK yang standar.
Perbandingan: Standard Retrieval vs Agentic Retrieval
Biar nggak bingung milih kapan harus pakai metode biasa dan kapan pakai agentic, tabel ini ngerangkum perbedaannya berdasarkan pengujian AWS:
| Fitur / Parameter | Standard Retrieval (Retrieve) | Agentic Retrieval (AgenticRetrieveStream) |
|---|---|---|
| Tipe Kueri Ideal | Pertanyaan simpel & fokus | Pertanyaan bercabang, perbandingan, eksploratif |
| Latensi | Rendah (satu kali panggil) | Lebih tinggi (ada siklus evaluasi & planning) |
| Biaya Eksekusi | Sangat murah | Lebih mahal karena butuh beberapa inferensi model |
| Skor Relevansi | Ada di metadata["score"] | Nggak ada field skor angka |
| Multi Knowledge Base | Terbatas 1 knowledge base | Bisa sampai 5 knowledge base sekaligus |
| Mode Guardrails | Mendukung BLOCK dan MASK | Cuma mendukung mode BLOCK |
Evaluasi AWS pada benchmark multi-hop publik (MuSiQue) ngebuktiin kalau agentic retrieval ngasih peningkatan recall paling tinggi di pertanyaan-pertanyaan sulit yang butuh penalaran bertahap. Sebaliknya, buat pertanyaan single-hop biasa, peningkatan skornya di bawah 5 poin. Artinya, memaksakan agentic loop buat pertanyaan sederhana cuma buang-buang biaya.
Untuk prompt evaluasi di query router, kamu bisa nyiapin klasifikasi intent seperti ini:
Kamu adalah Query Classifier untuk sistem RAG. Analisis pertanyaan pengguna berikut: Pertanyaan: {question} Tentukan apakah pertanyaan ini merupakan kueri sederhana (SINGLE_INTENT) atau kueri bercabang/perbandingan yang butuh pencarian banyak langkah (MULTI_INTENT).Keluarkan hanya format JSON:{"intent": "SINGLE_INTENT" | "MULTI_INTENT", "reason": "alasan singkat"}
Dampak Nyata Buat Developer dan Tech Lead di Indonesia
Buat developer maupun tim engineering di Indonesia yang lagi ngebangun aplikasi AI enterprise, ada beberapa hal penting yang perlu dipertimbangkan:
- Efisiensi Tagihan Cloud: Jangan jadikan agentic retrieval sebagai default buat semua request chatbot. Kalau semua traffic diarahkan ke planning loop, tagihan AWS Bedrock kamu bakal melonjak drastis karena banyaknya token tersembunyi yang kepakai pas langkah perencanaan.
- Kepatuhan Privasi & UU PDP: Knowledge base di AWS Bedrock membaca file langsung dari S3 di region yang kamu tentukan. Pastikan data sensitif pengguna Indonesia tetap mematuhi prinsip perlindungan data pribadi dengan enkripsi KMS dan pembatasan akses bucket yang ketat.
- Jangan Lupa Beres-Beres Resource: Setelah selesai nyobain eksperimen ini, langsung hapus knowledge base, data source, dan file di bucket S3. Knowledge base yang masih nyimpen data dokumen bakal terus kena biaya penyimpanan berkala.
Kalau kamu tertarik mendalami arsitektur aplikasi AI, integrasi API, dan perancangan agent cerdas secara menyeluruh, kamu bisa cek materi lengkapnya di kelas AI untuk Developer.
Kamu juga bisa baca pembahasan kami soal arsitektur sistem otomatis lainnya di artikel Ambient Agents di Amazon Bedrock buat ngeliat gimana agen AI bisa dipicu oleh event data secara otomatis.
Sumber & referensi
- 01
AWS · 5 Oktober 2026
Agentic retrieval with LangChain and Amazon Bedrock Knowledge Bases
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa bedanya standard retrieval dengan agentic retrieval di LangChain Bedrock?
Standard retrieval cuma melakukan satu kali pencarian kesamaan vektor untuk seluruh teks pertanyaan pengguna. Sementara itu, agentic retrieval memecah pertanyaan rumit menjadi beberapa sub-query, mengevaluasi kecukupan bukti, dan bisa mencari ulang jika dokumen belum lengkap.
Kenapa query agentic retrieval membutuhkan izin bedrock:GetDocumentContent?
Izin tersebut dibutuhkan saat tahap FullDocumentExpansion berjalan. Jika model merasa potongan teks hasil pencarian awal kurang memberikan konteks jawaban yang utuh, model akan memanggil izin tersebut untuk mengambil seluruh isi dokumen asli.
Berapa batas maksimal iterasi yang disarankan untuk agentic retrieval Bedrock?
Batas maksimal parameter maxAgentIteration disarankan tetap di angka default 5. Pengaturan di bawah angka 4 akan membuat sistem berhenti memecah sub-query dan perilakunya mirip dengan pencarian single-shot biasa.
Apakah agentic retrieval selalu lebih baik dibandingkan RAG biasa?
Nggak selalu, karena agentic retrieval memiliki latensi lebih tinggi dan biaya per panggilan yang lebih mahal. Metode ini sangat unggul untuk pertanyaan perbandingan bercabang, tetapi kurang efisien untuk pertanyaan sederhana berfokus tunggal.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.