Evaluasi Multi Agent Bedrock: Uji Akurasi dan Explainability
Bikin sistem multi-agent emang seru, tapi gimana cara ngecek logikanya pas masuk produksi? AWS bongkar framework evaluasi multi agent Bedrock di sini.
· 7 menit baca
Inti singkat
- Evaluasi multi agent butuh validasi rantai tool dan batasan bisnis, bukan sekadar respons teks.
- Amazon Bedrock AgentCore Evaluations punya evaluasi bawaan dan kustom untuk mode on-demand maupun online.
- Framework evaluasi dibagi jadi tiga lapis: metrik umum, validasi aturan bisnis, dan explainability independen.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
Amazon Web Services (AWS) membeberkan framework baru untuk evaluasi multi agent Bedrock memakai Amazon Bedrock AgentCore Evaluations, dengan fokus pada akurasi keputusan dan explainability. Langkah ini penting banget karena bikin sistem multi-agent yang cuma jago ngobrol udah nggak cukup buat kebutuhan bisnis nyata yang rumit. Seperti dilaporkan AWS Machine Learning Blog, sistem agen AI di perusahaan butuh jaminan logika yang jelas sebelum dilepas ke tahap produksi.
Kalau kamu pernah nyobain ngerakit beberapa agen AI sekaligus, tantangan terbesarnya biasanya bukan di cara manggil modelnya. Masalah muncul pas agen-agen itu mulai oper-operan tugas: apakah alat (tool) yang dipilih bener, batas anggaran dipatuhi, dan alasannya masuk akal? Kita bahas bareng gimana cara kerja framework evaluasi ini.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Evaluasi Multi Agent Bedrock Beda dari Evaluasi LLM Biasa?
Evaluasi LLM standar biasanya cuma ngecek seberapa luwes jawaban teks yang keluar dari model. Tapi di sistem multi-agent, agen-agen saling koordinasi buat bikin keputusan, jalanin workflow, dan manggil berbagai API. Jawaban yang kedengaran meyakinkan bisa aja salah total kalau agen salah milih sub-agent atau ngabaikan batas stok gudang.
Platform Amazon Bedrock AgentCore dirancang buat ngebangun, nyambungin, dan ngaudit agen dalam skala besar pakai model atau framework apa aja. Nah, fitur Amazon Bedrock AgentCore Evaluations hadir sebagai solusi fully-managed buat ngukur performa agen sepanjang fase development sampai produksi. Fitur ini melengkapi Amazon Bedrock AgentCore yang juga didukung kontrol pengaman Amazon Bedrock Guardrails.
Arsitektur Solusi: Kasus AnyCompany Retail
Buat nunjukin cara kerjanya, AWS ngasih studi kasus perusahaan fiktif bernama AnyCompany Retail. Perusahaan ini punya toko fisik, gudang regional, dan jalur ecommerce, tapi sering ngadepin masalah stok nggak seimbang: ada wilayah yang kehabisan barang pas promo, sementara wilayah lain malah kelebihan stok.
Solusi ini dibangun pakai framework Strands Agents SDK, Amazon Bedrock AgentCore MCP Server, dan evaluasi bawaan AgentCore. Seluruh agen jalan di Amazon Bedrock AgentCore runtime bareng Amazon Bedrock AgentCore memory serta Amazon Bedrock AgentCore Observability. Kalau kamu tertarik ngeliat konsep agen otonom lainnya, kamu juga bisa baca ulasan soal /developer/ambient-agents-amazon-bedrock-agentcore.
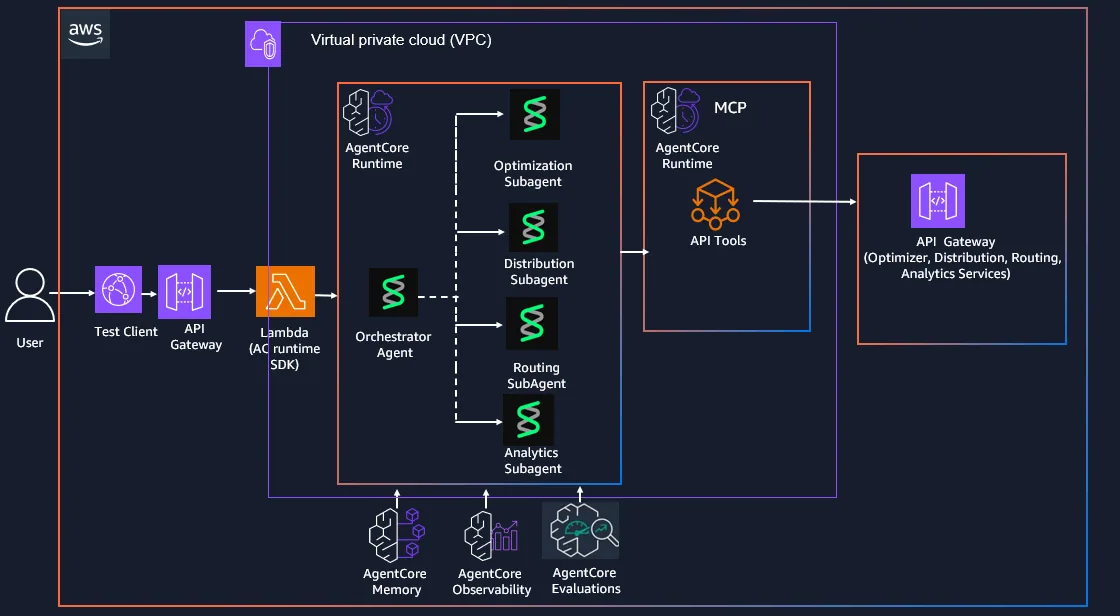
Arsitektur ini nerapin satu agen orkestrator utama dan empat sub-agent khusus:
- Orchestrator agent: Nerima permintaan planner lalu membagi tugas ke sub-agent yang dipasang sebagai tool.
- Optimization agent: Manggil tool MCP lewat mock Amazon API Gateway REST buat ngitung keputusan stok optimal.
- Distribution agent: Manggil API rekomendasi buat nyaranin penyeimbangan stok antargudang dan toko.
- Routing agent: Manggil API logistik buat nentuin opsi rute dan kurir pengiriman.
- Analytics agent: Ngejawab pertanyaan diagnostik rantai pasok dengan bikin query database.
Tiga Lapisan Framework Evaluasi Multi Agent Bedrock
Biar pengujian sistem multi agent bener-bener terpercaya, framework ini nerapin tiga lapisan evaluasi secara bertahap:
- Lapisan 1 (Built-in evaluators): Evaluasi bawaan tanpa setup tambahan. Metrik Helpfulness dipakai sebagai patokan dasar semua agen, ditambah satu metrik bawaan sesuai risiko utama masing-masing agen (misal Tool Selection Accuracy untuk orkestrator atau Faithfulness untuk analitik).
- Lapisan 2 (Custom evaluators): Evaluasi kustom buat aturan bisnis nyata. Di sini tim ngecek apakah rekomendasi menghormati batas budget, kapasitas gudang, atau kebenaran query SQL.
- Lapisan 3 (Explainability evaluators): Pengecekan independen buat ngukur apakah agen transparan dalam ngejelasin alasan di balik keputusannya.
Berikut rangkuman pembagian tugas evaluator di tiap agen:
| Agen | Evaluator Bawaan (Built-in) | Evaluator Kustom (Custom) |
|---|---|---|
| Orchestrator | Helpfulness; Tool Selection Accuracy | Plan coherence; Tool trajectory |
| Optimization | Helpfulness; Response Relevance | Constraint satisfaction (budget, stok, kapasitas); KPI attainment |
| Distribution | Helpfulness; Response Relevance | Recommendation groundedness; Risk impact |
| Routing | Helpfulness; Instruction Following | Route feasibility (ongkir, jadwal, armada); SLA evaluator |
| Analytics | Helpfulness; Faithfulness | SQL correctness; Data-grounding (Amazon RDS); No unsupported claims |
Explainability AI Agent Jadi Kunci Kepercayaan Sistem
Hal menarik dari framework ini adalah explainability AI agent diperlakukan sebagai dimensi evaluasi tingkat pertama yang terpisah. Keputusan agen bisa aja benar secara hitungan matematika, tapi kalau planner bisnis nggak ngerti kenapa angka itu dipilih, sistemnya bakal susah dipercaya.
Ada enam evaluator explainability yang dipasang secara independen:
- Decision rationale quality: Ngecek apakah agen ngejelasin alasan di balik sarannya.
- Evidence attribution: Ngecek apakah agen nyebut data, API response, atau hasil SQL yang mendasari keputusan.
- Constraint reasoning: Ngecek apakah batasan bisnis yang nentuin hasil akhir dijelaskan secara gamblang.
- Trade-off explanation: Ngecek apakah agen ngejelasin kompromi antara biaya, SLA, dan risiko stok.
- Tool-use explainability: Khusus orkestrator, ngecek alasan kenapa sub-agent tertentu dipanggil.
- Assumption disclosure: Ngecek apakah agen ngaku bikin asumsi tertentu pas datanya nggak lengkap.
Pemisahan ini bikin tim developer bisa ngebedain antara jawaban yang "bener tapi nggak transparan" dengan jawaban yang "penjelasannya meyakinkan tapi hitungannya salah".
Cara Deploy dan Menjalankan Evaluasi di Amazon Bedrock
Source code pengujian ini udah disiapin tim AWS di GitHub repo sample-agentic-genai-agentcore dan repository sampel AgentCore awslabs. Buat nyiapin lingkungannya, kamu butuh AWS CLI, AWS SAM CLI minimal v1.100.0, Docker v20.x ke atas, Node.js v18.x+, dan Python v3.11+.
Dependensi kodenya mencakup strands-agents, strands-agents-tools, requests, bedrock-agentcore, dan boto3. Langkah-langkah penerapannya adalah sebagai berikut:
1. Deploy Infrastruktur via Terraform
Masuk ke folder terraform, atur variabel vpc_id dan runtime_subnet_azs di file terraform.tfvars, lalu deploy:
cd terraform
cp terraform.tfvars.example terraform.tfvars
terraform init
terraform apply
Output Terraform bakal nampilin runtime ARN, URL API retail, evaluator API URL, dan memory ARN.
2. Jalankan Sesi Kueri Pengujian
Jalankan test client buat ngirim kueri simulasi ke agen rantai pasok. Script ini bakal ngembaliin session ID yang dicatat lewat AgentCore Observability:
cd test_client
pip install -r requirements.txt
python test_agent.py --runtime-arn "<supply_chain_arn>" --category optimization
3. Buat dan Daftarkan Custom Evaluators
Pindah ke direktori evaluasi lalu daftarkan evaluator kustom ke API:
cd ../test_evaluators
pip install -r requirements.txt
python test_evaluator.py --api-url "https://<evaluators-api-url>" create
4. Eksekusi Pengujian Terpadu
Panggil evaluasi kustom bareng evaluator bawaan buat session ID yang tadi didapat. Panggilan API ini sifatnya asinkron (ngasih respon HTTP 202 langsung):
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_optimization_constraint-<id>,Builtin.Helpfulness,Builtin.ResponseRelevance"
Hasil laporan pengujian bakal disimpan otomatis ke Amazon S3 dalam bentuk file EvaluationResults.md.
5. Jalankan Evaluator Explainability
Di session ID yang sama, kamu bisa langsung ngecek kualitas transparansi agen dengan manggil evaluator explainability:
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_decision_rationale-<id>,sc_constraint_reasoning-<id>"
Kalau semua pengujian udah selesai dicoba, bersihkan seluruh resource di akun AWS kamu biar nggak kena tagihan berjalan:
cd ../terraform
terraform destroy
Perbedaan Mode Evaluasi: On-Demand vs Online
Sistem multi-agent di Bedrock AgentCore Evaluations ngedukung dua mode pengujian yang saling melengkapi:
- Mode On-Demand: Dipakai pas tahap pengembangan, regression testing, atau gate pengecekan di pipeline CI/CD sebelum kode di-merge ke branch utama.
- Mode Online: Dipakai buat continuous monitoring pas agen udah live di production. Kamu cukup bikin konfigurasi
OnlineEvaluationConfigyang ngarah ke ARN evaluator dan nentuin sampling rate (misal 1% sampai 10% dari trace produksi). Sistem bakal otomatis ngebaca jejak interaksi dari AgentCore Observability, ngasih skor, dan ngirimin metrik serta alarm ke Amazon CloudWatch.
Buat developer yang lagi eksplorasi arsitektur multi-agent serupa di ekosistem AWS, kamu juga bisa melirik bahasan /developer/glm-5-3-bedrock-fitur-cara-pakai buat ngeliat pilihan model coding lain yang tersedia di Bedrock.
Kalau kamu butuh integrasi model cerdas lain ke sistem orkestrasimu lewat endpoint yang fleksibel, kamu bisa pakai Classai Router. Lewat satu API key, kamu bisa manggil model penalaran seperti Claude Sonnet 4.6 (Rp17.300 / Rp86.600 per 1 juta token) atau DeepSeek V4.1 Flash (Rp160 / Rp800 per 1 juta token) dengan format SDK standar tanpa ribet ganti-ganti setup kredensial luar negeri.
Dampak Nyata Buat Developer dan Tim IT di Indonesia
Nerapin evaluasi multi agent Bedrock ngasih fondasi kuat buat tim teknis di Indonesia yang mulai ngerancang solusi enterprise otomatis. Di sektor logistik, perbankan, maupun ritel lokal, kesalahan agen AI bukan cuma bikin malu, tapi bisa nimbulin kerugian finansial langsung kalau ada salah alokasi barang atau keliru membaca batas kredit.
Selain itu, pemisahan lapisan explainability ngebantu perusahaan patuh pada prinsip auditabilitas data dan akuntabilitas algoritma. Ketika agen AI ngasih rekomendasi restock atau pengalihan rute pengiriman, tim operasional manusia bisa ngecek data pendukungnya secara transparan sebelum mengeksekusi keputusan bernilai miliaran rupiah.
Sumber & referensi
- 01
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa fungsi utama Amazon Bedrock AgentCore Evaluations?
Fitur ini dipakai untuk mengevaluasi kinerja sistem multi-agent secara otomatis, baik pas tahap testing (on-demand) maupun di tahap produksi (online). Pengujian mencakup akurasi tool, kepatuhan batas bisnis, hingga kejernihan alasan keputusan.
Apa bedanya evaluasi bawaan dan evaluasi kustom di Bedrock AgentCore?
Evaluasi bawaan langsung siap pakai untuk metrik umum seperti Helpfulness dan Response Relevance. Sementara evaluasi kustom dibuat khusus untuk aturan bisnis spesifik, misalnya ngecek kecocokan query SQL, batas kapasitas gudang, atau batas anggaran biaya.
Kenapa explainability perlu dipisah dari evaluasi akurasi agen?
Pemisahan ini penting supaya developer tahu masalah aslinya saat agen gagal. Agen bisa saja menghasilkan hitungan yang tepat tapi penjelasannya buram, atau sebaliknya memberi alasan yang meyakinkan padahal melanggar batas aturan bisnis.
Bagaimana cara kerja evaluasi online di Amazon Bedrock?
Evaluasi online mengambil sampel trace produksi dari AgentCore Observability (misal 1-10%), lalu menilainya secara otomatis pakai evaluator yang dipilih. Hasil skor dan notifikasi langsung dikirim ke dasbor Amazon CloudWatch.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.