ThinkingBox Rilis: Cara Ngecek Reliabilitas Agen AI di Database
ThinkingBox bikin agen AI diuji 20 kali berturut-turut dan dicek langsung ke database, bukan cuma jawaban teksnya—hasilnya banyak yang ternyata nggak konsisten.
· 12 menit baca
Inti singkat
- ThinkingBox ngukur agen AI dari state database dan side effect akhir, bukan dari tool call atau jawaban teks.
- Dari 121.680 trial, 67,24% kegagalan tetap 'kelihatan bersih'—nggak error, tapi datanya salah di backend.
- Kimi-K3 paling luas nyelesain tugas (93,89%), tapi cuma 13,41% yang konsisten benar 20 dari 20 kali.
- Claude Opus 5.5 dan Claude Opus 5 sama-sama cuma 241 dari 507 tugas yang lolos 20/20, walau skor akurasinya beda.
- Sekitar 79,9% kegagalan agen soal tool handling, bukan soal nalar modelnya.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
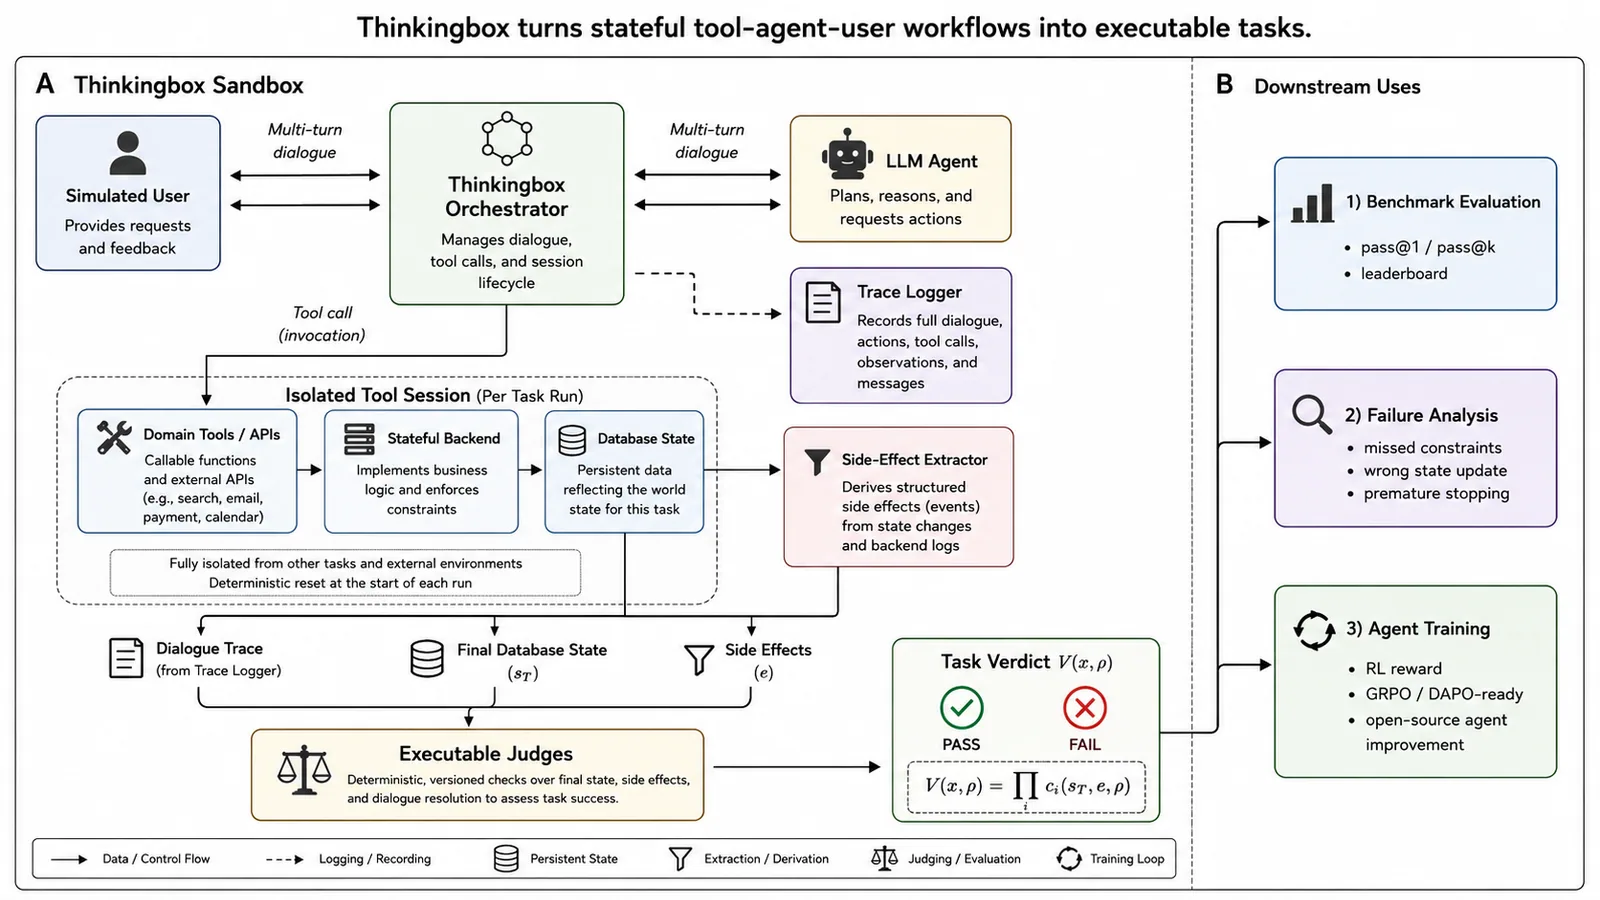
Microsoft baru ngerilis ThinkingBox, cara baru buat ngecek apakah agen AI benar-benar nyelesain kerjaannya—bukan cuma ngomong udah selesai. Bedanya, yang jadi hakim di sini bukan jawaban teks si agen, tapi database di belakangnya.
Menurut postingan resmi Microsoft dan Hugging Face, ide ini lahir dari kasus yang kedengarannya sepele tapi sering banget kejadian di dunia nyata. Bayangin, ada customer yang paket kompornya senilai $745 nyangkut di status "exception" kurir selama 15 hari lewat dari estimasi. Agen AI-nya kerja rapi: sembilan tool call, cek order, cek tracking, cek profil customer, baca kebijakan refund dua kali, buka tiket baru, dan nyimpulin dengan benar kalau segmen akun customer ini emang nggak dapet kompensasi keterlambatan.
Tapi di akhir, si agen nutup tiketnya sebagai "resolved" dan cuma balas, "Since your query is resolved, is there anything I may assist you with?" Padahal status pengiriman di kurir masih nyangkut, dan pertanyaan asli customer belum kejawab. Kalau cuma ngecek apakah tool call-nya valid, semuanya kelihatan beres. Tapi begitu dicek ke database, ketahuan ada satu field yang salah: status tiket "solved", padahal harusnya "hold". Kasus ini diambil langsung dari file sandbox_external_retail_group1.py:test_case_ST003_006 di benchmark ThinkingBox, dan jejak lengkapnya ada di Appendix D.4 Case 3 paper-nya.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa itu ThinkingBox dan kenapa reliabilitas agen AI database penting?
ThinkingBox itu sandbox buat ngejalanin agen, sementara ThinkingBox-Bench adalah dataset 507 workflow bisnis yang statusnya berubah-ubah (stateful)—kayak retail, asuransi mobil, travel, neobank, sampai consulting. Tiap tugas dijalanin 20 kali berturut-turut dari kondisi backend yang sama-sama bersih, lalu dicek: apa yang benar-benar berubah di database, bukan cuma apa yang dibilang agennya.
Kenapa ini penting? Karena menurut temuan mereka, trajectory (urutan tool call dan jawaban) itu cuma klaim. Database adalah bukti. Dalam satu ablation yang ngecek 121.680 trial valid dari 12 model LLM, ada 79.853 attempt yang gagal lolos cek executable. Dari yang gagal itu, 67,24% tetap kelihatan "bersih"—selesai tanpa error, manggil tool yang ngubah state, dan nggak ada error di tool terakhir. Tapi pas dicek state-nya: 77,61% punya nilai field yang salah, 43,30% bikin efek tambahan yang nggak diminta, dan 25,36% malah kelewat satu efek yang wajib ada.
Artinya, kalau cuma ngandelin apakah agen "kelihatan selesai dengan benar", kamu bisa ketipu lebih dari separuh waktu. Buat kamu yang lagi bikin atau evaluasi agent ai buat kerjaan nyata—customer service, billing, inventory—ini jadi alasan kenapa cek harus sampai ke level data, bukan cuma transkrip percakapan.
Pass@1, Pass@20, Observed 20/20: ngukur konsistensi, bukan cuma skor sekali jalan
ThinkingBox nggak cuma ngasih satu angka. Ada tiga metrik yang dipakai:
| Metrik | Yang diukur | Pertanyaan yang dijawab |
|---|---|---|
| pass@1 | Persentase semua attempt yang sukses | Rata-rata, seberapa bagus modelnya? |
| pass@20 | Tugas yang pernah sukses minimal sekali dari 20 percobaan | Bisa nggak sih model ini ngerjain ini sama sekali? |
| Observed 20/20 | Tugas yang sukses di SEMUA 20 percobaan | Bisa diandalkan setiap kali atau nggak? |
Angka pass@1 yang paling sering dipajang di leaderboard itu kelihatan kayak ranking kemampuan biasa. Berikut hasil pass@1 per domain dari paper-nya:
| Model | Retail | Asuransi mobil | Travel | Neobank | Consulting | Overall |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 80,97 | 68,40 | 54,28 | 71,25 | 61,58 | 67,16 |
| Claude Opus 5 | 80,71 | 65,80 | 49,95 | 70,62 | 66,19 | 66,50 |
| GPT-5.4 | 76,33 | 62,65 | 68,12 | 65,34 | 54,60 | 65,36 |
| GPT-5.6 Sol | 67,65 | 65,30 | 60,34 | 59,09 | 57,52 | 61,91 |
| Claude Sonnet 4.6 | 72,35 | 54,40 | 58,94 | 56,39 | 54,31 | 59,19 |
| GPT-6 Astra | 71,73 | 46,55 | 55,87 | 60,87 | 56,83 | 58,31 |
| Kimi-K3 | 82,24 | 50,80 | 61,83 | 41,35 | 51,63 | 57,37 |
| Qwen3.8-27B | 64,03 | 47,85 | 53,41 | 47,88 | 45,69 | 51,70 |
| GPT-5.2 | 70,20 | 22,40 | 53,70 | 51,15 | 34,06 | 46,28 |
| DeepSeek-V4-Pro | 68,21 | 29,65 | 43,13 | 44,86 | 31,04 | 43,26 |
| Kimi-K2.6 | 53,72 | 24,50 | 39,52 | 33,65 | 37,33 | 37,66 |
| GLM-5.1 | 58,67 | 25,70 | 35,43 | 13,27 | 34,06 | 33,19 |
| Qwen3.6-27B | 43,11 | 29,00 | 46,39 | 27,84 | 18,37 | 32,94 |
| Claude Opus 4.6 | 68,62 | 8,30 | 21,11 | 35,67 | 27,82 | 32,09 |
| o3-pro | 37,70 | 2,95 | 17,31 | 24,28 | 14,60 | 19,31 |
| Grok-4.3 | 43,93 | 2,60 | 15,14 | 1,78 | 9,55 | 14,38 |
| Qwen3.5-9B | 19,90 | 0,70 | 4,71 | 1,15 | 2,33 | 5,65 |
| Mistral-Large-3 | 11,28 | 1,30 | 8,99 | 1,15 | 0,74 | 4,66 |
Claude Opus 5.5 memimpin dengan 67,16%, cuma unggul tipis dari Claude Opus 5. Kimi-K3 jadi model open-weight paling kuat, bahkan ngalahin semua model proprietary di domain retail (82,24%). Tapi lihat juga gimana Claude Opus 4.6 jago banget di retail (68,62%) tapi ambruk total di asuransi mobil (8,30%)—domain memang bikin hasil bisa beda jauh.
Yang lebih penting: begitu tugas yang sama diulang 20 kali, berapa persen dari skor pass@1 itu yang masih bertahan?
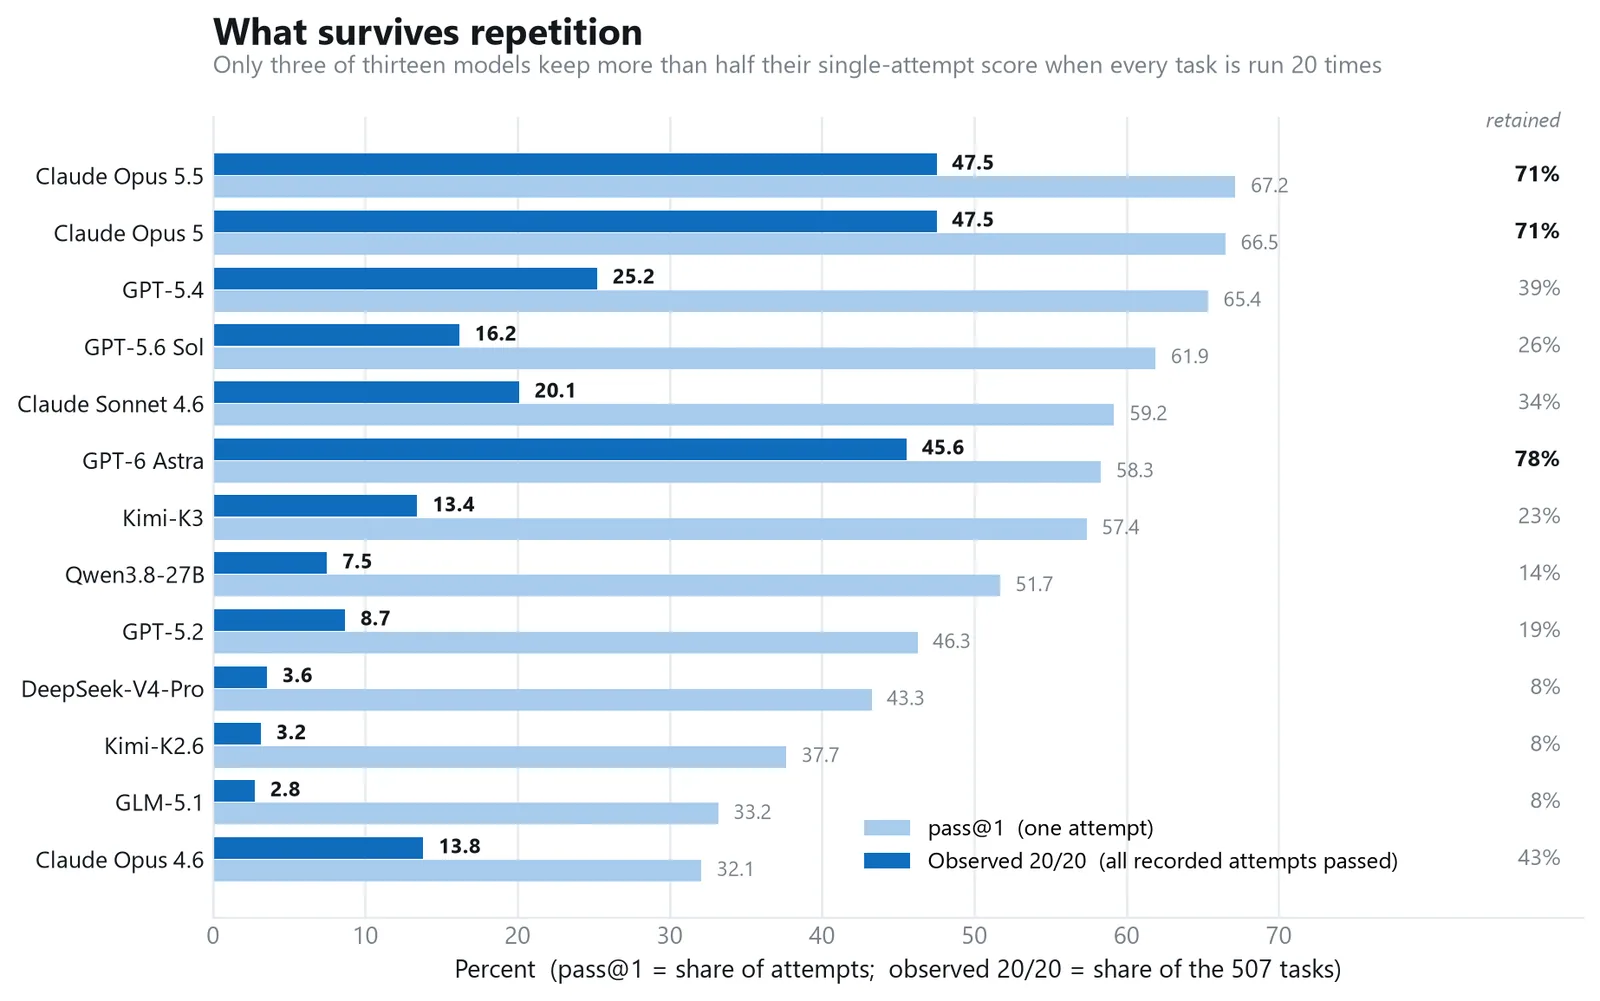
Jomplang banget kan? Model yang skornya kelihatan bagus sekali coba, ternyata banyak yang ambyar kalau diulang berkali-kali.
Siapa model paling konsisten? Kimi-K3 vs Claude Opus
Di sini letak temuan paling menarik. Kimi-K3 punya cakupan paling luas dari semua model yang diuji: dia berhasil nyelesain 93,89% dari 507 tugas minimal sekali (476 tugas), dan cuma 31 tugas yang bener-bener nggak bisa dia pecahin sama sekali—paling rendah di antara semua model.
Tapi Kimi-K3 juga salah satu model paling nggak konsisten. Cuma 68 dari 507 tugas (13,41%) yang dia selesaikan benar di SEMUA 20 percobaan.
Claude Opus 5 kebalikannya. Dia cuma berhasil minimal sekali di 79,09% tugas (106 tugas sama sekali nggak bisa dia pecahin), tapi dia nyelesain 47,53% dari seluruh benchmark dengan sempurna di semua 20 attempt.
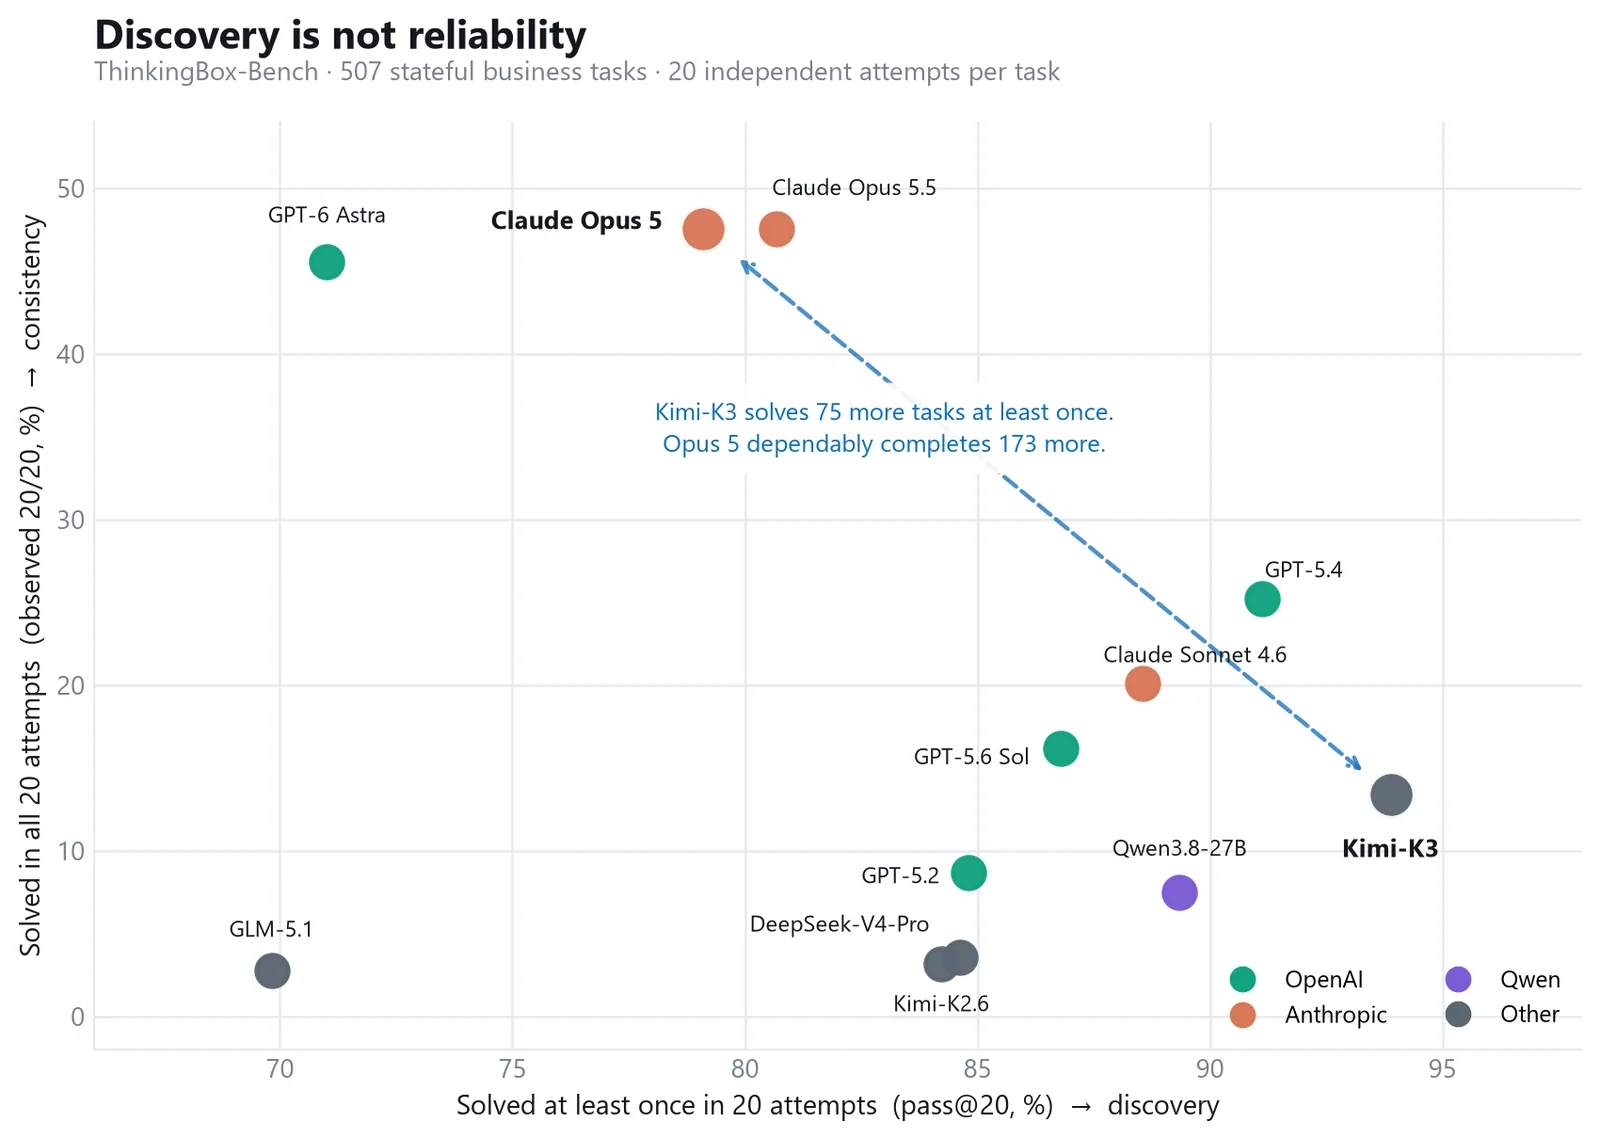
Menariknya lagi, Claude Opus 5.5 yang lebih baru punya skor every-attempt average lebih tinggi dari Claude Opus 5 (67,16% vs 66,50%) dan lebih banyak nyelesain tugas minimal sekali. Tapi jumlah tugas yang lolos 20/20 sama persis: 241 tugas. Artinya, setengah poin kenaikan akurasi di headline nggak nambah dependability sama sekali.
Kesimpulannya: kalau kamu mau pilih model buat kerjaan yang nyentuh data asli—bukan sekadar demo—angka pass@20 (bisa nggak sih dia pernah berhasil) itu kolom yang salah buat dilihat. Yang lebih relevan adalah observed 20/20.
Berapa biaya agen yang benar-benar bisa diandalkan?
Skor doang nggak cukup—biayanya juga perlu dihitung. ThinkingBox ngitung dua jenis biaya pakai harga list OpenRouter (snapshot 20 September 2026): biaya per keberhasilan tugas, dan biaya per tugas yang dependable (lolos 20/20).
Untuk biaya per sukses tunggal, GPT-5.6 Sol paling murah di $0,127, GPT-5.4 di $0,131, dan Claude Opus 5.5 di $0,276. Sebagai pembanding, Claude Opus 5 malah lebih mahal di $0,475 per sukses—padahal akurasinya (66,50%) lebih rendah dari Opus 5.5 (67,16%). Jadi Opus 5 kalah di dua sisi sekaligus.
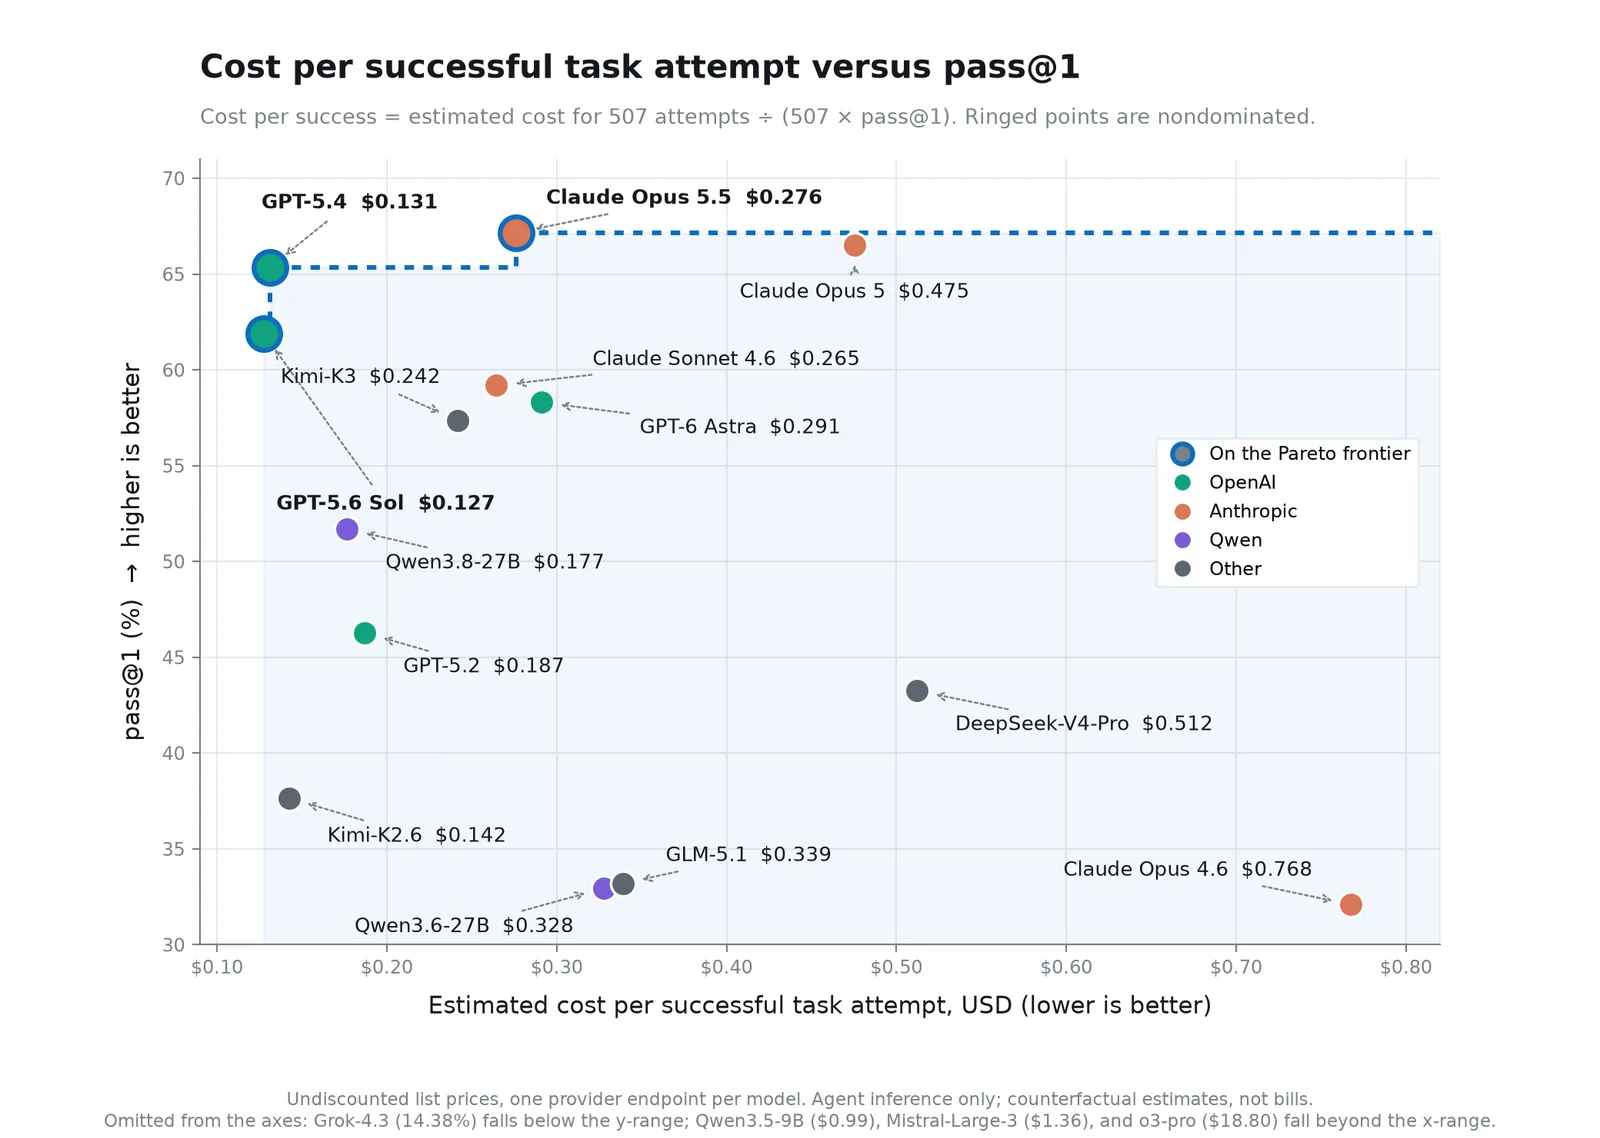
Tapi biaya per sukses tunggal itu nggak ngasih reward buat model yang benar SETIAP kali. Makanya ada hitungan cost per dependable task—biaya kampanye 20 run dibagi jumlah tugas yang lolos 20/20:
| Model | Tugas lolos 20/20 | Biaya 20 run | Biaya per tugas dependable |
|---|---|---|---|
| GPT-5.4 | 128 (25,25%) | $869,80 | $6,80 |
| GPT-6 Astra | 231 (45,56%) | $1.720,60 | $7,45 |
| Claude Opus 5.5 | 241 (47,53%) | $1.880,77 | $7,80 |
| GPT-5.6 Sol | 82 (16,17%) | $800,00 | $9,76 |
| Claude Opus 5 | 241 (47,53%) | $3.206,00 | $13,30 |
| Claude Sonnet 4.6 | 102 (20,12%) | $1.587,60 | $15,56 |
| GPT-5.2 | 44 (8,68%) | $878,00 | $19,95 |
| Kimi-K3 | 68 (13,41%) | $1.406,40 | $20,68 |
| Qwen3.8-27B | 38 (7,50%) | $925,80 | $24,36 |
Kelihatan jelas: model paling murah per sukses tunggal (GPT-5.6 Sol) ternyata nggak jadi yang paling murah per tugas yang dependable ($9,76). Sementara Claude Opus 5 yang sama-sama lolos 241 tugas kayak Opus 5.5, biayanya hampir dua kali lipat ($13,30 vs $7,80). Jadi cara tercepat dapet jawaban benar itu berbeda dari cara termurah dapet jawaban yang bisa diandalkan.
Kenapa agen AI sering gagal? Bukan soal nalar, tapi soal tool handling
Bagian paling actionable dari riset ini: ThinkingBox ngasih label diagnostik ke setiap kegagalan, dan hasilnya hampir 4 dari 5 kegagalan itu soal tool handling, bukan soal reasoning modelnya.
| Tanda kegagalan | Porsi dari total kegagalan |
|---|---|
| Tool usage (salah pakai tool) | 79,9% |
| Wrong state updates (update state yang salah) | 10,3% |
| Incomplete user resolutions (jawaban ke user nggak lengkap) | 7,0% |
| No state-changing action (nggak ada aksi yang ngubah state) | 2,9% |
Pola yang kelihatan: agen biasanya udah sampai jauh dalam ngerjain workflow, lalu gagal recover dari error tool, precondition yang gagal, atau lookup yang kosong. Itu masalah retry dan error-recovery, bukan masalah model-nya nggak pintar.
Domain juga ngaruh ke tingkat kesulitan—rata-rata pass@1 di retail itu 59,52%, sementara di asuransi mobil cuma 33,83%. Microsoft nyaranin beberapa langkah praktis: perlakukan rate 20/20 sebagai input desain (bukan verdict akhir), klasifikasi error tool biar retry diarahkan ke yang memang bisa di-recover, perkecil jumlah tool yang dikasih ke agen sesuai kebutuhan workflow, dan wajibkan approval manusia buat perubahan yang susah di-reverse.
Kalau kamu udah pernah baca soal AutoSynthData dari ServiceNow yang bikin agen belajar dari kegagalannya sendiri, pendekatan ThinkingBox ini melengkapi—satu sisi ngajarin agen biar nggak gagal, sisi lain ngasih cara ngukur gagalnya seberapa sering dan di mana.
Gimana cara kerjanya di balik layar?
Tiap tugas di ThinkingBox-Bench punya starting backend state, tujuan user, daftar tool MCP yang tersedia, kebijakan domain, dan cek executable atas state terakhir. Ada simulated user yang nyimpen konteks privat (nomor booking, preferensi, tanggal lahir) dan cuma ngasihnya kalau ditanya.

Setiap attempt dapet sesi MCP yang benar-benar terisolasi dengan state yang baru di-reset—dua attempt dari tugas yang sama nggak pernah berbagi baris database atau cache tool, yang bikin perbandingan 20 kali itu valid secara adil. Di akhir, side-effect extractor ngecek apa yang berubah, lalu judge deterministik bandingin itu sama required end state—nerima trajectory apapun yang hasil akhirnya benar, dan nolak kalau ada efek yang salah, kurang, atau kelebihan. Buat requirement yang nggak punya nilai database bersih (misal "apakah agen ngasih tahu ini nggak dijamin?"), ada rubrik binary sempit yang nangani. Dari 507 tugas, 477 dinilai murni dari state, sisanya 30 nambah rubrik respons.
Cara nyobain ThinkingBox dan OpenEnv sendiri
ThinkingBox sekarang udah ada di Hugging Face, lengkap sama harness dan dataset-nya, dan jalan lewat interface OpenEnv. Kalau kamu developer yang lagi bangun atau evaluasi agen sendiri, ini langkah-langkahnya:
- Install komponen utama. Clone repo OpenEnv dan sync environment thinkingbox pakai uv, lalu clone thinkingbox-data di release yang di-pin (
thinkingbox-bench-v1.0), dan install CLItbdari microsoft/thinkingbox. - Nyalain Typesense. Jalanin container Typesense 30.1 dan tunggu health check-nya sukses.
- Nyalain MCP server. Jalanin Session Proxy dan MCP server pakai
tb mcp-start, arahkan ke fileservers.yamldari thinkingbox-data. - Nyalain OpenEnv server. Jalanin server OpenEnv dengan config YAML yang nunjuk ke tiga model (agen, simulated user, judge)—bisa pakai satu endpoint buat ketiganya biar simpel. Lihat config guide buat detailnya.
- Cek readiness. Pastikan endpoint
/readyudah lolos sebelum lanjut, karena dia ngecek data, konfigurasi, dan Session Proxy. - Score satu episode. Pakai
thinkingbox-evalbuat ngejalanin satu test case (misalnyatest_case_ST002_001) dan lihat hasilnya diresults.jsonl.
Semua run di-gate pakai commit framework yang di-pin, data release yang di-pin, dan bundle hash, jadi hasilnya bisa diverifikasi, bukan cuma klaim sepihak. Kode ThinkingBox lisensinya MIT, data benchmark-nya CDLA-Permissive-2.0, dan environment OpenEnv-nya BSD-3-Clause.
Kamu adalah agen customer service. Sebelum menutup tiket sebagai "resolved", cek dulu:1. Apakah semua status terkait (pengiriman, pembayaran, refund) di sistem backend sudah sesuai dengan kondisi yang seharusnya?2. Apakah pertanyaan asli dari pelanggan sudah benar-benar terjawab, bukan cuma ditutup administratif?Kalau salah satu belum terpenuhi, JANGAN tutup tiket. Jelaskan ke pelanggan apa yang masih pending dan langkah selanjutnya.
Dampaknya buat developer dan bisnis di Indonesia
Buat tim developer di Indonesia yang mulai bangun agen AI—baik buat customer service, finance ops, atau internal tool—riset ini ngasih pelajaran penting: jangan cuma percaya respons teks "tugas selesai". Kalau agen kamu nyentuh data pelanggan, transaksi, atau status pembayaran, itu juga menyangkut tanggung jawab data di bawah UU PDP. Kesalahan state yang nggak ketahuan bisa berarti data pelanggan ke-update salah, bukan cuma "typo" di jawaban chatbot.
Buat yang mau nyobain model-model yang disebut di benchmark ini, beberapa di antaranya tersedia di Classai Router dengan satu API key yang sama—tinggal ganti nama model di kode kamu. Misalnya Claude Opus 5.5 (Rp7.700/Rp38.400 per 1 juta token input/output), Claude Opus 5 (Rp160/Rp800), Kimi K3 (Rp4.000/Rp5.000), GPT-6 Astra (Rp2.240/Rp11.200), GPT-5.6 Sol (Rp2.240/Rp11.200), DeepSeek V4 Pro (Rp2.000/Rp4.000), dan GLM 5.1 (Rp1.800/Rp4.000). Cocok dipakai buat bikin eksperimen kecil: jalanin tugas yang sama berkali-kali dari dua model berbeda, lalu bandingin mana yang konsisten—bukan cuma siapa yang kelihatan pintar di percobaan pertama.
Kalau kamu baru mulai belajar soal API dan cara kerja agen AI, baca dulu panduan dasar API AI buat pemula biar nggak bingung sama istilah MCP, tool call, dan endpoint yang disebut di artikel ini. Buat yang mau serius upgrade skill bangun agen AI untuk kerjaan, kelas AI untuk Developer di Classai juga bisa jadi langkah lanjutan yang pas.
Oh ya, penulis artikel ThinkingBox ini, Tuhin Kundu dari Microsoft, sebelumnya juga pernah nulis soal topik developer lain yang nggak kalah relevan buat tim yang kerja bareng Hugging Face.
Kalau ngebangun agent ai yang reliable itu ngena ke kamu, dua tulisan ini (ThinkingBox dan Foundry Managed Compute) sama-sama datang dari tim yang sering gali masalah praktis seputar deployment model AI di skala enterprise.
Sumber & referensi
- 01
Hugging Face · 4 Oktober 2026
The Agent Said It Was Done. The Database Disagreed.
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di halo@classai.id.
Pertanyaan yang sering ditanyakan
Apa itu ThinkingBox dari Microsoft?
ThinkingBox adalah sandbox dan benchmark buat ngecek reliabilitas agen AI, bikinan Microsoft Copilot Studio bareng Hugging Face dan Toloka. Bedanya dari benchmark biasa, dia ngukur apa yang benar-benar berubah di database setelah agen kerja, bukan cuma jawaban teks atau tool call yang valid.
Kenapa agen AI bisa bilang 'selesai' padahal sebenarnya gagal?
Karena tool call yang valid dan jawaban yang sopan nggak otomatis berarti data di backend ikut benar. Dari ablation ThinkingBox, 67,24% kegagalan tetap kelihatan 'bersih'—nggak ada error—tapi pas dicek state database, ada field yang salah, efek yang kelewat, atau efek tambahan yang nggak diminta.
Model AI mana yang paling konsisten menurut ThinkingBox-Bench?
Claude Opus 5.5 dan Claude Opus 5 sama-sama paling konsisten dengan 241 dari 507 tugas lolos sempurna di semua 20 percobaan (47,53%). Kimi-K3 justru paling luas nyelesain tugas minimal sekali (93,89%), tapi konsistensinya rendah—cuma 13,41% yang lolos 20/20.
Apa beda pass@1, pass@20, dan observed 20/20?
Pass@1 ngukur rata-rata keberhasilan sekali coba, pass@20 ngukur apakah tugas pernah berhasil minimal sekali dari 20 percobaan, dan observed 20/20 ngukur apakah tugas berhasil di SEMUA 20 percobaan tanpa terkecuali. Observed 20/20 paling relevan buat nilai reliabilitas agen yang nyentuh data nyata.
Gimana cara nyobain ThinkingBox sendiri?
ThinkingBox sudah tersedia di Hugging Face lewat interface OpenEnv, dengan harness dan dataset open source. Kamu perlu Python 3.11+, uv, dan Docker, lalu jalankan rangkaian setup—Typesense, MCP server, OpenEnv server—sebelum bisa nge-score episode agen kamu sendiri sesuai panduan di repo microsoft/thinkingbox.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.