AstaBrief Rilis: Model AI Open Source Ai2 untuk Laporan Riset
Ai2 ngerilis AstaBrief, model 8B open source yang bisa nulis laporan riset berisitasi cuma dalam 51 detik - jauh lebih ngebut dibanding mode Claude yang mereka pakai sebelumnya.
· 9 menit baca
Inti singkat
- AstaBrief 8B dari Ai2 adalah model AI open source yang dirilis gratis lengkap dengan data latihannya di Hugging Face.
- Fast mode pakai AstaBrief rata-rata cuma 51,1 detik per laporan, 3,5x lebih cepat dari Thinking mode yang pakai Claude (178,5 detik).
- Model dilatih dari 90 ribu query riset asli, disaring jadi 47 ribu data SFT dan 6 ribu pasangan DPO yang dinilai dua model juri.
- Filter citation density - bukan filter yang makin rumit - jadi kunci biar laporan tetap akurat sitasinya.
- Karena open weight, institusi riset bisa jalanin AstaBrief di server sendiri tanpa kirim data sensitif ke API pihak ketiga.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Ai2 baru ngerilis AstaBrief, model AI open source berukuran 8 miliar parameter yang bisa nulis laporan riset ilmiah lengkap dengan sitasi cuma dalam waktu rata-rata 51 detik - sekitar 3,5 kali lebih cepat dari mode andalan mereka yang pakai Claude.
Kalau kamu pernah nyuruh AI nyusun ringkasan dari banyak paper ilmiah, pasti ngerasain sendiri: makin lengkap jawabannya, biasanya makin lama nunggunya. Nah, menurut pengumuman resmi Ai2 di Hugging Face, mereka berhasil bikin model kecil yang nggak cuma cepat, tapi kualitas sitasinya tetap bisa diandalkan buat kerja ilmiah. Model ini namanya AstaBrief, dan sekarang jadi bagian dari Asta, platform riset agentic bikinan Ai2.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu AstaBrief, Model AI Open Source Bikinan Ai2?
AstaBrief itu model yang tugasnya spesifik: ngubah pertanyaan riset plus kutipan literatur yang udah diambil jadi laporan lengkap dengan sitasi, dalam satu kali proses tulis (bukan per bagian kayak biasanya). Modelnya dibangun dari basis Qwen3-8B, terus dilatih lagi khusus buat nulis laporan ilmiah.
Di Asta, AstaBrief sekarang jalan sebagai "Fast mode" di fitur Generate a Report, dampingan dari "Thinking mode" yang pakai Claude. Bedanya bukan cuma soal nama - Ai2 beneran ngerilis bobot modelnya plus data latihannya secara terbuka di Hugging Face, jadi siapa aja bisa download, pelajari, atau kembangin lagi. Ini yang bikin AstaBrief masuk kategori kecerdasan buatan sumber terbuka yang beneran bisa dipakai, bukan cuma demo.
Alasan Ai2 ngerilis ini terbuka juga praktis: banyak institusi riset butuh jalanin model di infrastruktur sendiri, apalagi kalau pertanyaan risetnya nyangkut data sensitif atau karya yang belum dipublikasiin. Model proprietary lewat API nggak selalu cocok buat kebutuhan kayak ini.
Gimana AstaBrief Dilatih? SFT dan DPO, Bukan RL
Menariknya, tim Ai2 sebenarnya udah punya pengalaman pakai reinforcement learning (RL) buat ningkatin kualitas laporan panjang - itu yang mereka pakai di model DR Tulu sebelumnya. Tapi buat AstaBrief, mereka justru pilih jalan yang lebih sederhana: supervised fine-tuning (SFT) dibarengi direct preference optimization (DPO).
Alasannya cukup masuk akal - RL itu mahal dan gampang nggak stabil. Tim Ai2 mau ngetes seberapa jauh kualitas laporan bisa didorong pakai setup yang lebih murah dan lebih gampang di-debug. Fokus utamanya jadi pindah ke kualitas data latihan, bukan ke metode optimasi yang makin canggih.
Selain itu, AstaBrief juga dilatih buat nulis laporan dalam satu pass langsung dari query dan potongan literatur yang relevan - nggak lewat proses ringkas-dan-kelompokkan dulu kayak di Thinking mode. Ternyata ini bisa dilakuin tanpa ngorbankan kualitas, dan efek sampingnya bikin proses jadi jauh lebih cepat.
Data Latihan: Dari 90 Ribu Query Peneliti Asli ke 47 Ribu Contoh SFT
Ini bagian yang menurut kami paling menarik. Tim Ai2 nggak pakai prompt sintetis atau benchmark buatan buat ngelatih AstaBrief - mereka ambil query riset asli dari pengguna Asta lewat sistem ScholarQA. Dari ratusan ribu query yang dikumpulin, mereka nemu kalau peneliti beneran kasih konteks panjang, banyak batasan, dan hubungan antarkonsep - bukan cuma kata kunci pendek kayak orang nyari di Google biasa.
Setelah disaring buat kualitas, relevansi, dan privasi (ngebuang trafik bot, query terlalu pendek, query non-Inggris, dan yang ada info pribadi), tersisa 90 ribu query riset. Dari situ, tim bikin laporan target pakai pipeline ScholarQA dengan model backing campuran: Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini, dan GPT-4.1. Hasil akhirnya 47 ribu contoh SFT yang siap pakai.
Untuk tahap DPO, mereka butuh pasangan laporan - satu lebih disukai dari yang lain. Satu laporan dibuat pakai pipeline ScholarQA (biasanya backing Claude), satu lagi dari model lain: o3, o4-mini, DeepSeek-V3, atau DeepSeek-R1. Dua model juri - GPT-4.1 dan DeepSeek-R1 - nentuin mana yang menang, dan cuma pasangan yang disetujuin keduanya yang dipakai. Tingkat kesepakatan dengan penilaian manusia sampai 95%. Hasilnya sekitar 6 ribu pasangan data DPO yang bersih dari noise.
Filter Sitasi Jadi Kunci, Bukan Filter yang Makin Rumit
Di percobaan awal, AstaBrief udah lumayan bagus soal kelengkapan isi, tapi masih ketinggalan soal akurasi jawaban dan kualitas sitasi dibanding pipeline berbasis Claude. Artinya, modelnya pinter nulis, tapi belum konsisten ngegrounding klaimnya ke bukti ilmiah yang bener.
Tim Ai2 ngetes empat filter berbasis statistik: rasio token output-input, relevansi sitasi, kepadatan sitasi, dan diversitas sitasi. Ternyata yang paling ngasih hasil nyata cuma satu: nyingkirin laporan sintetis dengan kepadatan sitasi rendah (banyak teks tanpa sitasi pendukung). Filter yang lebih rumit atau kombinasi banyak filter nggak nambah banyak.
Pelajaran ini jadi salah satu insight paling jelas dari proyek ini - sinyal sederhana soal apakah laporan konsisten nyitasi klaimnya ternyata lebih berguna dibanding kombinasi filter yang ribet. Spesialisasi ilmiah bukan cuma soal nambah teks sains di pretraining, tapi soal komposisi dan kualitas data post-training.
Seberapa Jago AstaBrief Dibanding Mode Thinking?
Evaluasi utama pakai SQABench-CS2, 200 pertanyaan riset ilmu komputer yang ditulis manusia, dengan empat metrik: rubric score (kelengkapan isi), answer precision (relevansi tiap paragraf), citation precision (apakah sitasi beneran mendukung klaim), dan citation recall (apakah klaim didukung penuh oleh sitasi yang ada). Evaluasi sekunder pakai DeepScholarBench, 63 query sintesis riset panjang dari paper ArXiv terbaru.
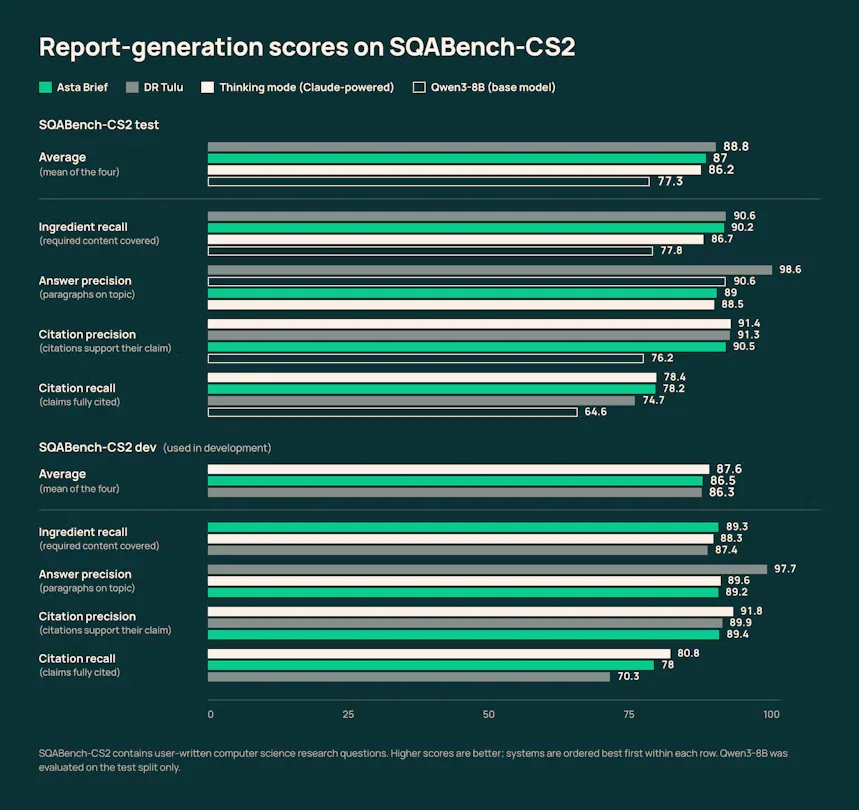
Di evaluasi ini, AstaBrief kompetitif sama pipeline Claude dan DR Tulu di beberapa ukuran kualitas jawaban dan sitasi. Soal kecepatan, perbedaannya jelas banget:
| Mode | Model di belakang | Waktu rata-rata per laporan |
|---|---|---|
| Fast mode | AstaBrief 8B (open source) | 51,1 detik |
| Thinking mode | Claude | 178,5 detik |
Artinya Fast mode sekitar 3,5x lebih cepat dari Thinking mode buat satu laporan penuh. Tapi Ai2 sendiri ngasih catatan penting: evaluasi ini dilakuin pas 2025, pakai model proprietary yang jadi frontier waktu itu. Mereka belum ngulang evaluasi lengkap lawan model frontier sekarang, jadi angka-angka ini lebih cocok dibaca sebagai validasi pendekatan desain sistemnya, bukan klaim posisi model di peta kompetisi hari ini.
Studi Manusia dan Dipakai di Dunia Nyata, Gimana Hasilnya?
Selain evaluasi otomatis, Ai2 juga bikin studi manusia kecil: 14 pertanyaan dari tiga peneliti sains, masing-masing kasih 4-5 pertanyaan, lalu ngurutin laporan dari tiga sistem (AstaBrief, pipeline Claude, DR Tulu) berdasarkan preferensi keseluruhan, kelengkapan, relevansi, organisasi, dan akurasi sitasi.
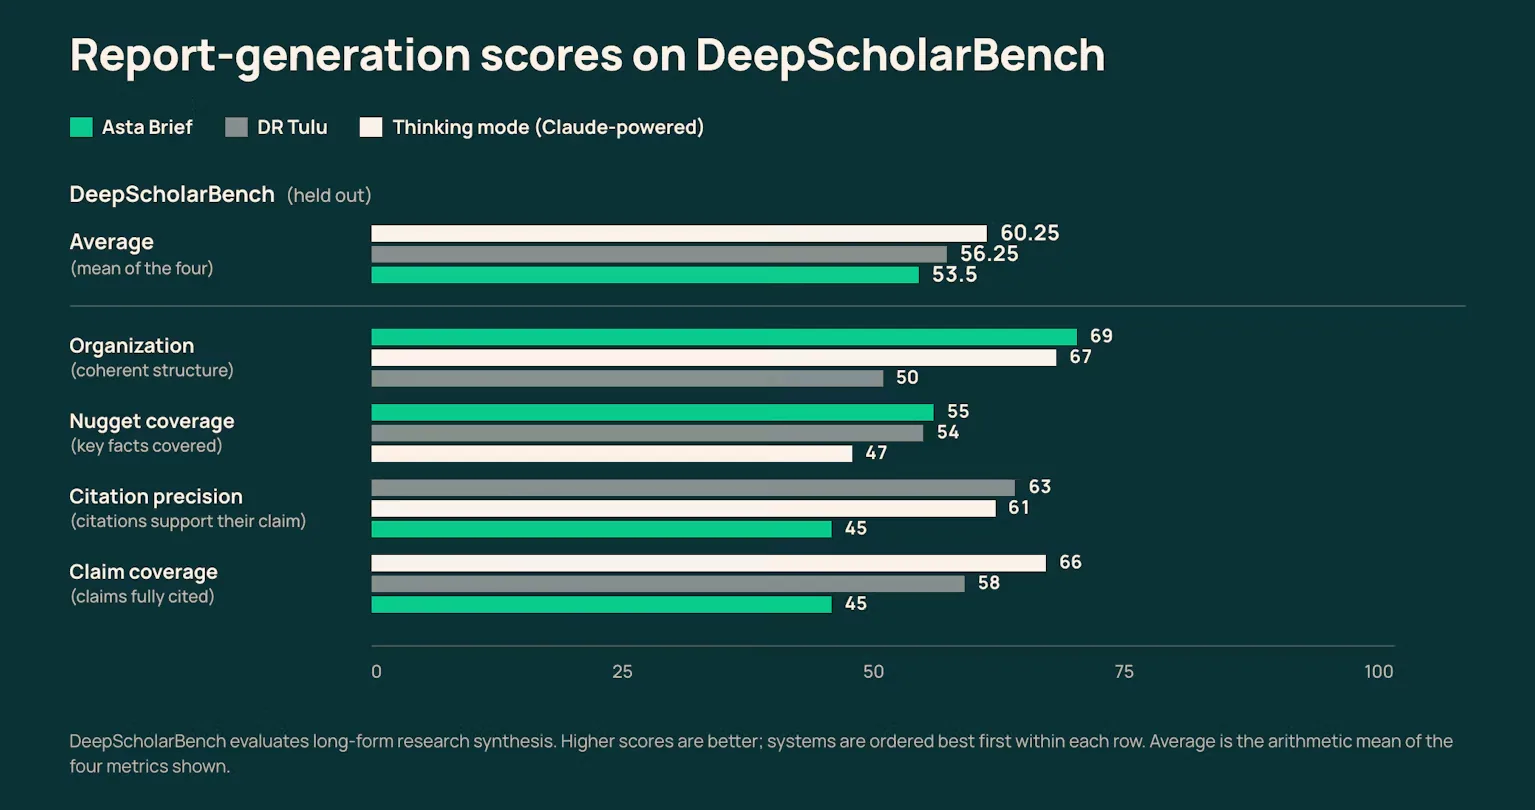
Soal preferensi keseluruhan, DR Tulu yang menang. Tapi dua dari tiga peneliti justru lebih suka AstaBrief soal akurasi sitasi - bukti kalau filter kualitas data yang dibahas sebelumnya beneran kerasa hasilnya.
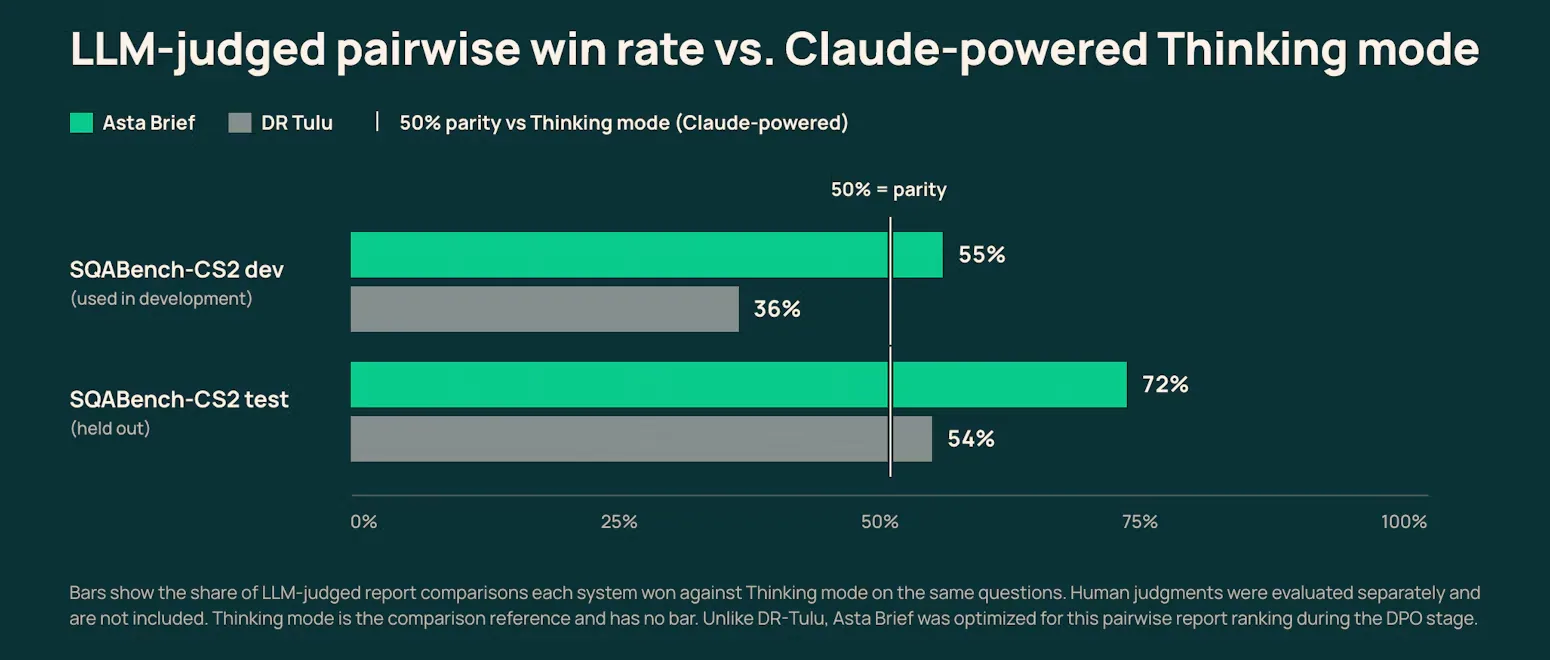
Di pemakaian nyata, Ai2 nyatat dari 374 pengguna Asta yang nyobain Fast mode: 29,1% pakai dua hari atau lebih, dengan rata-rata 3,67 thread laporan per orang. Yang menarik, 23% pengguna yang nyobain Fast mode nggak pernah balik lagi ke Thinking mode buat thread berikutnya, sementara 18% lagi gantian pakai keduanya tergantung kebutuhan (sekitar 40% thread mereka pakai Fast mode). Tingkat feedback positif pun mirip: 84,2% untuk Fast mode vs 85,2% untuk Thinking mode.
Cara Nyobain AstaBrief
Kalau kamu developer atau peneliti yang pengin ngulik langsung, ini langkah praktisnya:
- Download bobot model dan data latihan AstaBrief dari Hugging Face - semuanya open weight, jadi bisa dipasang di server sendiri.
- Pakai contoh workflow dari Ai2 di GitHub buat bikin laporan dari file PDF kamu sendiri - ini jadi titik awal yang udah disiapin buat local report generation.
- Kalau cuma mau nyobain tanpa setup teknis, langsung aja pilih Fast mode di fitur Generate a Report di platform Asta.
- Buat yang mau validasi sendiri, Ai2 juga buka SQABench-CS2 dan referensi DeepScholarBench buat ngetes model riset lain pakai metrik yang sama.
Kalau kamu lagi belajar dasar-dasar kerja sama model AI lewat API, artikel Apa itu API AI? Panduan Lengkap untuk Pemula bisa jadi bekal awal sebelum ngulik pipeline kayak AstaBrief ini.
Dampak Buat Developer dan Peneliti di Indonesia
Buat tim riset atau kampus di Indonesia, yang paling kerasa dari rilisan ini adalah soal kendali data. Karena AstaBrief open weight, institusi bisa jalanin model di infrastruktur sendiri - termasuk di belakang firewall - tanpa perlu kirim pertanyaan riset sensitif ke API pihak ketiga. Ini relevan banget kalau riset kamu nyangkut data yang belum dipublikasiin atau punya aturan privasi ketat kayak di konteks UU PDP.
Buat developer yang pengin bikin pipeline mirip - misalnya asisten riset internal atau tool ringkasan dokumen - pelajaran soal filter data dari AstaBrief ini berguna banget: fokus ke kepadatan sitasi atau sumber referensi, jangan cuma nambah data mentah sebanyak-banyaknya. Kalau kamu mau eksperimen bikin sistem serupa pakai API model lain, kamu bisa cobain lewat Classai Router - misalnya DeepSeek V4 Pro (Rp2.000 / Rp4.000 per 1 juta token) buat sintesis dokumen panjang, atau Claude Sonnet 5.5 (Rp6.400 / Rp32.100 per 1 juta token) kalau butuh kualitas penalaran lebih tinggi buat tugas grounding jawaban ke sumber.
Buat yang pengin belajar lebih jauh soal bangun aplikasi AI dari sisi developer, kelas AI untuk Developer bisa jadi tempat yang pas buat ngasah skill ini secara lebih terstruktur.
Contoh prompt kalau kamu mau nyoba bikin pipeline serupa pakai model lewat API:
Kamu adalah asisten riset. Berdasarkan potongan literatur berikut, tulis laporan ringkas yang jawab pertanyaan ini: [tulis pertanyaan risetmu]. Aturan:1. Setiap klaim harus disertai sitasi ke sumber yang relevan.2. Jangan membuat generalisasi yang lebih luas dari apa yang disebutkan di sumber.3. Strukturkan jawaban dalam bagian: Ringkasan, Temuan Utama, Keterbatasan. Potongan literatur:[tempel kutipan/snippet di sini]
Batasan dan Rencana Lanjutan AstaBrief
Ai2 sendiri jujur soal keterbatasan risetnya. Evaluasi yang mereka tulis kebanyakan dilakuin tahun 2025, dan belum diulang lawan model frontier hari ini - jadi angka benchmark di atas sebaiknya dibaca sebagai bukti soal pilihan desain training, bukan klaim posisi AstaBrief di peta kompetisi model AI terbaru.
Ke depannya, tim Ai2 lagi eksplorasi preference learning yang lebih detail, pendekatan RAG-plus-RL, kemampuan multi-turn dan multi-tool, sumber data ilmiah tambahan, serta evaluasi yang bisa ngecek apakah model tetap mempertahankan ruang lingkup bukti dari sumbernya - bukan cuma soal ada sitasi atau nggak. AstaBrief jadi satu titik dalam rangkaian riset Ai2 soal model bahasa buat sains, dari ScholarQA, DR Tulu, sampai Olmo yang lagi dikembangin.
Ai2 malah baru aja ngerilis riset terkait lainnya sehari sebelum AstaBrief, yaitu Olmo-core 3 - infrastruktur training terbuka yang dirancang buat ngelatih model MoE (mixture-of-experts) besar secara skalabel. Ini nunjukin kalau AstaBrief bukan proyek yang berdiri sendiri, tapi bagian dari rangkaian riset AI terbuka yang lebih besar di Ai2 buat sains.
Sumber & referensi
- 01
Hugging Face · 2 Oktober 2026
Open-sourcing AstaBrief, the fast report-generation model in Asta
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu AstaBrief?
AstaBrief adalah model AI open source bikinan Ai2 yang khusus dipakai buat nyusun laporan riset ilmiah lengkap dengan sitasi. Modelnya cuma 8 miliar parameter, dibangun dari Qwen3-8B, dan sekarang jadi mode Fast di platform riset Asta milik Ai2.
AstaBrief dilatih dari data apa?
Model ini dilatih dari 90 ribu query riset asli pengguna Asta, lalu disaring jadi 47 ribu contoh buat supervised fine-tuning. Selain itu ada 6 ribu pasangan data buat tahap DPO yang dinilai dua model juri, GPT-4.1 dan DeepSeek-R1, dengan tingkat kesepakatan 95% ke penilaian manusia.
Fast mode vs Thinking mode di Asta, apa bedanya?
Fast mode pakai AstaBrief yang open source dan rata-rata cuma butuh 51,1 detik per laporan, sedangkan Thinking mode pakai Claude dan butuh 178,5 detik. Soal kualitas, AstaBrief kompetitif, malah dua dari tiga peneliti di studi manusia lebih milih AstaBrief soal akurasi sitasi.
Bisa download dan pakai AstaBrief sendiri nggak?
Bisa. Ai2 ngerilis bobot model plus data latihannya di Hugging Face, dan mereka juga nyediain contoh workflow di GitHub buat bikin laporan dari PDF sendiri. Karena open weight, institusi bisa jalanin model ini di server sendiri tanpa kirim data ke API pihak ketiga.
Apakah AstaBrief mendukung bahasa Indonesia?
Sumbernya nggak nyebut dukungan bahasa Indonesia secara spesifik - datanya malah disaring khusus buat nyingkirin query non-Inggris. Jadi kemungkinan besar performanya paling bagus buat teks riset berbahasa Inggris dulu.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.