NVIDIA Nemotron 3.5 Rilis: Fondasi Baru Retrieval AI Agent
NVIDIA baru aja ngerilis seri Nemotron 3.5 yang fokus ke retrieval agent: Embed, Rerank, dan Parse. Bikin AI agent makin akurat dan hemat token!
· 10 menit baca
Inti singkat
- NVIDIA ngerilis seri model terbuka Nemotron 3.5 yang mencakup Embed, Rerank, dan Parse untuk efisiensi sistem AI agent.
- Nemotron 3.5 Embed 8B meraih posisi puncak di benchmark ViDoRe v3.1 untuk dense retrieval teks dan visual.
- Pemasangan Nemotron 3.5 Rerank sanggup memangkas biaya token inferensi agent hingga 14% dengan akurasi pencarian yang lebih baik.
- Nemotron 3.5 Parse memimpin ParseBench untuk model sub-1B parameter dengan kecepatan hingga 16,1 halaman per detik di GPU H100.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
NVIDIA resmi ngerilis keluarga model NVIDIA Nemotron 3.5 yang mencakup Embed, Rerank, dan Parse untuk menyempurnakan alur kerja AI agent. Rangkaian model retrieval multimodal berlisensi komersial ini dirancang biar sistem AI bisa nemuin bukti relevan dari dokumen teks maupun gambar secara akurat tanpa buang-buang token inferensi.
Kabar gembira ini diumumkan langsung lewat pengumuman resmi NVIDIA di Hugging Face. Selama ini, masalah paling bikin pusing saat bikin agentic workflow atau sistem RAG (Retrieval-Augmented Generation) adalah borosnya biaya token saat agent mencari data. Kalau dokumen yang diambil nggak lengkap atau salah sasaran, agent bakal muter-muter nanya berulang kali. Lewat pembaruan ini, NVIDIA ngasih jawaban komprehensif mulai dari tahap ekstraksi dokumen PDF, pencarian vektor multimodal, sampai pengurutan ulang konteks.
Kalau kamu lagi ngebangun aplikasi agentic AI atau pengin naikin performa pencarian dokumen perusahaan, yuk kita bedah tuntas apa aja yang dibawa oleh seri Nemotron 3.5 ini!
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa AI Agent Sering Boros Token dan Muter-Muter?
Kualitas jawaban agent itu bergantung banget sama bukti yang berhasil ditarik dari database. Bayangin kamu minta agent buat ngecek produk mana yang berisiko kehabisan stok kuartal depan beserta alasannya. Agent harus ngebaca grafik tren permintaan di chart, tabel sisa barang di inventaris, dan laporan pengiriman supplier, lalu nalarin semuanya barengan.
Kalau sistem retrieval cuma ngasih potongan teks yang meleset, agent bakal manggil tool pencarian berkali-kali. Setiap putaran pencarian itu makan token input dan output yang lumayan banyak. Nah, NVIDIA nguji performa Nemotron 3.5 Embed dan Rerank di berbagai pengujian kayak ViDoRe v3 (gabungan teks dan gambar), BRIGHT, dan BrowseComp-Plus buat ngukur seberapa jauh retrieval yang bagus bisa nekan konsumsi token.
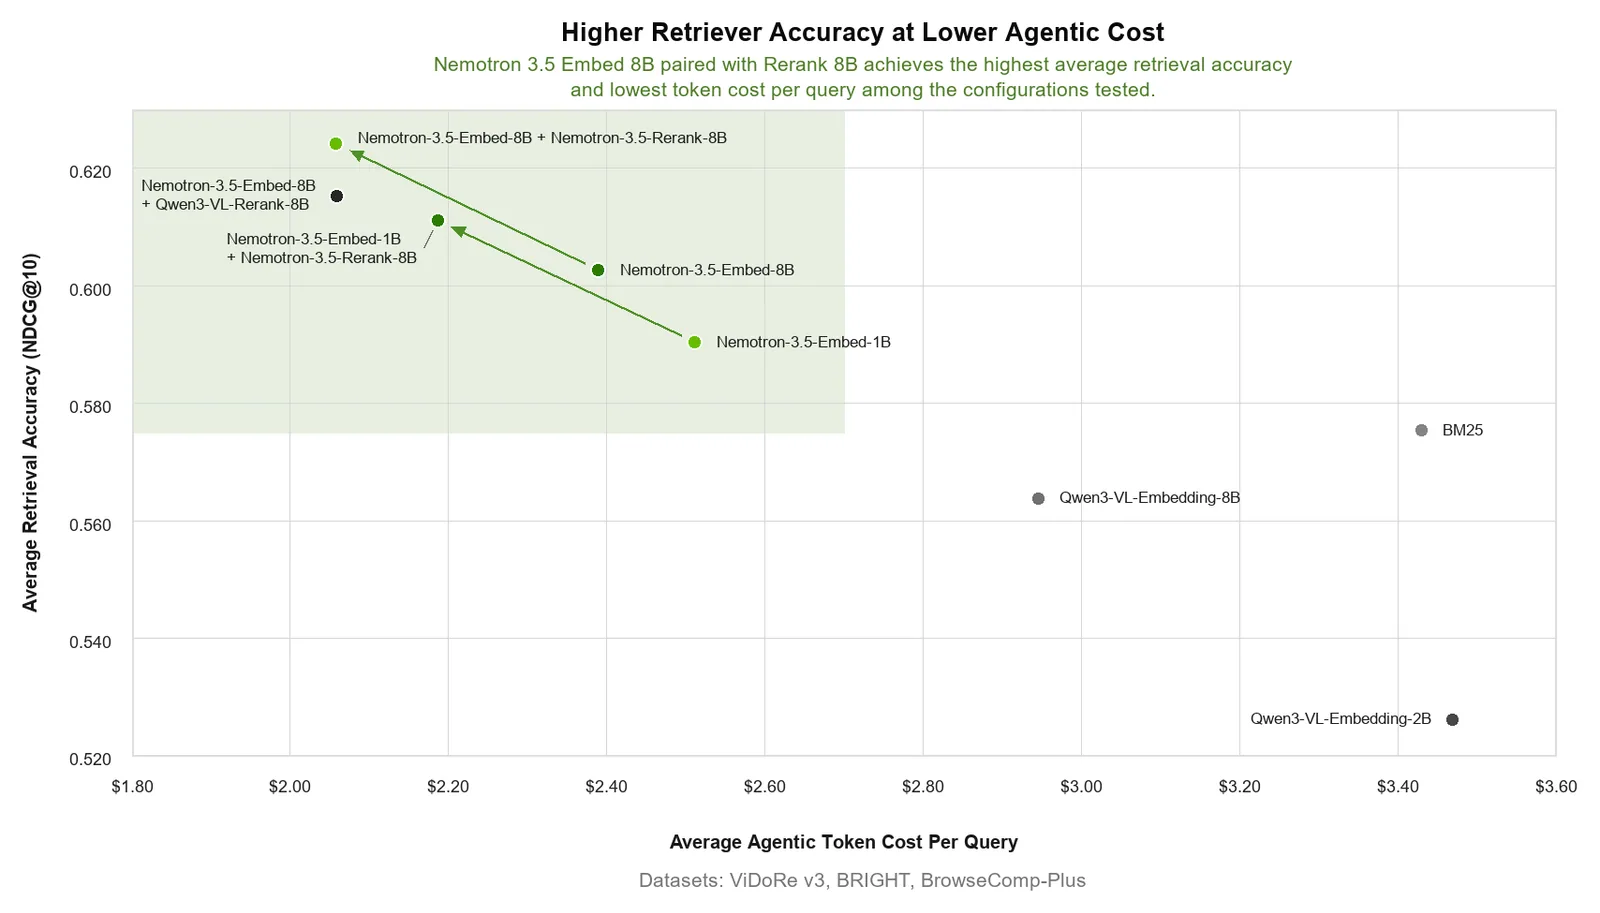
Hasilnya kelihatan jelas banget. Dengan nambahin Nemotron 3.5 Rerank, biaya token per query agent terpangkas sekitar 14% saat dipadukan dengan Nemotron 3.5 Embed 8B, dan hemat 13% bareng Embed 1B. Akurasinya pun ikutan naik, bahkan ngalahin Qwen3-VL-Reranker-8B sekitar 0,9 poin nDCG@10 pada batas biaya token yang sama.
Mengenal Keluarga NVIDIA Nemotron 3.5: Parse, Embed, dan Rerank
NVIDIA nggak cuma ngerilis satu model raksasa yang berat, tapi ngebagi tugas ke beberapa varian model terbuka yang siap dipakai produksi. Ada tiga pilar utama yang disediakan buat kebutuhan retrieval modern:
| Nama Model | Peran Utama | Fokus Penggunaan |
|---|---|---|
| Nemotron-3.5-Embed-8B-BF16 | Mengambil data teks dan gambar dengan dukungan multibahasa kuat | Pencarian dokumen berbobot visual tinggi dengan kualitas maksimal |
| Nemotron-3.5-Embed-1B-BF16 | Versi distilasi dari 8B dengan ukuran memori jauh lebih ringkas | Pengindeksan multimodal hemat resource dan serving cepat |
| Nemotron-3.5-Embed-1B-NVFP4 | Model 1B berkuantisasi NVFP4 pada enkoder teks dan gambar | Skala throughput tinggi di hardware yang mendukung kuantisasi |
| Nemotron-3.5-Rerank-8B-BF16 | Evaluasi pasangan query-dokumen buat urutan relevansi terbaik | Menyaring kandidat bukti terbaik buat RAG dan context agent |
| Nemotron-3.5-Parse (631M) | Ekstraksi visual PDF/dokumen jadi teks terstruktur | Mengubah tabel, grafik, dan layout dokumen jadi Markdown/HTML |
Menariknya, komponen teks pada model Embed tetap mempertahankan bobot dasar Nemotron 3 Embed sebelumnya karena bagian bahasa dibekukan saat pelatihan. Jadi kalau kamu udah punya indeks vektor teks lama, kamu nggak perlu re-indexing dari nol buat data teksnya.
Nemotron 3.5 Embed: Jagoan Multimodal Teks dan Gambar
Kelemahan klasik pencarian vektor biasa adalah ketidakmampuannya memahami isi bagan, alur skematik, atau infografis. Nemotron 3.5 Embed ngebangun kemampuan barunya di atas arsitektur Ministral-3-8B-Instruct dengan teknik contrastive learning pada korpus teks dan visual.
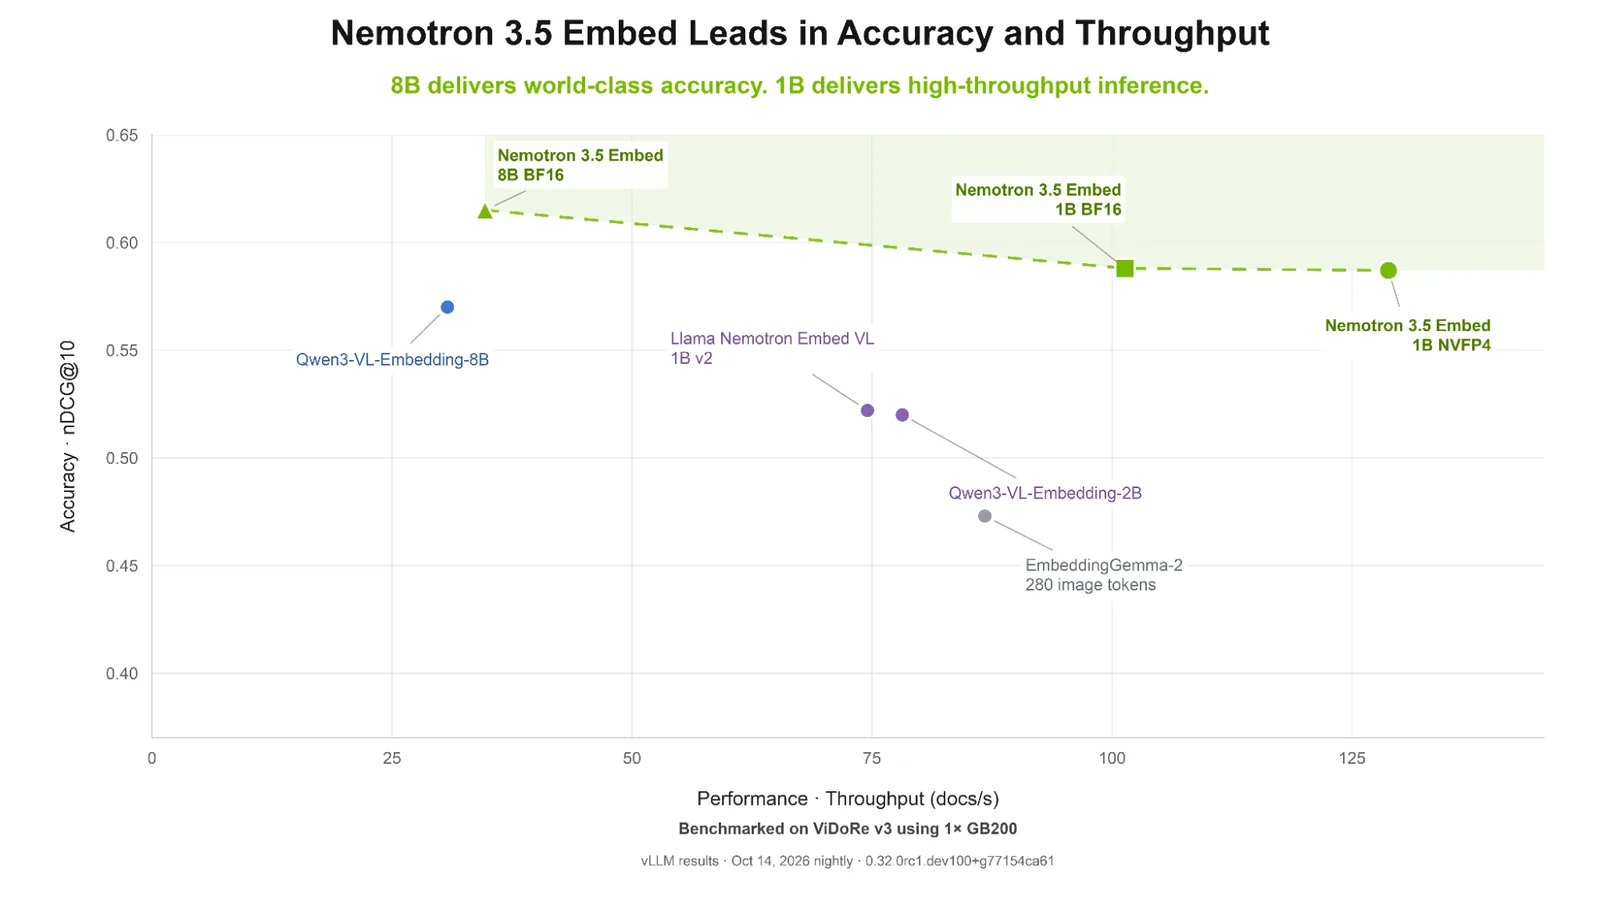
Di leaderboard ViDoRe v3.1, Nemotron 3.5 Embed 8B BF16 duduk di peringkat pertama untuk kategori dense retrieval dengan skor 61,17 nDCG@10. Skor ini melonjak 8,94 poin dibanding model generasi sebelumnya, Llama Nemotron Embed VL 1B yang meraih 52,23.
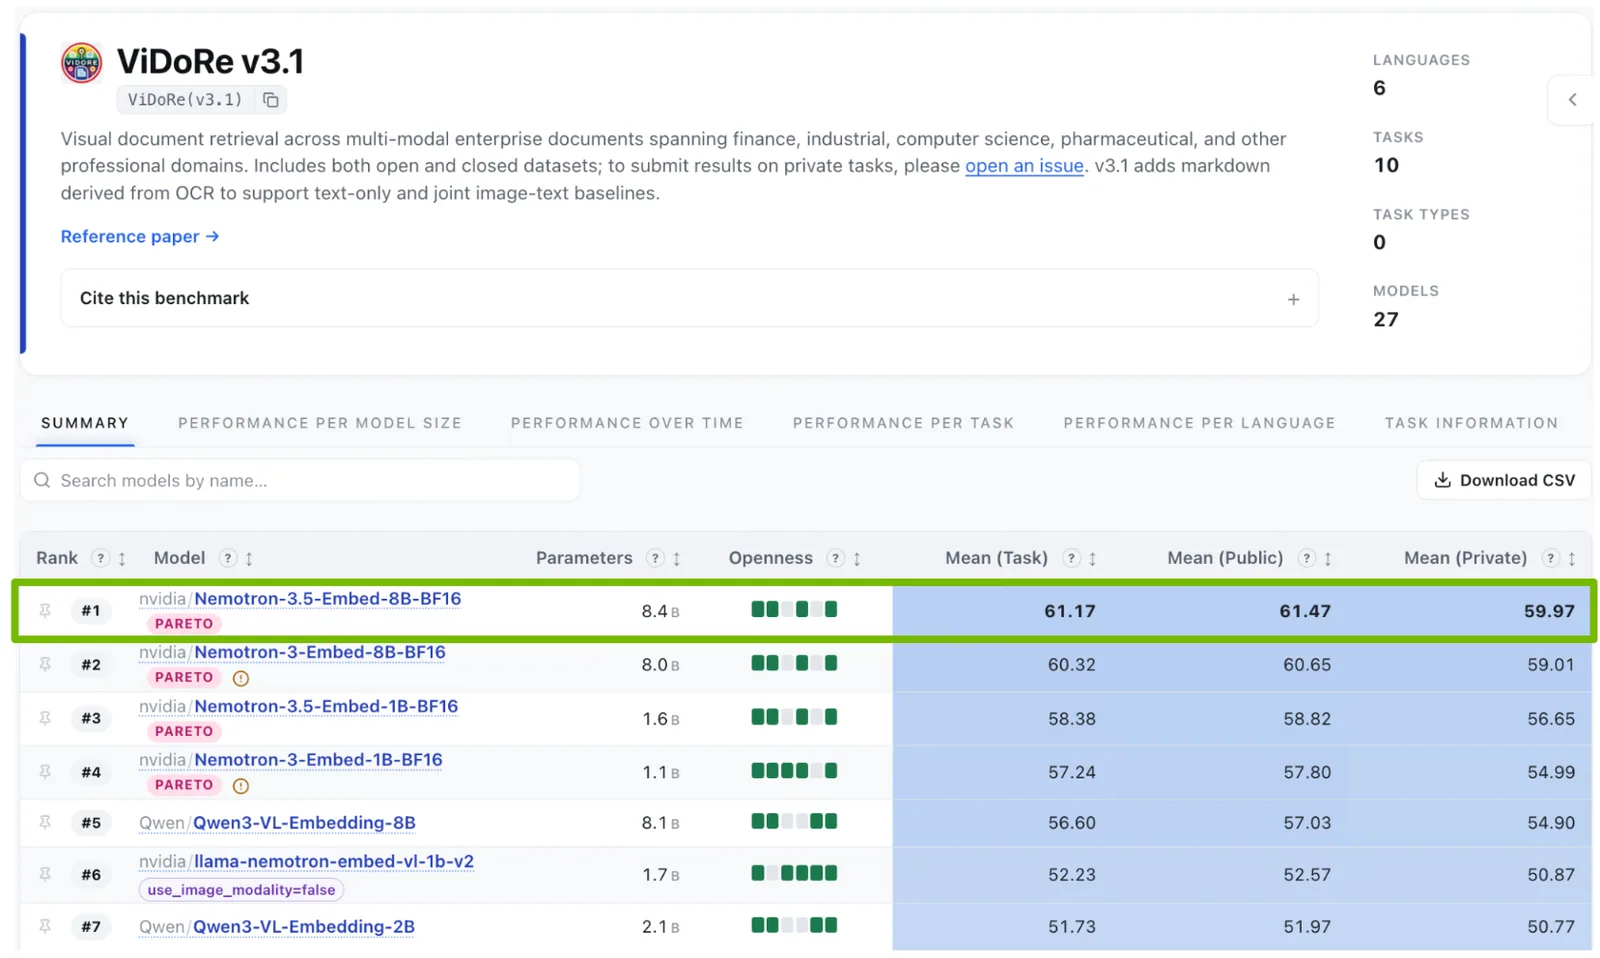
Buat yang punya keterbatasan resource infrastruktur, varian 1B BF16 hasil distilasi juga sangat bertenaga. Model mini ini mencetak skor 58,38 nDCG@10, alias masih mempertahankan 95,4% kemampuan model gurunya yang berukuran 8B berkat kombinasi kerugian cosine dan mean squared error (MSE).
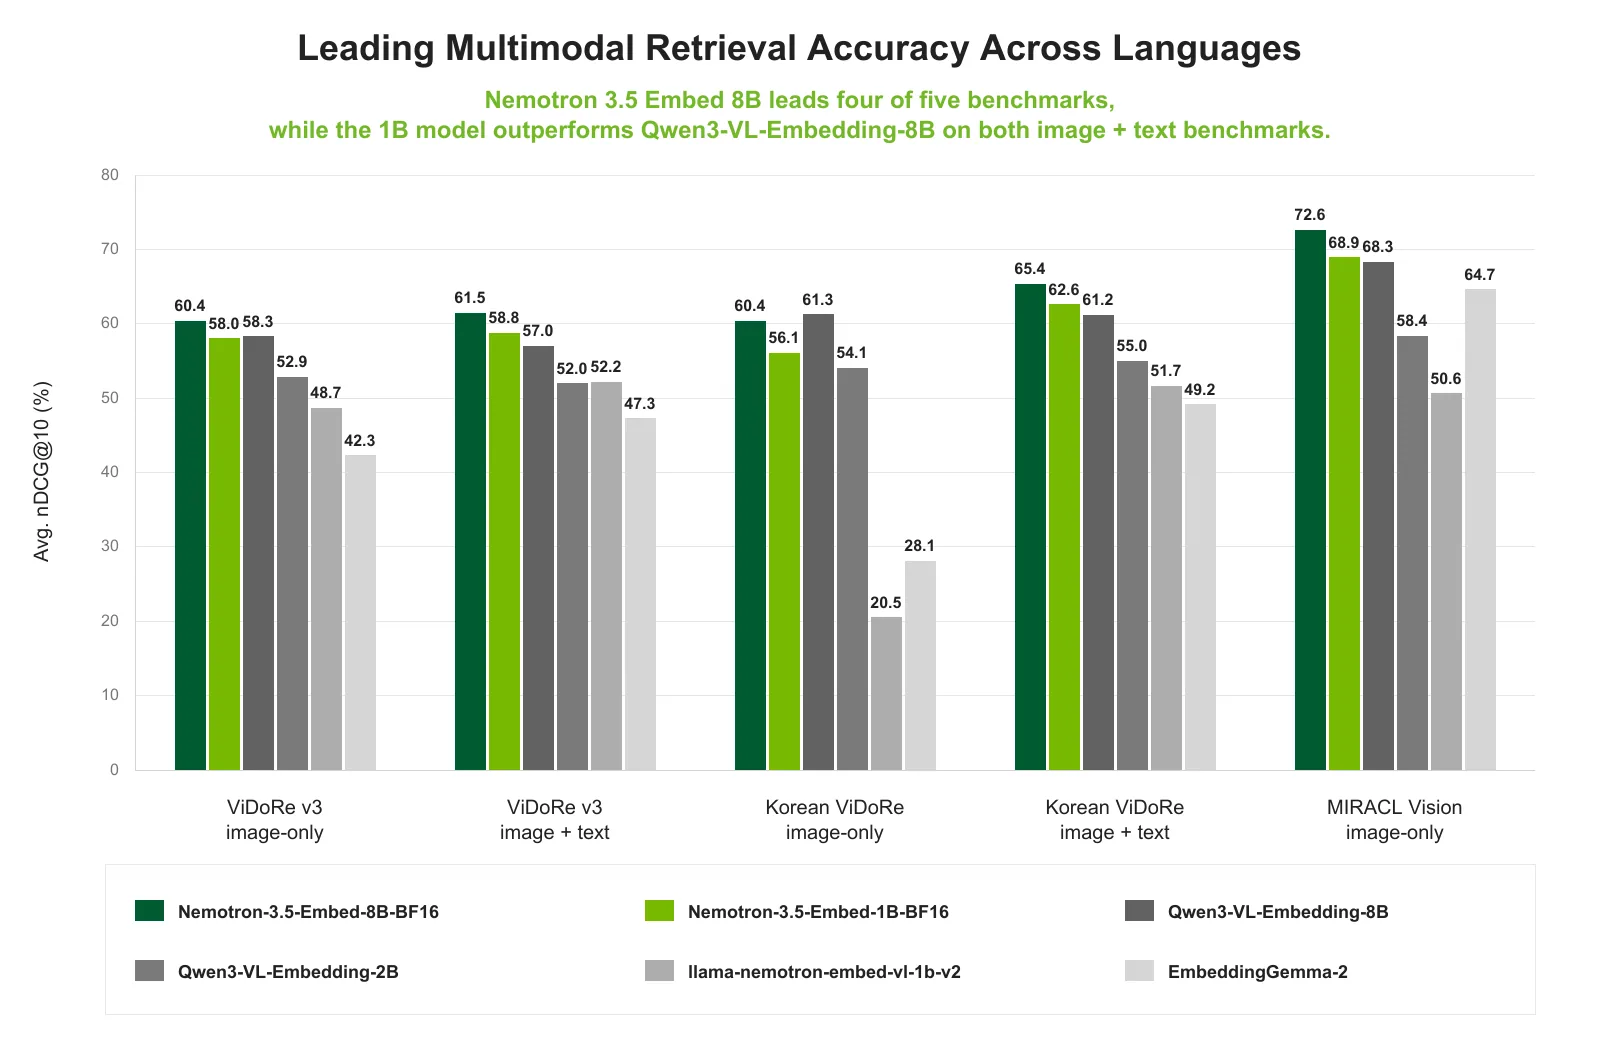
Di pengujian multibahasa MIRACL Vision yang mencakup 18 bahasa, varian 8B tembus skor 72,6 nDCG@10, unggul 4,3 poin di atas Qwen3-VL-Embedding-8B. Pada pengujian KoViDoRe untuk bahasa Korea, model Embed 8B dan 1B juga melampaui baseline Qwen saat mengolah input kombinasi gambar dan teks. Secara keseluruhan, pengujian teks murninya sendiri mencakup hingga 34 bahasa.
Nemotron 3.5 Rerank: Saring Bukti Paling Relevan Buat Agent
Model embedding bertugas ngumpulin kandidat dokumen yang mirip dari database vektor. Tapi, apakah dokumen yang mirip secara semantik itu bener-bener ngejawab inti pertanyaan? Belum tentu. Di sinilah peran Nemotron 3.5 Rerank 8B BF16 sebagai cross-encoder.
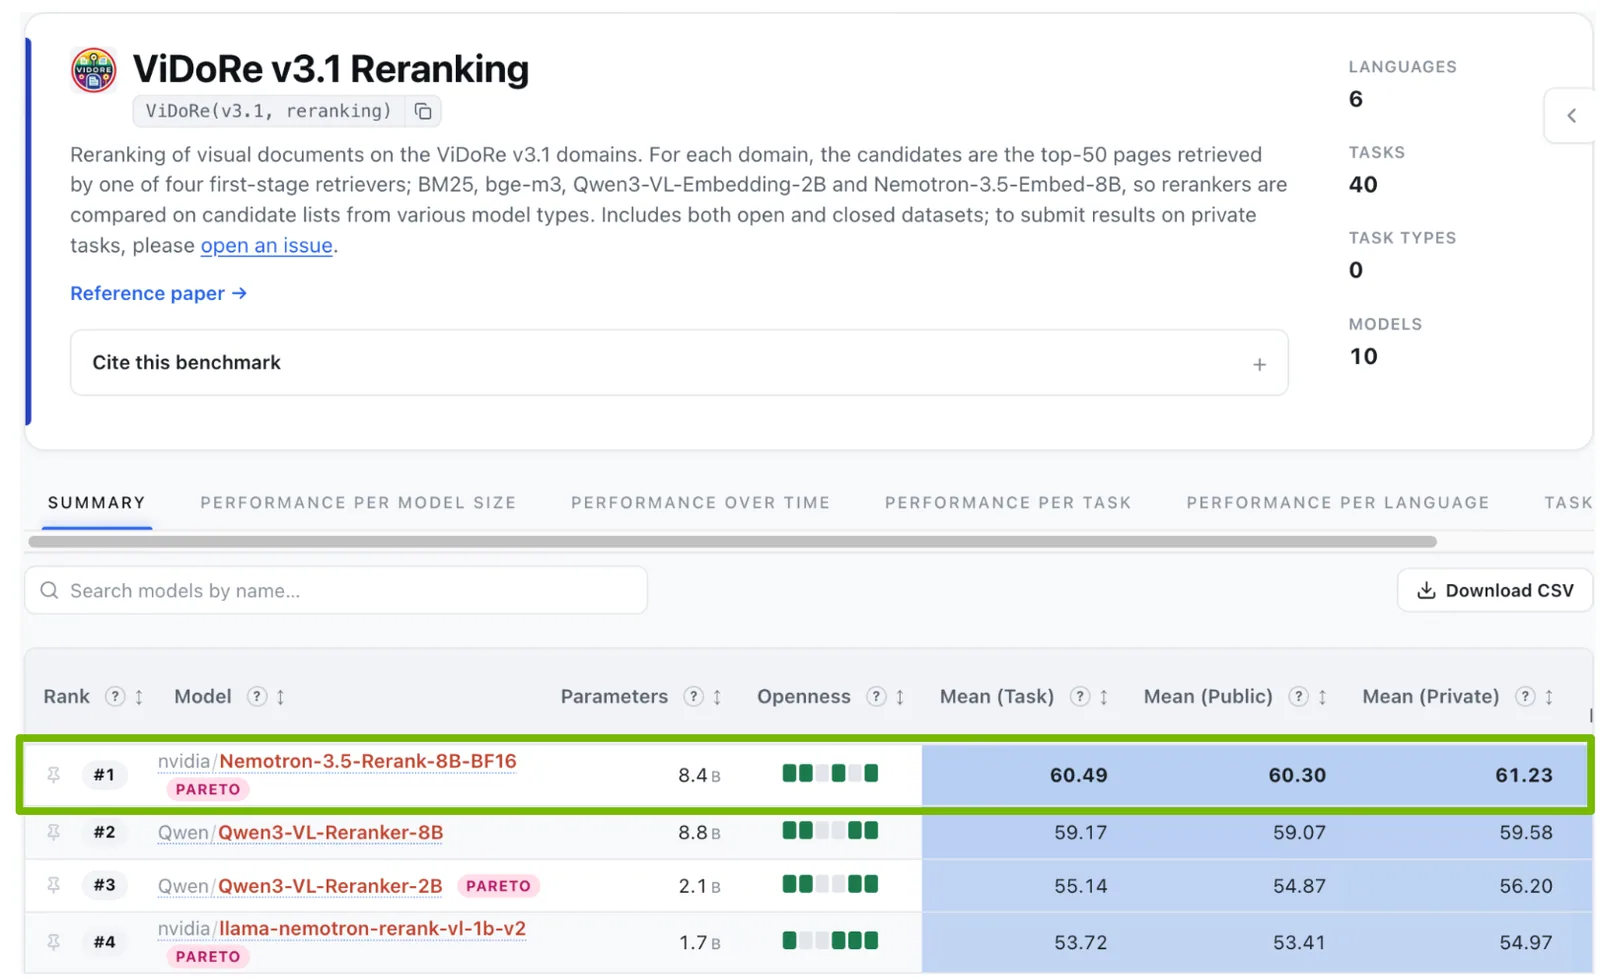
Model reranker ini mengevaluasi pasangan query dan dokumen secara bersamaan menggunakan kepala skoring multilayer perceptron (MLP) untuk menghasilkan nilai relevansi skalar. Pada benchmark reranking ViDoRe v3.1 yang baru diluncurkan bersama tim MTEB, Nemotron 3.5 Rerank 8B meraih nilai 60,49 nDCG@10 pada input gabungan gambar dan teks, melampaui Qwen-3-VL-Reranker-8B yang dapet 59,17.
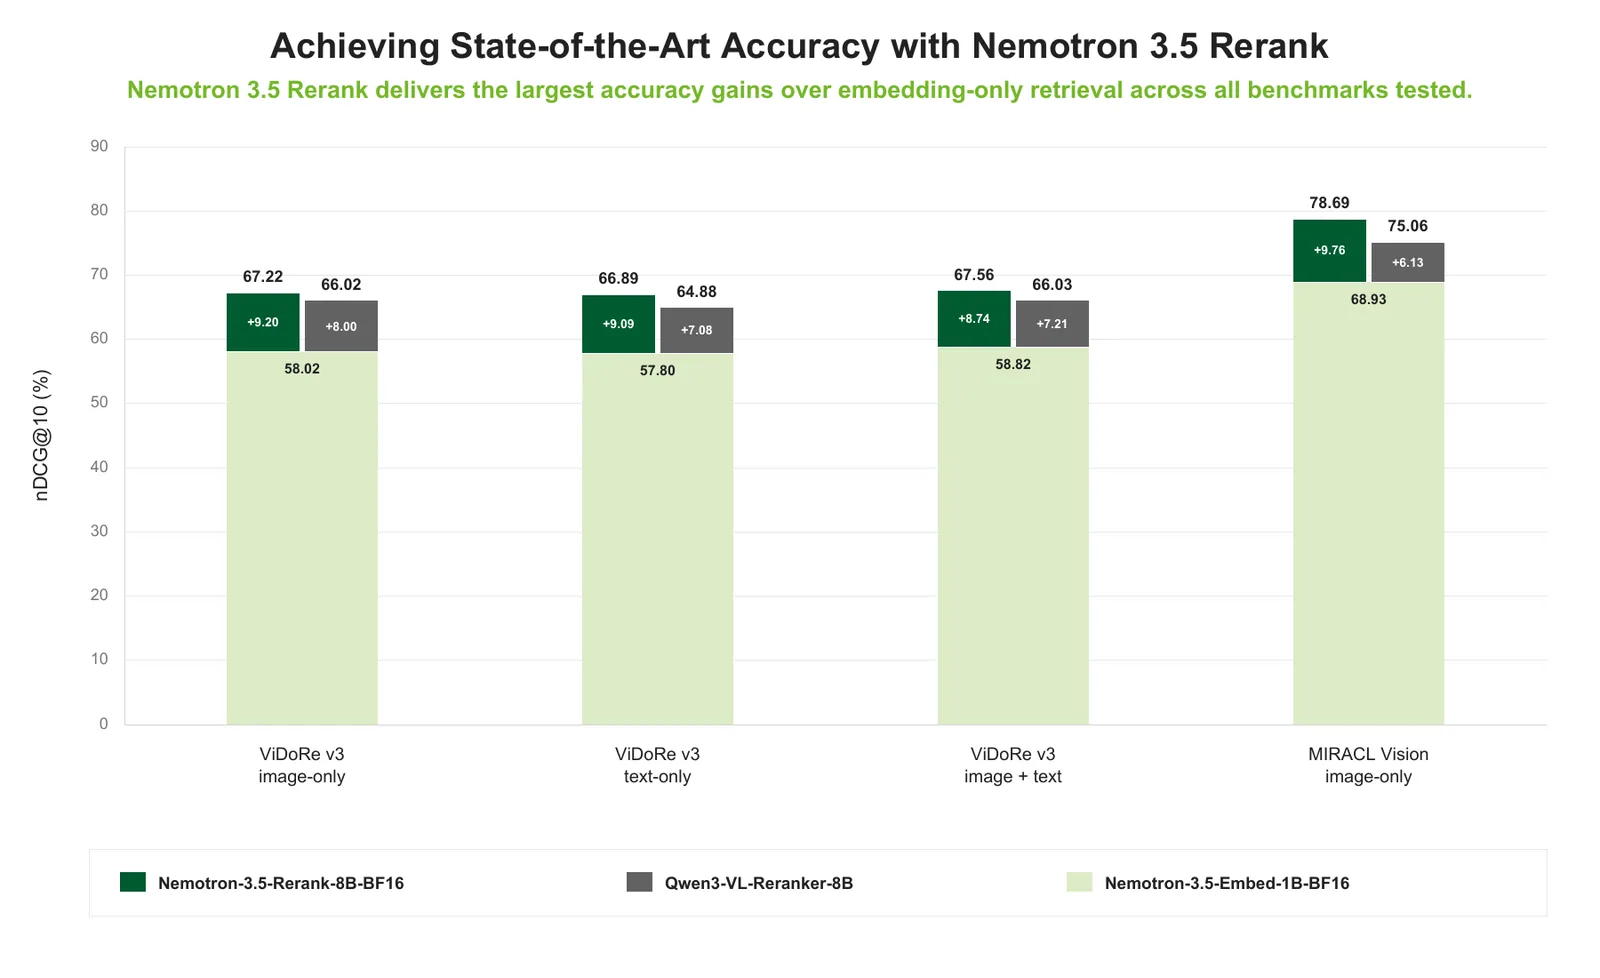
Dengan membuang dokumen yang kurang relevan sebelum masuk ke context window LLM utama, agent kamu nggak bakal bingung kena distraksi konteks. Mirip kayak konsep pemilihan tools runtime yang pernah kita bahas di artikel /developer/aws-agent-registry-runtime-tool-discovery-ai, ketepatan pemilihan konteks dan bukti adalah kunci utama penghematan biaya inferensi.
Nemotron 3.5 Parse: Bikin PDF dan Dokumen Rumit Jadi Terstruktur
Sebelum data bisa di-embed atau di-rerank, masalah terbesarnya sering kali ada di dokumen mentah: PDF hasil scan, laporan keuangan berantakan, atau tabel tanpa garis batas. Nemotron 3.5 Parse hadir dengan ukuran mungil 631 juta parameter khusus buat ngeberesin urusan ini.
Model ini mengonversi gambar dokumen jadi teks terbaca mesin dalam format Markdown atau tabel HTML sembari mempertahankan tata letak, koordinat visual, dan urutan baca aslinya.
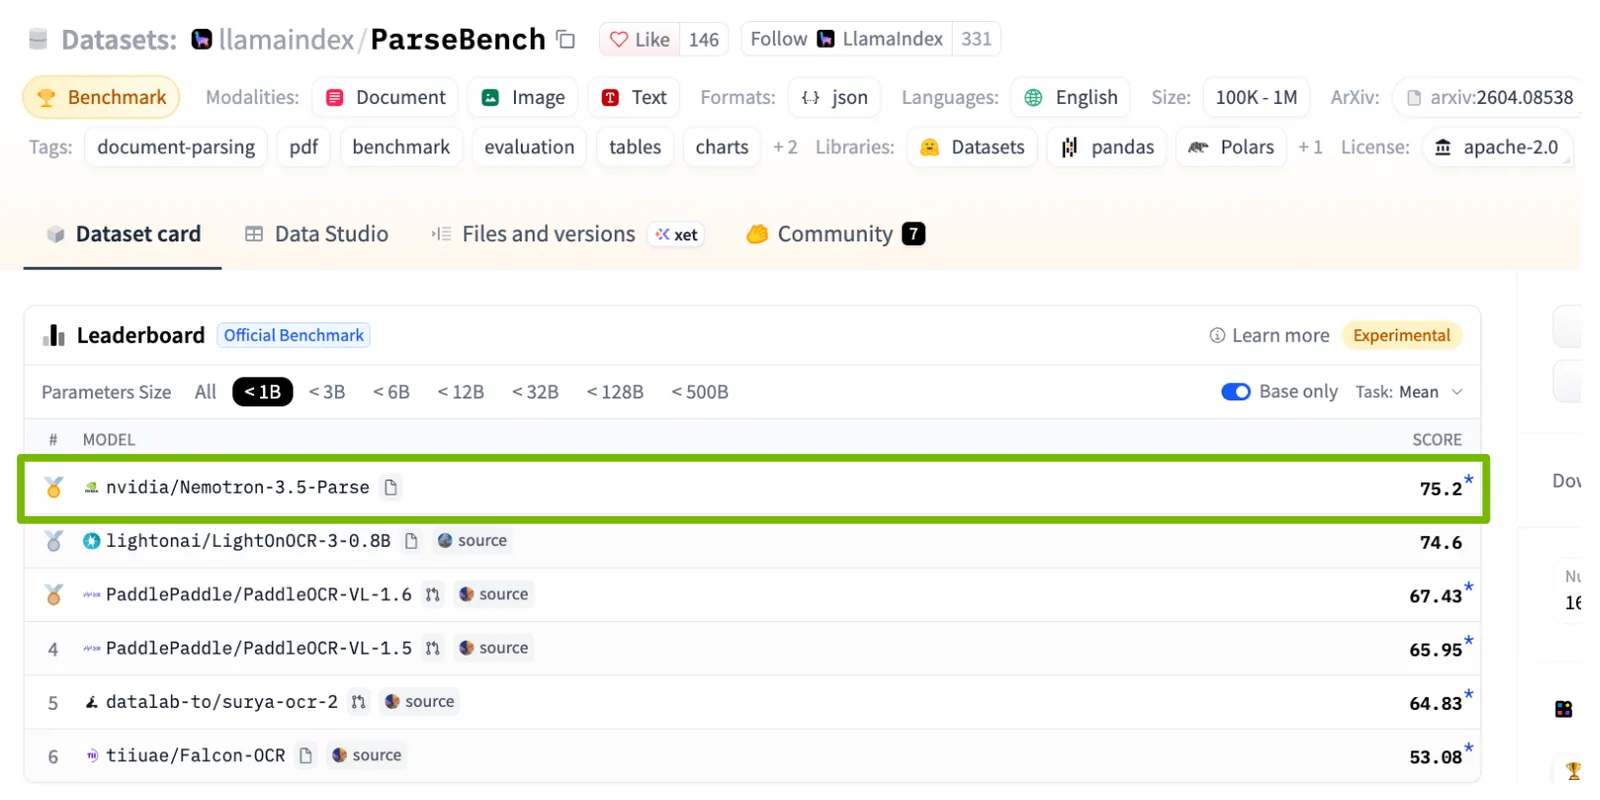
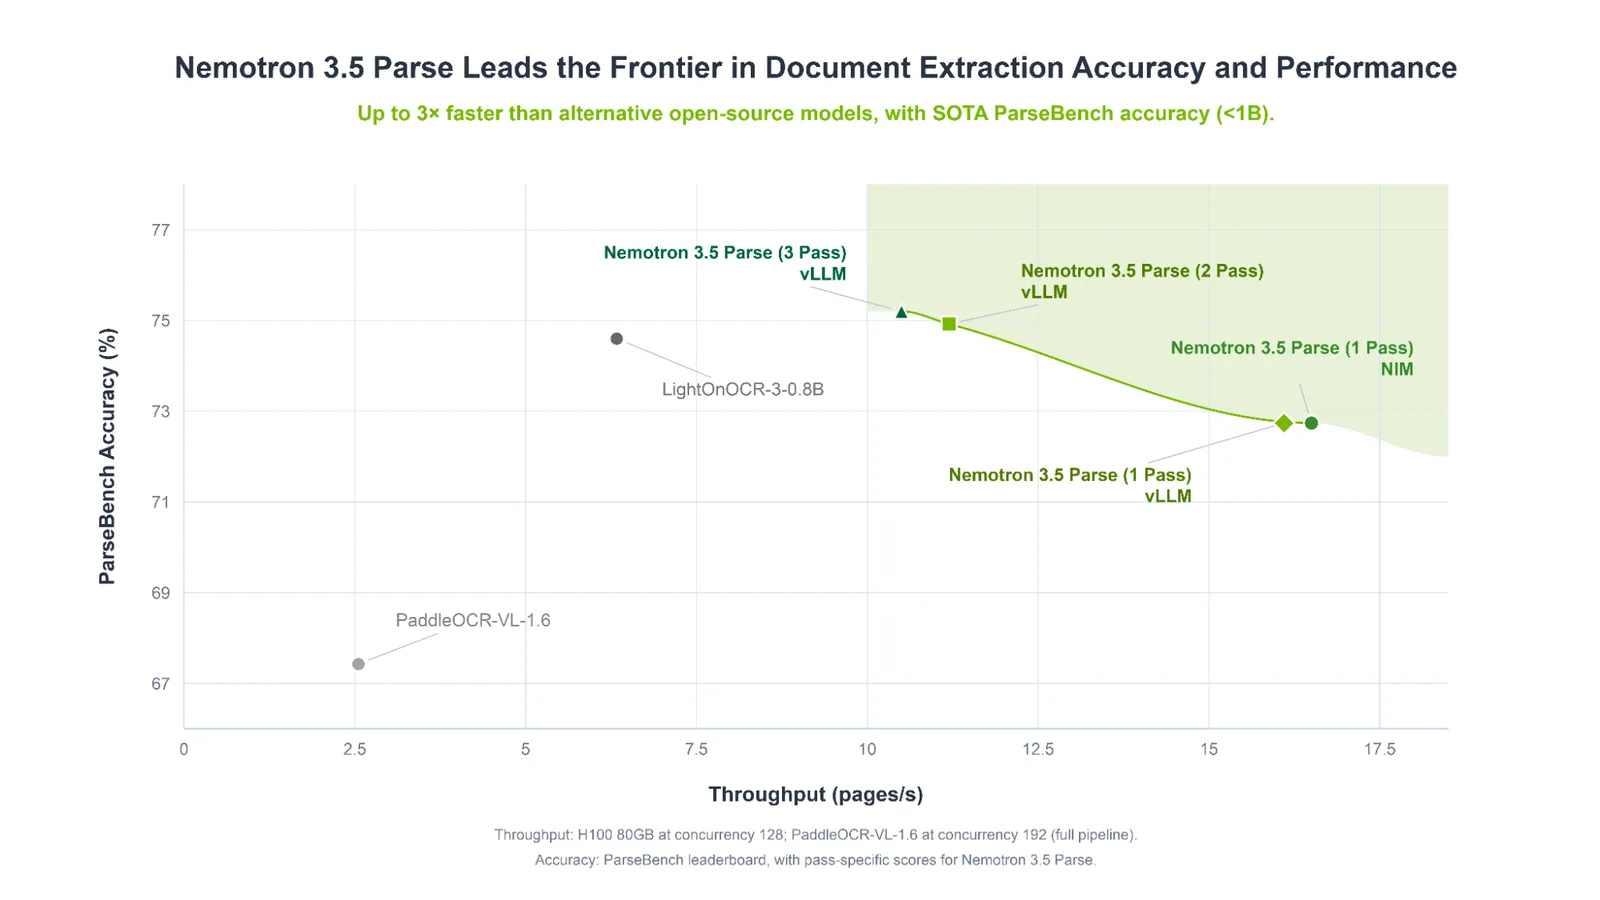
Di benchmark ParseBench, Nemotron 3.5 Parse berhasil jadi nomor satu untuk kategori model sub-1B parameter dengan skor 75,20 sembari memproses 10,5 halaman per detik pada satu GPU NVIDIA H100. Developer juga bisa memilih mode inferensi sesuai kebutuhan:
| Mode Pemrosesan | Skor ParseBench | Kecepatan (Halaman/Detik di GPU H100) |
|---|---|---|
| Single pass | 72,74 | 16,1 |
| Double pass | 74,92 | 11,2 |
| Triple pass | 75,20 | 10,5 |
Mode single pass sangat cocok buat memproses tumpukan dokumen dalam jumlah besar dengan cepat. Sedangkan mode double dan triple pass bakal memotong ulang (crop) area tabel atau grafik rumit yang terdeteksi di awal biar hasil pembacaannya jauh lebih akurat.
NVIDIA ngelatih model Parse ini menggunakan data sintetis beragam serta penguatan pasca-pelatihan Group Relative Policy Optimization (GRPO) dengan reward function khusus. Pendekatan ini efektif ngilangin repetisi teks berulang dan tag yang nggak tertutup, sekaligus memperluas jangkauan OCR hingga mencakup 163 kombinasi bahasa dan aksara.
Di luar riset retrieval dokumen perkantoran ini, NVIDIA juga terus mengeksplorasi simulasi visual generatif mendalam di berbagai bidang khusus lainnya, seperti riset bedah klinis yang dipublikasikan dalam waktu berdekatan.
Kinerja di Skala Produksi: Kuantisasi NVFP4 dan Akselerasi NIM
Akurasi tinggi tentu kurang mantap kalau bikin server kewalahan saat traffic lagi padat. NVIDIA ngasih dua opsi deployment yang bikin ngiler tim engineer:
- Kuantisasi NVFP4 pada Model 1B: Saat dijalankan di chip NVIDIA GB200, varian 1B NVFP4 sanggup memproses 128,8 dokumen per detik, alias 27,1% lebih ngebut dari versi BF16 (101,3 dokumen/detik). Kerennya, akurasinya di ViDoRe v3 masih bertahan di angka 99,85% dibanding model dasarnya.
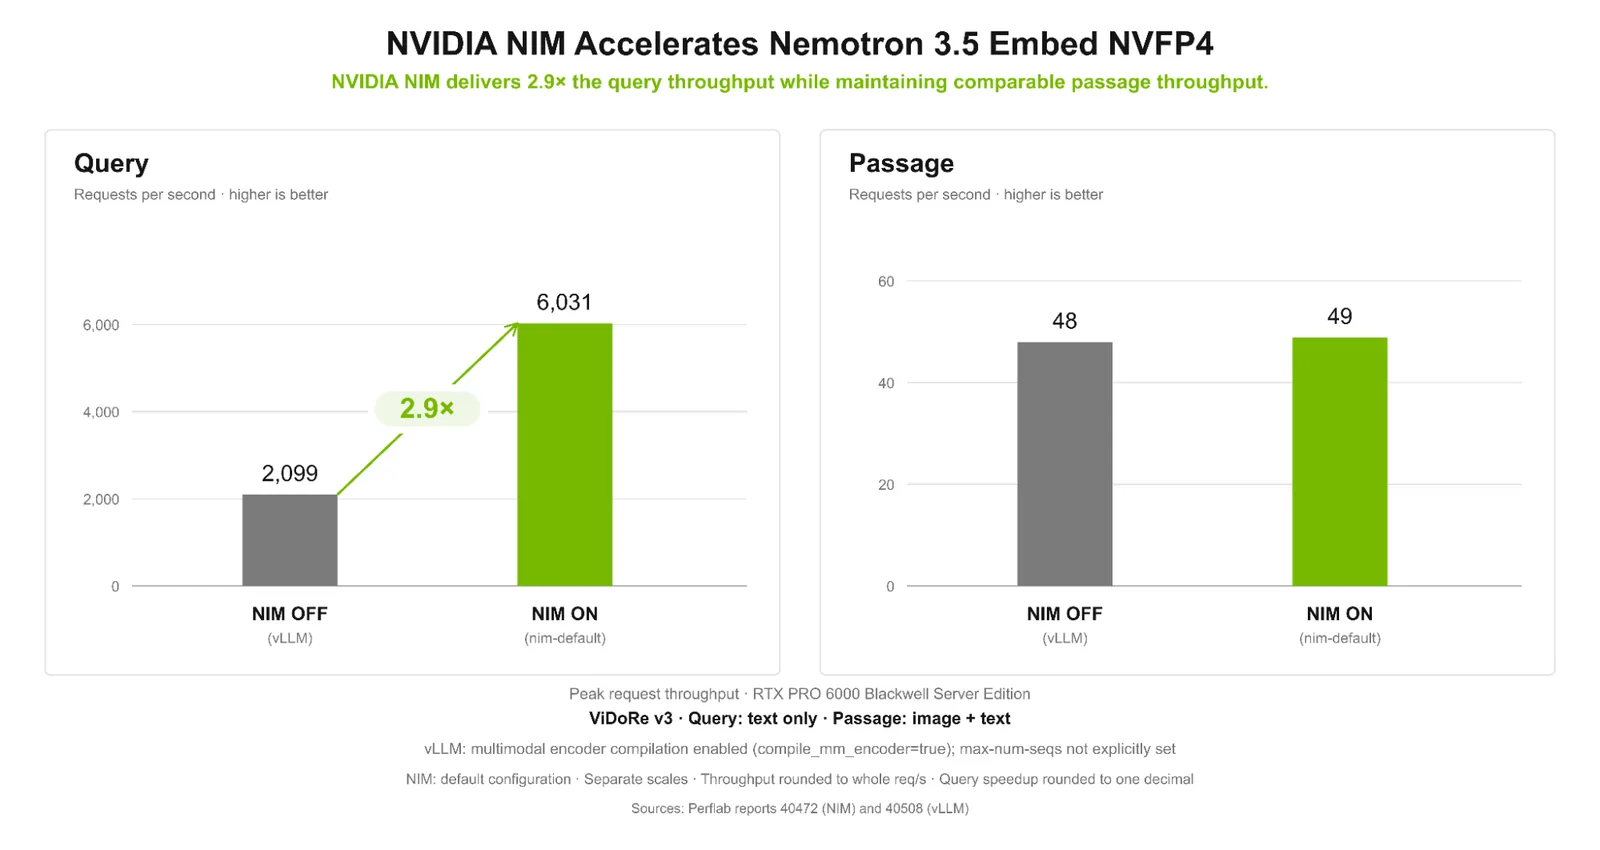
- Akselerasi NVIDIA NIM: Pengujian di GPU NVIDIA RTX PRO 6000 Blackwell Server Edition nunjukin throughput NVIDIA NIM tembus 6.031 query per detik. Angka ini sekitar 2,9 kali lipat lebih kencang dibanding setup vLLM standar yang mencatat 2.099 query per detik.
Mitra enterprise dunia udah merasakan keunggulan model ini secara langsung. Elastic mengintegrasikannya lewat Elasticsearch Inference API. Vectorize mencatat skor teratas pada benchmark memori percakapan panjang LoCoMo (93,8% recall@10) dan BEAM 100K (65,9%). Sementara Q2D-Web oleh Perplexity serta pengujian Turbopuffer pada pencarian PDF bisnis memperlihatkan hasil penemuan bukti yang lebih tajam hingga 5% dibanding baseline sebelumnya.
Cara Mencoba dan Fine-Tuning NVIDIA Nemotron 3.5
Bobot model Nemotron 3.5 sudah tersedia terbuka di Hugging Face, microservice container di NVIDIA NIM, serta mitra cloud inferensi kayak Baseten, DeepInfra, dan FriendliAI. Kalau dokumen kantormu punya istilah yang sangat spesifik, kamu bisa memanfaatkan panduan NVIDIA NeMo AutoModel.
Berikut langkah ringkas kalau kamu pengin mengintegrasikannya ke dalam proyek AI agent milikmu:
- Pilih lingkungan deployment: Unduh checkpoint dari Hugging Face untuk hosting mandiri, atau pakai endpoint NVIDIA NIM untuk kemudahan deployment skala produksi.
- Ekstraksi dokumen via Nemotron Parse: Masukkan dokumen PDF ke endpoint Parse untuk menghasilkan struktur teks Markdown dan tabel HTML yang rapi.
- Buat embedding multimodal: Generate representasi vektor dokumen pakai Nemotron 3.5 Embed (pilih 8B untuk kualitas puncak atau 1B NVFP4 untuk efisiensi tinggi).
- Pasang Reranker di pipeline RAG: Setelah database vektor mengambil 50 kandidat teratas, masukkan ke Nemotron 3.5 Rerank 8B untuk menyaringnya menjadi 5 sampai 10 bukti terbaik.
- Fine-tuning dokumen khusus (Opsional): Manfaatkan resep fine-tuning Nemotron jika akurasi pada bagan spesifik masih perlu ditingkatkan. Pada eksperimen NVIDIA memakai 8.591 query sintetis dari Qwen3.8-Flash-Next, fine-tuning model 1B selama satu epoch sanggup mendongkrak skor nDCG@10 sebesar 18% (dari 37,34 naik ke 44,12).
Kamu juga bisa ngasih prompt terstruktur ke agent kamu biar cara kerja pencariannya makin rapi dan terarah, contohnya kayak gini:
Kamu adalah agent analis inventaris. Tugasmu mencari risiko kehabisan stok barang di kuartal depan.1. Gunakan search_tool untuk mengambil data dari laporan supplier dan grafik perkiraan permintaan.2. Pastikan bukti mencakup angka sisa stok di tabel gudang dan estimasi waktu kirim (lead time).3. Evaluasi apakah jadwal pengiriman mencukupi sebelum stok habis.4. Sertakan referensi halaman dan judul tabel pada jawaban analisismu.
Apa Dampak Rilis Ini Buat Pembaca dan Developer di Indonesia?
Buat ekosistem teknologi di Indonesia, kehadiran seri model Nemotron 3.5 ini ngasih beberapa manfaat nyata:
- Digitalisasi Dokumen Lokal Makin Gampang: Banyak kantor, instansi, dan UMKM di Indonesia masih menyimpan arsip berupa pindaian PDF, nota belanja, atau formulir tabel yang berantakan. Model Parse dengan dukungan OCR luas di 163 kombinasi bahasa dan aksara bisa jadi solusi ekstraksi data otomatis tanpa ketergantungan software proprietary yang mahal.
- Kepatuhan Privasi Data Lokal (UU PDP): Berhubung bobot model Nemotron 3.5 dirilis terbuka dan berlisensi komersial, perusahaan perbankan atau startup di Indonesia bisa menginstalnya langsung di server on-premise lokal, sehingga privasi data sensitif tetap terjaga aman di dalam negeri.
- Penghematan Biaya Operasional Sistem AI: Pemangkasan konsumsi token inferensi hingga 14% bakal sangat berasa di dompet operasional jika aplikasimu melayani ratusan ribu percakapan per hari. Konteks yang ringkas dan padat juga bikin LLM lebih jarang berhalusinasi.
Ketika bukti dokumen dari sistem retrieval sudah siap, kamu tetap membutuhkan model bahasa utama yang cerdas untuk merangkai jawaban akhir. Melalui Classai Router, kamu bisa mengakses berbagai model reasoning dan komputasi cerdas seperti Nemotron 3.5 Super (cuma Rp1.500 / Rp2.000 per 1 juta token) cukup pakai satu API key standar tanpa perlu kartu kredit luar negeri.
Buat kamu yang mau memperdalam keahlian bikin arsitektur agent, integrasi API AI modern, dan automasi sistem kerja, langsung aja pelajari materi lengkapnya di Kelas AI untuk Developer. Selamat mencoba meracik pipeline RAG multimodal yang makin hemat dan akurat!
Sumber & referensi
- 01
Hugging Face · 21 Oktober 2026
NVIDIA Nemotron 3.5 Embed, Rerank, and Parse: Advancing Agents with World-Class Retrieval Models
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu NVIDIA Nemotron 3.5?
NVIDIA Nemotron 3.5 adalah kumpulan model AI terbuka dan berlisensi komersial dari NVIDIA untuk kebutuhan retrieval pada sistem AI agent. Lini ini mencakup model Parse untuk ekstraksi dokumen, Embed untuk pencarian vektor teks dan visual, serta Rerank untuk menyaring kandidat data paling relevan.
Kenapa model Rerank di Nemotron 3.5 bisa menghemat token agent?
Nemotron 3.5 Rerank bertindak sebagai cross-encoder yang mengevaluasi kembali dokumen hasil pencarian dan hanya memasukkan bukti paling relevan ke konteks LLM. Karena konteks pengecoh disingkirkan, agent tidak perlu mengulang pencarian berkali-kali sehingga menghemat token inferensi hingga 14%.
Apakah kita harus membuat ulang indeks vektor teks saat migrasi ke Nemotron 3.5 Embed?
Tidak perlu. Bagian enkoder teks pada Nemotron 3.5 Embed dibekukan dari model generasi sebelumnya, Nemotron 3 Embed. Representasi vektor untuk teks murni tidak mengalami perubahan, sehingga database vektor teks yang sudah ada bisa langsung dipakai kembali tanpa re-indexing.
Berapa ukuran model Nemotron 3.5 Parse dan apa kelebihannya?
Nemotron 3.5 Parse memiliki ukuran 631 juta parameter dan berhasil menduduki peringkat pertama di ParseBench untuk model sub-1B parameter. Model ini mampu mengekstrak tabel dan grafik dokumen menjadi format Markdown atau HTML dengan kecepatan hingga 16,1 halaman per detik pada GPU H100.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.