NVIDIA NeMo Agent Toolkit S3 Vectors: Agent AI Jadi Ingat
AWS kasih tutorial lengkap gimana NVIDIA NeMo Agent Toolkit dipasangin Amazon S3 Vectors jadi memory jangka panjang buat agent AI, dari bikin plugin sampai deploy di Amazon EKS.
· 9 menit baca
Inti singkat
- NVIDIA NeMo Agent Toolkit (NAT) sekarang bisa pakai Amazon S3 Vectors jadi memory provider custom buat agent AI.
- S3 Vectors nyimpen sampai 2 miliar vector per index tanpa capacity planning, bayarnya cuma storage, write, dan query.
- Konsistensi tulis S3 Vectors kuat, jadi memory langsung kebaca agent lain begitu disimpan — pas buat tim multi-agent.
- AWS nyaranin deploy stack ini di Amazon EKS biar kontrol penuh soal scaling, network, dan akses IAM lewat IRSA.
- Menurut AWS, pakai memory bikin jawaban agent lebih grounded dan token usage turun, tapi latency naik sedikit.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
AWS baru ngasih tutorial teknis gimana NVIDIA NeMo Agent Toolkit (NAT) bisa dipasangin Amazon S3 Vectors sebagai "otak penyimpan memori" buat agent AI — biar agent nggak lupa-lupa terus setiap sesi baru dimulai. Ini penting banget buat yang lagi bangun sistem multi-agent, karena selama ini bikin memory yang murah, konsisten, dan bisa nyimpen jutaan data itu bukan perkara gampang.
Tutorialnya ditulis oleh Venkata Sistla dan dimuat di blog resmi AWS. Ini kelanjutan dari postingan AWS sebelumnya soal arsitektur memory buat sistem multi-agent — kali ini langsung masuk ke implementasi: kode, konfigurasi, sampai deploy di Kubernetes. Kalau kamu developer yang lagi ngoprek agent AI, ini contoh nyata gimana agent bisa "ingat" riwayat kerja mereka sendiri.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa itu NVIDIA NeMo Agent Toolkit (NAT)?
NAT itu framework open source buat bikin, nge-profil, dan ngoptimalin AI agent. Yang menarik, NAT ini framework-agnostic — bisa disambung ke Strands Agents, LangChain, LlamaIndex, CrewAI, atau bikinan sendiri.
Ada empat kemampuan utama di NAT:
- Orkestrasi agent — agent didefinisikan sebagai workflow yang bisa diatur-atur, lengkap sama LLM, tools, dan prompt. Bisa dijalanin lokal pakai
nat runatau dijadiin service permanen pakainat serve. - Profiling — ngelacak pemakaian token, latency, throughput, sampai waktu jalan tiap agent dan tools, buat nemuin bottleneck di workflow multi-agent.
- Evaluasi — ada evaluator built-in buat ngecek akurasi jawaban, relevansi konteks, groundedness respons, sampai jalur kerja agent.
- Optimasi — tuning parameter otomatis (temperature, top_p, max_tokens) biar kualitas maksimal tapi biaya dan latency tetap kecil.
Yang jadi fokus artikel ini adalah modul memory-nya. NAT punya subsistem memory yang dirancang buat nyimpen riwayat obrolan, preferensi user, dan pengetahuan jangka panjang lintas sesi agent. Komponen intinya:
MemoryEditor— interface abstrak yang wajib diimplementasikan semua backend memory, isinya tiga method:add_items(),search(), danremove_items().MemoryItem— model data buat satu keping memori, isinya riwayat obrolan, tag, metadata, user_id, sama teks memorinya.MemoryBaseConfig— kelas Pydantic yang jadi dasar konfigurasi memory custom. NAT nemuin provider lewat field_typedi config YAML.auto_memory_agent— wrapper workflow yang otomatis nyimpen dan narik memory tanpa LLM harus manggil tool memory secara eksplisit.
NAT udah punya provider memory built-in: Mem0, MemMachine, Redis, dan Zep. Tapi buat sistem multi-agent produksi yang butuh vector storage elastis, konsistensi tulis yang kuat, dan skala sampai miliaran vector dengan biaya hemat, AWS bikin provider custom pakai Amazon S3 Vectors.
Kenapa Amazon S3 Vectors Cocok Buat Memory Agent?
Amazon S3 Vectors itu kapabilitas vector search di Amazon S3. Menurut AWS, S3 Vectors nge-cover semua syarat arsitektur yang dibutuhkan agent memory:
| Kebutuhan | Kemampuan S3 Vectors |
|---|---|
| Pencarian semantik | Vector similarity search dengan metrik jarak yang bisa diatur (cosine, euclidean) |
| Query terfilter | Metadata di tiap vector bisa difilter (string, angka, boolean, list) |
| Koordinasi multi-agent | Konsistensi tulis kuat — memori langsung kebaca begitu disimpan |
| Skala | Sampai 2 miliar vector per index, tanpa perlu capacity planning |
| Biaya | Cuma bayar storage, write, dan query — nggak ada compute nganggur yang tetap dibayar |
| Kontrol akses | Kebijakan IAM per bucket dan index, bisa isolasi per-tenant lewat index terpisah |
Dua poin yang paling krusial buat sistem multi-agent itu konsistensi tulis dan skala. Kalau beberapa agent kerja bareng dan saling nyimpen-ngambil memori, telat sepersekian detik aja bisa bikin agent lain kerja dobel atau dapat info usang. S3 Vectors ngejamin memori langsung terlihat begitu ditulis, jadi nggak perlu invalidasi cache.
Cara NAT dan S3 Vectors Disatuin: 3 Langkah Implementasi
AWS ngasih contoh implementasi lewat tiga langkah: bikin infrastruktur S3 Vectors, bikin plugin MemoryEditor custom, lalu konfigurasi workflow agent-nya di file YAML.
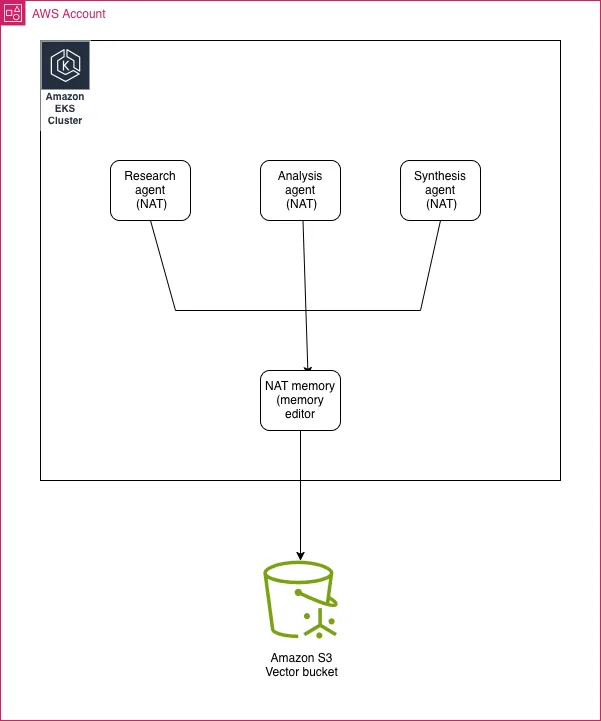
Langkah 1 — bikin bucket dan index. Index dibuat dengan 1024 dimensi biar cocok sama output Amazon Titan Text Embeddings V2, model embedding yang dipakai di contoh ini. Field content ditandai sebagai metadata non-filterable karena isinya teks panjang.
Langkah 2 — implementasi plugin MemoryEditor. Plugin ini yang jadi jembatan antara NAT dan S3 Vectors: tiap kali ada memori baru, teksnya diubah jadi embedding lewat Titan, lalu disimpan sebagai vector dengan metadata lengkap — user_id, memory_type (episodic/semantic), agent_id, team_id, task_id, confidence, sampai timestamp. Pas agent butuh nyari memori lama, fungsi search() ngubah query jadi embedding juga, terus nge-filter hasil berdasarkan metadata yang relevan.
Langkah 3 — konfigurasi workflow di YAML. Di sini provider custom-nya didaftarin lewat _type: s3vectors_memory, terus dipasang ke fungsi add_memory dan get_memory. Contoh potongan konfigurasinya kurang lebih begini:
memory:
 agent_memory:
 _type: s3vectors_memory
 vector_bucket: "amzn-s3-demo-research-agent-memory"
 index_name: "agent-long-term-memory"
 aws_region: "us-west-2"

workflow:
 _type: auto_memory_agent
 inner_agent_name: research_agent
 memory_name: agent_memory
 llm_name: bedrock_llm
 save_user_messages_to_memory: true
 retrieve_memory_for_every_response: true
Dengan wrapper auto_memory_agent, semua pesan user dan respons agent otomatis kesimpen, dan konteks relevan otomatis disuntikin sebelum tiap panggilan agent. Jadi LLM-nya nggak perlu disuruh manggil tool memory secara manual.
Studi Kasus: Tim Agent Riset Investasi yang Saling Nyambung Memori
AWS ngasih contoh kasus yang cukup konkret: tiga agent kerja bareng buat riset investasi. Research Agent ngumpulin data pasar, laporan earning, dan berita. Analysis Agent ngerjain analisis kuantitatif dan nemuin pola. Synthesis Agent nyusun laporan dari gabungan temuan dua agent lainnya.
Karena punya memory bareng, tiap agent bisa nerusin kerjaan yang udah pernah dikerjain — nggak perlu panggil API berulang atau ngulang analisis yang sama. Mereka pakai index S3 Vectors yang sama tapi nulis dengan agent_id masing-masing, dan nyari memori pakai filter team_id serta is_shared biar cuma ambil data yang memang relevan dan boleh dibagi.
Ada juga konsep konsolidasi memori: seiring waktu, memori episodic (kejadian spesifik) numpuk terus. AWS nyaranin memori-memori ini dirapihin jadi pengetahuan semantic (pola umum) secara berkala — bisa lewat cron job terjadwal, batas jumlah vector tertentu, atau sinyal dari agent itu sendiri setelah beberapa siklus riset. Ini bikin pencarian memori ke depannya tetap presisi dan nggak berat.
Deploy di Amazon EKS: Kenapa Bukan Cuma Serverless?
AWS milih Amazon EKS buat deployment karena tim yang butuh kontrol penuh atas lifecycle, scaling, dan network isolation agent-nya cocok pakai Kubernetes. Tiap tipe agent dijadiin Kubernetes Deployment, dan akses ke S3 Vectors diatur lewat IAM Roles for Service Accounts (IRSA) — jadi tiap pod cuma punya izin sesuai yang dia butuhkan.
Container agent-nya dibungkus pakai Dockerfile sederhana yang nge-install nvidia-nat[langchain] dan boto3, lalu dijalankan dengan nat serve. Deployment-nya dilengkapi HorizontalPodAutoscaler yang nambah-ngurangin replica berdasarkan pemakaian CPU, jadi saat traffic naik, agent bisa auto-scale sampai 10 replica tanpa kehilangan akses ke memory bareng.
Kalau kamu nggak mau ribet ngurusin operasional Kubernetes, AWS juga nyebut alternatif: Amazon Bedrock AgentCore sebagai runtime terkelola yang ngilangin beban operasional itu. Jadi EKS ini pilihan buat yang emang butuh kontrol penuh, bukan satu-satunya jalan.
Efeknya ke Performa Agent: Apa Kata AWS?
AWS nyediain cara ngukur dampak memory pakai nat eval — bandingin satu config dengan memory aktif dan satu tanpa memory, pakai dataset yang sama. Tapi penting dicatat, hasil berikut ini ekspektasi arah berdasarkan desain arsitektur, bukan angka benchmark yang udah dites AWS sendiri:
- Groundedness naik — karena agent bisa ngutip memori lama sebagai sumber, bukan cuma andalin pengetahuan internal model.
- Token usage turun — agent nggak perlu nurunin ulang fakta yang udah ketemu di sesi sebelumnya.
- Latency naik sedikit — tiap recall memory nambah satu query S3 Vectors (biasanya di bawah satu detik), tapi porsinya kecil dibanding waktu inferensi LLM.
- Kerjaan dobel berkurang — karena memori dibagi, agent nggak ngulang riset atau analisis yang udah dikerjain temannya.
Besarnya efek ini tergantung workload kamu sendiri: seberapa sering konteks dipakai ulang antar sesi, berapa banyak agent yang kolaborasi, dan seberapa besar top_k yang dipakai buat nge-retrieve memori.
Dampak Buat Developer Indonesia: Ngapain Peduli?
Buat developer atau startup di Indonesia yang lagi bangun produk berbasis AI agent, pola di artikel ini ngasih template nyata soal gimana bikin agent yang nggak "amnesia" tiap sesi — mulai dari customer support bot yang ingat histori pelanggan, sampai sistem DevOps yang belajar dari insiden sebelumnya. Contoh di artikel AWS malah nyebut domain lain yang cocok: legal research sampai scientific discovery.
Kalau kamu lagi eksperimen sama LLM yang jadi "otak" di workflow seperti ini — kayak llm_name: bedrock_llm yang di contoh AWS pakai model Claude — kamu bisa nyobain model sejenis lewat Classai Router tanpa perlu akun AWS atau kartu kredit luar negeri. Ada Claude Sonnet 4.5 (Rp160/Rp800 per 1 juta token) atau Claude Sonnet 5.5 (Rp6.400/Rp38.400 untuk input/output lebih tinggi) buat kebutuhan reasoning yang lebih berat. Tinggal ganti base URL ke router.classai.id/v1, kode SDK OpenAI atau Anthropic yang udah kamu punya nggak perlu diubah.
Kalau masih baru belajar bikin agent dan arsitekturnya, kelas AI untuk Developer dari Classai bisa jadi titik awal yang lebih terstruktur sebelum lompat ke proyek seberat ini.
Cara Mulai Nyobain NAT + S3 Vectors
Kalau mau coba sendiri pola dari artikel AWS ini, berikut langkah ringkasnya:
- Siapin akun AWS dengan izin bikin resource S3 Vectors dan cluster Amazon EKS.
- Install NVIDIA NeMo Agent Toolkit (AWS nyobain di versi 1.6) pakai Python 3.11 atau 3.12.
- Siapin embedding model — contoh di artikel ini pakai Amazon Titan Text Embeddings V2 lewat Bedrock.
- Bikin bucket dan index S3 Vectors, lalu tulis plugin
MemoryEditorcustom yang nyambung ke S3 Vectors. - Konfigurasi workflow di YAML, pasang
auto_memory_agent, lalu tes lokal pakainat runsebelum deploy ke EKS pakainat serve.
Dokumentasi lengkapnya ada di NVIDIA NeMo Agent Toolkit documentation dan panduan Adding a Memory Provider kalau kamu mau bikin provider memory versi sendiri selain S3 Vectors.
Saya mau bikin agent AI pakai NVIDIA NeMo Agent Toolkit dengan memory provider custom. Tolong bantu saya:1. Jelaskan struktur minimal class MemoryEditor yang perlu saya implementasikan (add_items, search, remove_items).2. Kasih contoh metadata schema yang masuk akal buat kasus [sebutkan use case kamu, misal: customer support bot toko online].3. Kasih saran kapan harus konsolidasi memori episodic jadi semantic.
Kalau kamu ngerjain proyek agent yang lebih fokus ke keandalan di database, artikel Cara Ngecek Reliabilitas Agen AI di Database bisa jadi bacaan lanjutan yang nyambung sama topik ini.
Sumber & referensi
- 01
AWS · 2 Oktober 2026
Build agent memory with NVIDIA NeMo Agent Toolkit and Amazon S3 Vectors
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di halo@classai.id.
Pertanyaan yang sering ditanyakan
Apa itu NVIDIA NeMo Agent Toolkit?
NVIDIA NeMo Agent Toolkit (NAT) adalah framework open source buat bikin, nge-profil, dan ngoptimalin AI agent. NAT bisa disambung ke LangChain, CrewAI, LlamaIndex, Strands Agents, atau implementasi custom, dan punya modul memory bawaan buat nyimpen riwayat obrolan agent.
Apa itu Amazon S3 Vectors dan kenapa dipakai buat memory agent AI?
Amazon S3 Vectors adalah kapabilitas vector search di Amazon S3 yang bisa nyimpen sampai 2 miliar vector per index. Dipakai buat memory agent karena punya konsistensi tulis kuat, metadata yang bisa difilter, dan biayanya cuma dari storage, write, dan query — nggak ada compute nganggur.
Apakah NVIDIA NeMo Agent Toolkit cuma bisa jalan di AWS?
Nggak, NAT itu open source dan framework-agnostic, bisa dipasangin ke berbagai backend memory seperti Mem0, Redis, Zep, atau custom provider. Yang dibahas di artikel AWS ini adalah salah satu contoh implementasi pakai Amazon S3 Vectors dan dideploy di Amazon EKS.
Apa risiko nyimpen data di agent memory seperti ini?
Risiko utamanya ada di retensi data dan kebocoran informasi pribadi (PII) kalau nggak dikelola hati-hati. AWS nyaranin bikin kebijakan retensi, redaksi data sensitif sebelum di-embed, dan isolasi akses per-tenant pakai index dan IAM yang scoped.
Gimana cara mulai nyobain NAT dengan S3 Vectors?
Kamu butuh akun AWS, install NAT (versi 1.6 ke atas), siapin embedding model kayak Titan Text Embeddings V2, bikin bucket dan index S3 Vectors, lalu tulis plugin MemoryEditor custom sebelum konfigurasi workflow di file YAML dan deploy ke Amazon EKS.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.