Nemotron 3 5 Super VL Rilis: Model MoE NVIDIA Kini Siap di AWS
NVIDIA merilis Nemotron 3.5 Super VL dengan arsitektur MoE 120B dan hybrid Mamba-2. Model multimodal ini kini siap dideploy di AWS EKS dan SageMaker HyperPod.
· 10 menit baca
Inti singkat
- Nemotron 3.5 Super VL adalah model MoE 120B yang cuma mengaktifkan 12B parameter per token.
- Model ini memadukan Mamba-2, attention, dan encoder vision RADIO dengan context length hingga 1M token.
- NVIDIA membagikan bobot model, dataset latihan, dan resep post-training secara terbuka.
- Deployment didukung di Amazon EKS, EKS Auto Mode, dan SageMaker HyperPod EKS memakai NVIDIA Dynamo.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
NVIDIA Nemotron 3.5 Super VL resmi hadir di infrastruktur Amazon Web Services (AWS) sebagai model multimodal open source berukuran 120B parameter yang memakai arsitektur Mixture of Experts (MoE). Model ini menggabungkan kemampuan penalaran tingkat lanjut, eksekusi tool, serta pemahaman visual menyeluruh untuk teks, gambar, dokumen, hingga video dalam satu sistem.
Buat developer yang lagi getol membangun agen AI otonom, urusan visual dan teks biasanya harus dipisah ke model yang berbeda. Nah, langkah NVIDIA ngerilis model ini mengubah alur kerja tersebut. Menurut pengumuman resmi AWS Machine Learning Blog, model anyar ini melengkapi jajaran keluarga Nemotron lain yang udah ada di AWS, seperti Nemotron 3 Nano, Nano Omni, Super, Ultra, dan Nemotron 3.5 Lightning. Bedanya, versi Super VL ini dirancang khusus buat menangani tugas penalaran visual yang berat tanpa bikin ongkos komputasi jebol.
Kabar baiknya lagi buat pegiat kecerdasan buatan sumber terbuka, NVIDIA nggak cuma ngerilis checkpoint bobot modelnya aja. Mereka juga membagikan dataset pelatihan dan resep post-training secara terbuka, jadi tim developer bisa melakukan kustomisasi penuh sesuai kebutuhan domain bisnis masing-masing di atas server sendiri.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu Nemotron 3.5 Super VL?
Secara teknis, Nemotron 3.5 Super VL adalah model vision-language multimodal terbuka hasil distilasi dari model Nemotron 3 Ultra. Walau total parameternya mencapai 120 miliar (120B), arsitektur sparse routing di dalamnya bikin model ini cuma mengaktifkan 12 miliar (12B) parameter per token pas proses inferensi berjalan.
Artinya, kebutuhan komputasi per token setara dengan model berukuran jauh lebih kecil, tapi kapasitas pengetahuannya tetap seluas model 120B. Model ini menerima input berupa teks, gambar, dokumen visual, dan video, dengan output berbentuk teks. Menariknya lagi, panjang konteks (context length) yang didukung mencapai 1 juta token, didukung oleh checkpoint berformat BF16 serta format kuantisasi hemat memori NVFP4.
Sebelumnya kita udah melihat inovasi audio lewat /developer/nemotron-3-5-transcribe-nvidia-speech-to-text, dan sekarang NVIDIA melengkapinya ke pemrosesan visual dan teks tingkat lanjut lewat keluarga model yang sama.
Berikut ringkasan spesifikasi utama Nemotron 3.5 Super VL:
| Spesifikasi | Detail | Catatan Teknis |
|---|---|---|
| Total Parameter | 120B | Bobot penuh disimpan di memori GPU |
| Parameter Aktif | 12B | Diaktifkan per token lewat sparse routing |
| Context Window | Hingga 1.000.000 token | Cocok buat dokumen tebal & video panjang |
| Jenis Input | Teks, Gambar, Dokumen, Video | Menggunakan vision encoder RADIO |
| Format Output | Teks | Mendukung fungsi reasoning dan tool calling |
| Format Checkpoint | BF16 dan NVFP4 | NVFP4 memangkas kebutuhan jumlah GPU |
Rahasia Arsitektur: Hybrid Mamba-2 dan Vision Encoder RADIO
Kenapa model sebesar ini bisa tetap gesit dan hemat resource? Kuncinya ada pada desain arsitektur hibrida. Nemotron 3.5 Super VL memadukan lapisan Mamba-2, layer attention standar Transformer, dan lapisan expert MoE yang diselingi secara bergantian.
Lapisan Mamba-2 punya keunggulan telak dalam mengelola memori karena membawa state berukuran konstan saat proses pembuatan teks berlangsung. Berbeda dengan mekanisme KV cache pada Transformer murni yang memorinya terus membengkak seiring bertambahnya panjang token, Mamba-2 menjaga penggunaan RAM GPU tetap stabil. Ini alasan kenapa model bisa melayani context window sampai 1 juta token tanpa bikin server kehabisan memori.
Di sisi pemrosesan visual, model ini mengandalkan encoder vision RADIO yang sanggup membaca tata letak dokumen rumit, bagan, dan frame video resolusi tinggi. Selain itu, ada head Multi-Token Prediction (MTP) bertingkat yang mendukung fitur speculative decoding langsung dari dalam arsitektur model, bikin proses inferensi token jadi berlipat lebih kencang.
Hasil Benchmark Nemotron 3.5 Super VL
NVIDIA menguji performa model ini di berbagai pengujian standar industri buat mengukur kapabilitas penalaran dan kinerja agen otonom. Hasilnya terbukti kompetitif buat model sekelasnya, seperti yang dipublikasikan dalam technical report Nemotron.
| Benchmark | Skor | Aspek yang Diuji |
|---|---|---|
| Hermes Bench | 63,44% | Kemampuan penalaran umum dan instruksi kompleks |
| LangChain Agent Evaluations | 87,05% | Efektivitas eksekusi tool dan alur kerja agen AI |
| CharXiv | 80,80% | Pemahaman grafik, diagram, dan data visual teknis |
Skor 87,05% pada evaluasi LangChain membuktikan model ini bukan sekadar jago ngobrol, melainkan siap dipakai buat alur kerja agen mandiri yang butuh memanggil API eksternal dan mengambil keputusan runtut.
Skenario Penggunaan Utama buat Agen AI
Kombinasi antara penalaran logika dan pemahaman visual bikin Nemotron 3.5 Super VL luwes dipakai untuk berbagai fungsi praktis:
- Coding dan Validasi Software: Membaca screenshot error, menganalisis struktur kode program, menguji logika algoritma, dan ngasih saran perbaikan bug.
- Riset Web Terverifikasi: Agen bisa melakukan pencarian daring lewat tool search, lalu membandingkan silang isi halaman web dengan tangkapan layar bukti sumber.
- Document Intelligence Tingkat Lanjut: Membaca tabel berformat rumit, membaca diagram batang atau garis, dan merangkum berkas laporan keuangan puluhan halaman.
- Operasi Keamanan Siber: Menganalisis log sistem visual, mendeteksi potensi celah keamanan pada konfigurasi, dan melakukan triage terhadap laporan ancaman.
- Analisis Konten Video: Menelusuri momen penting di dalam rekaman video, mereview konten, sampai menganalisis rekaman insiden secara otomatis.
Model ini juga terhubung mulus dengan berbagai framework agen populer melalui NVIDIA Agent Toolkit serta panduan resmi di NVIDIA developer blog.
Kebutuhan Hardware dan Konfigurasi GPU Minimum
Karena model ini punya 120 miliar parameter, kamu butuh cluster GPU yang memadai buat menampung seluruh bobotnya. vLLM dipakai sebagai inference engine utama. Jumlah GPU minimum yang kamu perlukan bergantung pada format presisi bobot yang dipilih (BF16 atau kuantisasi NVFP4):
| Tipe GPU NVIDIA | Minimum GPU (BF16) | Minimum GPU (NVFP4) |
|---|---|---|
| B200 / GB200 | 8 GPU | 2 GPU |
| B300 / GB300 | 4 GPU | 1 GPU |
| H200 | 8 GPU | 4 GPU |
| H100 | 16 GPU | 8 GPU |
Kalau kamu pakai instance berbasis H100 dengan presisi penuh BF16, kamu butuh minimal 16 GPU. Tapi kalau beralih ke format NVFP4 di arsitektur Blackwell (B200/GB200), kebutuhan GPU bisa dipangkas drastis jadi cuma 2 unit saja.
Arsitektur Deploy Nemotron di Amazon EKS dan SageMaker
AWS menyediakan referensi deployment resmi yang bisa dijalankan di tiga lingkungan: Amazon Elastic Kubernetes Service (Amazon EKS) standar, EKS Auto Mode, dan Amazon SageMaker HyperPod EKS. Kalau kamu pakai EKS Auto Mode, urusan penskalaan node, konfigurasi driver GPU, dan dukungan EFA bakal dikelola langsung secara otomatis oleh AWS.
Struktur dasarnya memisahkan antara control plane Kubernetes dan data plane. Data plane dibagi menjadi dua jenis node:
- CPU Node: Menjalankan pod sistem Kubernetes, pengujian, dan router lalu lintas.
- GPU Node: Khusus memuat container inference dan menjalankan bobot model.
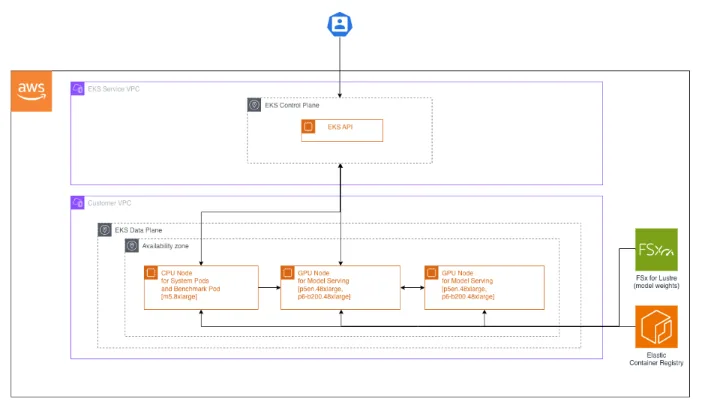
Komponen pendukungnya mencakup Amazon Elastic Container Registry (ECR) buat menyimpan image container, volume bersama Amazon FSx for Lustre untuk menyimpan dan menyalurkan file bobot model berkecepatan tinggi ke GPU, serta Elastic Fabric Adapter (EFA) buat komunikasi antar-node GPU. Pengelolaan inferensi ditangani oleh NVIDIA Dynamo, yang bisa dikonfigurasi dalam dua pola: aggregated (semua tahap jalan di satu node) atau disaggregated (memisahkan tahap prefill dan decode di node berbeda, bahkan encoding visual bisa ditaruh di node terpisah).
Validasi Cluster dan Pengukuran Kinerja dengan aiperf
Sebelum melayani traffic produksi, cluster harus divalidasi dulu stabilitas jaringannya. Validasi dilakukan memakai micro-benchmark all-reduce dari NVIDIA Collective Communications Library (NCCL). Uji coba ini memastikan semua adapter EFA dan interkoneksi GPU berjalan pada bandwidth maksimal tanpa ada paket yang tersendat.
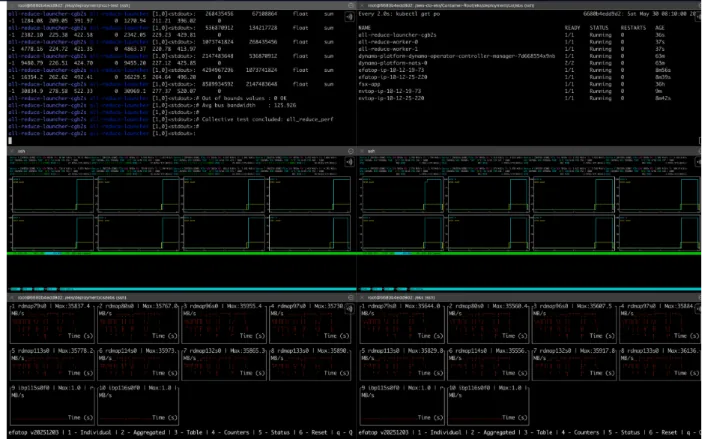
Setelah cluster dinyatakan sehat, performa inferensi diukur memakai tool pengujian resmi NVIDIA aiperf. Alat ini mencatat metrik utama seperti Time to First Token (TTFT), Inter-Token Latency (ITL), dan Throughput dalam satuan Token per Second (TPS).
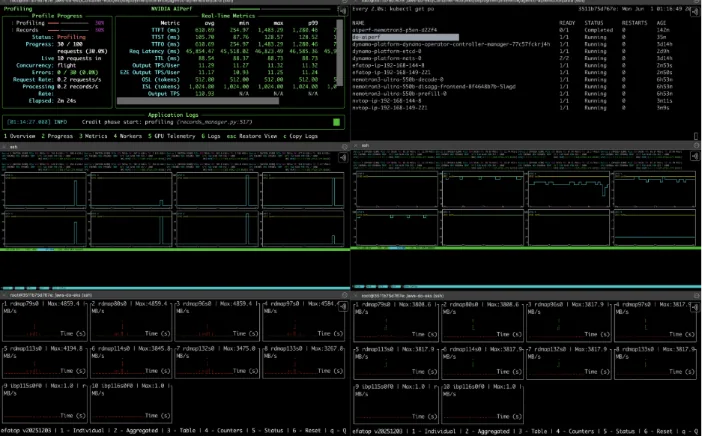
Pengujian dilakukan lewat concurrency sweep, yaitu menyimulasikan lonjakan request bersamaan dari tingkat rendah sampai tinggi. Data ini penting banget buat membandingkan arsitektur inferensi aggregated vs disaggregated.
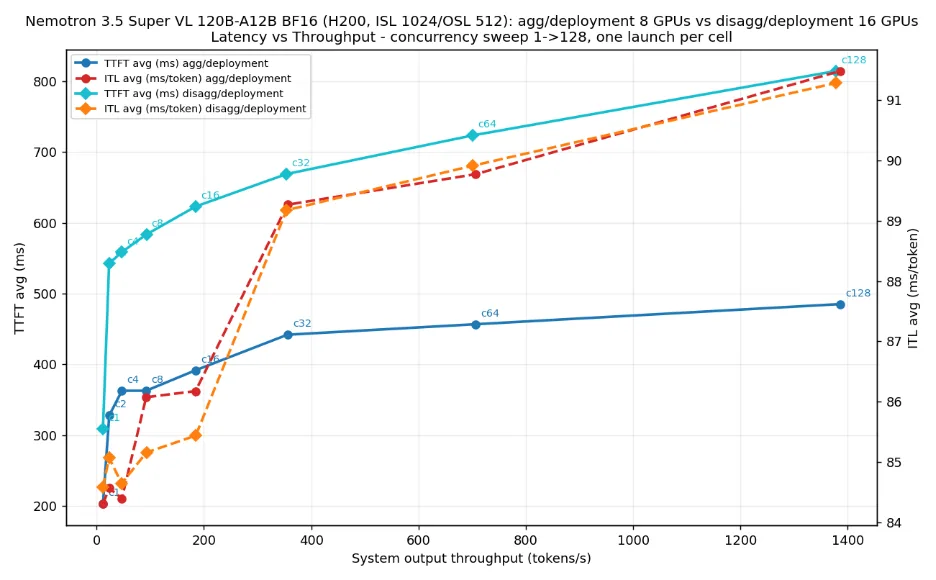
Hasil pengujian pada grafik di atas menunjukkan inferensi Nemotron 3.5 Super VL menghasilkan TTFT yang lebih rendah pada konfigurasi tertentu dengan ITL yang relatif sama antara metode aggregated dan disaggregated di dua node. Kalau kamu menetapkan Service Level Objective (SLO) misalnya TTFT di bawah 600 ms dan ITL di bawah 100 ms per token, grafik ini langsung memperlihatkan kapasitas throughput maksimal yang bisa dilayani per replika (sekitar 320 token per detik pada tingkat concurrency c32).
Panduan Praktis Deploy di AWS EKS
Buat developer yang pengin langsung mencoba panduan resminya, blueprint lengkap sudah disediakan di repositori terbuka AWS. Kamu bisa mengikuti alur kerja berikut berbasis panduan teknis walkthrough aws-do-eks:
- Siapkan Cluster Kubernetes: Buat cluster Amazon EKS atau SageMaker HyperPod EKS dengan node group GPU berbasis instance p6-b200.48xlarge (8x B200) atau p5en.48xlarge (8x H200). Aktifkan konfigurasi EFA di subnet VPC kamu.
- Pasang Penyimpanan Bersama: Buat file system Amazon FSx for Lustre dan kaitkan ke cluster EKS. Langkah ini penting supaya pod GPU bisa membaca file bobot ratusan gigabyte secara paralel tanpa bottleneck.
- Unduh Bobot Model: Jalankan job pod sementara untuk menarik bobot Nemotron 3.5 Super VL resmi dari repositori ke volume FSx for Lustre.
- Terapkan Manifest Kubernetes: Deploy container image NVIDIA Dynamo dan vLLM yang sudah disiapkan di Amazon ECR menggunakan konfigurasi manifest YAML bawaan aws-do-eks.
- Jalankan Uji NCCL dan aiperf: Eksekusi script pengujian NCCL buat memverifikasi jaringan antarnode, lalu jalankan sweep aiperf buat memastikan latensi sudah sesuai target aplikasi kamu.
Jika ingin mempelajari blueprint arsitektur agen di cloud AWS lebih dalam, kamu juga bisa membaca artikel kami tentang /developer/arsitektur-bedrock-agentcore-platform-agen-ai.
Berikut contoh prompt pengujian analisis dokumen visual yang bisa kamu kirimkan ke endpoint model setelah aktif:
Kamu adalah agen analis data keuangan. Analisis gambar bagan laporan laba rugi kuartal ketiga yang dilampirkan berikut ini.1. Ekstraksi angka pendapatan bersih, margin kotor, dan biaya operasional dalam format tabel Markdown.2. Identifikasi 3 anomali atau deviasi terbesar dibanding kuartal sebelumnya.3. Berikan rekomendasi langkah efisiensi berdasarkan data tersebut.
Dampak Buat Developer dan Perusahaan di Indonesia
Kehadiran Nemotron 3.5 Super VL membawa alternatif segar buat industri teknologi di Indonesia, terutama di tengah regulasi perlindungan data pribadi (UU PDP):
- Kedaulatan Data Penuh: Perusahaan perbankan, fintech, logistik, dan layanan kesehatan di Indonesia yang terikat aturan ketat privasi data kini bisa menjalankan model multimodal kelas atas di infrastruktur AWS VPC lokal atau on-premise mereka sendiri tanpa harus melempar dokumen sensitif ke API pihak ketiga.
- Efisiensi Biaya Operasional: Berkat arsitektur MoE (cuma 12B active) dan Mamba-2, biaya komputasi per token jauh lebih ekonomis dibanding model dense murni berukuran ratusan miliar parameter, terutama untuk dokumen panjang seperti kontrak legal atau berkas perpajakan.
- Kustomisasi Domain Lokal: Karena NVIDIA merilis resep training dan datasetnya secara terbuka, developer lokal bisa melakukan fine-tuning lanjutan memakai korpus bahasa Indonesia khusus industri—misalnya istilah medis, hukum perdata lokal, atau terminologi logistik daerah.
Buat kamu yang ingin membangun prototipe agen cerdas atau integrasi aplikasi tanpa perlu repot menyiapkan cluster GPU sendiri sejak hari pertama, kamu bisa memanfaatkan Classai Router. Lewat satu API key yang kompatibel dengan format SDK OpenAI maupun Anthropic, kamu bisa langsung mencoba berbagai model canggih seperti Claude Sonnet 5.5 (Rp3.600 / Rp18.000 per 1M token), GPT-4o (Rp525 / Rp2.700 per 1M token), hingga DeepSeek V4.1 Flash (Rp1.155 / Rp4.200 per 1M token). Cukup ganti base URL ke router.classai.id/v1, dan saldo bisa diisi mulai Rp10.000 via QRIS tanpa kartu kredit luar negeri.
Kalau kamu tertarik mendalami keterampilan praktis membangun aplikasi berbasis model AI tingkat lanjut, kamu juga bisa mengikuti kelas AI untuk Developer di Classai untuk belajar langsung dari praktisi industri.
Sumber & referensi
- 01
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa keunggulan utama Nemotron 3.5 Super VL dibanding model lain?
Nemotron 3.5 Super VL memakai arsitektur MoE 120B yang cuma mengaktifkan 12B parameter per token, dipadu lapisan Mamba-2 dan encoder vision RADIO. Desain ini bikin model mampu memproses teks, dokumen, gambar, dan video hingga 1 juta token dengan komputasi sehemat model kecil.
Apakah Nemotron 3.5 Super VL open source?
Ya, model ini terbuka. NVIDIA merilis bobot model (weights), dataset pelatihan, serta resep post-training secara publik, sehingga developer bisa mengunduh, memodifikasi, dan menjalankannya di infrastruktur cloud atau server sendiri.
Berapa GPU minimum untuk deploy Nemotron 3.5 Super VL di vLLM?
Kebutuhannya tergantung tipe GPU dan format presisi. Untuk format BF16, kamu butuh minimal 8 GPU NVIDIA B200 atau H200, atau 16 GPU H100. Sedangkan pada format kuantisasi NVFP4, kamu cukup memakai 2 GPU B200, 4 GPU H200, atau 8 GPU H100.
Apa fungsi Mamba-2 pada arsitektur Nemotron 3.5 Super VL?
Lapisan Mamba-2 mempertahankan ukuran state yang konstan selama proses pembuatan token teks. Hal ini mencegah pembengkakan memori akibat KV cache pada konteks panjang, sehingga model sanggup menangani context length hingga 1 juta token secara stabil.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.