Evaluasi Model Amazon Bedrock: Trik Potong Biaya AI Vision 86%
Dataset evaluasi AI kamu bisa jadi memihak model lama. Simak cara tim teknis membongkar bias evaluasi di Amazon Bedrock dan memangkas biaya sampai 86%.
· 8 menit baca
Inti singkat
- Sebanyak 96,8% label evaluasi lama Property Finder ternyata berasal dari tebakan model sebelumnya, bukan kurasi manusia.
- Memperbaiki ground truth dengan anotasi pakar independen membongkar perbandingan performa model yang selama ini bias.
- Transisi dari single-label ke multi-label sukses menyelesaikan masalah ambiguitas foto properti yang tumpang tindih.
- Optimasi prompt terarah menghasilkan peningkatan Micro F1 hingga 0,81 pada model Llama 4 Maverick 17B Instruct.
- Migrasi beban kerja ke Amazon Bedrock berhasil memangkas biaya pemrosesan gambar hingga 86% dan latensi 40–60%.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Banyak tim engineering terjebak bias evaluasi karena memakai tebakan model lama sebagai kunci jawaban acuan (ground truth). Lewat studi kasus Property Finder dan tim AWS, perbaikan metodologi evaluasi model Amazon Bedrock terbukti bisa mendongkrak akurasi klasifikasi sekaligus memangkas biaya komputasi sampai 86 persen.
Pernah nggak kamu ngerasa model AI baru yang kamu tes selalu kalah dibanding model lama di sistem produksi? Jangan buru-buru menyimpulkan model baru itu jelek. Bisa jadi, sistem evaluasi kamu yang lagi membohongi kamu sendiri. Masalah jebakan evaluasi melingkar ini dibongkar tuntas lewat laporan teknis di AWS Machine Learning Blog bersama tim Property Finder.
Property Finder adalah platform real estate digital yang memproses puluhan ribu gambar properti tiap hari di kawasan Timur Tengah dan Afrika Utara (MENA). Tiap foto listing harus dicek 11 atribut kualitas sekaligus, mulai dari deteksi watermark, klasifikasi ruangan, status furnitur, kualitas foto, sampai indikator konstruksi. Saat mereka berniat mencari model alternatif yang lebih murah di Amazon Bedrock, semua kandidat baru selalu terlihat jeblok. Ternyata, biang keroknya ada di dataset evaluasi mereka sendiri.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Jebakan Circular Evaluation: Saat Kunci Jawaban Ditulis Model Lama
Setelah diaudit, tim Property Finder menemukan fakta mengejutkan: 96,8 persen label evaluasi mereka diwarisi langsung dari prediksi model lama, bukan diverifikasi oleh pakar manusia. Selama ini mereka mengira, karena model lama sudah jalan di produksi tanpa komplain, hasilnya otomatis aman dipakai sebagai ground truth.
Kondisi ini bikin evaluasi jadi melingkar (circular evaluation). Setiap model alternatif dinilai bukan berdasarkan kebenaran objektif foto, melainkan seberapa mirip jawabannya dengan model lama. Parahnya lagi, label lama itu punya banyak cacat tersembunyi. Misalnya, ekstraksi teks watermark punya kesalahan level karakter yang dianggap benar, termasuk salah mengenali nama merek dan karakter hilang. Selain itu, pada 3,2 persen sampel yang sempat dilabeli manusia, para anotator memasukkan kategori di luar spesifikasi, seperti munculnya label Office yang aslinya nggak ada di daftar prompt.
Kalau kamu mau tahu taktik efisiensi token lainnya di infrastruktur cloud ini, kamu juga bisa baca ulasan teknis kami soal /developer/prompt-caching-amazon-bedrock-agen-ai-hemat-biaya.
Membangun Ground Truth Vision AI yang Bersih dan Objektif
Untuk memutus siklus evaluasi yang bias, tim Property Finder bareng AWS Generative AI Innovation Center membangun ulang dataset evaluasi dari nol tanpa melihat keluaran model lama sama sekali.
- Anotasi oleh Pakar Domain: Tim menganotasi manual 356 gambar dari listing di Uni Emirat Arab (UEA) dan 230 gambar dari Mesir untuk cek lintas wilayah. Sebanyak 256 gambar UEA awal dijadikan development set untuk tuning, sedangkan sisa 100 gambar berikutnya digabung untuk membentuk 356 gambar evaluation set final.
- Klarifikasi Ambigu: Sesi klarifikasi rutin diadakan bareng tim AWS untuk memastikan konsistensi standar kualitas listing properti pada setiap sampel.
- Transisi ke Multi-label: Foto lorong yang memperlihatkan kamar tidur lewat pintu terbuka sebelumnya bikin bingung model single-label. Dengan beralih ke multi-label, model dinilai atas apa yang berhasil dikenali secara wajar tanpa dihukum karena menyebutkan ruangan kedua yang memang terlihat.
- Pemilihan Metrik yang Pas: Metrik Micro F1 dipilih sebagai acuan utama karena memberi bobot sama pada tiap prediksi. Macro F1 tetap dipantau supaya performa di kelas langka nggak tenggelam. Selain itu, mereka melacak metrik Intersection over Union (IoU) per sampel serta exact-match accuracy untuk sembilan atribut single-label.
Optimasi Prompt Berbasis Pendekatan Reinforcement Learning
Setelah punya tolak ukur evaluasi yang adil, Property Finder mulai menata prompt. Pendekatan yang dipakai mengadopsi konsep mirip reinforcement learning atau metode GEPA (Genetic-Pareto reflective prompt evolution), di mana versi prompt diperlakukan layaknya agen, skor Micro F1 sebagai sinyal reward, dan analisis eror gambar sebagai penunjuk arah perbaikan.
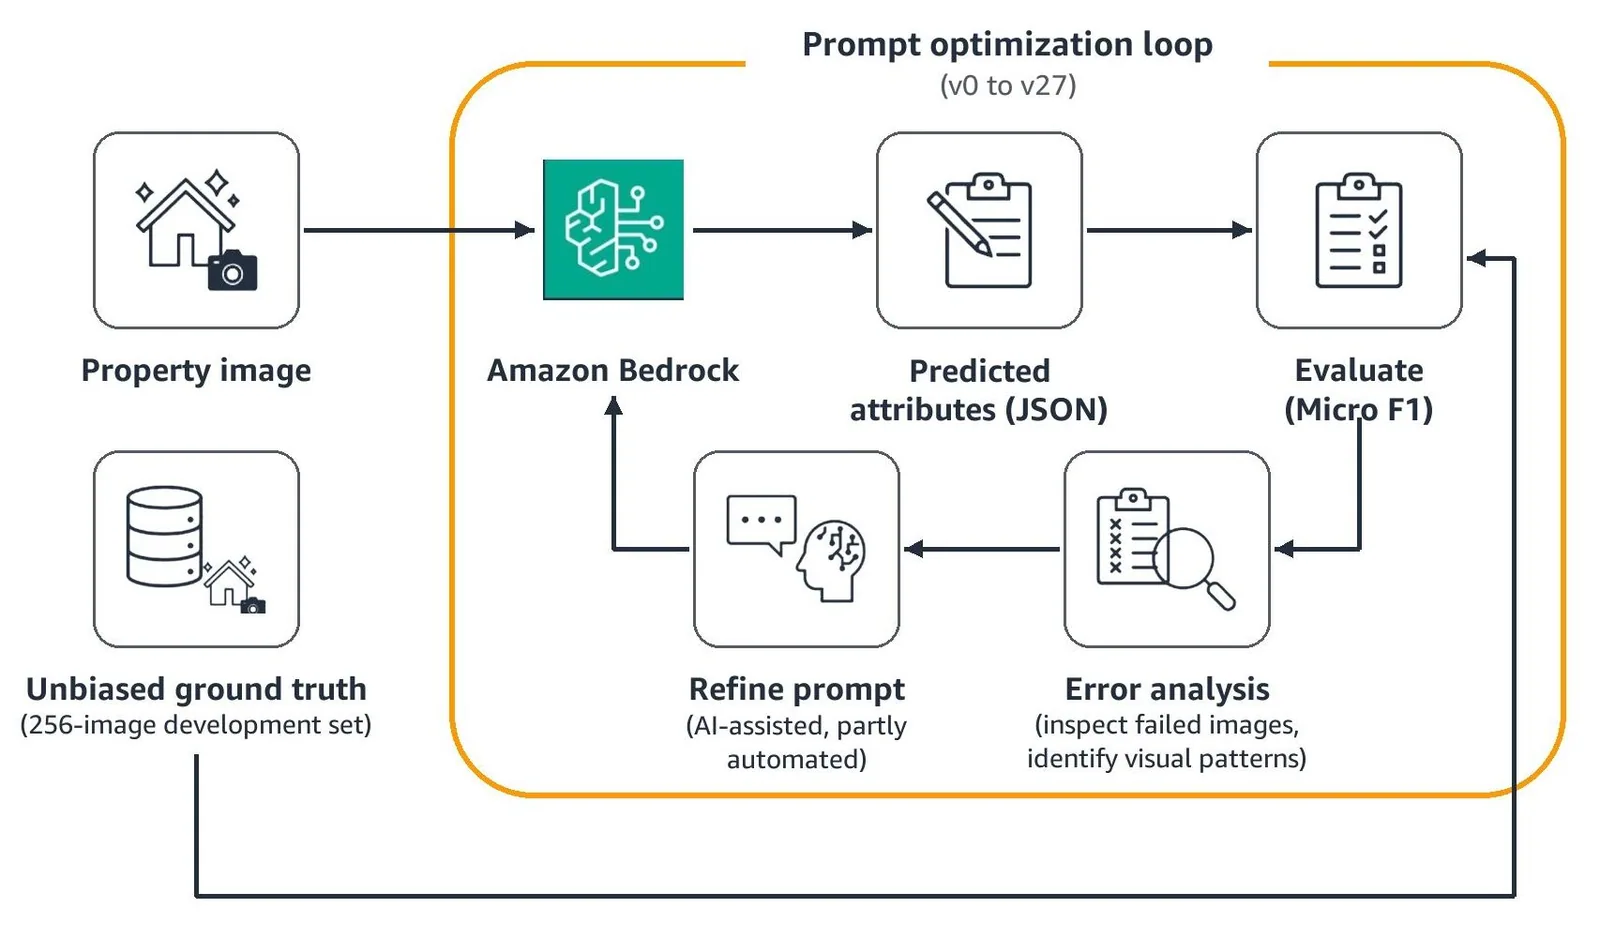
Optimasi prompt ini berjalan intensif dari versi v0 sampai v27_PF. Pada tahap awal (v0), instruksi klasifikasinya sangat umum dan cuma menghasilkan Micro F1 sebesar 0,55 pada model proprietary A (baseline produksi lama dengan prompt v22). Analisis eror visual menunjukkan model sering salah fokus pada ruangan kecil di balik pintu. Tim lantas menambahkan aturan eksplisit agar model mendahulukan ruangan yang mendominasi bingkai foto.
Perbaikan berlanjut ke adaptasi lokal. Di kawasan Timur Tengah, listing foto sering memuat teks Arab dekoratif yang bukan watermark komersial. Begitu aturan khusus teks Arab ditambahkan, angka positif palsu langsung rontok drastis. Mulai dari prompt v21 yang sudah mendukung format multi-label, model Llama 4 Maverick 17B Instruct dari Meta sanggup mencetak Micro F1 sebesar 0,75 pada development set.
Masuk ke versi v27, tim memanfaatkan framework otomatis MIPROv2 dari pustaka DSPy untuk merestrukturisasi tugas klasifikasi foto. Versi pamungkas (v27_PF) menambahkan aturan khusus untuk gambar render 3D, foto berbingkai, dan koridor, yang berhasil mendorong skor Micro F1 Llama 4 Maverick 17B Instruct tembus 0,81 di development set dan 0,80 di evaluation set.
Mengapa Eksperimen Multi-Call Gagal?
Menariknya, nggak semua ide optimasi berakhir manis. Tim Property Finder sempat mencoba skema 2-bucket approach, yaitu memecah pemrosesan ke dalam dua panggilan API terpisah: satu khusus membaca atribut watermark, dan satu lagi untuk sisa atribut gambar lainnya.
Hasilnya ternyata nihil peningkatan akurasi. Justru kemampuan mendeteksi foto berbingkai (boxed-image detection) anjlok tajam. Pasalnya, tanpa konteks atribut watermark di dalam prompt yang sama, model AI malah mengira watermark di pinggir gambar sebagai garis tepi bingkai foto. Ini jadi bukti penting kalau memecah prompt visi jadi beberapa panggilan API belum tentu bikin model makin cerdas.
Hasil Uji: Llama 4 Maverick 17B Unggul Telak di Amazon Bedrock
Melalui pengujian di Amazon Bedrock, model Llama 4 Maverick 17B Instruct (v27_PF) terbukti menyamai atau melampaui performa model proprietary A di seluruh 11 atribut listing properti. Pada klasifikasi foto multi-label, keduanya mencetak skor seimbang.
Berikut rincian skor exact-match accuracy yang diraih Llama 4 Maverick 17B Instruct pada 9 atribut single-label (diuji pada 356 data evaluation set):
| Atribut Gambar | Exact-Match Accuracy |
|---|---|
| Deteksi Rotasi (Rotation detection) | 100% |
| Deteksi Orang (People detection) | 97% |
| Deteksi Gambar Berbingkai (Boxed-image) | 97% |
| Deteksi Watermark | 94% |
| Deteksi Render 3D | 93% |
| Status Furnitur (Furnished status) | 91% |
| Ruangan Sedang Dibangun | 81% |
| Ukuran Ruangan (Room size) | 65% |
| Ekstraksi Teks Watermark | 55% |
Enam dari sembilan atribut berhasil menembus akurasi 90 persen ke atas. Skor Micro F1 model ini secara keseluruhan mencapai 0,80, jauh meninggalkan model proprietary A yang tertahan di angka 0,56.
Perbandingan Biaya dan Kecepatan Pemrosesan
Bagi bisnis yang memproses jutaan token dan puluhan ribu gambar setiap hari, efisiensi unit ekonomi adalah kunci keberlanjutan sistem AI.
| Metrik Operasional | Hasil / Efisiensi |
|---|---|
| Estimasi Biaya per 1.000 Gambar | $2,35 |
| Penurunan Biaya Operasional | Hemat 86% |
| Penurunan Latensi Inferensi | Turun 40–60% |
Estimasi angka $2,35 per 1.000 gambar ini dihitung berdasarkan harga wilayah AWS US East (Ohio) per Desember 2025 dengan asumsi batas atas 9.000 token input dan 200 token output per gambar. Dalam praktiknya, satu panggilan prompt v27_PF hanya memakan sekitar 7.500–8.000 token input. Berkat arsitektur open-weight yang efisien dan penghapusan panggilan ganda, Property Finder sukses menghemat pengeluaran hingga 86 persen dan mempercepat inferensi sampai 60 persen.
Bila sistem AI kamu menangani interaksi visual atau teks dengan volume tinggi dan butuh integrasi model cerdas lain seperti GPT-4o mini, DeepSeek V4.1 Flash, atau Claude Haiku, kamu bisa melirik gateway API fleksibel. Lewat Classai Router, kamu bisa menghubungkan berbagai model global terbaik cukup lewat satu endpoint terpadu.
Contoh Format Prompt JSON untuk Vision AI
Untuk mendapatkan luaran multi-label yang terstruktur seperti yang diterapkan tim Property Finder, kamu bisa memakai panduan prompt berorientasi JSON berikut saat memanggil model visi:
Kamu adalah sistem analis gambar real estate profesional. Analisis foto properti yang diberikan dan kembalikan output HANYA dalam format JSON valid tanpa teks pengantar. Tugas:1. Tentukan kategori ruangan utama berdasarkan area yang mendominasi frame.2. Jika ada ruangan lain yang terlihat jelas melalui pintu/lorong, masukkan ke dalam daftar 'secondary_rooms'.3. Deteksi apakah ada watermark logo, teks Arab dekoratif, atau atribut bingkai. Format output yang diharapkan:{ "primary_room": "string", "secondary_rooms": ["string"], "is_furnished": true, "is_under_construction": false, "has_watermark": false, "is_boxed_frame": false}
Dampak Nyata untuk Developer dan Bisnis di Indonesia
Pembelajaran dari Property Finder ini relevan banget buat ekosistem tech dan startup di Indonesia, khususnya yang bergerak di bidang e-commerce, logistik, fintech KYC, sampai aplikasi listing properti lokal.
Pertama, banyak tim developer lokal terbiasa membuat data uji (validation set) hanya dari hasil scraping atau hasil tebakan model OpenAI yang sudah ada. Cara ini menciptakan ilusi performa. Begitu kamu mau migrasi ke model open-weight yang lebih terjangkau, model baru akan selalu dicap gagal padahal masalahnya ada pada ground truth yang cacat.
Kedua, konteks lokal sangat krusial. Seperti halnya Property Finder yang harus menyetel aturan ekstra untuk teks Arab hiasan, aplikasi di Indonesia juga punya dinamika visual khas—mulai dari stempel toko, spanduk warung, hingga foto KTP dengan latar belakang yang bervariasi. Menyesuaikan prompt dengan karakteristik visual lokal jauh lebih murah dan efektif ketimbang memaksakan fine-tuning yang mahal.
Bila tim kamu tertarik memperdalam arsitektur model bahasa dan integrasi API modern, kamu bisa bergabung di kelas AI untuk Developer guna mempelajari alur kerja AI yang rapi dan siap produksi.
Kalau kamu butuh alternatif pengujian berbagai model LLM global tanpa pusing langganan kartu kredit luar negeri, kamu bisa memanfaatkan Classai Router. Cukup pakai satu API key yang kompatibel dengan SDK OpenAI maupun Anthropic, kamu bisa langsung mencoba model hemat seperti DeepSeek V4.1 Flash (input Rp1.155 / output Rp4.200 per 1M token) atau gpt-4o-mini (input Rp945 / output Rp3.750 per 1M token) dengan top up mudah via QRIS mulai Rp10.000.
Sumber & referensi
- 01
AWS · 27 Oktober 2026
Fix evaluation bias to unlock better models on Amazon Bedrock
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa yang dimaksud dengan circular evaluation pada model AI?
Circular evaluation terjadi saat dataset pengujian dilabeli memakai prediksi model lama, bukan diverifikasi oleh manusia. Akibatnya, model baru yang diuji akan dinilai berdasarkan kemiripannya dengan kebiasaan model lama, bukan berdasarkan kebenaran faktual data.
Mengapa klasifikasi multi-label lebih baik untuk analisis gambar properti?
Banyak foto properti menampilkan beberapa ruangan sekaligus, misalnya kamar tidur yang tampak jelas dari arah lorong. Format multi-label mencegah model disalahkan hanya karena mendeteksi ruangan sekunder yang memang nyata terlihat di gambar.
Berapa penghematan biaya yang didapat Property Finder di Amazon Bedrock?
Property Finder memangkas biaya pemrosesan gambar hingga 86 persen dengan estimasi ongkos $2,35 per 1.000 gambar. Waktu latensi inferensi sistem mereka juga sukses dipersingkat sekitar 40 hingga 60 persen.
Apa peran framework MIPROv2 dalam optimasi prompt?
MIPROv2 adalah modul optimasi prompt otomatis dari pustaka DSPy. Tool ini dipakai untuk menata ulang struktur instruksi klasifikasi foto secara otomatis sehingga mendongkrak skor Micro F1 model Llama 4 Maverick 17B Instruct hingga 0,76.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.