Prompt Caching Amazon Bedrock: Trik Hemat Biaya Agen AI sampai 64%
Agen AI sering terjebak siklus Groundhog Day karena membaca ulang riwayat dari nol di tiap langkah. Ini panduan arsitektur prompt caching di Amazon Bedrock.
· 9 menit baca
Inti singkat
- Agen AI mengalami pemborosan token karena harus memproses ulang seluruh instruksi dan riwayat di setiap giliran.
- Fitur prompt caching menyimpan status key-value (KV) selama fase prefill sehingga prompt statis tidak perlu dihitung ulang.
- Kombinasi explicit breakpoint dan implicit caching memangkas biaya input token model GPT-6 Astra hingga 64 persen.
- Prefix prompt minimal wajib mencapai 1.024 token dengan waktu aktif cache minimal 30 menit.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Amazon Web Services membagikan pola implementasi prompt caching Amazon Bedrock untuk menjalankan model OpenAI dengan biaya hingga 64% lebih murah. Solusi arsitektur ini memecahkan masalah klasik agen AI yang harus membaca ulang seluruh instruksi, definisi tool, dan riwayat obrolan dari nol di setiap langkah pemanggilan fungsi.
Kalau kamu pernah nonton film Groundhog Day, karakter yang diperankan Bill Murray terjebak mengulang hari 2 Februari yang sama terus-menerus selama puluhan tahun. Dia bangun di kamar yang sama, mendengar lagu radio yang sama, dan nggak ada perkembangan kemarin yang tersisa kecuali dia mengulang proses belajarnya dari awal.
Menurut penjelasan Claudio Mazzoni di blog resmi AWS, agen AI modern hidup dalam versi Groundhog Day mereka sendiri. Model bahasa nggak punya ingatan internal bawaan antar-request. Setiap kali agen memanggil tool, memeriksa hasil data, lalu memutuskan langkah berikutnya, kamu harus mengirim ulang seluruh riwayatnya ke model. Masuk ke langkah ke-20 dalam sesi coding, model bakal membaca ulang langkah 1 sampai 19. Ujung-ujungnya, kantong kamu yang jebol karena harus membayar token yang sama berulang-ulang.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa AI Agent Sering Terjebak Siklus "Groundhog Day"?
Biar paham kenapa biaya agen AI gampang membengkak, kita perlu membedah isi paket data yang dikirim aplikasi ke LLM (Large Language Model) pada putaran pertama:
- Daftar Tool: Definisi setiap fungsi yang bisa dipanggil agen. Bagian ini biasanya statis dan cuma berubah kalau kamu merilis versi baru aplikasi.
- Instruksi (System Prompt): Aturan main, kepribadian agen, batasan keamanan, dan contoh kasus yang disiapkan developer.
- History Percakapan: Rekaman semua interaksi yang sudah terjadi dalam sesi berjalan, mulai dari perintah awal user, riwayat pemanggilan tool oleh model, sampai hasil data yang dikembalikan.
- Turn Baru: Hasil eksekusi fungsi terbaru atau pesan lanjutan dari pengguna.
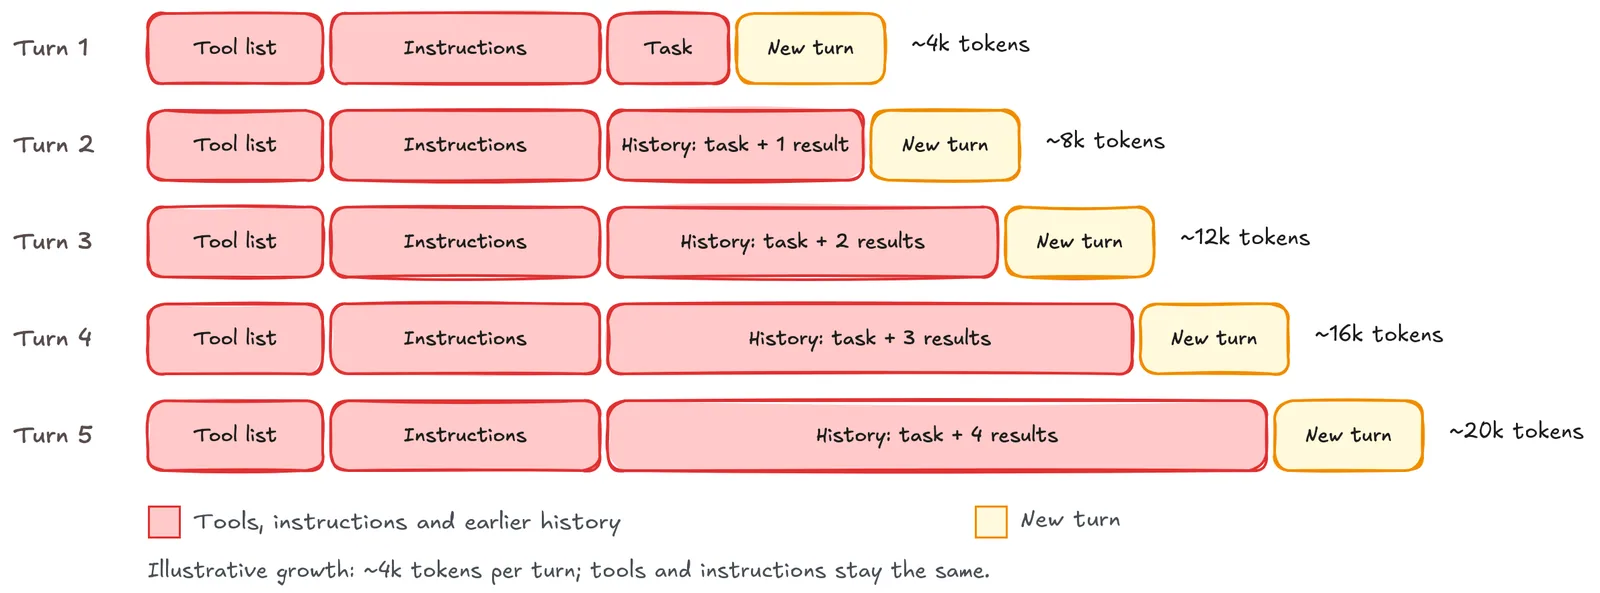
Tanpa mekanisme penyimpanan sementara, setiap giliran (turn) bakal mengirim ulang tumpukan teks yang makin lama makin panjang. Di giliran kelima atau keenam, 80 persen token yang kamu bayar sebenarnya cuma pengulangan dari instruksi yang nggak pernah berubah sama sekali.
Cara Kerja Prompt Caching di Bawah Kap Mesin
Saat LLM menerima prompt, langkah komputasi pertama yang dijalankan bernama tahap prefill. Pada fase ini, model memproses setiap input token dan membangun vektor key dan value (vektor KV). Vektor inilah yang membentuk memori kerja model sebelum menghasilkan token jawaban pertama.
Mekanisme prompt caching bertugas menyimpan status vektor KV tersebut. Status ini mencakup sistem prompt, skema tool, dan riwayat yang sudah dibaca. Ketika ada request baru yang diawali susunan token yang persis sama, layanan Bedrock langsung memuat memori yang sudah tersimpan alih-alih menghitung ulang dari nol. Model cuma perlu memproses teks baru yang berada di ujung prompt.
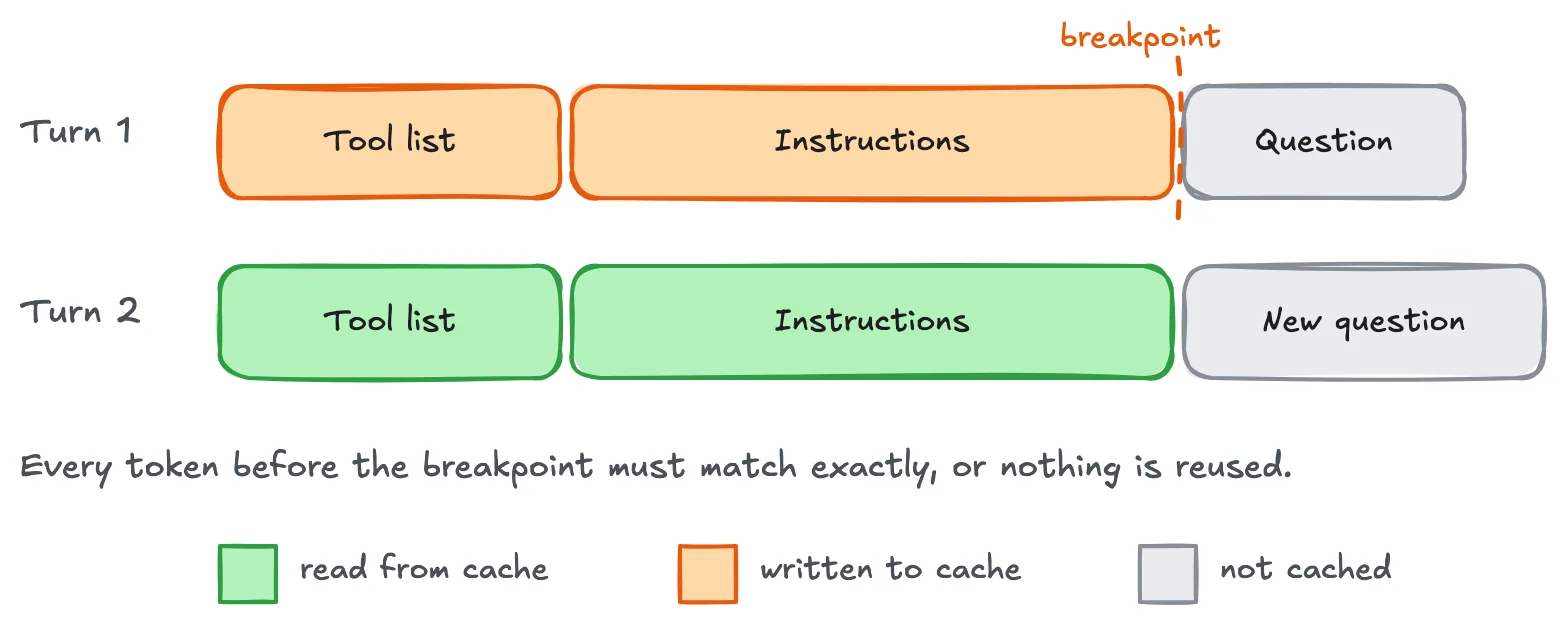
Prompt caching bekerja dengan syarat teks yang kamu kirim harus identik per karakternya. Format JSON, urutan spasi, dan penataan skema fungsi nggak boleh berubah sedikit pun. Kalau ada data dinamis seperti jam sistem atau ID transaksi acak di awal instruksi, cache langsung gagal dimanfaatkan (cache miss).
Memilih Jalur: Implicit vs Explicit Prompt Caching
Di Amazon Bedrock untuk model OpenAI (seperti GPT-6 Astra, GPT-6.1 Sol, dan GPT-5.6 Luna), ada dua cara kerja cache yang bisa kamu pakai:
- Explicit Caching: Kamu menentukan batas simpan secara manual menggunakan parameter
prompt_cache_breakpoint. Metode ini cocok banget buat mengunci bagian statis seperti daftar fungsi dan instruksi developer agar bisa dipakai ulang lintas sesi percakapan. - Implicit Caching: Bedrock secara otomatis memilih titik potong terbaik seiring bertambahnya percakapan. Cocok buat menangani riwayat obrolan yang terus memanjang dalam satu sesi.
Kamu bisa menggabungkan keduanya sekaligus. Pasang penanda eksplisit di akhir instruksi dasar, lalu biarkan mode implisit mengelola percakapan yang terus bertambah.
Berikut contoh konfigurasi awal menggunakan Python SDK:
KEY = "support-agent:v7:gpt-6-astra"
INSTRUCTIONS = "Kebijakan operasional support dan contoh penanganan..."

# Simpan bagian statis secara eksplisit
resp = client.responses.create(
    model="us.openai.gpt-6-astra",
    store=False,
    include=["reasoning.encrypted_content"],
    prompt_cache_key=KEY,
    prompt_cache_options={"mode": "explicit", "ttl": "30m"},
    tools=TOOLS,
    input=[
        {
            "role": "developer",
            "content": [{
                "type": "input_text",
                "text": INSTRUCTIONS,
                "prompt_cache_breakpoint": {"mode": "explicit"},
            }],
        },
        {"role": "user", "content": task},
    ],
)
Ukuran prefix yang mau disimpan harus mencapai minimal 1.024 token biar memenuhi syarat caching di Bedrock. Dalam pengujian AWS, prefix berisi instruksi dan tool sebesar 4.120 token berhasil ditulis sekali di turn pertama dan langsung dibaca ulang di semua turn berikutnya tanpa biaya komputasi penuh.
Trik Rolling Breakpoints untuk Riwayat Percakapan dan Eksekusi Tool
Ketika agen AI mulai mengeksekusi fungsi, aplikasi kamu bertugas menjalankan fungsinya secara lokal lalu mengembalikan hasilnya ke model. Setiap hasil fungsi baru ditambahkan ke daftar riwayat (history).
Kalau kamu pakai mode eksplisit murni untuk mengelola riwayat multi-turn, triknya adalah memakai metode rolling breakpoints. Setiap kali kamu menerima hasil fungsi baru, bungkus teks tersebut dalam blok input_text dan beri penanda breakpoint pada hasil terakhir. Ingat, jangan hapus breakpoint dari turn sebelumnya agar model tetap bisa mengenali titik simpan yang lama.
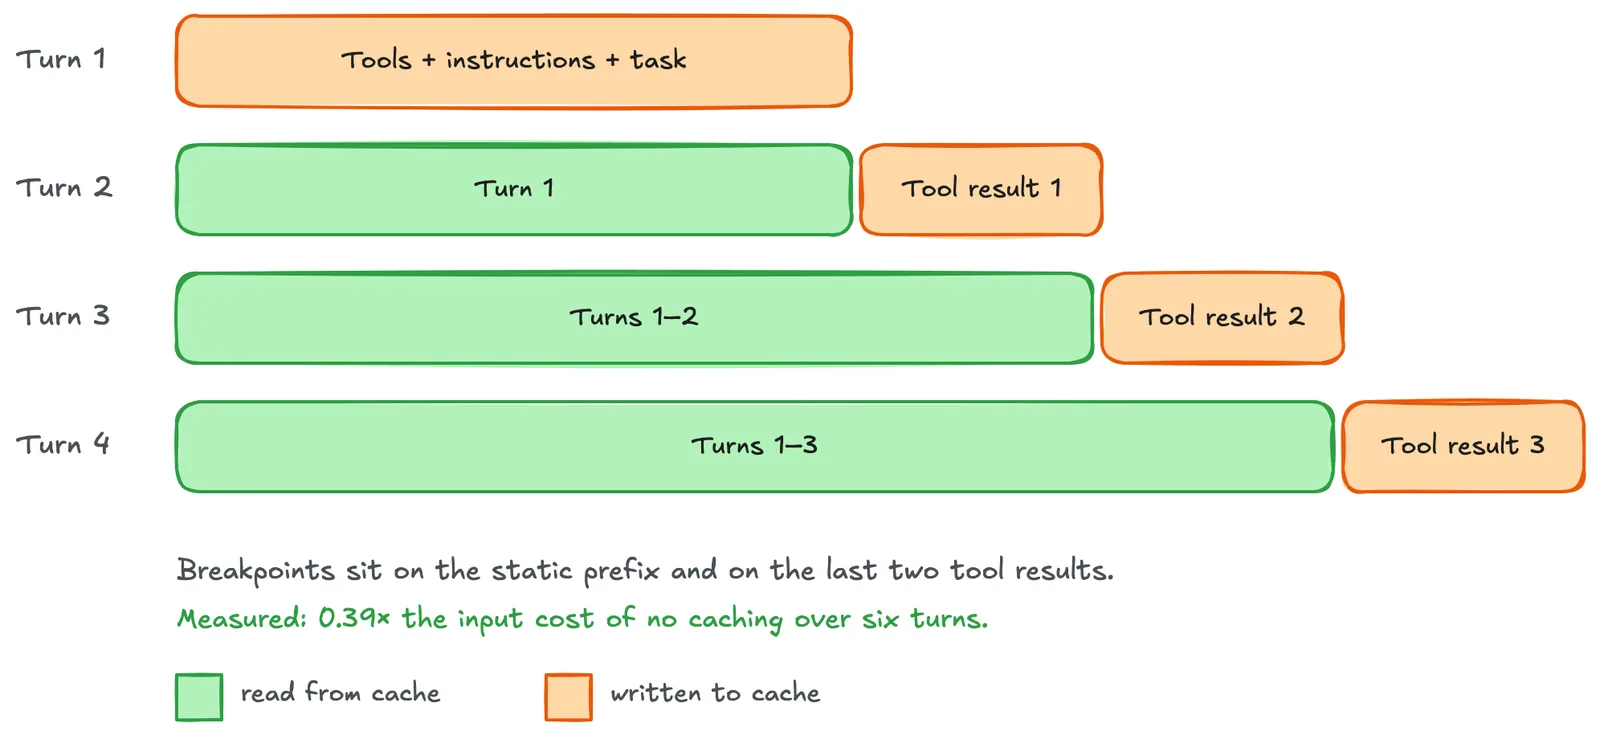
Dalam pengujian alur kerja enam giliran pada model GPT-6 Astra, mode implicit caching berhasil memangkas biaya input hingga 62 persen dibanding tanpa cache. Sementara itu, teknik explicit rolling breakpoints memberikan penghematan sekitar 61 persen.
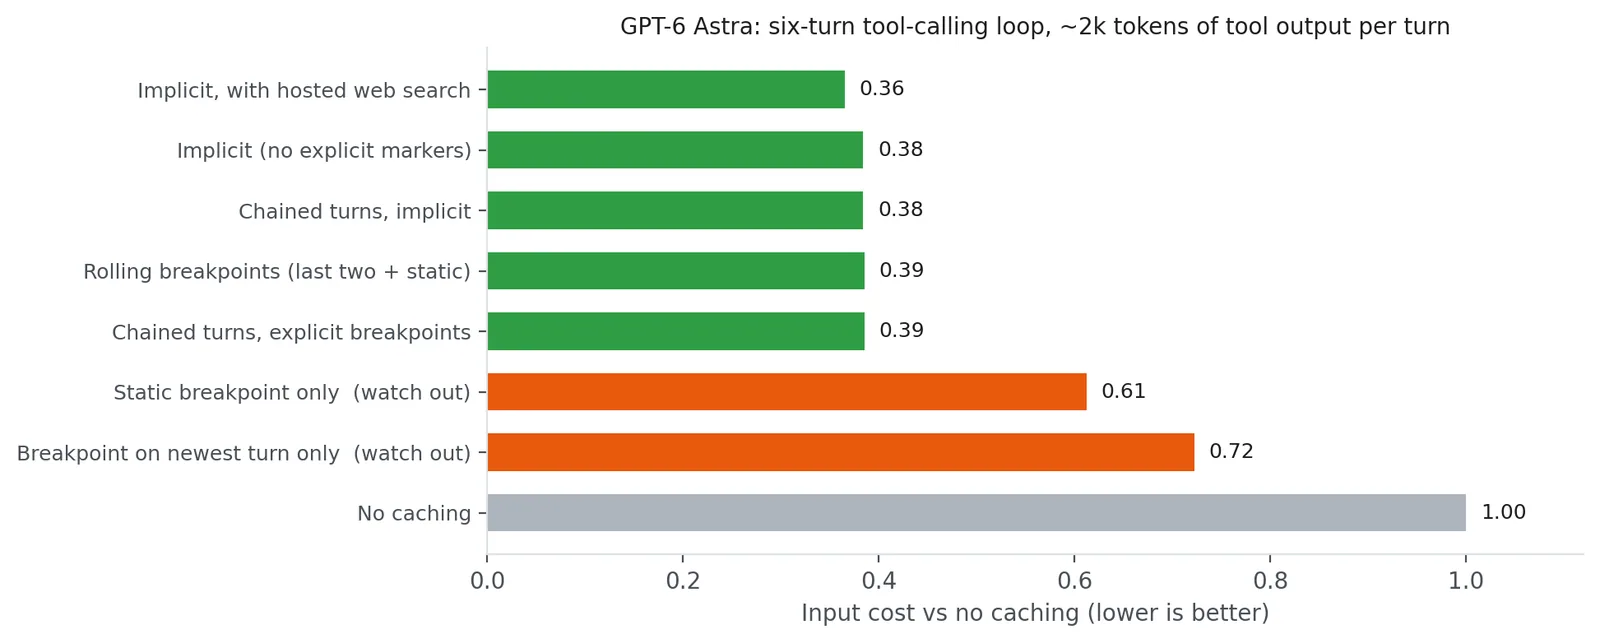
Berikut ringkasan perbandingan pendekatan caching berdasarkan data AWS:
| Pendekatan Caching | Penghematan Biaya Input (GPT-6 Astra) | Kelebihan Utama | Catatan Penting |
|---|---|---|---|
| Tanpa Caching | 0% (Biaya Penuh) | Setup paling sederhana | Token dibayar berulang-ulang di tiap turn |
| Explicit Statis Saja | ~39% (Skor 0.61 biaya) | Tool & instruksi aman tersimpan | Riwayat percakapan tetap dihitung penuh |
| Explicit Rolling Breakpoint | ~61% | Mengontrol persis apa yang disimpan | Struktur penanda di array payload lebih kompleks |
| Implicit Caching Penuh | ~62% | Otomatis mengikuti panjang chat | Kurang optimal jika tugas berikutnya berganti total |
| Kombinasi (Hybrid) | ~64% | Paling fleksibel untuk agen dinamis | Butuh disiplin menjaga konsistensi prefix awal |
Cara Menangani Perubahan Tool Tanpa Bikin Cache Batal
Salah satu kendala terbesar dalam arsitektur agen adalah ketika tool yang tersedia harus berubah di tengah jalan. Kalau kamu langsung mengedit atau mengubah urutan array TOOLS, seluruh cache yang dibuat di awal bakal langsung hangus.
Ada dua cara resmi yang direkomendasikan AWS untuk mengatasi masalah ini:
- Pakai
allowed_tools: Tetap kirim daftar skema tool awal yang lengkap dan terurut secara statis. Gunakan parametertool_choicedengan konfigurasiallowed_toolsuntuk membatasi fungsi mana saja yang boleh dipanggil model pada langkah tertentu. Pembatasan ini nggak merusak cache karena skema awal tetap utuh. - Gunakan
additional_tools: Endpoint Amazon Bedrock Runtime dan Mantle mendukung tipe inputadditional_toolsuntuk model GPT-6 Astra, GPT-6.1 Sol, dan GPT-5.6 Luna. Kamu bisa menyisipkan definisi fungsi baru di bagian bawah riwayat obrolan tanpa mengganggu prefix awal.
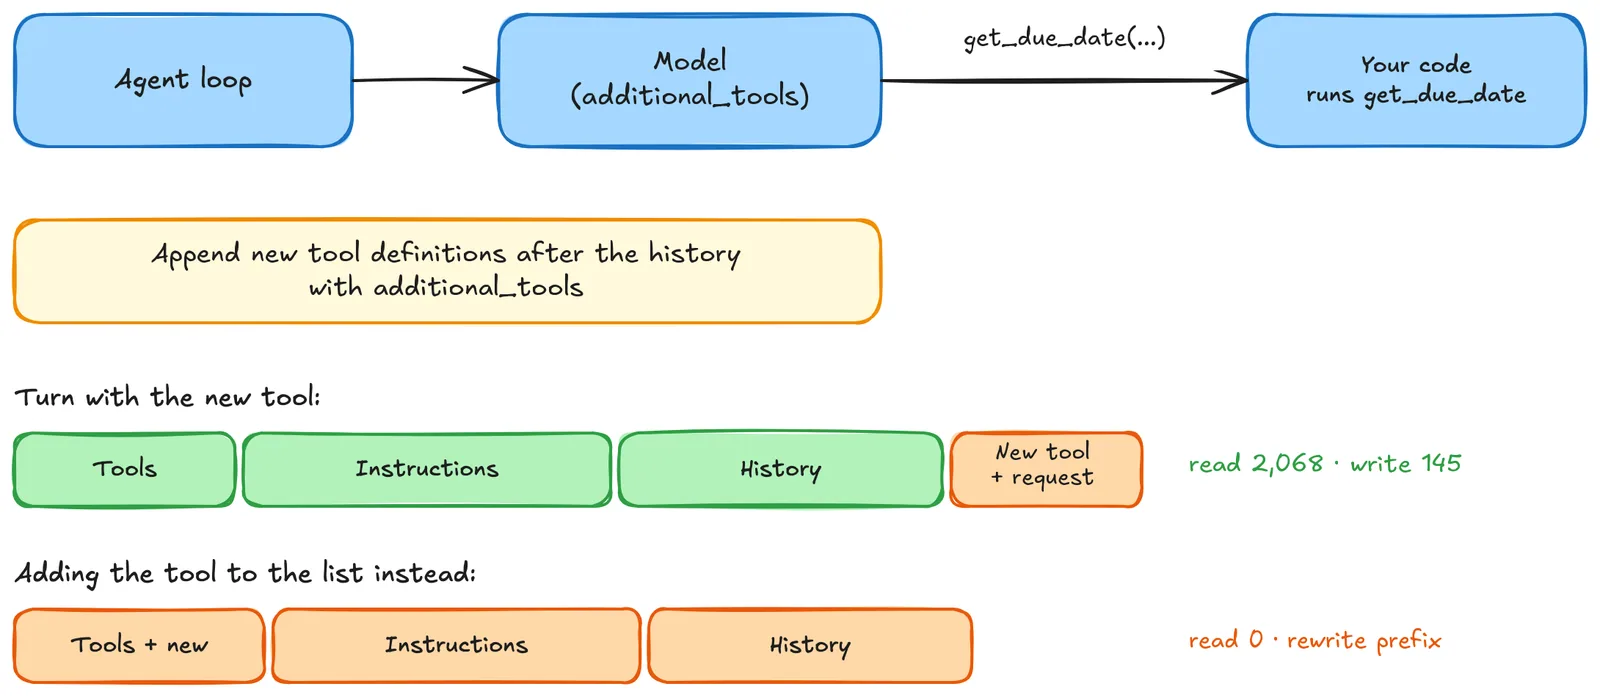
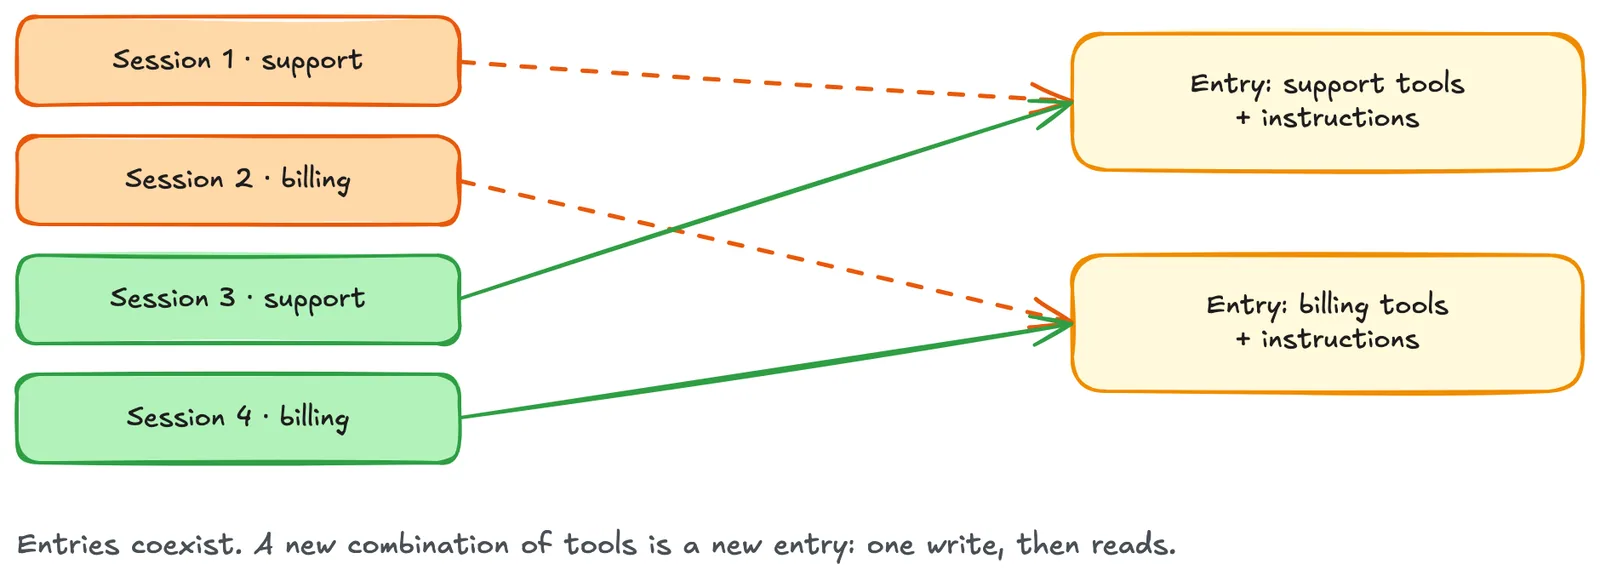
Untuk agen dengan peran berbeda, misalnya agen bagian teknis dan agen penagihan (billing), pisahkan katalog tool sejak awal sesi (cached tool profiles). Tiap profil punya prefix tersendiri yang bisa dipakai bersama oleh sesi sejenis.
Pola Subagent dan Side Calls: Hangatkan Sekali, Lalu Sebar
Ketika agen utama membagi tugas ke beberapa asisten pembantu (subagents atau helper), jangan biarkan setiap subagent membaca ulang latar belakang sistem dari awal secara mandiri. Terapkan pola warm once, then fan out.
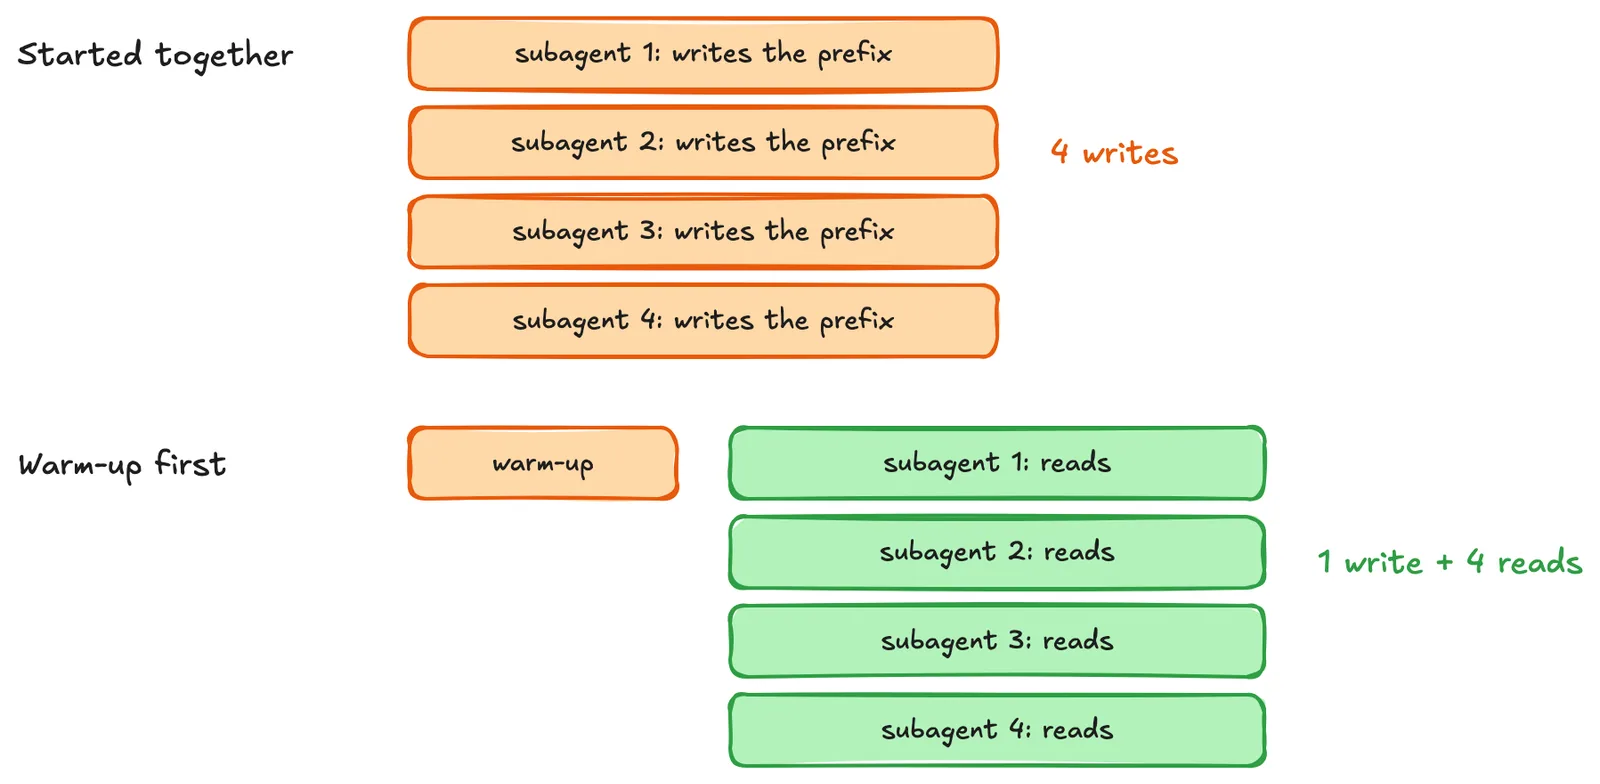
Kirimkan satu request pemanasan sederhana dengan output pendek (misalnya minta model membalas kata "READY") untuk memicu penulisan cache awal. Setelah token masuk ke cache, jalankan subagent secara paralel menggunakan ThreadPoolExecutor:
# Pastikan prefix sudah tersimpan sebelum panggil helper paralel
shared = {"role": "developer", "content": [{
    "type": "input_text", "text": INSTRUCTIONS,
    "prompt_cache_breakpoint": {"mode": "explicit"},
}]}

warm = client.responses.create(
    model="us.openai.gpt-6-astra",
    store=False,
    tools=TOOLS,
    prompt_cache_key=KEY,
    prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    max_output_tokens=16,
    input=[shared, {"role": "user", "content": "Reply READY."}],
)

# Jalankan subagent paralel setelah pemanasan selesai
helper_inputs = [[shared, {"role": "user", "content": task}] for task in helper_tasks]
with ThreadPoolExecutor(max_workers=4) as pool:
    helpers = list(pool.map(ask_with_implicit_cache, helper_inputs))
Pola yang sama berlaku untuk panggilan sampingan (side calls), seperti proses perangkuman (summarizer) atau evaluasi keamanan (judge). Cukup lakukan kloning data riwayat dengan deepcopy(history), lalu tambahkan instruksi ringkasan di paling akhir. Helper bakal membaca riwayat panjang dari cache dan cuma membayar token instruksi barunya.
Mengelola Cache Key, Waktu Kedaluwarsa (TTL), dan Monitoring di CloudWatch
Cache yang disimpan di Amazon Bedrock memiliki waktu aktif minimal (time-to-live atau TTL) selama 30 menit. Setiap kali cache tersebut berhasil dibaca ulang, masa aktifnya bakal diperpanjang otomatis.
Biar cache bisa dipakai lintas sesi pengguna, kelola prompt_cache_key secara hati-hati. Kalau kamu memakai kunci acak berbasis ID sesi, cache nggak akan pernah bisa dibagikan ke sesi pengguna lain. Buat kunci stabil berbasis hash teks instruksi:
import hashlib

def cache_key(app, model, prompt_version, instructions):
    digest = hashlib.sha256(instructions.encode()).hexdigest()[:12]
    return f"{app}:{prompt_version}:{model}:{digest}"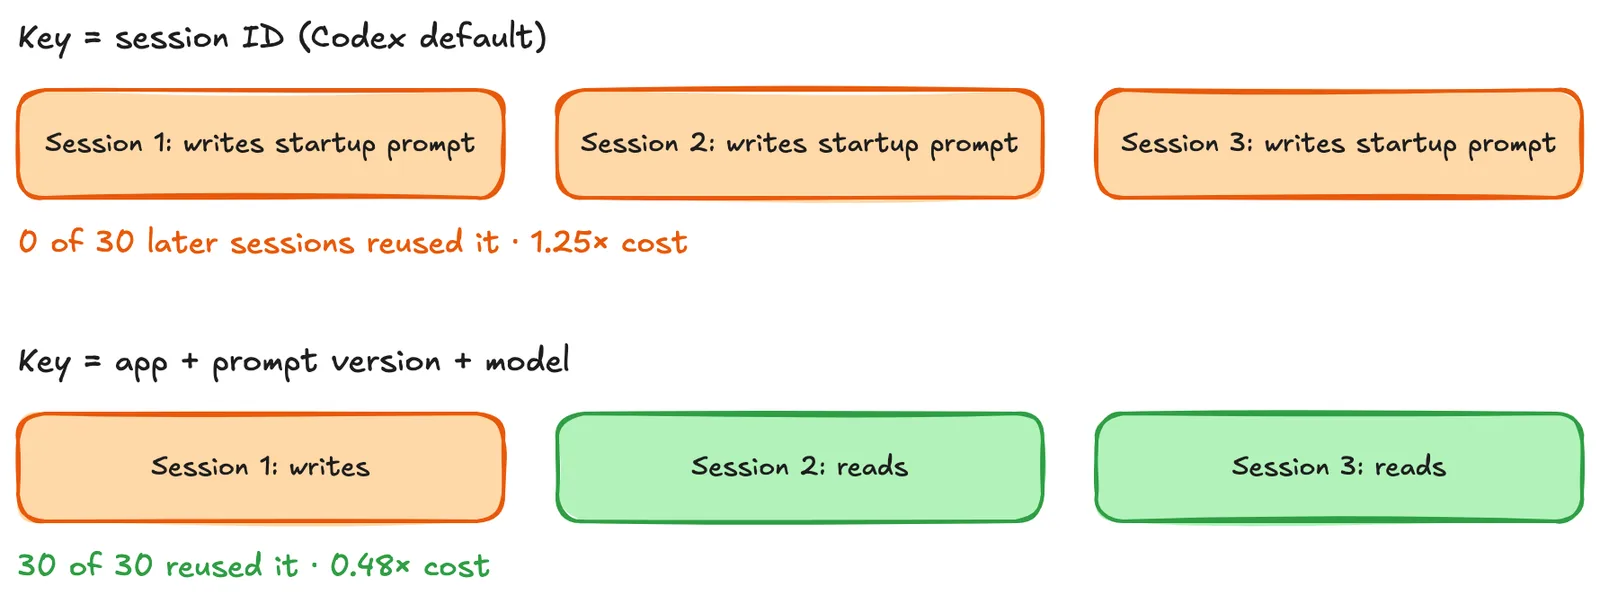
Untuk memantau apakah cache berjalan lancar di sistem production, pantau metrik berikut:
- Respons API: Periksa objek
resp.usage.input_tokens_detailsuntuk melihat angka pada kolomcached_tokens(token yang dibaca) dancache_write_tokens(token yang baru ditulis). - Amazon CloudWatch: Pada endpoint Amazon Bedrock Runtime, pantau metrik
CacheReadInputTokenCountdanCacheWriteInputTokenCount. - AWS Cost Explorer: Filter laporan berdasarkan Amazon Bedrock dan kelompokkan berdasarkan Usage type untuk melihat pemisahan biaya cache read, cache write, dan regular uncached input.
Berapa Penghematannya dan Efek Nyata Buat Developer Indonesia?
Dalam skenario agen pendukung pelanggan (support agent) yang diuji AWS, sistem berjalan dengan prefix awal sebesar 8.000 token dan melewati enam giliran obrolan yang masing-masing menambah 2.000 token baru.
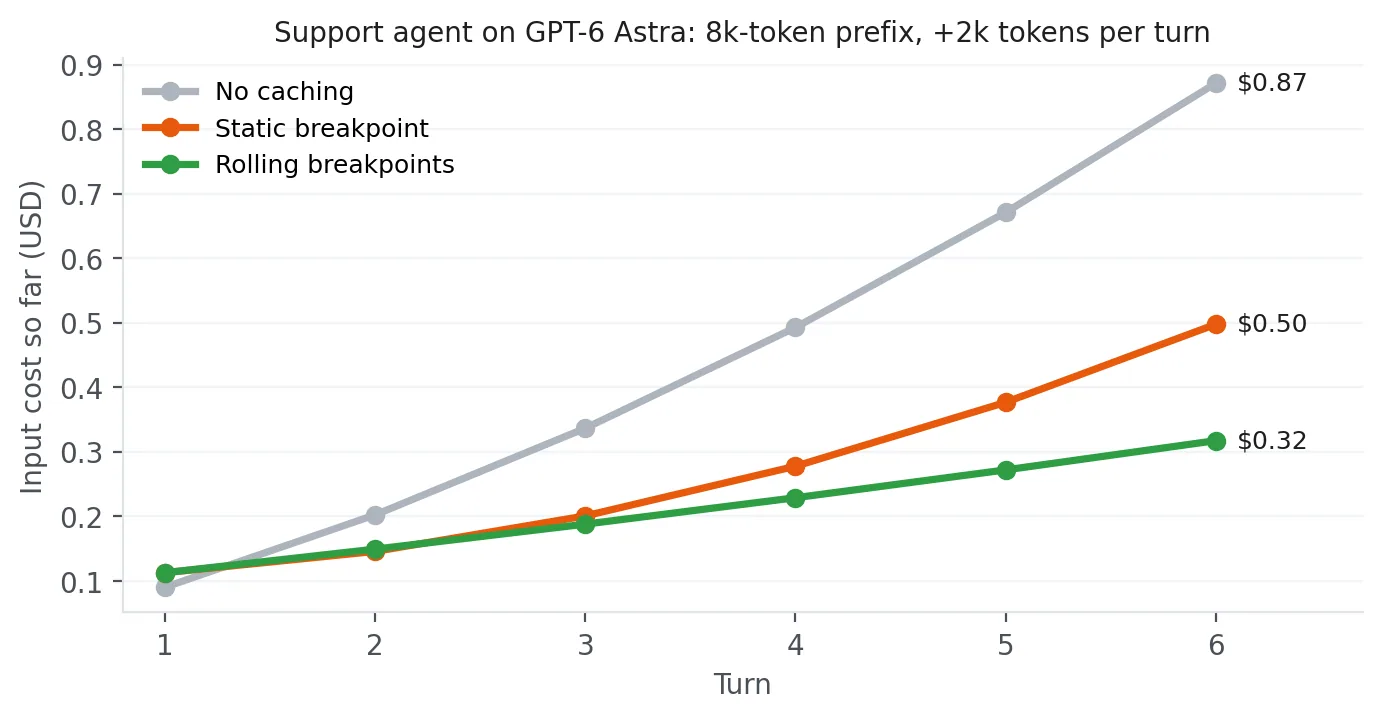
Tanpa caching, biaya input mencapai $0,87 per sesi. Dengan penerapan cache statis satu kali, biaya turun ke $0,50. Ketika dioptimalkan dengan teknik rolling breakpoints, biaya input terpangkas hingga 64% menjadi hanya $0,32 per sesi. Di samping penghematan biaya, latensi time-to-first-token (TTFT) juga turun drastis karena model nggak perlu membuang waktu memproses ribuan token awal.
Buat tim engineer dan startup di Indonesia yang lagi membangun aplikasi berbasis agen otonom, efisiensi ini krusial banget. Biaya API sering kali menjadi pos pengeluaran terbesar saat produk mulai kedatangan banyak pengguna aktif. Selain itu, kecepatan respons sangat menentukan retensi pengguna lokal yang sensitif terhadap aplikasi lambat.
Kalau kamu butuh menguji prompt atau bereksperimen dengan model frontier OpenAI tanpa pusing konfigurasi cloud yang rumit, kamu juga bisa menjajal berbagai model lewat Classai Router. Tersedia pilihan model seperti GPT-6 Astra (Rp9.720 / 1 juta token input dan Rp48.600 / 1 juta token output), GPT 6.1 Sol (Rp5.130 / 1 juta token input), atau GPT-5.6 Luna (Rp1.830 / 1 juta token input) yang langsung kompatibel dengan format SDK standar tanpa kartu kredit luar negeri.
Kamu juga bisa mendalami pembuatan arsitektur aplikasi AI end-to-end lewat kelas AI untuk Developer biar pemahaman integrasi sistemmu makin matang.
Kalau kamu ingin menyiapkan prompt sistem yang siap pakai dengan struktur optimal untuk prompt caching, gunakan template berikut:
[ROLE & OBJECTIVE]Kamu adalah asisten teknis cerdas yang bertugas memecahkan masalah integrasi API dan database sistem. [RULES & CONSTRAINTS]1. Analisis masalah langkah demi langkah sebelum memutuskan memanggil fungsi eksternal.2. Jangan pernah mengulang definisi parameter fungsi jika tidak diperlukan dalam konteks baru.3. Format jawaban akhir secara ringkas dan langsung ke solusi teknis. [AVAILABLE CAPABILITIES]- Menjalankan kueri data diagnostik- Memverifikasi status token otentikasi- Memperbarui tiket kendala sistem [USER REQUEST]Lanjutkan penanganan tiket berdasarkan riwayat interaksi sebelumnya tanpa mengulang pemeriksaan awal.
Dengan menjaga konsistensi susunan teks di atas batas 1.024 token dan memposisikan data dinamis di ujung pesan, agen AI kamu bakal terbebas dari siklus Groundhog Day yang boros anggaran.
Sumber & referensi
- 01
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa syarat minimal agar prompt caching bisa aktif di Amazon Bedrock?
Prefix prompt yang ingin disimpan harus memiliki panjang minimal 1.024 token dan teksnya harus sama persis tanpa perubahan karakter sedikit pun. Selain itu, model dan region AWS yang dipakai harus mendukung fitur ini.
Berapa lama masa aktif (TTL) prompt cache di Amazon Bedrock?
Masa aktif minimum cache adalah 30 menit terhitung sejak penulisan awal. Durasi ini akan diperpanjang secara otomatis setiap kali cache tersebut berhasil dibaca kembali oleh request yang cocok.
Apakah menulis ke cache dikenakan biaya tambahan?
Ya, biaya penulisan ke cache (cache write) bertarif 1,25 kali lipat dari harga input token normal. Namun, setiap pembacaan cache (cache read) setelahnya dikenakan tarif yang jauh lebih murah sehingga total biaya multi-turn tetap hemat.
Bagaimana cara menambahkan tool baru tanpa membatalkan cache yang ada?
Kamu bisa memanfaatkan fitur additional_tools pada endpoint Bedrock Runtime untuk menyisipkan skema tool baru di akhir riwayat percakapan tanpa mengubah daftar tool utama yang sudah tersimpan di cache.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.