SageMaker SDK v3 Fleet: Cara Kelola Ribuan Model Kamera Edge
Melatih satu model computer vision itu gampang, tapi gimana kalau pabrik butuh ribuan kamera edge? AWS bagikan panduan SageMaker SDK v3 fleet.
· 9 menit baca
Inti singkat
- SageMaker SDK v3 merombak arsitektur library menjadi paket modular dengan konfigurasi bertipe kuat.
- Pipeline dual-branch melatih convolutional autoencoder dan ResNet18 classifier secara terpisah untuk tiap kamera.
- Model Registry memakai metadata CameraId untuk mendukung proses warm-start training berkelanjutan.
- Kompilasi SageMaker Neo berjalan otomatis di dalam pipeline hanya setelah model lolos quality gate ONNX.
- Semafor atomic di DynamoDB membatasi konkurensi training maksimal lima eksekusi agar kuota AWS tetap aman.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
AWS merilis arsitektur referensi baru untuk mengelola siklus hidup ribuan model computer vision di perangkat edge menggunakan Amazon SageMaker Python SDK v3. Solusi ini menjawab tantangan berat di lantai pabrik ketika proof-of-concept satu kamera berhasil, tetapi langsung kedodoran saat harus dipasang pada puluhan lini produksi dengan kondisi optik yang berbeda-beda.
Bikin model computer vision buat satu kamera di meja lab emang kelihatan gampang. Masalah baru meledak pas pihak pabrik minta sistem inspeksi mutu visual itu dipasang di 40 lini produksi sekaligus. Di lapangan, tiap lini punya beberapa kamera, dan tiap kamera ngelihat dunia dengan cara yang beda banget. Ada kamera yang sudut pasangnya agak miring, ada yang kena pantulan silau dari pelat stainless steel, dan ada juga yang pencahayaannya berubah drastis tiap kali pintu gudang dibuka. Menggabungkan semua rekaman video jadi satu dataset terpusat terbukti bikin akurasi jeblok di banyak kamera. Ujung-ujungnya, tiap kamera butuh model yang di-fine-tune khusus buat dirinya sendiri. Menurut laporan teknis di AWS Machine Learning Blog, tantangan terbesarnya bukan lagi cara melatih satu model pintar, melainkan cara melatih, menguji, memberi versi, dan mengirim ribuan model ke perangkat edge tanpa bantuan manual manusia sama sekali.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa butuh arsitektur sagemaker sdk v3 fleet?
Arsitektur sagemaker sdk v3 fleet ini merupakan pembaruan dari pola MLOps visual inspection yang sempat dikenalkan AWS pada 2023. Di versi terbaru ini, AWS mengganti Amazon SageMaker Edge Manager yang sudah deprecated dengan dokumentasi SageMaker Neo untuk optimasi model langsung ke perangkat edge.
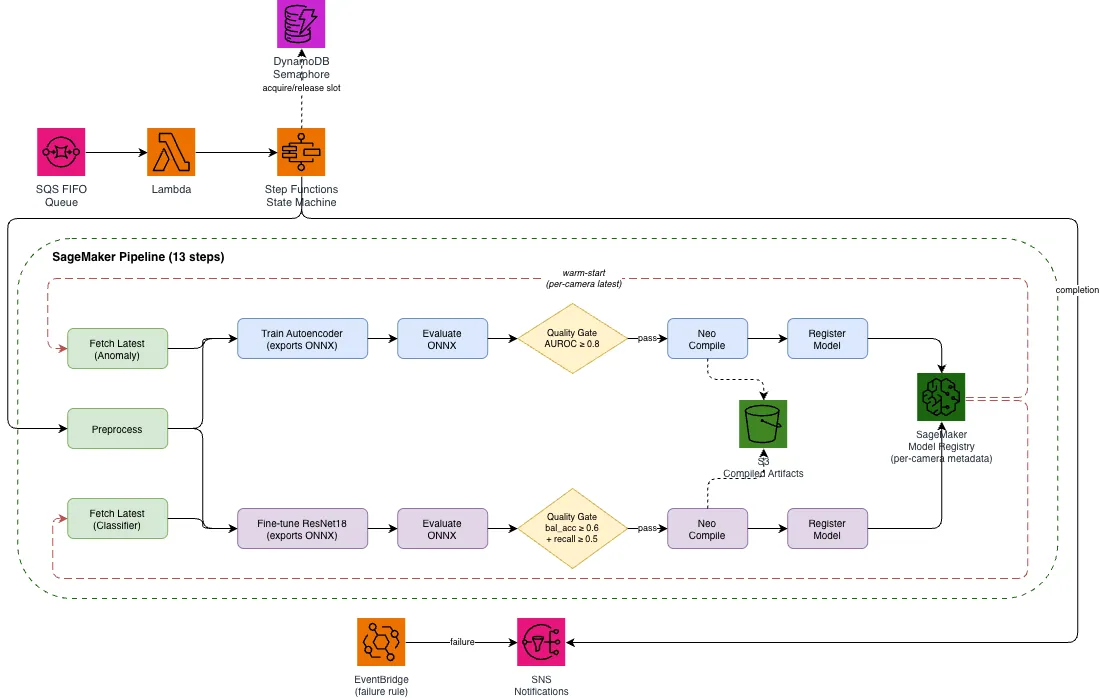
Sistem ini memisahkan tugas jadi dua pilar utama: layer orkestrasi armada kamera dan pipeline training mandiri yang diparameterisasi per kamera. Semua komponen infrastruktur dideploy menggunakan AWS Cloud Development Kit (AWS CDK). Satu siklus penuh pipeline pada data sintetis cuma makan biaya komputasi sekitar $0.07 (berdasarkan pengujian instance ml.m5.xlarge di Region US East Ohio).
Perubahan besar di Amazon SageMaker Python SDK v3
Bagi engineer yang biasa pakai SDK v2, pembaruan ke SDK v3 membawa perubahan struktur yang lumayan drastis. Amazon SageMaker Python SDK v3 memecah library monolitik lama menjadi paket-paket modular terpisah, seperti sagemaker-core, sagemaker-train, sagemaker-serve, dan sagemaker-mlops. Saat memasang dependensi sagemaker>=3.0.0,<4, kamu bakal langsung mengunduh modul-modul ini secara terpisah.
Konfigurasi training yang tadinya dijejalkan ke argumen konstruktor kelas Estimator kini dipindah ke objek konfigurasi bertipe (typed config objects). Objek ini kemudian dimasukkan ke dalam kelas ModelTrainer. Bentuk kodenya jadi jauh lebih terstruktur dan minim typo:
from sagemaker.train import ModelTrainer
from sagemaker.train.configs import InputData, Compute, OutputDataConfig
from sagemaker.core.training.configs import MetricDefinition

anomalib_trainer = ModelTrainer(
    training_image=custom_training_image_uri,
    compute=Compute(
        instance_type=training_instance_type.to_string(),
        instance_count=1,
    ),
    base_job_name="cv-pipeline-anomalib-train",
    sagemaker_session=pipeline_session,
    role=role_arn,
    hyperparameters={
        "program": "train_anomalib.py",
        "model_name": "autoencoder",
        "image_size": "256",
        "num_epochs": "3",
        "batch_size": "16",
        "learning_rate": "0.001",
    },
    input_data_config=anomalib_input_data,
    output_data_config=OutputDataConfig(
        s3_output_path=run_prefix("anomalib-training")
    ),
).with_metric_definitions([
    MetricDefinition(
        name="image_auroc",
        regex=r"validation:image_auroc=([0-9]*\.?[0-9]+)",
    ),
])
Ada dua perilaku penting di SDK v3 yang nggak tertulis gamblang sebagai breaking changes tapi bisa bikin pusing kalau kamu mendeploy pipeline lewat CDK:
- Validasi live IAM pas sintesis: SDK v3 langsung memvalidasi execution role ke AWS IAM saat kode CDK disintesis, bukan pas pipeline dijalankan. Kalau role belum dibuat di cloud, sintesis bakal langsung gagal. Solusinya, deployment dibuat dua tahap: jalankan deploy pertama dengan context flag
-c bootstrap=trueuntuk membuat role, S3 bucket, dan repository ECR, baru jalankan deploy kedua untuk menyusun pipeline. - Simulasi izin ECR pull: Validator role di SDK v3 mengecek izin pull ECR tanpa resource ARN spesifik. Kalau execution role kamu dibatasi hanya ke satu repo ECR tertentu, validator bakal menganggap role itu kurang izin. Makanya role butuh izin ECR yang sedikit lebih longgar.
Selain itu, praktik terbaik di SDK v3 adalah menginisialisasi pipeline memakai PipelineSession(default_bucket=your_bucket). Langkah ini memastikan semua upload kode dan artefak masuk ke bucket milik pipeline itu sendiri, sehingga izin akses S3 tetap rapi dan terpusat.
Kalau kamu tertarik mendalami manajemen deployment infrastruktur cloud otomatis semacam ini, kamu juga bisa membaca artikel kami tentang /developer/auto-scaling-sagemaker-cdk-update-endpoint.
Cara kerja pipeline dual-branch per kamera
Pipeline training di sistem ini terdiri dari 13 langkah yang dijalankan per eksekusi kamera. Alur kerjanya dimulai dari tiga langkah paralel: pemrosesan data (Preprocess), pengambilan model anomali terakhir yang approved (Fetch Latest Anomaly), dan pengambilan model klasifikasi terakhir (Fetch Latest Classifier).
Setelah data siap, pipeline melatih dua cabang model secara terpisah:
- Cabang Detektor Anomali: Menggunakan convolutional autoencoder berukuran kecil. Model ini dilatih khusus mengenali bentuk produk normal. Kalau ada bagian produk yang rusak atau asing, autoencoder bakal kesulitan merekonstruksi gambar itu, dan anomali langsung terdeteksi dari tingginya reconstruction error.
- Cabang Klasifikasi Cacat: Memakai arsitektur ResNet18 dengan bobot awal ImageNet yang di-fine-tune untuk memastikan jenis kecacatan produk.
Di dunia manufaktur nyata, data cacat biasanya sangat langka—sekitar 90% produk dalam kondisi mulus dan cuma 10% yang cacat. Kalau dilatih sembarangan, model klasifikasi bakal malas dan selalu menebak produk berstatus normal. Untuk mencegah hal itu, cabang klasifikasi menyeimbangkan batch training memakai WeightedRandomSampler dengan frekuensi kelas terbalik (inverse class frequencies), sementara loss function dibiarkan unweighted agar model tidak condong berlebihan ke kelas minoritas.
Quality gates: jangan pernah kirim model rusak ke edge
Sebelum model didaftarkan ke registri, model wajib melewati gerbang kualitas (quality gates). Kerennya, pengujian ini dilakukan langsung pada artefak ekspor ONNX menggunakan ONNX Runtime, bukan pada model PyTorch di memory GPU. Prinsipnya tegas: apa yang kamu uji harus sama persis dengan file biner yang bakal dikirim ke perangkat edge, sehingga bug akibat konversi ekspor nggak bakal lolos ke pabrik.
Cabang anomali mewajibkan skor AUROC minimal 0.8. Sedangkan untuk cabang klasifikasi, metrik akurasi biasa sama sekali nggak dipakai karena bisa menipu. Model yang menebak semua produk "bagus" tetap bisa meraih akurasi 90% padahal gagal menangkap cacat sama sekali. AWS memasang dua metrik wajib sekaligus lewat ConditionStep:
step_check_classifier = ConditionStep(
    name="CheckClassifierQuality",
    conditions=[
        ConditionGreaterThanOrEqualTo(
            left=JsonGet(
                step_name=step_eval_classifier.name,
                property_file="evaluation",
                json_path="balanced_accuracy",
            ),
            right=min_accuracy,  # minimal 0.6
        ),
        ConditionGreaterThanOrEqualTo(
            left=JsonGet(
                step_name=step_eval_classifier.name,
                property_file="evaluation",
                json_path="defect_recall",
            ),
            right=min_defect_recall,  # minimal 0.5
        ),
    ],
    if_steps=[step_compile_classifier, step_register_classifier],
    else_steps=[step_fail_classifier],
    depends_on=[step_eval_classifier],
)
Kedua syarat di atas harus lolos berbarengan. Kalau salah satu gagal, eksekusi cabang itu dinyatakan fail dan model nggak bakal masuk ke registri. Sementara itu, perangkat kamera di lini produksi bakal tetap menjalankan model approved versi terdahulu yang terbukti stabil.
Kompilasi edge dengan SageMaker Neo langsung di pipeline
Begitu model lolos dari gerbang kualitas, langkah berikutnya bukan registrasi, melainkan kompilasi edge memakai SageMaker Neo. Hal ini dilakukan supaya Model Registry nggak menyimpan model yang gagal dijalankan di chipset kamera.
Langkah kompilasi ini menangani tiga masalah teknis yang sering memicu error:
- Pembersihan tarball: SageMaker Neo mewajibkan input tarball cuma berisi file model, padahal proses training SageMaker biasanya menghasilkan file
model.tar.gzyang bercampur dengan file checkpoint dan metrik. Pipeline otomatis mengemas ulang tarball khusus ONNX terlebih dahulu. - Ukuran batch statis: Ekspor ONNX biasanya memakai sumbu batch dinamis, sementara Neo menuntut ukuran input yang konkret. Langkah ini secara eksplisit mengunci ukuran batch ke angka 1.
- Penamaan job deterministik: Karena langkah pipeline bisa mengalami retry otomatis kalau ada kendala jaringan, nama job kompilasi Neo diturunkan langsung dari execution ID pipeline. Saat retry terjadi, sistem bakal melanjutkan polling pada job yang sudah ada daripada membuat job ganda.
| Artefak & Target | Format File | Peran dalam Sistem | Engine Runtime |
|---|---|---|---|
| Artefak ONNX | .onnx | Format portabel hasil ekspor training | ONNX Runtime |
| Output SageMaker Neo | compiled.so (shared library) | Biner teroptimasi khusus chip edge | DLR runtime |
| Default Target Platform | LINUX/X86_64 | Pengujian awal pada PC industri standar | DLR Engine |
| Target Perangkat Khusus | jetson_xavier, rasp4b | Kompilasi khusus akselerator edge | DLR Engine |
Pengelolaan model per kamera di Model Registry
Menyimpan ribuan model untuk ribuan kamera nggak berarti kamu harus bikin ribuan grup registri terpisah. Solusi ini hanya memakai dua grup bersama, salah satunya sm1k-classifier-model-group.
Setiap kali model didaftarkan lewat ModelBuilder, identitas kamera ditempelkan ke properti metadata:
step_register_classifier = ModelStep(
    name="RegisterClassifierModel",
    depends_on=[step_compile_classifier],
    step_args=classifier_model_builder.register(
        model_package_group_name="sm1k-classifier-model-group",
        approval_status="Approved",
        model_metrics=classifier_metrics,
        customer_metadata_properties={"CameraId": camera_id},
    ),
)
Karena API ListModelPackages belum mendukung penyaringan metadata dari sisi server, langkah fetch awal bakal membaca paket approved dari yang paling baru sampai menemukan paket dengan CameraId yang cocok. Kalau kamera baru pertama kali dipasang dan belum punya model approved, sistem otomatis beralih ke inisialisasi cold-start (bobot ImageNet untuk classifier atau inisialisasi acak untuk autoencoder). Pola ini bikin proses training ulang berjalan hemat dan cepat karena selalu melanjutkan bobot terakhir milik kamera itu sendiri (warm-start).
Orkestrasi antrean fleet pakai semafor DynamoDB
Setiap akun AWS memiliki batas kuota bersamaan (concurrent service quotas) untuk training job SageMaker. Kalau tiba-tiba 500 kamera mengirimkan sinyal minta dilatih ulang secara bersamaan, akun cloud kamu pasti langsung terkunci karena menabrak batas kuota.
Untuk mengendalikan laju eksekusi armada kamera, arsitektur ini memanfaatkan semafor di Amazon DynamoDB yang diatur oleh AWS Step Functions:
acquire_semaphore = tasks.DynamoUpdateItem(
    self, "AcquireSemaphore",
    table=semaphore_table,
    key={"LockName": tasks.DynamoAttributeValue.from_string("pipeline-concurrency")},
    update_expression="SET ActiveCount = if_not_exists(ActiveCount, :zero) + :one",
    condition_expression="attribute_not_exists(ActiveCount) OR ActiveCount < :limit",
)
Mekanisme atomic update pada tabel DynamoDB memastikan kuota dihitung presisi tanpa ada celah perebutan giliran (race conditions). Secara default, kuota dibatasi maksimal lima eksekusi berjalan berbarengan. Kalau slot penuh, request bakal antre di Amazon SQS FIFO dan Step Functions bakal mencoba lagi nanti secara berkala. Ketika pipeline selesai atau mengalami kegagalan, slot langsung dikembalikan ke tabel.
Langkah mencoba di lingkungan lokal
Untuk mencoba arsitektur ini, kamu bisa langsung clone kode sumber dari aws-samples GitHub repository. Repositori tersebut juga menyertakan skrip untuk mengunduh BCCD dataset, yaitu kumpulan citra mikroskop sel darah berlisensi MIT yang dipakai sebagai analogi pendeteksi cacat sel.
Berikut langkah-langkah praktisnya:
- Siapkan virtual environment Python (versi 3.10, 3.11, atau 3.12) dan pasang dependensi dari repositori aws-samples.
- Pastikan AWS CDK CLI sudah terpasang dengan versi minimal 2.1131.0, lalu jalankan
cdk bootstrapdi akun AWS kamu. - Jalankan sintesis dan deploy tahap awal untuk membuat resource IAM role, S3 bucket, dan Amazon ECR:
bash cdk deploy SageMakerCVPipelineStack -c bootstrap=true - Jalankan deploy penuh untuk memasang seluruh pipeline dan layer orkestrasi Step Functions, lalu build container training:
bash cdk deploy --all ./scripts/push_ecr_image.sh
Secara default, pipeline bakal menghasilkan data gambar sintetis otomatis, jadi kamu bisa memvalidasi 13 langkah pipeline tanpa perlu repot menyiapkan dataset manual.
Kalau kamu sedang mengembangkan automasi cloud atau integrasi skrip AI semacam ini dan butuh bantuan model penalaran buat debugging kode, kamu bisa memanfaatkan model seperti DeepSeek V4.1 Flash (Rp1.155 / Rp4.200 per 1M token) atau Kimi K3 (Rp2.925 / Rp14.580 per 1M token) lewat Classai Router.
Dampak nyata untuk industri dan developer di Indonesia
Penerapan computer vision berskala armada kamera ini punya potensi besar buat sektor industri di Indonesia, mulai dari manufaktur tekstil, perakitan elektronik, pengemasan makanan, hingga pemantauan buah di perkebunan kelapa sawit. Kendala utama operasional AI visual di pabrik-pabrik Indonesia biasanya berkisar pada biaya bandwidth internet yang mahal dan koneksi yang fluktuatif.
Dengan mengompilasi model memakai SageMaker Neo dan menjalankannya langsung di perangkat lokal lewat DLR runtime, pemrosesan citra dilakukan 100% di lokasi tanpa perlu streaming video beresolusi tinggi ke server cloud. Selain menghemat biaya jaringan, latensi deteksi cacat jadi instan dalam hitungan milidetik. Data visual sensitif dari lini produksi pabrik juga tetap aman tersimpan di jaringan lokal, sejalan dengan prinsip perlindungan data operasional industri.
Sumber & referensi
- 01
AWS · 27 Oktober 2026
Fleet-wide computer vision lifecycle at the edge with SageMaker SDK v3
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa keunggulan Amazon SageMaker Python SDK v3 dibanding SDK v2?
SageMaker SDK v3 merombak struktur library menjadi modular terpisah seperti sagemaker-core, sagemaker-train, dan sagemaker-mlops. Pengaturan training yang dulunya menumpuk di konstruktor Estimator kini diubah menjadi objek konfigurasi bertipe kuat sehingga mengurangi risiko salah ketik dan memudahkan pemeliharaan kode infrastruktur.
Kenapa evaluasi quality gate harus dilakukan pada file ONNX?
Pengujian langsung pada file ekspor ONNX memastikan artefak yang diuji identik dengan artefak biner yang bakal dikirim ke perangkat edge. Jika terjadi kerusakan bobot atau bug saat proses ekspor dari PyTorch, model tersebut bakal langsung ditolak sebelum mencapai tahap pendaftaran registri.
Bagaimana cara sistem membedakan ribuan model kamera di registri?
Model dari seluruh armada disimpan dalam Model Package Group bersama dengan menyertakan properti metadata CameraId. Ketika jadwal training ulang kamera tertentu dijalankan, sistem membaca paket approved terbaru milik ID kamera tersebut agar pelatihan baru bisa melanjutkan bobot historis sebelumnya.
Berapa biaya komputasi untuk menjalankan pipeline ini?
Satu siklus eksekusi penuh berisi 13 langkah pada data sintetis membutuhkan biaya komputasi sekitar $0.07 menggunakan instance ml.m5.xlarge. Sumber daya orkestrasi seperti AWS Step Functions dan DynamoDB memakan biaya kurang dari $0.10 per bulan untuk skala sampel pengujian.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.