Dharma Field Extractor Rilis: Ubah Dokumen Apa Pun Jadi JSON
Model mungil 2B dari Dharma-AI ini sukses kalahkan LLM frontier buat urusan ekstraksi dokumen ke JSON, dengan biaya operasional jauh lebih miring.
· 11 menit baca
Inti singkat
- Dharma Field Extractor berukuran 2 miliar parameter mampu mengubah gambar dokumen langsung jadi data JSON berformat rapi.
- Model ini mencatat skor F1 0,834 pada benchmark 1.638 pengujian, melampaui Claude Opus 5 dan jajaran GPT-5.6.
- Mendukung dua mode ekstraksi: mode open tanpa schema dan mode schema-directed dengan struktur tipe data ketat.
- Biaya operasional self-hosted di satu GPU L40S tercatat 6 hingga 147 kali lebih murah dibanding API frontier komersial.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Dharma Field Extractor resmi dirilis sebagai model spesialis 2 miliar parameter (2B) yang mampu mengekstrak dokumen apa saja langsung menjadi format JSON terstruktur. Model bikinan Dharma-AI ini membuktikan kalau model kecil yang dilatih khusus buat satu tugas bisa ngalahin LLM raksasa sekelas Claude Opus 5 maupun GPT-5.6 Luna dengan biaya operasional yang jauh lebih murah.
Kabar gembira buat para software engineer dan tim data ini diumumkan lewat blog resmi Dharma-AI di Hugging Face. Masalah klasik di dunia kerja selama ini emang bikin pusing: dokumen transaksi numpuk di meja atau inbox, tapi sistem database kamu butuh input data yang rapi dan terstruktur.
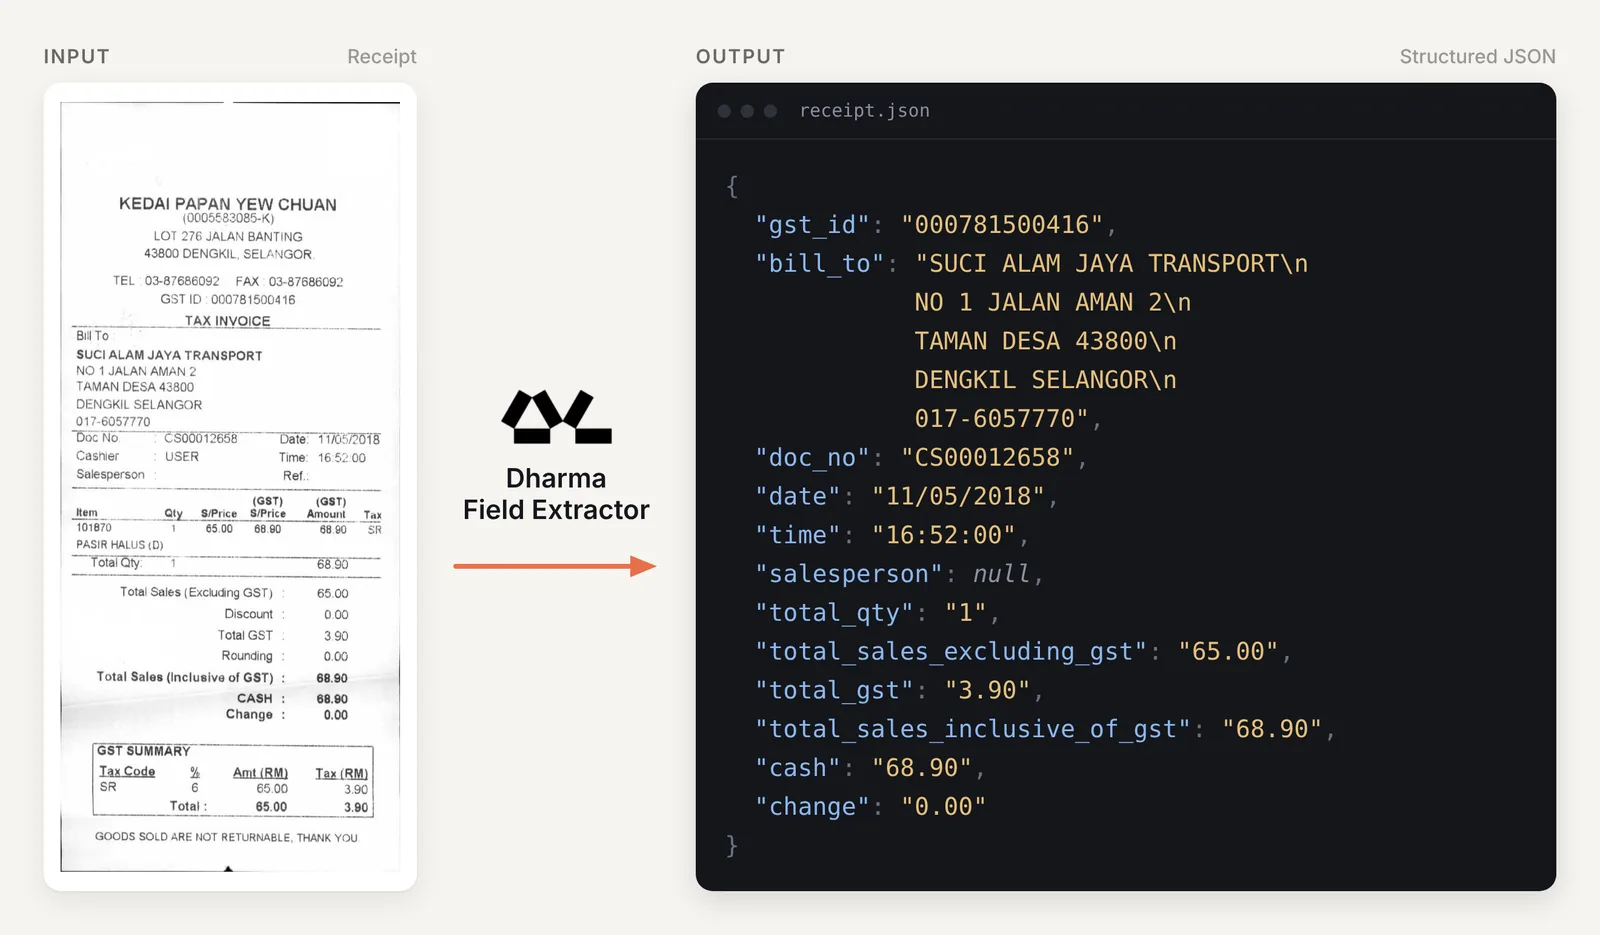
Selama ini, kita sering terjebak di antara dua pilihan yang sama-sama bikin repot. Pakai OCR biasa cuma ngasih tumpukan teks mentah tanpa struktur, sementara pakai model frontier via API biayanya luar biasa boros kalau volumenya ribuan lembar sehari. Nah, kehadiran Dharma Field Extractor datang buat beresin masalah itu tepat di titik tengahnya.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa OCR Biasa dan LLM Frontier Masih Bikin Repot?
Sebelum masuk ke jeroan teknisnya, kita perlu paham dulu kenapa solusi yang ada sekarang sering mentok. Di bulan April sebelumnya, tim Dharma sempat ngerilis model bernama DharmaOCR-LITE yang fokus ngebaca teks pada dokumen secara presisi. Dasar risetnya udah dipublikasikan lewat paper arXiv mereka.
OCR konvensional emang jago nyalin kata per kata persis tata letak aslinya di atas kertas. Hasil kayak gitu cocok banget kalau kebutuhan kamu cuma digitalisasi buku lama atau ngebaca kontrak dari awal sampai akhir. Tapi masalahnya, di dunia operasional kantor, kamu biasanya nggak butuh seluruh teks di kertas itu.
Coba bayangin kamu dapet tumpukan invoice vendor tiap pagi. Yang kamu butuhin buat masuk ke database cuma empat hal: nama vendor, nomor invoice, tanggal jatuh tempo, dan nominal total. Kalau kamu lempar ke mesin OCR biasa, kamu cuma dapet untaian teks panjang sebaris demi sebaris. Ujung-ujungnya developer harus nulis script regex atau aturan parsing manual yang gampang banget rusak tiap kali vendor ganti template dokumen.
Banyak tim akhirnya beralih manggil API LLM frontier. Model umum ini emang pintar memahami konteks lewat prompting rapi. Tapi kalau dipakai buat ratusan ribu halaman dokumen transaksi harian, tagihan API bakal langsung boncos gara-gara biaya token input gambar plus reasoning token yang mahal. Belum lagi latensi jaringannya yang bikin antrean sistem makin panjang.
Cara Kerja Dharma Field Extractor: Open vs Schema-Directed
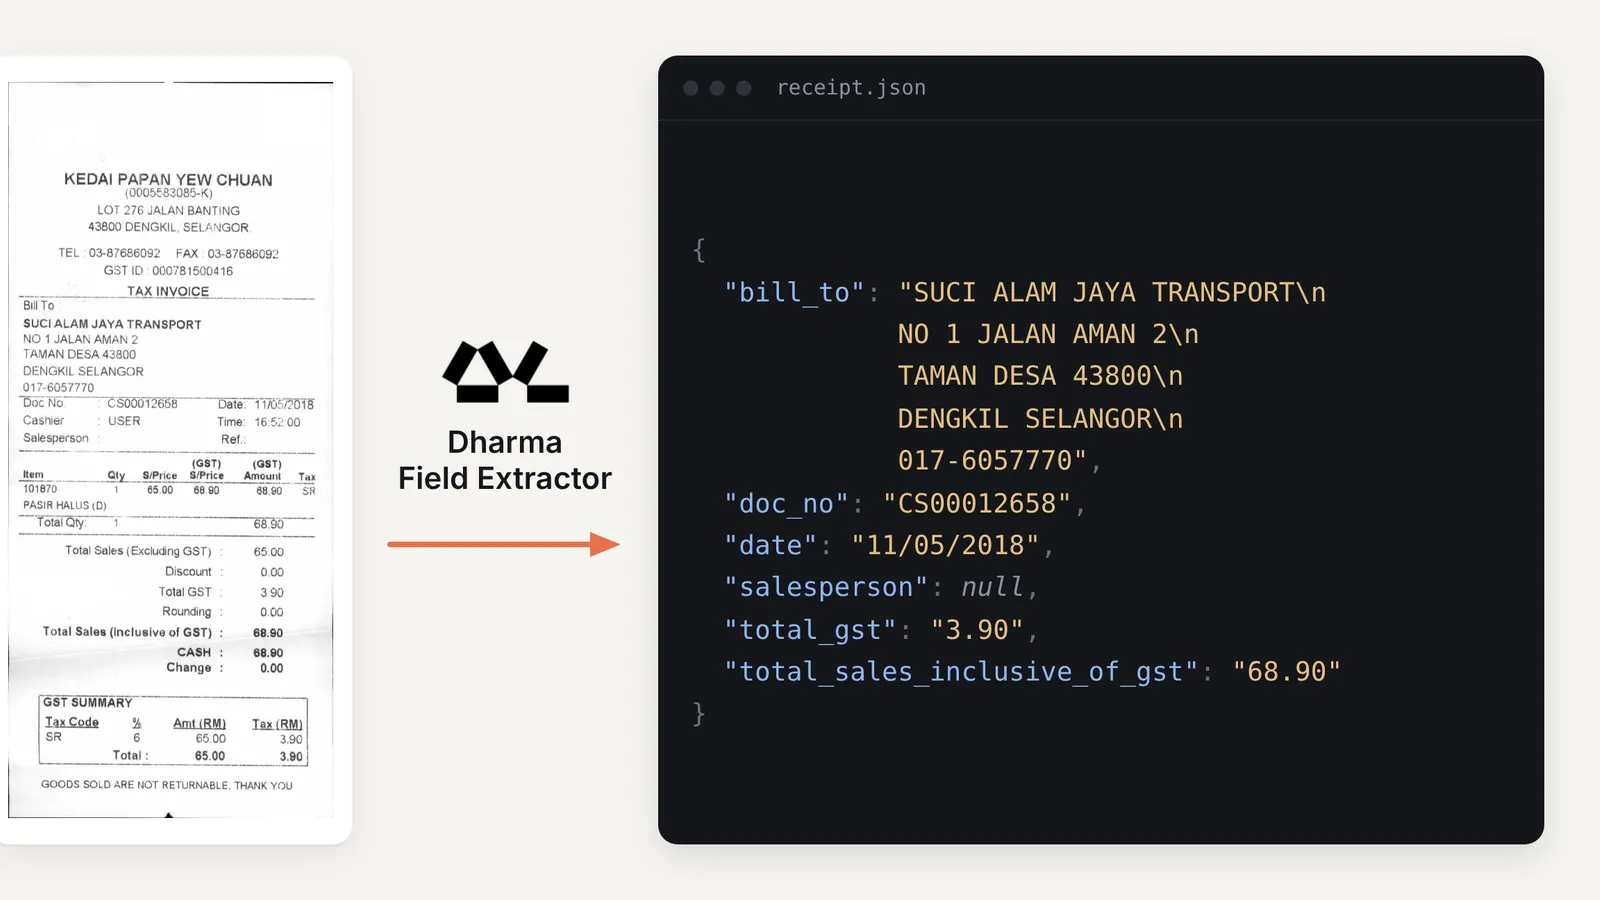
Dharma Field Extractor mengambil pendekatan yang beda. Model ini nggak cuma membaca karakter, tapi langsung memetakan informasi visual jadi file JSON berformat rapi. Kamu nggak perlu pusing bikin pipeline OCR terpisah lalu disambung ke parser lain.
Model ini nawarin dua mode ekstraksi yang bisa disesuaikan sama alur kerja kamu:
- Mode Open (Tanpa Schema): Cocok dipakai pas kamu nggak tahu persis format dokumen yang masuk. Model bakal ngebaca halaman, mengenali label dan nilai dari layout visual (misalnya label teks di samping nominal angka atau struktur baris tabel), lalu otomatis ngembaliin seluruh pasangan key-value yang ditemuin.
- Mode Schema-Directed (Dengan Schema Tertentu): Cocok pas sistem database kamu udah punya skema baku. Kamu tinggal kirim schema JSON yang diinginkan beserta tipe datanya (string, number, atau boolean). Model bakal ngisi key persis sesuai permintaanmu tanpa nambahin key liar.
Kerennya lagi, kalau kamu minta sebuah field yang ternyata emang nggak tercantum di dalam kertas dokumen, model ini bakal jujur ngasih nilai null. Ini fitur penting banget biar model nggak halusinasi ngarang data palsu ke sistem keuangan kamu.
Arsitektur dan Data Pelatihan di Balik Ukuran 2B
Banyak orang mikir model AI pintar itu harus berukuran puluhan atau ratusan miliar parameter. Tapi Dharma membuktikan sebaliknya. Base model yang dipakai adalah DharmaOCR-LITE v1.1 berukuran 2 miliar parameter yang udah dioptimasi lewat Supervised Fine-Tuning (SFT) dan Direct Preference Optimization (DPO).
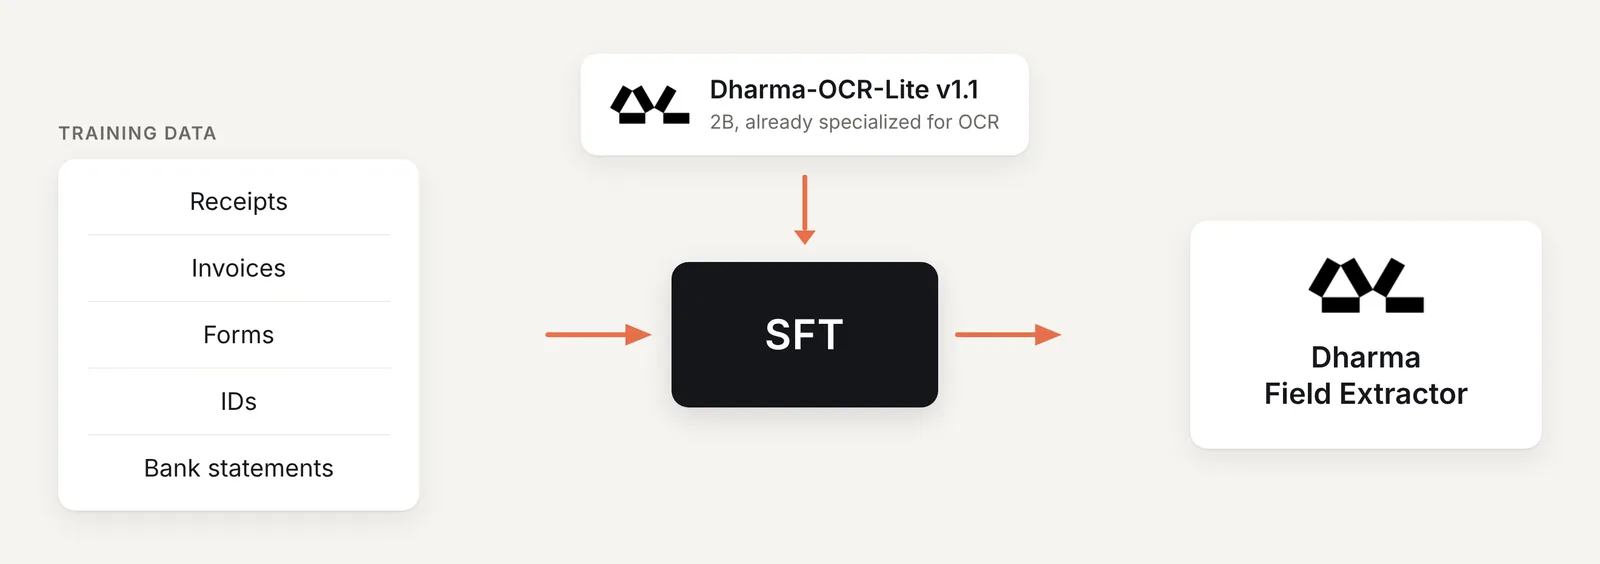
Di atas checkpoint dasar tersebut, tim melatih adapter LoRA memakai 43.384 contoh latihan yang mencakup mode open maupun schema-directed. Datanya dibagi ke dalam tiga aliran utama:
- English multi-domain data: Dokumen beragam dari web publik yang mencakup banyak format dokumen.
- Brazilian domain data: Dokumen nyata dari Brasil dalam bahasa Portugis yang diambil secara internal, termasuk dataset identitas seperti yang ada di repositori publik BID Dataset.
- Multilingual data: Porsi dokumen dalam bahasa-bahasa Eropa dan Asia lainnya buat memperluas kemampuan generalisasi lintas bahasa.
Campuran datanya sengaja dibuat multi-domain: kuitansi, faktur komersial, formulir kuesioner, rekening koran bank, dokumen kartu identitas, sampai dokumen sintetis. Jadi model nggak terkunci cuma di satu format kertas aja.
Hasil Benchmark: Skor Lebih Tinggi, Biaya Jauh Lebih Murah
Buat nguji kemampuannya, Dharma-AI ngejalanin benchmark pada 546 dokumen di tiga skenario permintaan berbeda, menghasilkan total 1.638 kasus pengujian. Metrik penilaiannya ketat banget: nilai F1 pada tingkat field (dicocokkan lewat path termasuk posisi sel dalam tabel), dikalikan dengan kesamaan Levenshtein pada nilai yang cocok, lalu dikalikan persentase keluaran yang menghasilkan JSON valid.
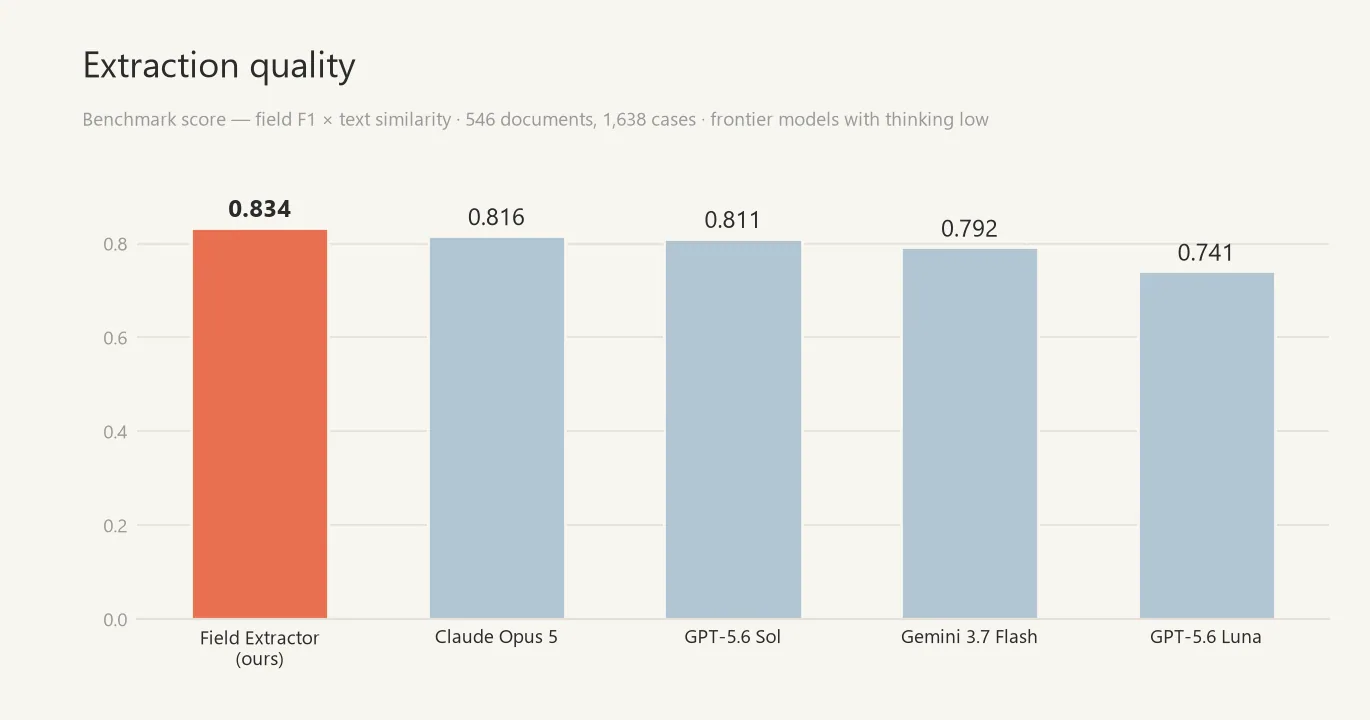
Hasil pengujian menunjukkan kalau model mungil 2B ini sukses ngalahin semua model frontier serbabisa yang diuji. Selisih kualitasnya lumayan terasa, mulai dari 1,8 poin lebih unggul dibanding Claude Opus 5 sampai 9,3 poin di atas GPT-5.6 Luna.
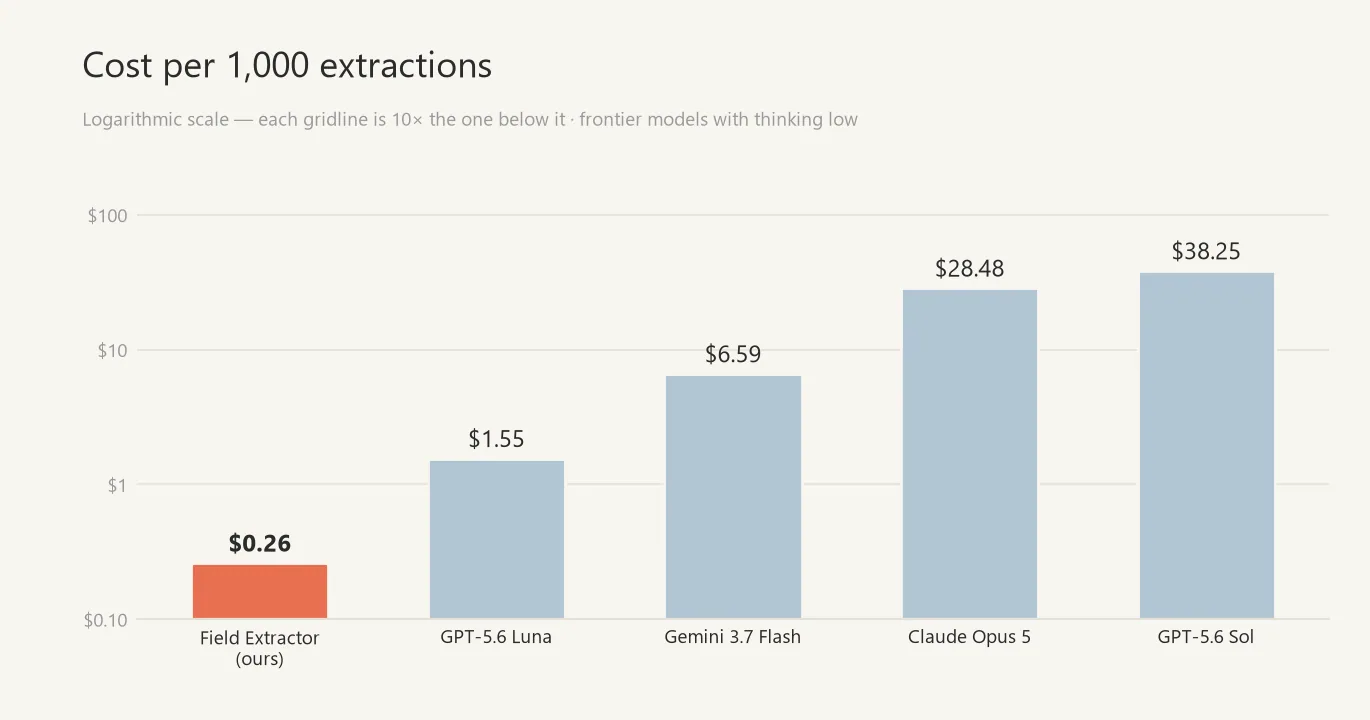
Dari sisi operasional, perbedaannya makin kontras. Biaya model frontier dihitung dari rata-rata token input dan output per halaman (termasuk reasoning token pada setelan low) sesuai daftar harga resmi masing-masing penyedia. Sementara Dharma Field Extractor dihitung berbasis sewa GPU mandiri pada satu kartu Nvidia L40S seharga $2,24 per jam.
Berikut perbandingan performa dan biaya operasional yang tercatat di pengujian mereka:
| Model | Tipe Arsitektur | Skor Kualitas (F1 x Valid JSON) | Selisih Skor vs Dharma 2B | Estimasi Rasio Biaya Ekstraksi |
|---|---|---|---|---|
| Dharma Field Extractor (2B) | Specialized SLM | 0,834 | Baseline Unggul | 1x (Paling Murah) |
| Claude Opus 5 | Frontier API | 0,816 | Kalah 1,8 poin | Jauh lebih mahal |
| GPT-5.6 Luna | Frontier API | 0,741 | Kalah 9,3 poin | Sekitar 6x lebih mahal |
| GPT-5.6 Sol | Frontier API | Lebih rendah | Terpaut jauh | Sekitar 147x lebih mahal |
Uji Nyata Generalisasi Dokumen: Dari Kuitansi sampai Coretan Tangan
Biar adil, pengujian juga memakai dataset publik yang sama sekali nggak pernah dilihat model selama proses training, yaitu SROIE (dataset kuitansi belanja) dan FUNSD (dataset formulir arsip).
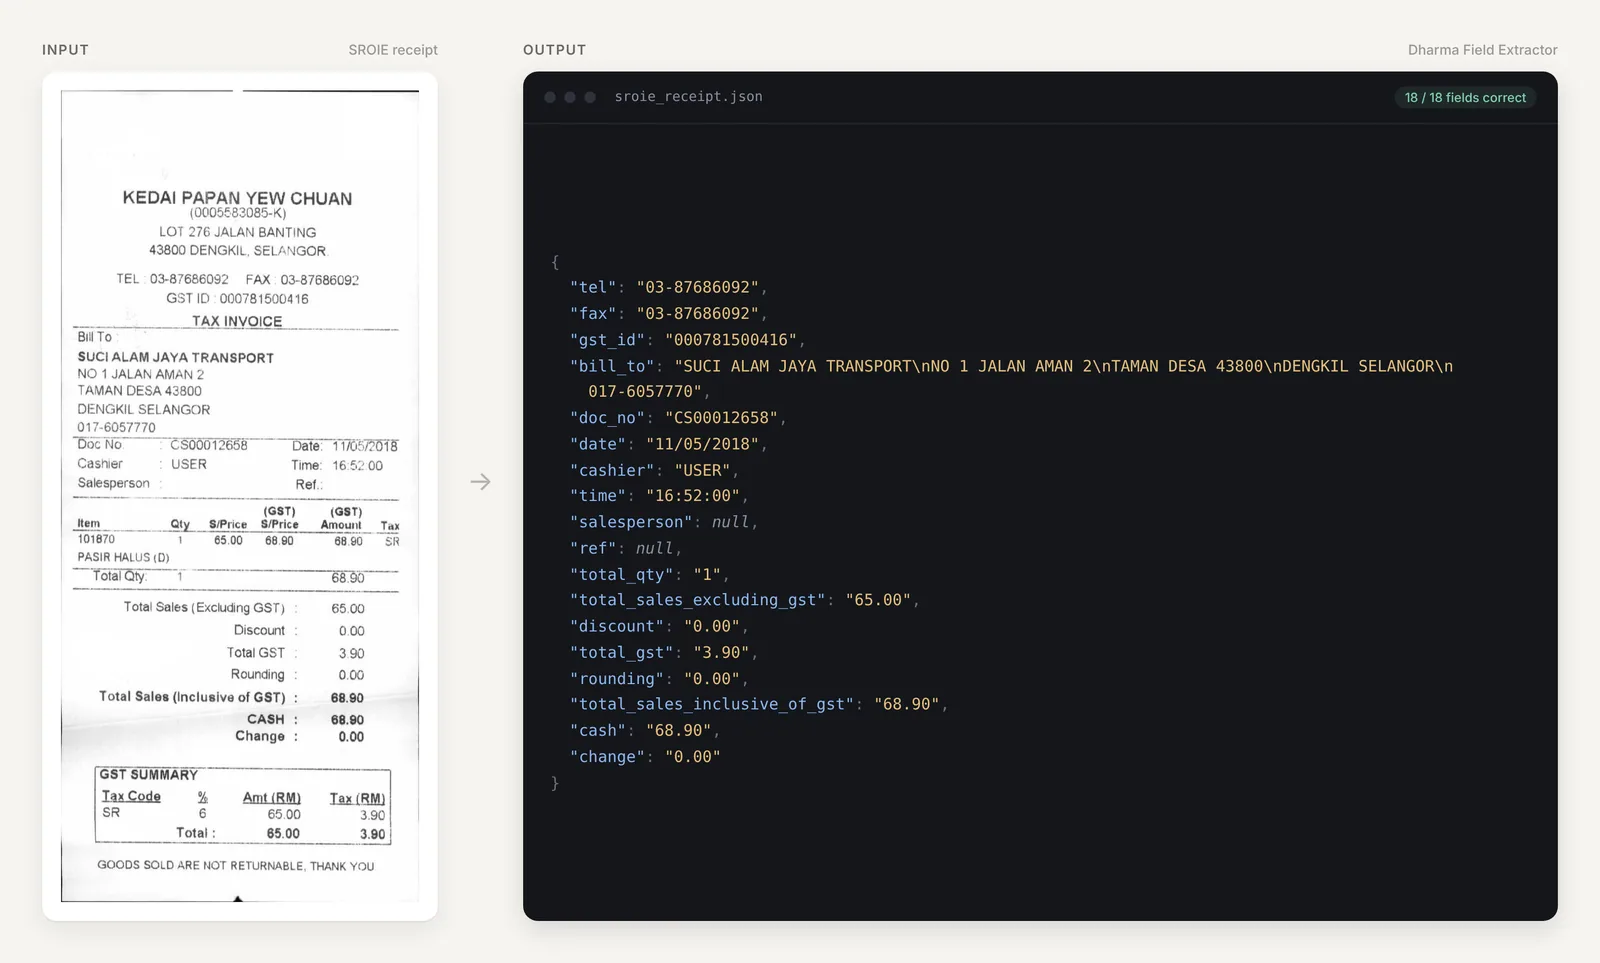
Pada sampel kuitansi belanja SROIE, tim meminta model mengekstrak 18 field yang tercetak. Hasilnya mulus tanpa cela. Alamat tagihan multibaris yang nggak punya label teks berhasil ditarik jadi satu string utuh. Dua field yang emang kosong (salesperson dan ref) secara tepat diisi null, dan tiap digit angka desimal pada total belanja cocok sampai ke digit sen terakhir.
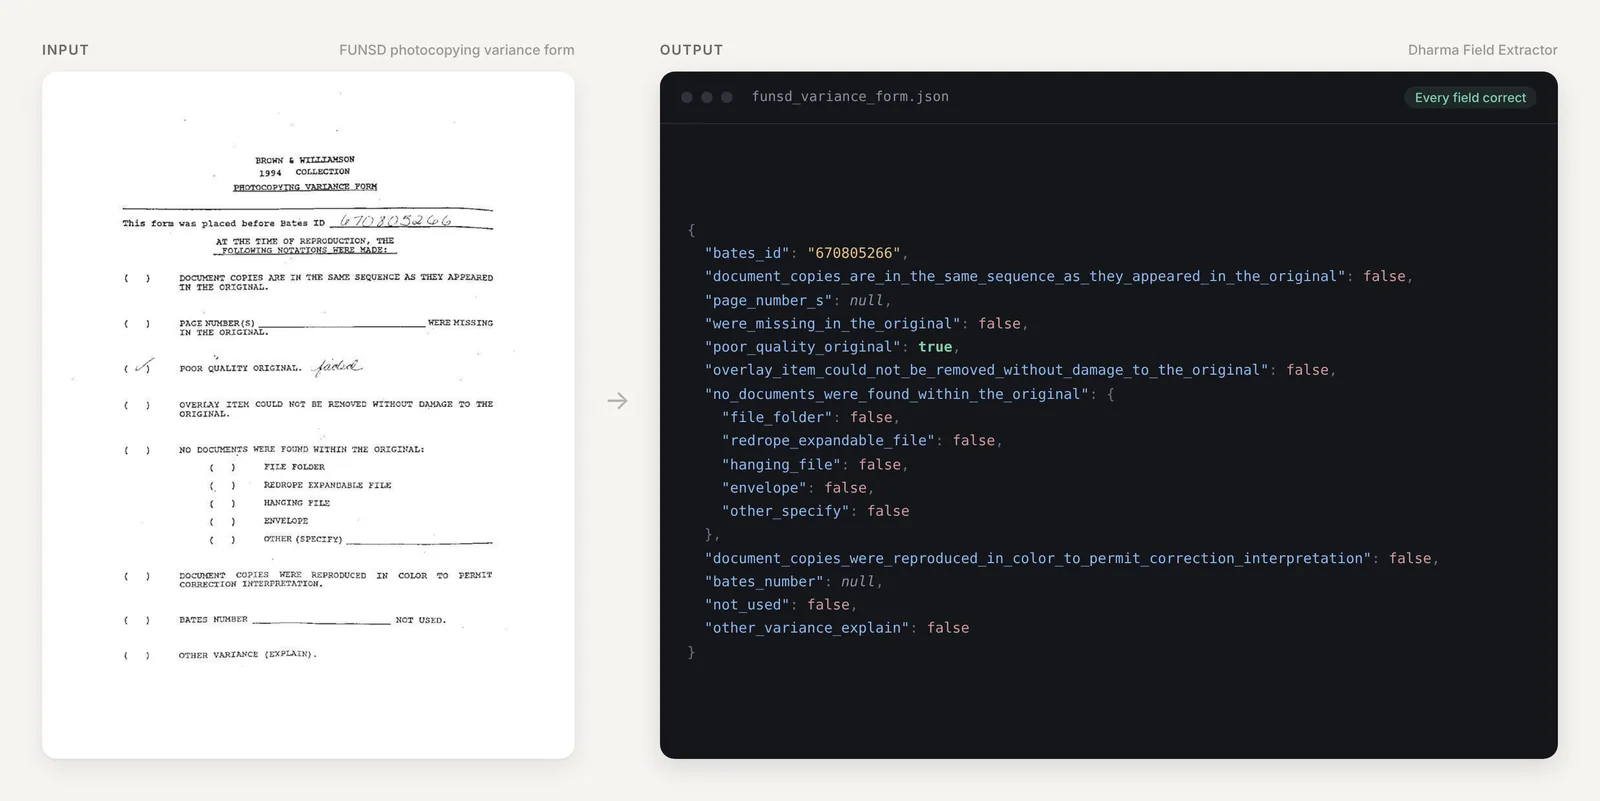
Ujian lebih berat ada di dataset formulir fotokopi FUNSD. Di formulir ini ada daftar checklist 12 pilihan boolean dengan sub-opsi bersarang. Model secara tepat cuma ngasih nilai true pada satu kotak yang dicentang manual dengan catatan tulisan tangan "faded" di sampingnya, sedangkan 11 kotak lainnya ditandai false. Model bahkan berhasil ngebaca nomor ID Bates tulisan tangan di tepi kertas dan ngisi null buat bagian yang sengaja dikosongkan.
Efisiensi Vokabulari dan Masa Depan Model Spesialis
Riset Dharma-AI ini makin mengukuhkan tesis utama mereka: buat tugas yang batasannya jelas, model kecil yang dilatih khusus bakal ngalahin model raksasa serbabisa. Pendekatan ini sejalan dengan publikasi riset mereka lainnya mengenai bagaimana spesialisasi kosakata pada SLM mampu memangkas biaya inferensi hingga 77 persen di skenario aplikasi nyata.
Jumlah parameter cuma menentukan batas atas kemampuan sebuah model, tapi proses pelatihan yang menentukan seberapa jauh model bisa mendekati batas tersebut pada tugas tertentu. Bisnis kamu nggak selalu butuh model paling besar di pasaran, melainkan model yang dilatih pas buat masalah bisnismu.
Langkah Memanfaatkan Model Ekstraksi Dokumen di Alur Kerja Kamu
Kalau kamu pengin mulai nerapin alur ekstraksi dokumen otomatis berbasis AI ke sistem internal kantor atau aplikasi buatanmu, berikut langkah praktis yang bisa kamu jalanin:
- Petakan Format Data Tujuan: Tentukan apakah sistem database kamu butuh schema ketat (nama tabel dan kolom tertentu) atau cukup penampung key-value fleksibel.
- Siapkan Schema JSON yang Tepat: Tuliskan nama field, tipe data yang diizinkan (string, number, array, boolean), serta struktur bersarang jika ada tabel item transaksi.
- Kirim Gambar Dokumen ke Model: Masukkan gambar pindaian dokumen bareng instruksi schema tersebut ke endpoint model ekstraksi.
- Validasi Nilai Null dan Angka: Manfaatkan output
nullbawaan model buat menandai dokumen yang datanya kurang lengkap sebelum masuk ke antrean verifikasi manual tim operasional. - Simpan Langsung ke Database: Karena hasil keluaran udah berformat JSON murni tanpa celoteh teks pembuka, kamu bisa langsung nge-parse data itu ke PostgreSQL, MongoDB, atau webhook sistem ERP kamu.
Berikut contoh schema prompt yang biasa dipakai saat meminta model mengekstrak tagihan ke format JSON siap pakai:
Ekstrak data dari gambar invoice ini ke format JSON valid sesuai schema berikut:{ "vendor_name": "string", "invoice_number": "string", "invoice_date": "string", "due_date": "string", "line_items": [ { "item_description": "string", "quantity": "number", "unit_price": "number", "total_amount": "number" } ], "subtotal": "number", "tax": "number", "grand_total": "number"}Jika ada field yang tidak ditemukan pada dokumen, isi nilainya dengan null tanpa mengarang nilai baru.
Pilihan Alternatif Model Frontier Lewat API
Menjalankan model self-hosted 2B seperti Dharma Field Extractor di server GPU pribadi emang opsi paling hemat kalau volume transaksi harianmu mencapai puluhan ribu halaman. Tapi buat startup atau tim developer yang belum siap mengelola server GPU L40S sendiri, memanfaatkan API model frontier fleksibel tetap jadi jalan pintas paling cepat buat tahap validasi produk.
Kalau kamu butuh menguji pipeline ekstraksi dokumen memakai model reasoning frontier yang juga ada di benchmark sumber, kamu bisa langsung nyobain lewat Classai Router. Di Classai Router, kamu bisa memanggil Claude Opus 5 dengan tarif Rp4.500 per 1 juta token input dan Rp22.500 per 1 juta token output. Pilihan lain dari kubu OpenAI seperti GPT-5.6 Sol (Rp5.130 input / Rp16.200 output per 1M token) dan GPT-5.6 Luna (Rp1.830 input / Rp9.120 output per 1M token) juga tersedia langsung lewat satu kunci API yang sama.
Kelebihan pakai gateway router semacam ini, kamu cukup ubah satu string nama model di baris kodinganmu tanpa perlu bongkar ulang arsitektur SDK OpenAI atau Anthropic Messages yang udah terpasang di backend kamu. Mirip dengan konsep pipeline data bersih yang pernah kita bahas di artikel Crawl4AI Amazon Bedrock RAG, efisiensi format input bakal sangat nentuin biaya akhir token kamu.
Biar skill koding dan integrasi sistem AI kamu makin mantap, kamu juga bisa belajar langsung di kelas AI untuk Developer atau ngulik otomasi koding lewat tutorial di kelas Tutorial Classai Router Coding.
Dampak Nyata buat Developer dan Industri Bisnis di Indonesia
Rilisnya teknologi ekstraksi dokumen berbasis small language model (SLM) ini punya dampak positif yang kerasa banget buat ekosistem teknologi di Indonesia:
- Efisiensi Biaya Operasional UMKM dan Startup: Startup fintech, logistik, atau aplikasi akuntansi lokal nggak perlu lagi pusing mikirin biaya API dolar yang menguras dompet tiap kali user nge-upload struk belanja atau dokumen invoice.
- Kepatuhan Privasi Data Lokal (UU PDP): Buat perbankan dan instansi kesehatan yang terikat aturan kerahasiaan data nasabah di Indonesia, model spesialis 2B ini bisa dijalankan sepenuhnya di infrastruktur lokal (on-premise atau private cloud domestik) tanpa mengirim secuil pun data gambar dokumen nasabah ke server luar negeri.
- Penyelesaian Dokumen Format Campuran: Banyak dokumen administrasi di kantor Indonesia memuat tabel manual dan stempel basah. Kemampuan model membaca layout bersarang sekaligus tulisan tangan ngurangin beban input data manual yang selama ini makan waktu tim operasional berjam-jam.
Langkah Dharma-AI ngebuktiin filosofi penting di dunia engineering modern: kamu nggak selalu butuh model AI dengan ukuran raksasa buat ngeberesin urusan operasional bisnis. Model berukuran ringkas yang dirancang dan dilatih tepat pada tugas spesifiknya terbukti mampu ngasih output yang lebih rapi, lebih cepat, dan tentunya ramah di anggaran server.
Sumber & referensi
- 01
Hugging Face · 5 November 2026
Dharma Field Extractor: Any Document In, Structured Fields in JSON Out
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu Dharma Field Extractor?
Dharma Field Extractor adalah model AI spesialis berukuran 2 miliar parameter bikinan Dharma-AI yang mampu mengekstrak informasi dari gambar dokumen apa saja langsung menjadi format JSON terstruktur.
Apa bedanya Dharma Field Extractor dengan OCR biasa?
OCR biasa hanya menyalin teks mentah sebaris demi sebaris sesuai posisi visual di kertas tanpa memahami arti data tersebut. Sebaliknya, Dharma Field Extractor langsung mengelompokkan data ke dalam pasangan key-value, tabel, dan tipe data JSON siap pakai tanpa perlu regex tambahan.
Berapa skor benchmark Dharma Field Extractor dibanding model frontier?
Pada benchmark 1.638 pengujian, Dharma Field Extractor meraih skor kualitas 0,834. Nilai ini melampaui Claude Opus 5 yang mencetak skor 0,816 dan GPT-5.6 Luna di angka 0,741.
Bagaimana cara kerja mode schema-directed pada model ini?
Kamu mengirimkan schema JSON yang diinginkan beserta tipe datanya, lalu model akan mengisi nilai dokumen persis pada key tersebut. Jika data yang diminta tidak tercantum di dokumen, model akan otomatis mengisi nilai null alih-alih mengarang nilai baru.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.