Agentic Retrieval Bedrock CDK: Bikin RAG Cerdas Tanpa Ribet
Arsitektur RAG biasa sering gagal jawab pertanyaan rumit. AWS membagikan cara setup agentic retrieval di Bedrock dengan CDK, bikin pipeline data otomatis dan transparan.
· 10 menit baca
Inti singkat
- Agentic retrieval di Amazon Bedrock menggantikan pencarian vektor tunggal dengan agen yang bisa bernalar dan mengambil data berulang kali.
- Tipe Managed Knowledge Base mengurus ingestion, embedding, dan indeks otomatis tanpa perlu mengelola OpenSearch Serverless sendiri.
- Proyek ini dideploy lewat AWS CDK dalam empat stack yang saling terhubung secara otomatis hanya dengan satu perintah terminal.
- Tersedia tujuh lapisan observabilitas di CloudWatch untuk melacak metrik pemanggilan tool, biaya token, hingga kualitas sitasi.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
AWS resmi memperkenalkan panduan arsitektur agentic retrieval bedrock cdk buat ngebangun sistem pencarian enterprise yang jauh lebih cerdas, otomatis, dan transparan. Solusi ini ngandelin fitur Managed Knowledge Base dan AgentCore Gateway supaya agen AI bisa mikir, milih sumber data, dan ngasih jawaban lengkap bareng kutipan yang valid.
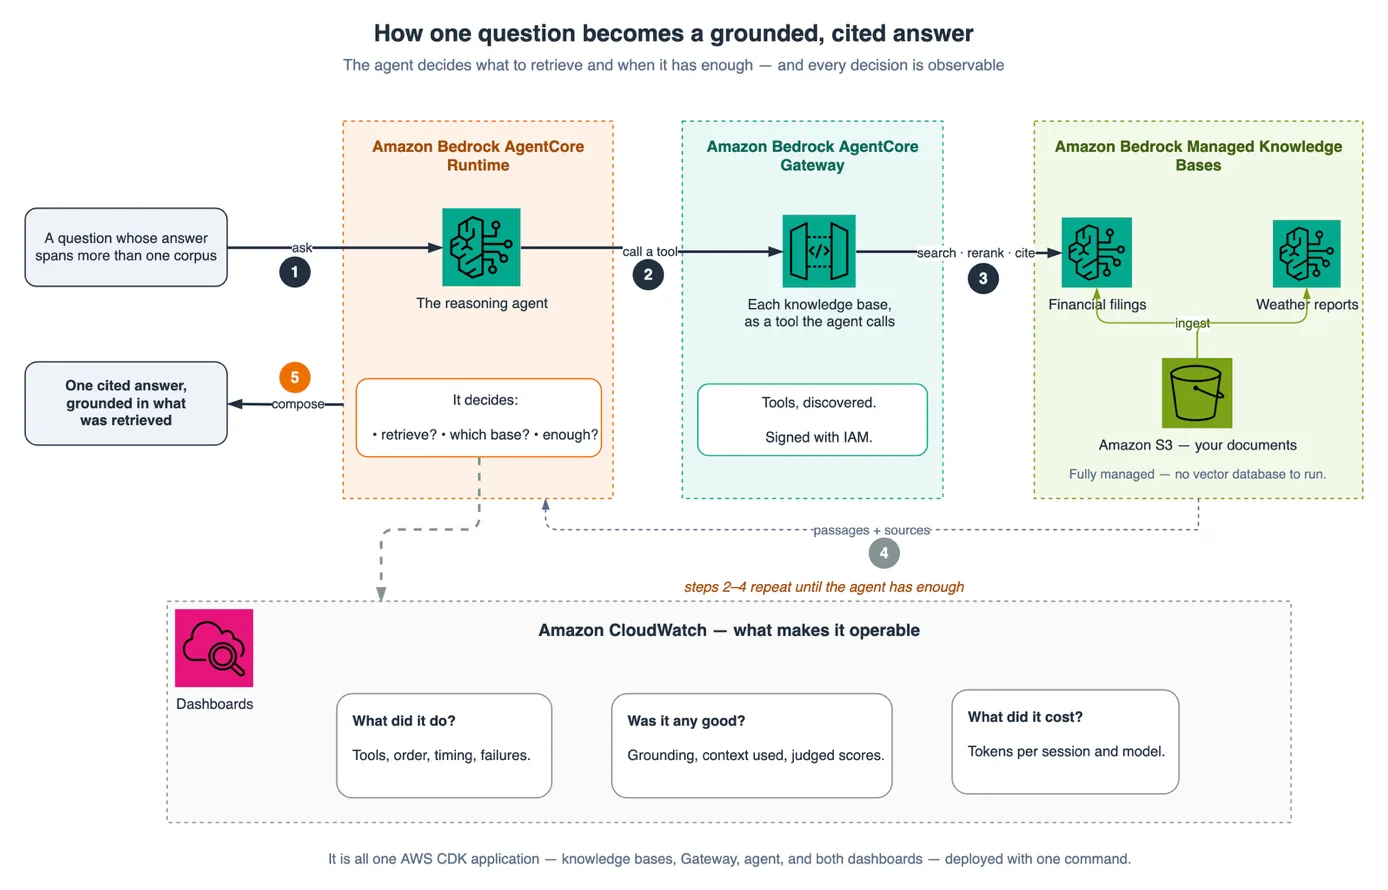
Kalau kamu pernah bikin sistem Retrieval Augmented Generation (RAG) biasa, kamu pasti tahu batasannya. RAG konvensional cuma ngubah pertanyaan jadi embedding, ngambil beberapa potongan teks dari satu indeks vektor, lalu nyuruh model bikin jawaban. Begitu pertanyaannya butuh data dari dua dokumen berbeda atau butuh pengecekan ulang, jawabannya langsung ngaco atau kepotong. Seperti dijelaskan dalam blog resmi AWS, arsitektur agentic retrieval hadir buat beresin masalah klasik ini.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa RAG Biasa Nggak Cukup dan Butuh Agentic Retrieval?
Sistem RAG standar biasanya gagal lewat tiga skenario yang sering kita temuin di lapangan. Pertama, saat jawaban dari pertanyaan user tersebar di dua tempat terpisah, satu tarikan data (single retrieval) cuma bakal ngasih setengah informasi. Hasilnya, AI ngasih jawaban yang kelihatan lancar tapi sebenernya nggak lengkap.
Kedua, kalau sumber data yang dicari tergantung pada konteks pertanyaan, indeks tunggal nggak punya logika buat milih dokumen mana yang relevan. Ketiga, kalau sistem butuh ngecek ulang dokumen setelah ngeliat hasil tarikan pertama, alur RAG biasa nggak punya wadah buat ngelakuin putaran kedua.
Di sinilah konsep agentic retrieval masuk. Sistem ini naruh agen penalaran (reasoning agent) di tengah alur kerja. Agen bakal mutusin sendiri: apakah dia perlu narik data? Dokumen mana yang cocok dibuka? Dan apakah dia perlu ngulang pencarian sebelum nulis jawaban akhir? Lewat API AgenticRetrieveStream di Amazon Bedrock Knowledge Bases, kemampuan penalaran multi-langkah dan sitasi data ini udah jadi fitur bawaan yang siap pakai.
Bedrock Managed Knowledge Base vs DIY: Apa Bedanya?
Sebelumnya, ngebangun RAG di AWS butuh konfigurasi infrastruktur yang lumayan panjang. Kamu harus nyiapin koleksi Amazon OpenSearch Serverless, ngatur indeks vektor, mikirin kapasitas OpenSearch Compute Units (OCU), sampai ngatur pipeline embedding sendiri. Pendekatan Customer-managed (DIY) ini emang fleksibel, tapi bikin pusing operasionalnya.
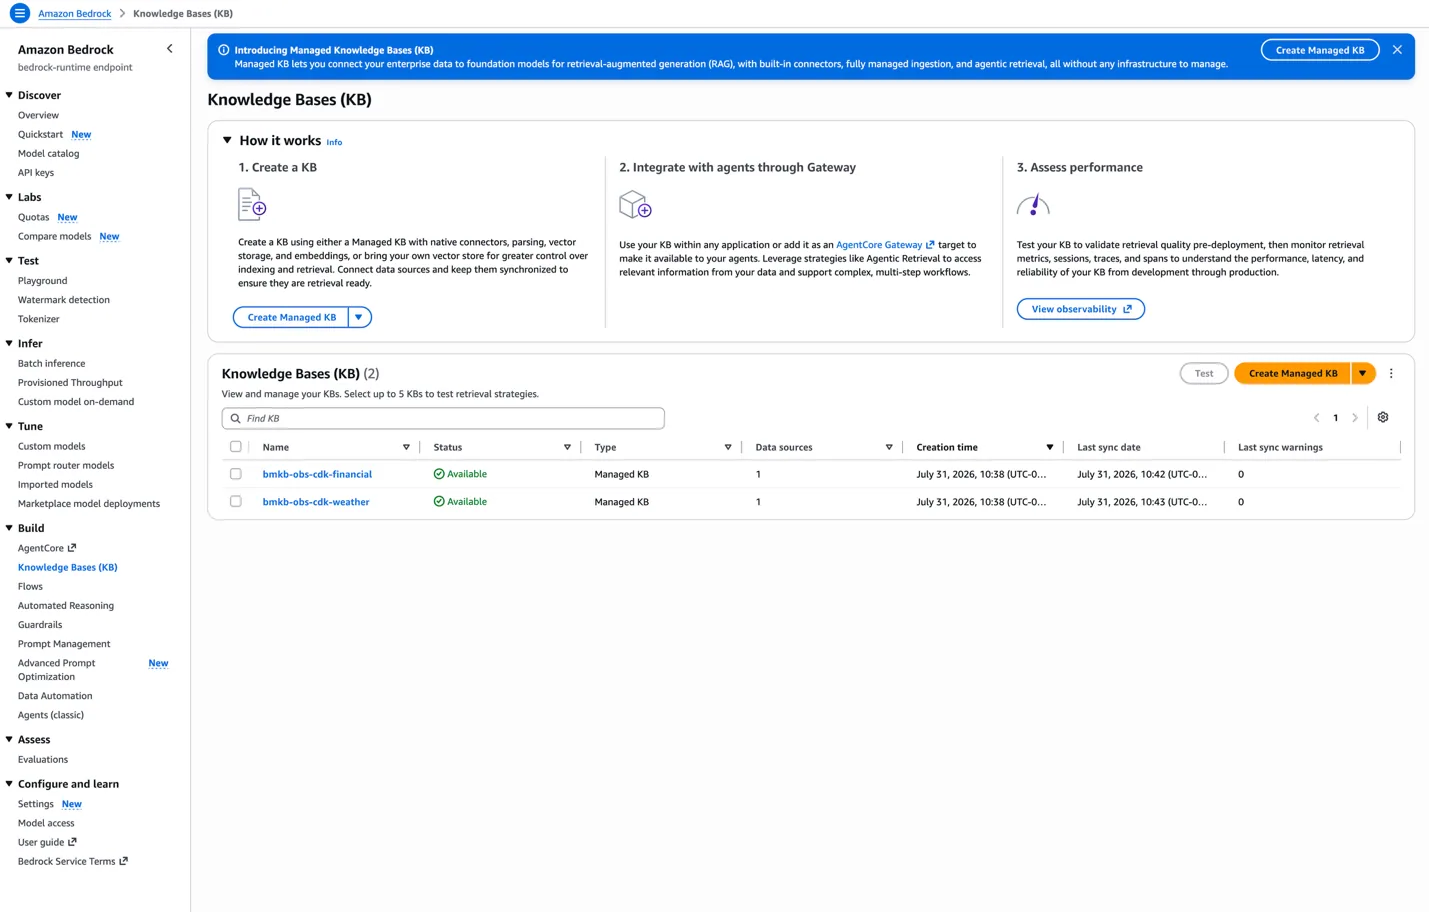
Kini Bedrock ngasih opsi baru bertipe MANAGED. Di opsi ini, AWS yang ngurusin pemecahan dokumen (chunking), indexing, penyimpanan, sampai proses reranking secara otomatis tanpa biaya tambahan buat model bawaannya.
| Kemampuan | Amazon Bedrock Managed | Customer-managed (DIY) |
|---|---|---|
Agentic retrieval (AgenticRetrieveStream) | Didukung | Nggak didukung |
| Integrasi AgentCore Gateway | Didukung | Nggak didukung |
| Data store | Otomatis scaling, dikelola penuh oleh Bedrock | Kamu yang buat, scaling, dan rawat |
| Embedding + reranking | Model bawaan terkelola tanpa biaya ekstra | Harus dikonfigurasi sendiri |
| Infrastruktur yang harus diurus | Nggak ada | Vektor DB dan resource lain |
Fitur agentic retrieval dan konektor AgentCore Gateway saat ini cuma jalan di Managed Knowledge Base. Jadi, tipe terkelola ini emang jadi fondasi utama kalau kamu mau bikin pipeline pencarian berbasis agen yang beneran praktis.
Arsitektur RAG AWS dan Cara Kerja AgentCore Gateway
Alur kerja solusi ini menghubungkan beberapa layanan AWS utama: Amazon Bedrock AgentCore (Runtime dan Gateway), Managed Knowledge Base, Amazon S3, serta pemantauan lewat Amazon CloudWatch dan AWS X-Ray.
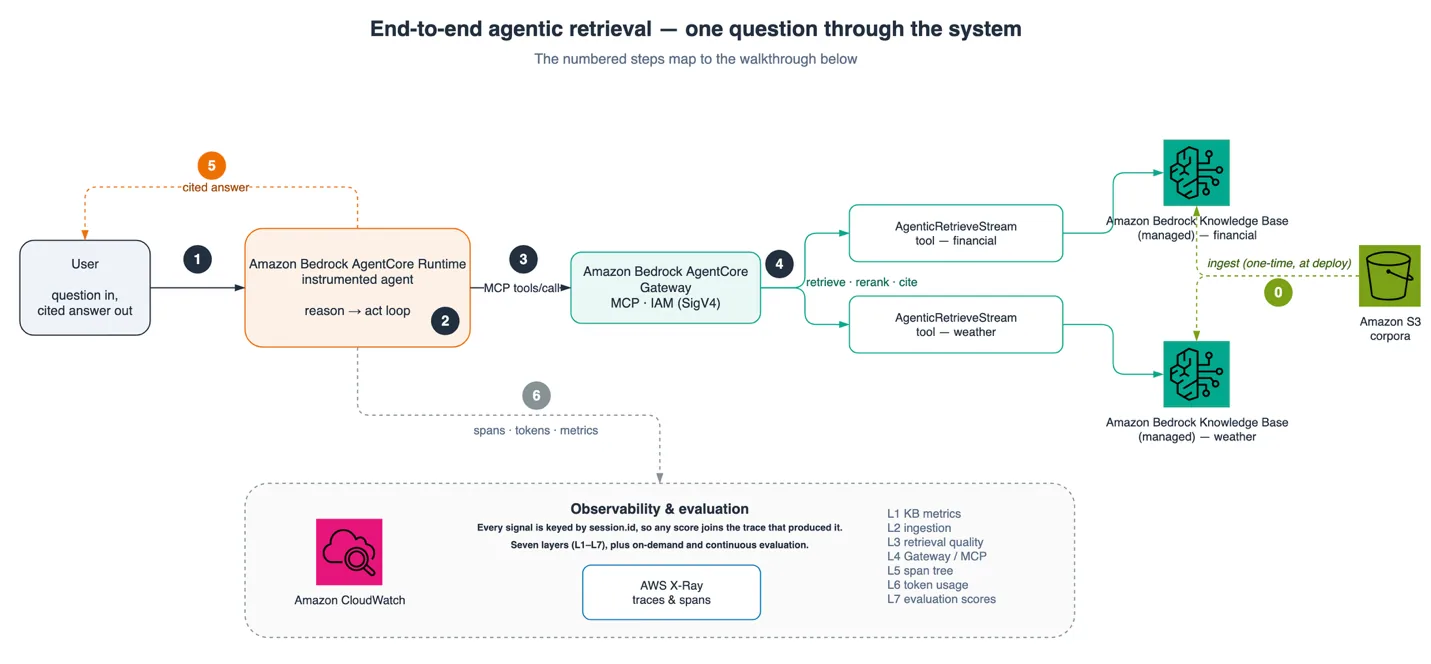
Alurnya dibagi jadi beberapa tahap terstruktur:
- Langkah Awal (Deploy): Dokumen dari Amazon S3 diolah otomatis ke masing-masing Managed Knowledge Base. Bedrock langsung parsing, mecah teks, nge-embed, dan bikin indeks tanpa gagal.
- Pertanyaan Masuk: User ngirim prompt ke agen di AgentCore Runtime. Runtime langsung ngerekam jejak eksekusi pakai OpenTelemetry (OTEL) sejak panggilan pertama.
- Perencanaan & Routing: Model penalaran agen nentuin tool mana yang harus dipanggil. Karena tiap knowledge base dijadikan tool terpisah lewat protokol Model Context Protocol (MCP), agen bisa langsung ngarahin pertanyaan ke topik yang pas.
- Pemanggilan via Gateway: AgentCore Gateway nerusin panggilan tool lewat otentikasi AWS IAM berstandar SigV4 ke API
AgenticRetrieveStream. - Pencarian Internal & Sitasi: Bedrock mecah pertanyaan jadi sub-query, nyari data secara berulang, dan nyusun jawaban yang punya sitasi sumber jelas (grounded).
- Pengecekan Jawaban: Agen ngecek apakah jawaban udah cukup. Kalau belum, dia bakal manggil tool lagi. Begitu lengkap, jawaban beres dikirim balik ke user sambil seluruh metriknya dicatat di CloudWatch.
Panduan Deploy Satu Perintah Pakai Bedrock Knowledge Base CDK
Kelebihan utama proyek ini ada pada pemanfaatan AWS CDK. Daripada nulis template CloudFormation mentah yang bikin repot ngurus export-import nilai antar-stack, CDK langsung nentuin urutan dependensi dari referensi kode Python.
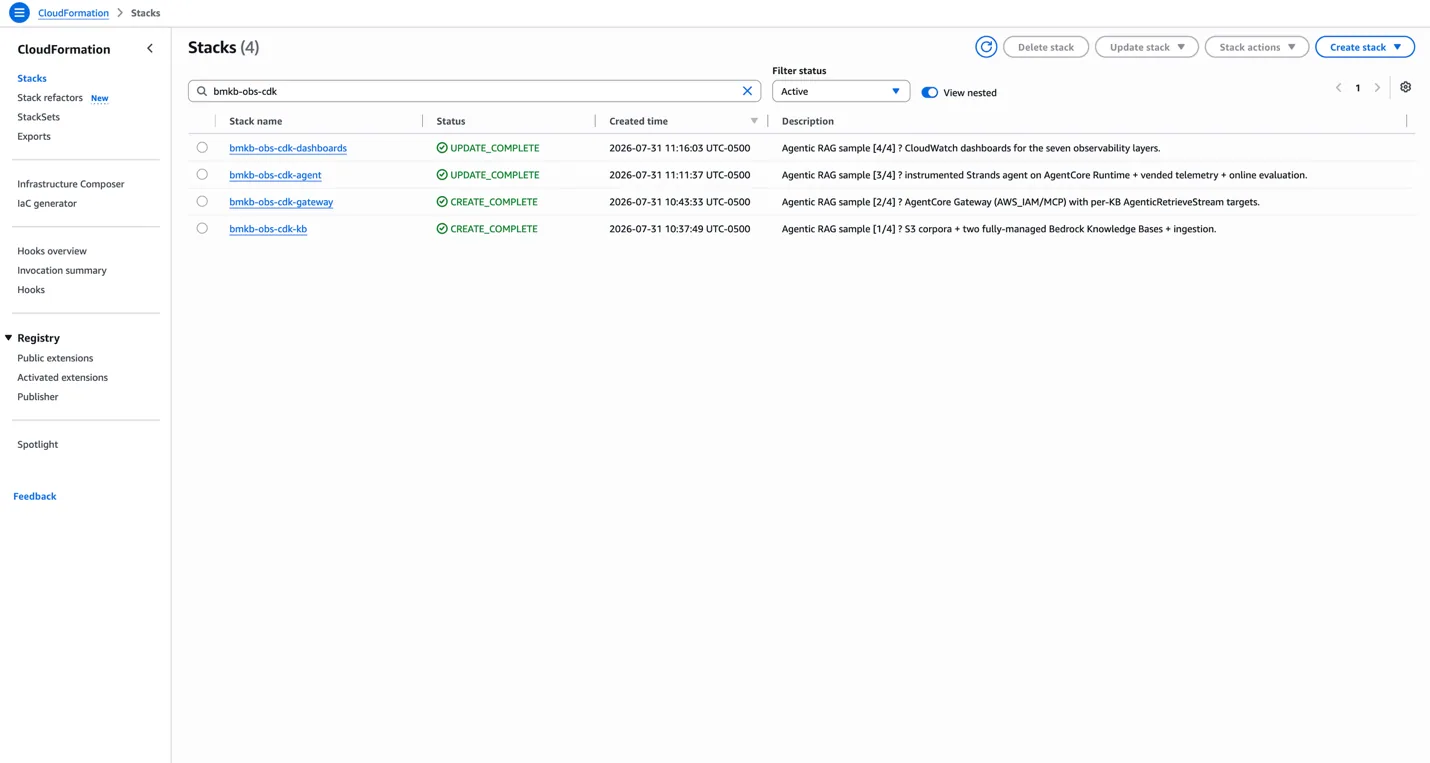
Ada empat stack yang dideploy secara otomatis:
| No | Stack | Resource yang Dibuat | Keterangan |
|---|---|---|---|
| 1 | -kb | S3 bucket, upload data, 2 Managed KB, IAM | Dokumen diproses sampai status ACTIVE |
| 2 | -gateway | AgentCore Gateway (AWS_IAM / MCP) | Target per-KB tanpa butuh Cognito |
| 3 | -agent | Amazon ECR, AWS CodeBuild, agen Strands di Runtime | Build image container sekitar 8–10 menit |
| 4 | -dashboards | 2 dashboard CloudWatch | Menampilkan metrik visual begitu ada trafik |
Langkah Pemasangan
Sebelum mulai, pastiin komputermu udah terpasang Node.js 18+, CDK CLI (npm install -g aws-cdk), Python 3.13+, dan akun AWS dengan akses Bedrock serta AgentCore. Kamu nggak butuh Docker lokal karena image container agen bakal dibikin langsung oleh CodeBuild pakai arsitektur ARM64.
Jalankan perintah ini di terminal:
git clone https://github.com/aws-samples/amazon-bedrock-samples.git
cd rag/managed-knowledge-bases/07-IaaC/managed-kb-observability-cdk/
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cdk bootstrap
cdk deploy --all
CDK bakal membaca dependensi di berkas app.py, lalu menjalankan deploy mulai dari stack -kb, -gateway, -agent, sampai -dashboards. Penanganan proses sinkronisasi ingestion dan build image yang makan waktu lama diurus rapi lewat Provider framework di AWS Lambda dengan batas waktu tunggu sampai 30 menit.
Menguji Semantic Routing dan Kualitas Grounded AI Bedrock
Repository ini menyertakan dua contoh dataset di dalam folder data/:
- Finansial: Laporan tahunan sintetis Octank 10-K (
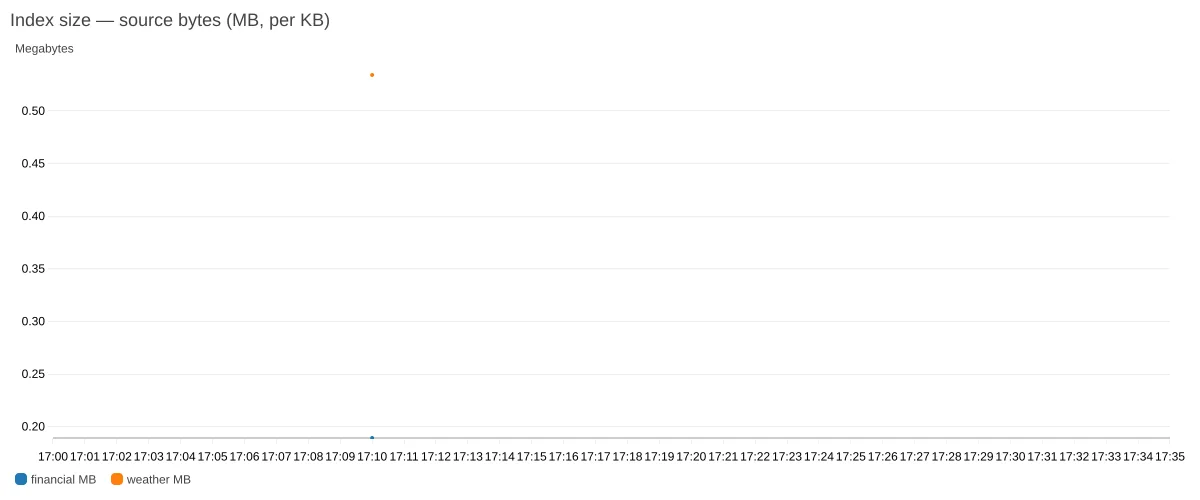
octank_financial_10K.pdf, ~198 KB) berlisensi CC0. - Cuaca: Laporan tornado resmi dari Congressional Research Service AS (
tornadoes_report.pdf, ~560 KB) yang berstatus domain publik.
Pemisahan dua korpus ini sengaja dilakuin buat ngetes kemampuan semantic routing. Alih-alih nyampur semua data ke dalam satu indeks raksasa, arsitektur ini memisahkan keduanya jadi dua tool independen di Gateway. Dengan cara ini, pohon eksekusi (span tree) bisa nunjukkin dengan gamblang kapan agen manggil tool finansial dan kapan manggil tool cuaca.
Kamu bisa nyobain pengujian ini lewat Jupyter Notebook notebooks/01-drive-and-observe.ipynb. Begitu dijalankan, notebook bakal ngebaca output stack CloudFormation secara otomatis tanpa perlu copy-paste ID atau ARN secara manual.
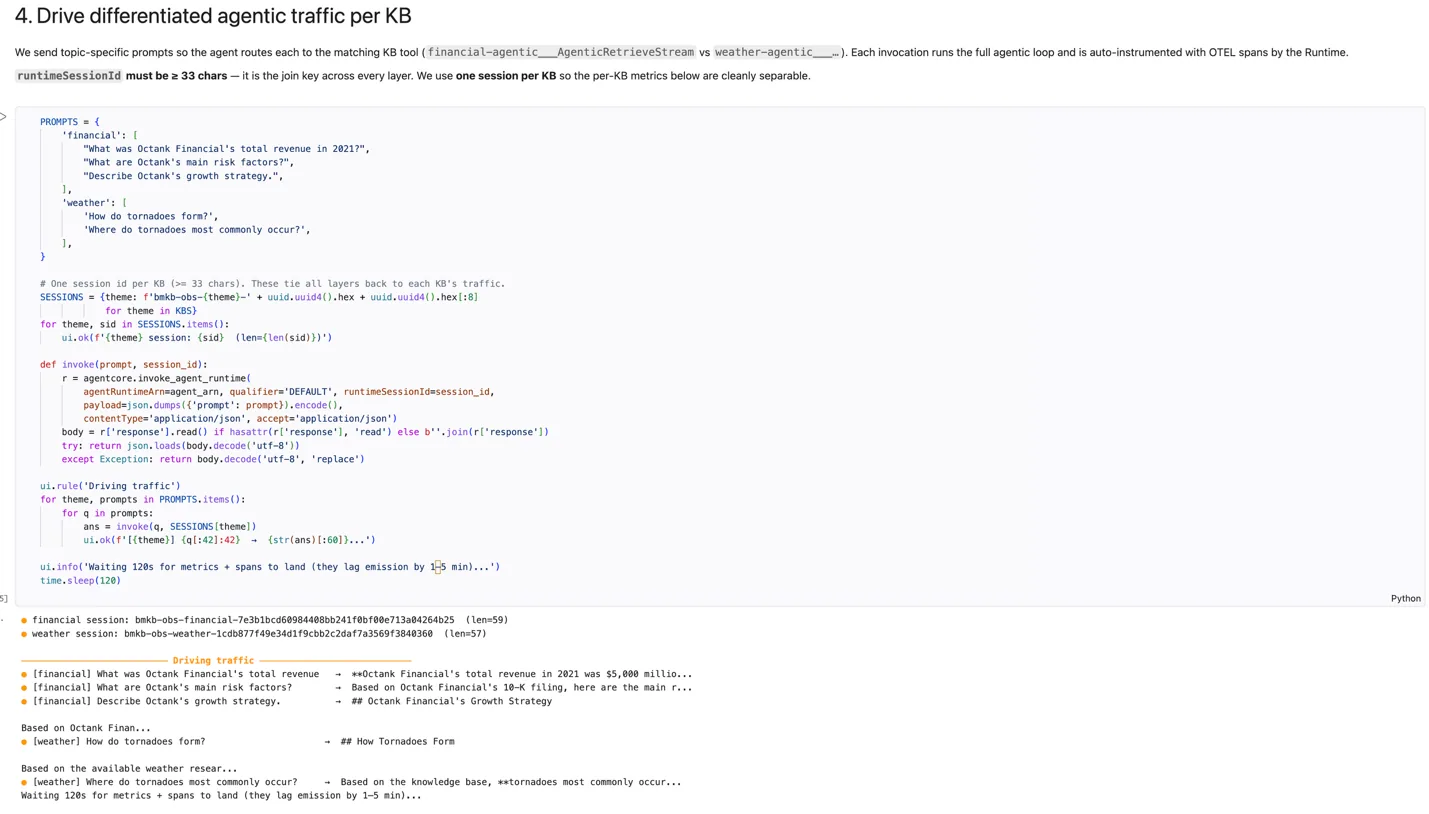
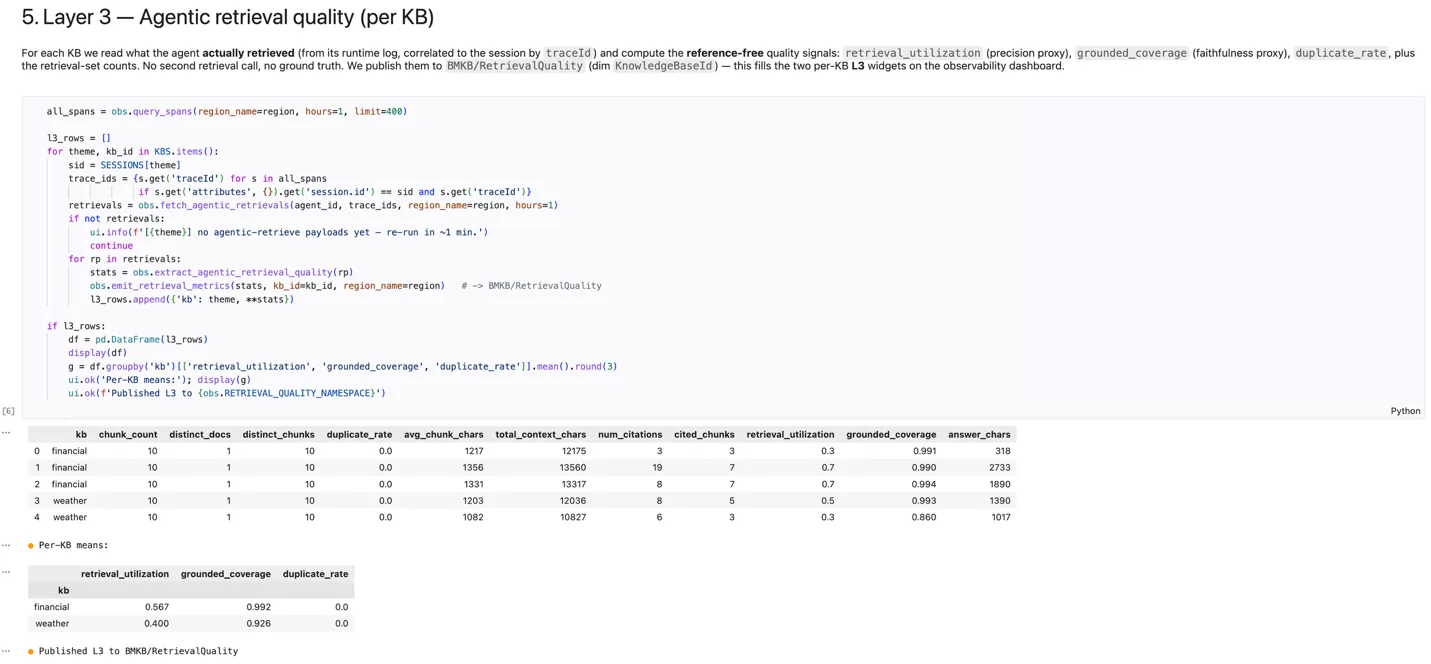
Selain ngecek routing, notebook ini juga ngitung sinyal kualitas retrieval Layer 3 tanpa butuh data ground truth atau model penilai tambahan (reference-free metrics), lalu ngirim hasilnya langsung ke CloudWatch.
Membedah 7 Lapisan Observabilitas di Amazon CloudWatch
Bikin agen AI itu gampang-gampang susah. Kalau sistem RAG satu arah gampang ditebak jalurnya, agen AI yang punya kemampuan looping bakal ngambil rute berbeda di tiap pertanyaan. Kalau nggak ada sistem pemantauan yang matang, kamu bakal buta soal performa dan biayanya.
Solusi CDK ini langsung nyiapin dua dashboard visual di Amazon CloudWatch yang mencakup tujuh lapisan telemetri:
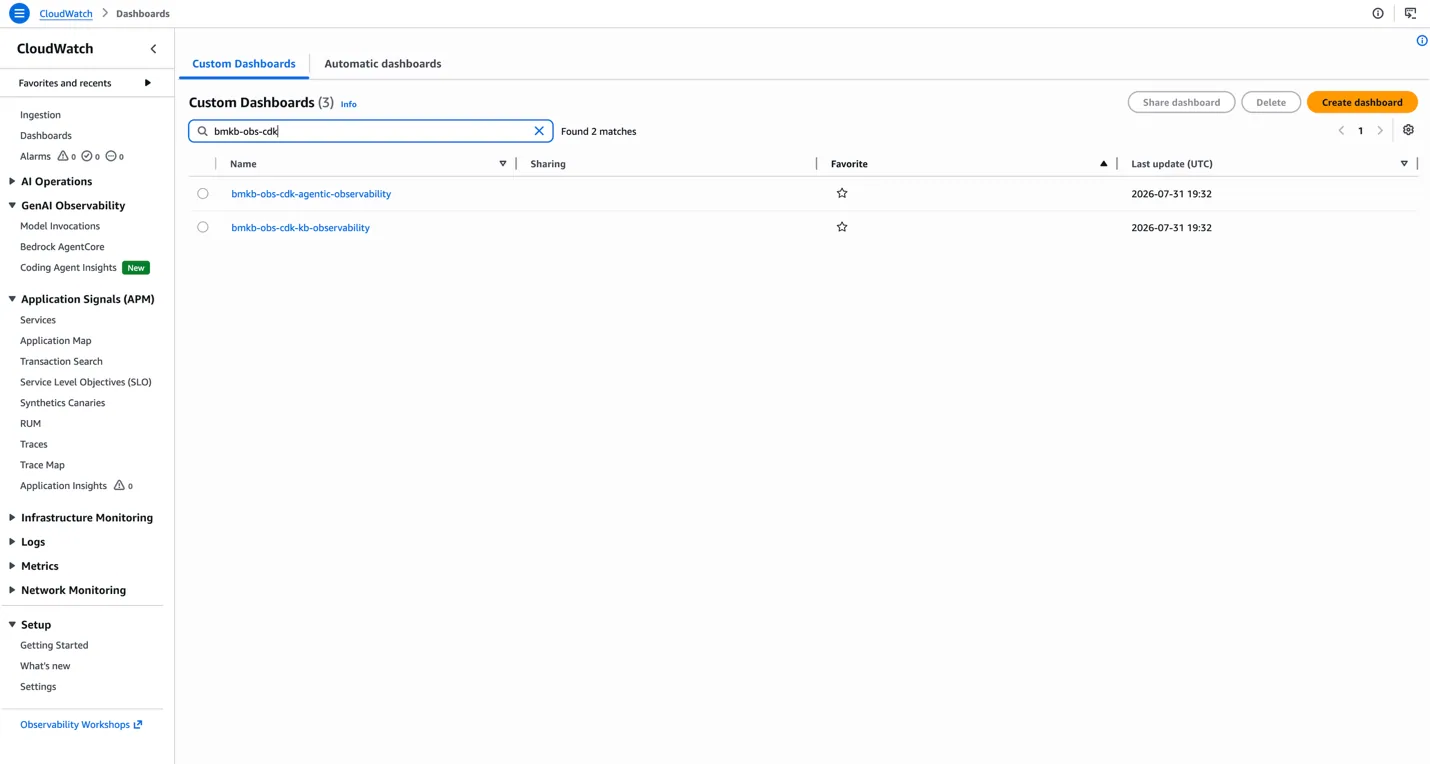
Dashboard A: Observabilitas Agentic End-to-End
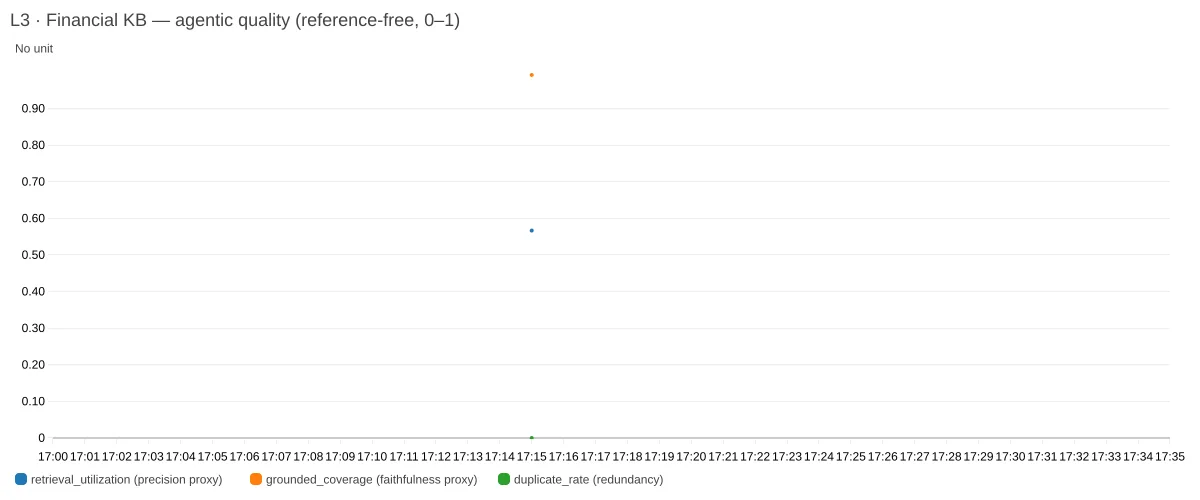
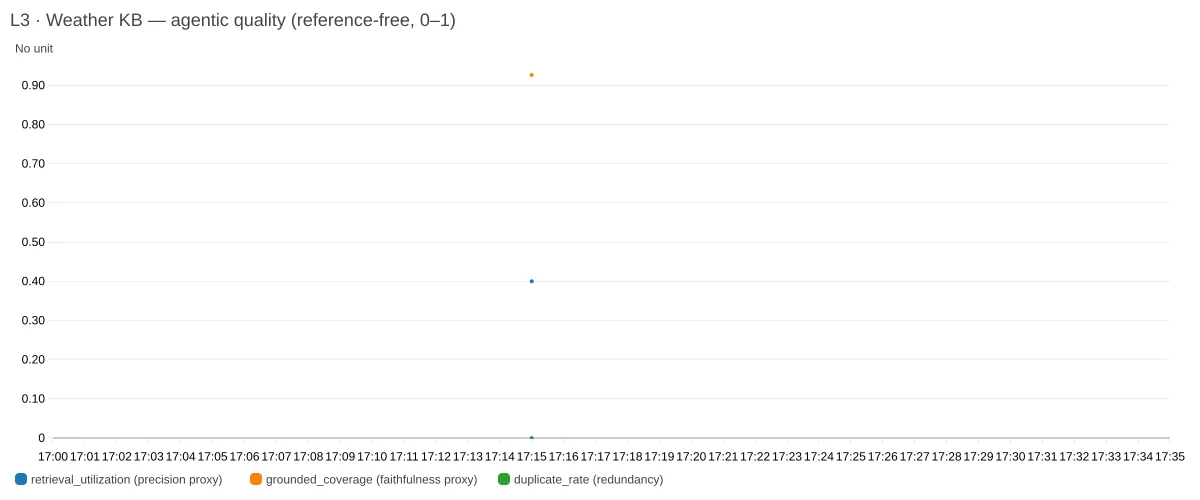
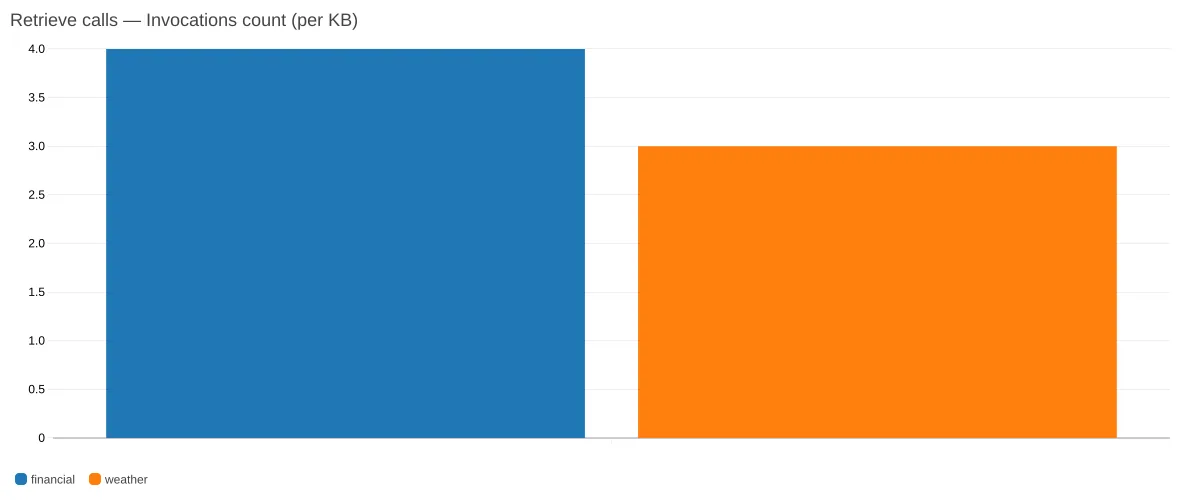
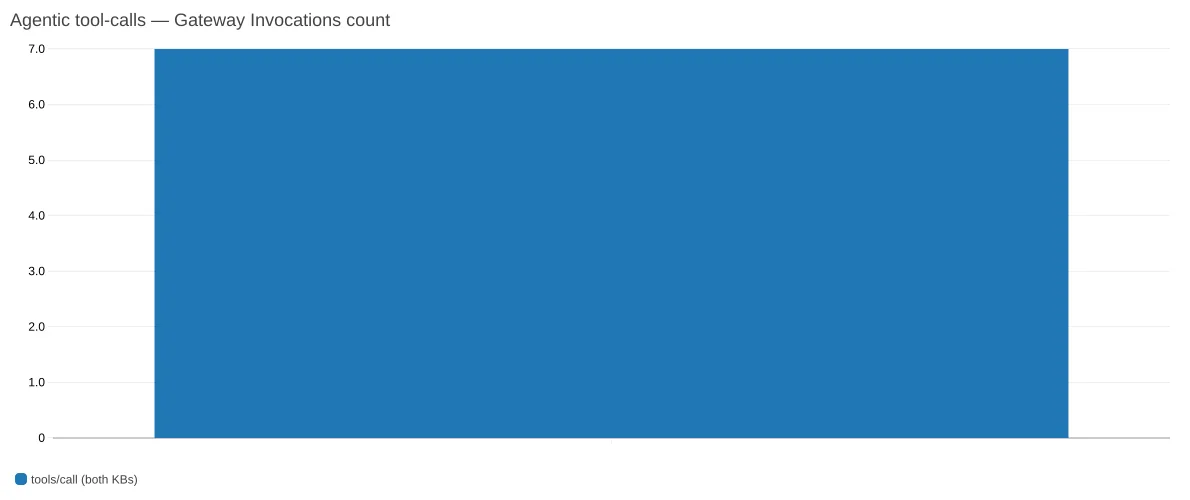
Dashboard ini memantau alur sistem secara menyeluruh. Di sini kelihatan bahwa untuk N pertanyaan, kamu bakal ngeliat sekitar N pemanggilan agen, ~2N penarikan data, ~3N panggilan LLM, dan ~5N operasi MCP di Gateway. Dashboard ini juga memplot metrik kualitas Layer 3 secara terpisah buat masing-masing knowledge base:
- Retrieval Utilization: Seberapa banyak data yang ditarik bener-bener kepakai di jawaban akhir.
- Grounded Coverage: Indikator apakah jawaban beneran didukung oleh kutipan teks sumber.
- Duplicate Rate: Menghitung apakah ada potongan data ganda yang ditarik selama proses looping.
Dashboard B: Observabilitas Per Knowledge Base (BMKB)
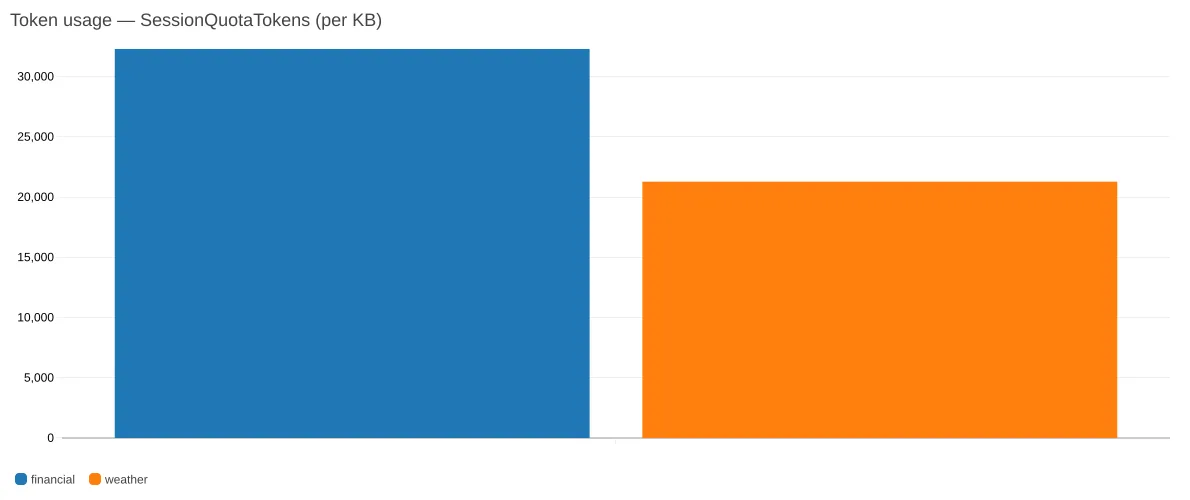
Dashboard kedua fokus pada metrik operasional yang nentuin pengeluaran biaya cloud. Empat widget utamanya nampilin ukuran indeks dari byte data di S3, volume pemanggilan API retrieve, total pemanggilan tool di AgentCore Gateway, serta pemakaian token per sesi.
Memahami Lapisan 5: OpenTelemetry Span Tree
Lapisan kelima (L5) menyimpan data jejak OpenTelemetry di log aws/spans. Struktur pohon jejak ini penting banget dipahami pas kamu mau ngitung konsumsi token. Satu pemanggilan model bahasa menghasilkan tiga tingkatan span bersarang: span invoke_agent dari Strands Agents, span internal chat, dan span daun bertipe CLIENT bernama chat <model>.
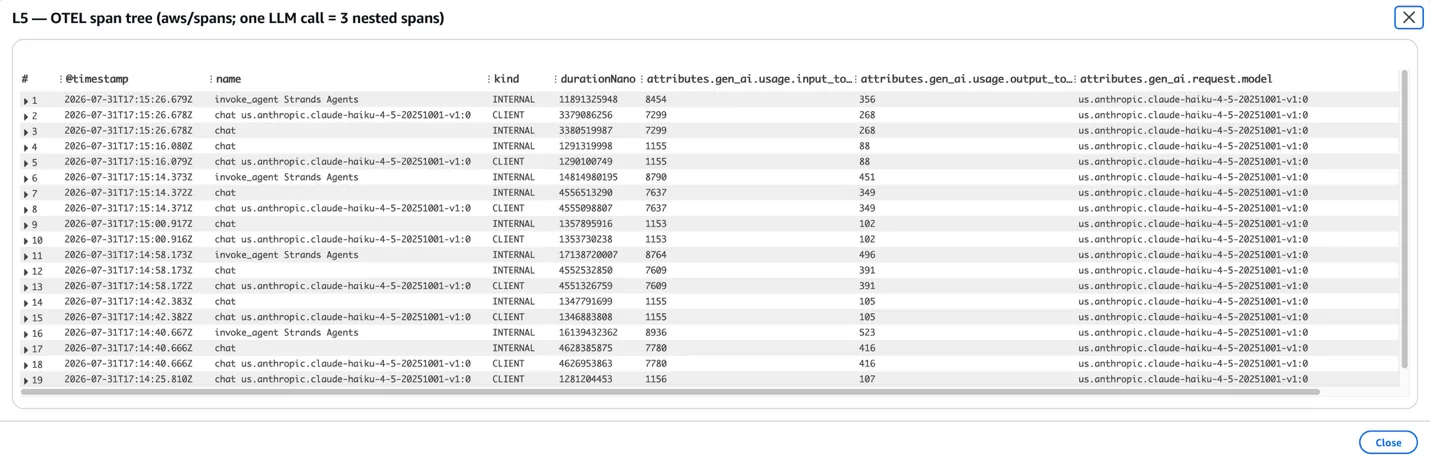
Ketiga tingkatan span itu nampilin atribut jumlah token input dan output yang persis sama. Jadi, kalau kamu mau bikin agregasi metrik token sendiri biar biayanya nggak terhitung tiga kali lipat, pastikan kamu cuma memfilter span daun yang bertipe CLIENT.
Kalau kamu lagi ngembangin backend atau agen AI dan butuh akses cepat ke model seperti Claude Haiku 4.5 tanpa perlu setup akun luar negeri, kamu bisa manfaatin Classai Router. Cukup pakai satu API key, kamu bisa manggil model claude-haiku-4.5 (Rp900 input / Rp4.500 output per 1 juta token) dengan format SDK standar OpenAI maupun Anthropic, bayar pakai rupiah lewat QRIS.
Biar pemahaman kamu soal bikin pipeline agen AI makin matang, kamu juga bisa gabung di kelas AI untuk Developer bareng komunitas teknis Classai.
Dampak Nyata Buat Developer dan Tim Engineering
Buat tim developer dan arsitek cloud di Indonesia, pola arsitektur ini ngasih solusi konkret atas beberapa tantangan teknis:
- Hemat Waktu Operasional: Kamu nggak perlu lagi repot nge-tweak cluster OpenSearch Serverless atau ngurus pecahan embedding manual. Managed Knowledge Base ngerjain tugas berat itu di balik layar.
- Kepatuhan Audit & Transparansi Data: Dengan prinsip grounded AI, setiap jawaban yang keluar wajib punya sitasi dokumen yang jelas. Ini penting banget buat memenuhi standar tata kelola data perusahaan dan kepatuhan audit internal.
- Kendali Biaya yang Terukur: Lewat telemetri 7 lapis di CloudWatch, tim finansial dan engineering bisa memantau pemakaian token per knowledge base secara transparan, jadi nggak ada tagihan mendadak akibat agen AI yang mengalami infinite loop.
Kamu juga bisa mempelajari teknik optimasi agen lainnya di artikel kami tentang trik prompt caching Amazon Bedrock supaya biaya inferensi agen AI bisa ditekan lebih jauh lagi.
Sumber & referensi
- 01
AWS · 27 Oktober 2026
Build agentic retrieval on a Managed Amazon Bedrock Knowledge Base with CDK
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa bedanya RAG biasa dengan agentic retrieval di AWS Bedrock?
RAG biasa cuma narik data sekali dari satu indeks vektor lalu bikin jawaban. Agentic retrieval memakai agen cerdas yang bisa menentukan apakah perlu mencari data, memilih sumber dokumen yang tepat, dan mengulang pencarian sampai jawabannya lengkap bareng kutipannya.
Apakah membuat Managed Knowledge Base Bedrock membutuhkan OpenSearch Serverless?
Nggak butuh sama sekali. Tipe Managed Knowledge Base mengurus penyimpanan data, pemecahan teks, embedding, dan pengindeksan secara internal oleh layanan Bedrock tanpa perlu membuat koleksi OpenSearch Serverless manual.
Berapa lama proses deploy proyek Bedrock CDK ini?
Proses deployment empat stack ini makan waktu sekitar 8 sampai 10 menit. Waktu paling lama dihabiskan pada tahap stack agen karena AWS CodeBuild perlu merakit image container berbasis ARM64.
Mengapa observabilitas CloudWatch sangat penting untuk agentic RAG?
Karena alur agen AI dinamis dan bisa mengambil langkah berbeda di setiap pertanyaan. CloudWatch membantu developer memantau latensi, rute tool yang dipanggil, konsumsi token, dan kualitas sitasi dokumen secara transparan.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.