Reinforcement Learning SageMaker AI: Cara Latih AI Agent Multi-Turn
AWS merilis panduan Multi-Turn Reinforcement Learning di SageMaker AI. Yuk bedah cara bikin AI agent makin pintar ngerjain tugas beruntun tanpa boncos!
· 11 menit baca
Inti singkat
- Multi-Turn RL di SageMaker AI melatih model berdasarkan hasil akhir dari rangkaian aksi beruntun, bukan per prompt tunggal.
- Eksperimen AWS membuktikan GPT-OSS-20B naik tingkat keberhasilan dari 61 persen jadi 84 persen dengan biaya token sekitar $339.
- Sistem memisahkan peran: SageMaker AI mengelola training policy model, sementara Amazon Bedrock AgentCore menjalankan agent dan reward.
- Desain reward wajib mengutamakan hasil akhir (outcome-dominant) agar agent tidak mengeksploitasi bonus langkah tambahan.
- Evaluasi model wajib dilakukan pada pengaturan serving nyata (seperti temperature 1.0), bukan sekadar mengandalkan metrik validasi training.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
AWS resmi membagikan panduan teknis Multi-Turn Reinforcement Learning di Amazon SageMaker AI untuk melatih model AI agent dalam menyelesaikan tugas interaktif multi-langkah. Pendekatan ini memungkinkan AI agent belajar langsung dari hasil akhir sebuah alur kerja yang panjang, bukan cuma menebak satu jawaban dari satu prompt seperti pada fine-tuning biasa.
Kalau kamu pernah nyobain bikin AI agent buat ngurus alur kerja kantor—misalnya bikin laporan reimbursement atau ngefilter tiket keluhan pelanggan—kamu pasti tahu betapa ribetnya proses itu. Agent harus ngambil keputusan berulang kali, manggil tool berkali-kali, dan langkah berikutnya selalu bergantung sama hasil langkah sebelumnya. Masalahnya, teknik Supervised Fine-Tuning (SFT) biasa nggak punya label buat alur rumit kayak gini, dan Single-Turn Reinforcement Learning (RL) nggak bisa ngasih reward yang adil buat keputusan yang diambil agent tiga langkah sebelum tugasnya selesai.
Lewat panduan resmi di AWS Machine Learning Blog, AWS ngebocorin cara kerja Multi-Turn Reinforcement Learning (MTRL) di Amazon SageMaker AI bareng Amazon Bedrock AgentCore. Mereka nyobain metode ini pada game Wordle memakai model open-weights GPT-OSS-20B, dan hasilnya gila banget: tingkat kemenangan tebak kata melonjak dari 61 persen ke 84 persen di pengaturan reasoning default cuma dengan biaya token sekitar $339. Menarik kan? Yuk kita bedah arsitektur dan langkah praktisnya.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Multi-Turn RL Dibutuhkan Buat AI Agent?
Selama ini kebanyakan teknik fine-tuning fokus bikin model ngasih jawaban teks terbaik dalam sekali balas. Padahal, tugas agentic itu sifatnya dinamis. Nggak ada satu rute mutlak yang harus ditiru agent. Yang paling penting adalah: alur kerja itu akhirnya sukses atau gagal.
Di sinilah MTRL masuk. Layanan ini ngirim prompt ke agent yang kamu pasang di Amazon Bedrock AgentCore atau infrastruktur sendiri (kayak Amazon EKS, EC2, atau AWS Fargate lewat AWS Lambda forwarder). Agent bakal manggil policy model yang lagi dilatih, berinteraksi di lingkungan (environment) selama beberapa giliran (turns), lalu ngelaporin satu skor reward pas sesi selesai. Kamu nggak perlu pusing mikirin rute mana yang paling bener, cukup tentuin cara ngitung skor akhirnya.
Studi kasus yang dipakai tim AWS adalah Wordle—game tebak 5 huruf dalam 6 kali tebakan. Game ini dipilih bukan karena model frontier belum bisa main, tapi karena aturannya jelas, tiap tebakan bergantung sama respons sebelumnya, dan penilaiannya objektif. Di dunia nyata, pipeline yang sama persis bisa kamu pakai buat ngelatih model kecil berbiaya murah agar jago ngerjain SOP internal perusahaan kamu.
Arsitektur Reinforcement Learning SageMaker AI dan AgentCore
Sistem MTRL ini dibagi jadi dua sisi yang saling ngobrol lewat API. SageMaker AI megang kendali proses training job dan policy model, sedangkan Bedrock AgentCore jadi rumah buat runtime agent, environment Wordle, dan fungsi reward.
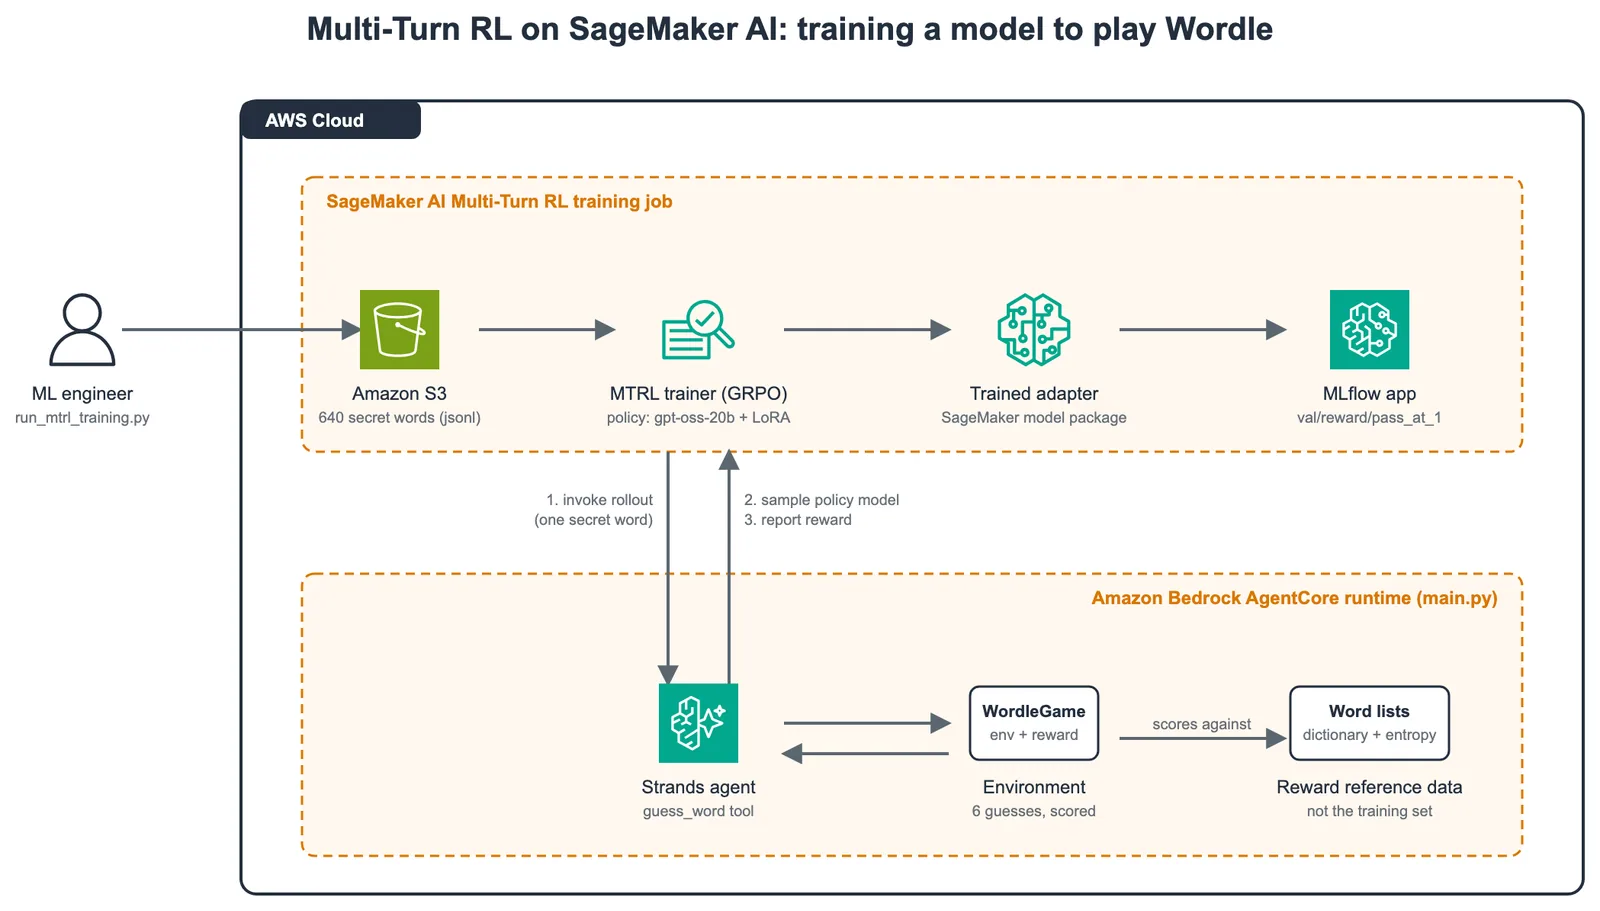
Dalam setiap rollout, MTRL memanggil runtime AgentCore membawa satu baris data training (berisi satu kata rahasia). Agent di dalam runtime manggil policy model lewat endpoint OpenAI-compatible milik SageMaker Job Runtime. Model bakal nebak kata lewat fungsi tool guess_word, dapet umpan balik warna huruf (hijau, kuning, abu-abu), lalu ngelanjutin strategi sampai menang atau jatah tebakan habis. Setelah selesai, agent ngirim satu skor reward balik ke SageMaker AI. Metode Group Relative Policy Optimization (GRPO) bakal membandingkan variasi reward dari beberapa rollout kata yang sama buat ngupdate adapter LoRA di policy model.
Ada tiga prinsip desain penting di sistem ini:
- Agent dan reward disatukan: Satu file Python di AgentCore nampung environment, definisi tool, dan fungsi scoring.
- Dataset cuma nyimpen kata rahasia: Daftar kata diambil dari SCOWL open-source dan cuma dipakai buat validasi tebakan, bukan buat ngajarin kunci jawaban ke model.
- Reward fokus pada hasil (outcome-dominant): Menang dapet poin gede (+1.05 sampai +1.55 tergantung kecepatan), kalah dapet -0.5, dan kalau bengong tanpa nebak kena penalti -1.5.
Model yang Didukung dan Rincian Biaya Training
MTRL di SageMaker AI sifatnya serverless. Kamu nggak perlu pusing milih tipe instance GPU atau ngatur ukuran cluster. Kamu cukup milih base model yang didukung, dan sistem otomatis nyiapin infrastrukturnya.
Berikut model dasar yang didukung beserta ketersediaan Region AWS saat pengujian:
| Base Model | AWS Region |
|---|---|
| Amazon Nova 2 Lite | US East (N. Virginia), US West (Oregon) |
| GPT-OSS-20B | US East (N. Virginia), US West (Oregon) |
| Gemma 4 31B (instruction-tuned) | US West (Oregon) |
| Qwen 3.6 27B | US West (Oregon) |
Biaya training dihitung murni dari penggunaan token per 1 juta token pada tiga dimensi:
- Prefill: Token input yang dibaca model. Bagian ini numpuk terus karena tiap turn agent harus baca ulang riwayat tebakan sebelumnya.
- Sample: Token output yang digenerate model, termasuk reasoning token.
- Train: Token yang diproses pada backward pass buat ngupdate adapter LoRA.
Pada eksperimen 100-step AWS pakai GPT-OSS-20B, total ada 105.486 rollout selama 12 jam 40 menit. Rincian biayanya seperti ini:
| Dimensi Token | Jumlah Token | Harga per 1M Token | Total Biaya |
|---|---|---|---|
| Prefill | 491.616.806 | $0.12 | $58.99 |
| Sample | 159.737.098 | $0.30 | $47.92 |
| Train | 643.308.554 | $0.36 | $231.59 |
| Total Token | 1.294.662.458 | - | $338.50 |
Biaya training paling boros ada di dimensi train karena ngikutin panjang trajectory. Selain token SageMaker, runtime AgentCore kena biaya komputasi vCPU dan memori sekitar $79 di CloudWatch. Jadi total modal eksperimen ini sekitar $417.50.
Langkah Praktis Setup dan Training Agent SageMaker
Kalau kamu tertarik nyobain pipeline ini dari kode di aws-samples repository, berikut langkah-langkah terstrukturnya:
1. Siapkan Prasyarat dan IAM Role
Pastikan lokal komputermu sudah terpasang Python 3.10+, package manager uv, Node 20+, AgentCore CLI (npm install -g @aws/agentcore), dan botocore versi 1.43.37 ke atas (versi pertama yang ngedukung operasi AgentRFT). Kamu butuh bucket Amazon S3 di region yang sama dengan training job.
Kamu butuh dua IAM role:
- Agent Runtime Role: Dibuat otomatis pas deploy AgentCore, nge-trust
bedrock-agentcore.amazonaws.comdan punya policyAmazonSageMakerJobRuntimeAccess. - Training Job Role: Role yang kamu bikin manual. Role ini wajib nge-trust
job.sagemaker.amazonaws.com(ingat, pakai prefixjob., bukan cumasagemaker.amazonaws.com) dengan actionsts:AssumeRoledansts:TagSession, serta policyAmazonSageMakerJobFullAccess.
2. Deploy Agent ke Amazon Bedrock AgentCore
Clone repository contoh, atur account ID dan region AWS di konfigurasi, lalu deploy via CLI:
git clone https://github.com/aws-samples/sample-multi-turn-rl-wordle
cd sample-multi-turn-rl-wordle/Wordle
agentcore validate
agentcore deploy
CLI bakal nge-build dependency ke platform Linux ARM64 dan nge-deploy CloudFormation stack.
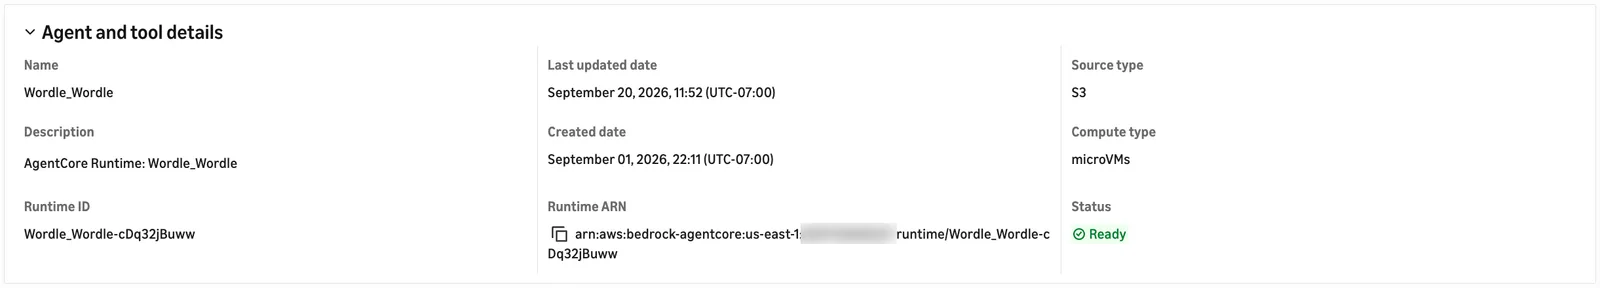
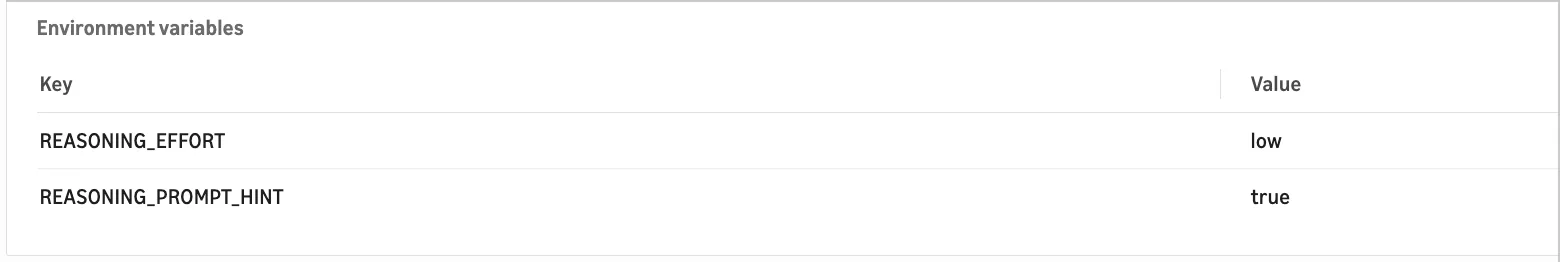
Di dalam file agentcore.json, ada pengaturan environment variable penting: REASONING_EFFORT=low dan REASONING_PROMPT_HINT=true. Pengaturan ini memangkas konsumsi token sampling antara 63 sampai 83 persen dibanding reasoning medium, tanpa ngasih bocoran kata sama sekali.
Struktur kode main.py intinya membungkus handler fungsi dengan dekorator khusus:
app = BedrockAgentCoreApp()

@app.entrypoint  # Wajib paling luar: ngejalanin HTTP server AgentCore
@sagemaker_rft_handler  # Ngirim reward balik ke SageMaker AI
def handle_rollout(payload):
    prompt, answer = parse_task(payload["prompt"])
    game = WordleGame(answer)

    @tool
    def guess_word(guess: str) -> str:
        """Kirim tebakan 5 huruf dan terima feedback warna."""
        return game.guess(guess)

    agent = Agent(model=build_model(), system_prompt=SYSTEM_PROMPT, tools=[guess_word])
    agent(prompt)
return {"reward": game.final_reward()}3. Uji Coba Runtime (Smoke Test)
Sebelum buang-buang kuota GPU, jalankan smoke test pakai payload bohongan (payload.json) dari repository. Edit account ID kamu, lalu tembak lewat AWS CLI:
ACCOUNT=$(aws sts get-caller-identity --query Account --output text)
sed "s/111122223333/$ACCOUNT/" payload.json > /tmp/payload.json

aws bedrock-agentcore invoke-agent-runtime \
  --agent-runtime-arn <RUNTIME_ARN> \
  --runtime-session-id smoke-test-$(date +%s)000000000000000 \
  --payload fileb:///tmp/payload.json /dev/stdout
Perintah ini bakal mencetak {"reward": -1.5} dan memunculkan error 400 "Could not find job" di CloudWatch logs. Ini pertanda bagus! Artinya alur parsing payload, autentikasi, dan error handling agent kamu udah berfungsi normal.
4. Siapkan Dataset dan Jalankan Training
Dataset MTRL sangat simpel dan nggak butuh transkrip percakapan buatan manusia. Cukup file JSONL yang tiap barisnya berisi string prompt, kata kunci jawaban (answer), dan id unik. Unggah 640 baris data training dan 128 baris data validasi ke bucket S3 kamu.
Jalankan training script menggunakan MultiTurnRLTrainer dari SDK sagemaker-train:
uv run python run_mtrl_training.py \
  --model openai-reasoning-gpt-oss-20b \
  --agent-runtime-arn <RUNTIME_ARN> \
  --role-arn arn:aws:iam::<ACCOUNT>:role/<JOB_ROLE> \
  --train-dataset s3://<YOUR_BUCKET>/wordle-mtrl/train/training-data.jsonl \
  --val-dataset s3://<YOUR_BUCKET>/wordle-mtrl/validation/validation-data.jsonl \
  --s3-output-path s3://<YOUR_BUCKET>/wordle-mtrl/output/ \
  --mlflow-app-arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>
Nilai sampling_max_tokens diatur mentok ke 8192 karena pada angka default 4096, model sering kehabisan token reasoning sebelum sempat manggil tool pertamanya. Dengan max_steps 100 dan group_size 8, model memainkan 1.024 sesi game per langkah training.
Evaluasi Model dan Trik Monitoring di MLflow
Selama training berjalan, pantau metrik lewat MLflow. Metrik kunci yang wajib diperhatikan adalah val/reward/pass_at_1 (persentase kata uji coba yang berhasil dipecahkan).
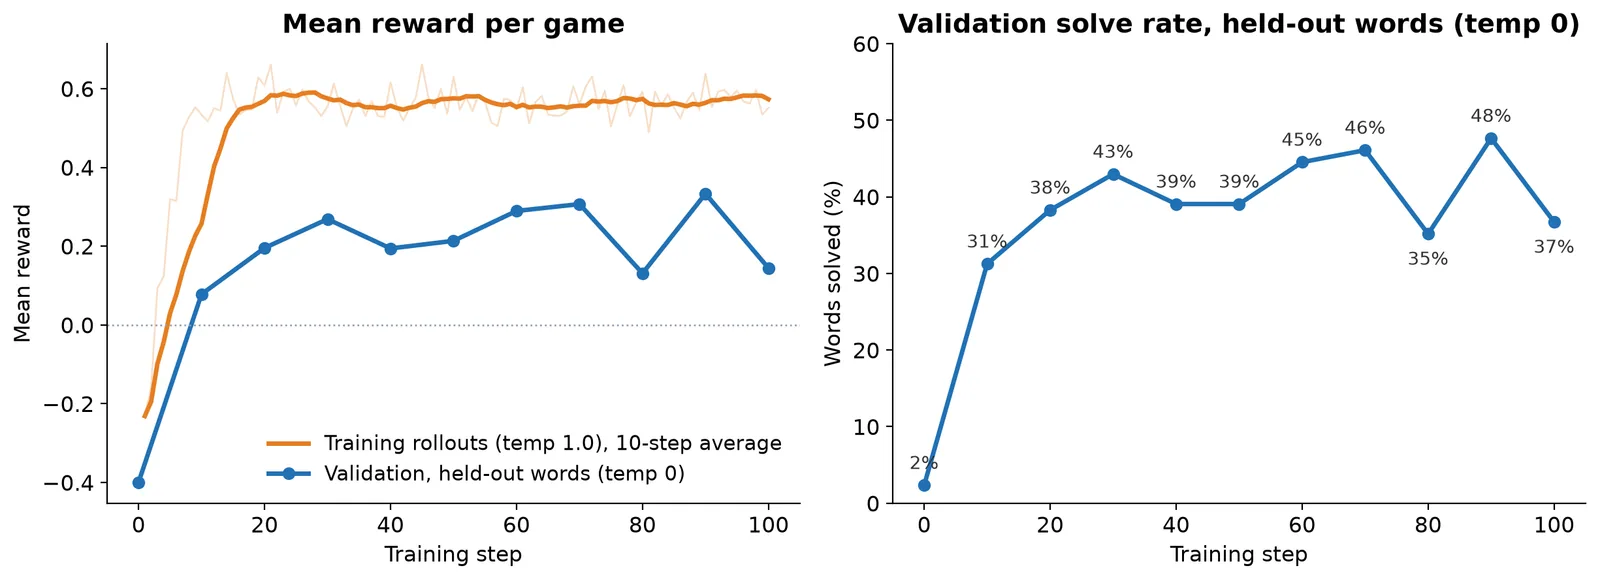
Rata-rata reward training naik ke angka +0.57 dalam 15 step pertama lalu stabil. Di data validasi, solve rate melonjak dari 2 persen jadi 31 persen di 10 step pertama, lalu bergerak di kisaran 35 hingga 48 persen.
Saat evaluasi rollout di CloudWatch, model yang sudah terlatih memperlihatkan perilaku cerdas: mempertahankan huruf hijau di posisi yang pas, membuang huruf abu-abu, dan memanfaatkan huruf kuning untuk menyeleksi kata berikutnya—tanpa pernah diajari aturan itu secara manual lewat teks.
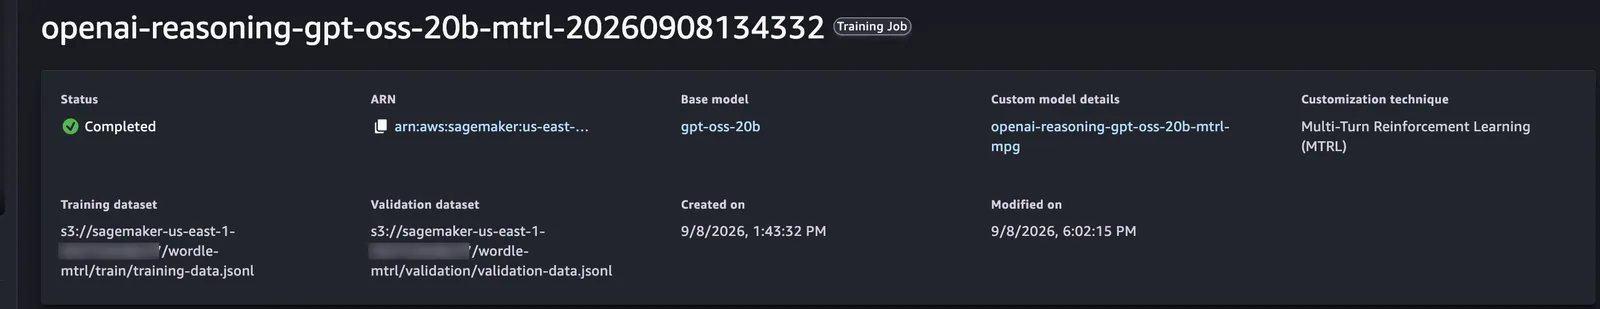
Setelah selesai, jalankan evaluation job terpisah (AgentRFTEvaluation). Kamu bisa membandingkan base model vs model hasil training pada variasi reasoning effort dan sampling temperature.
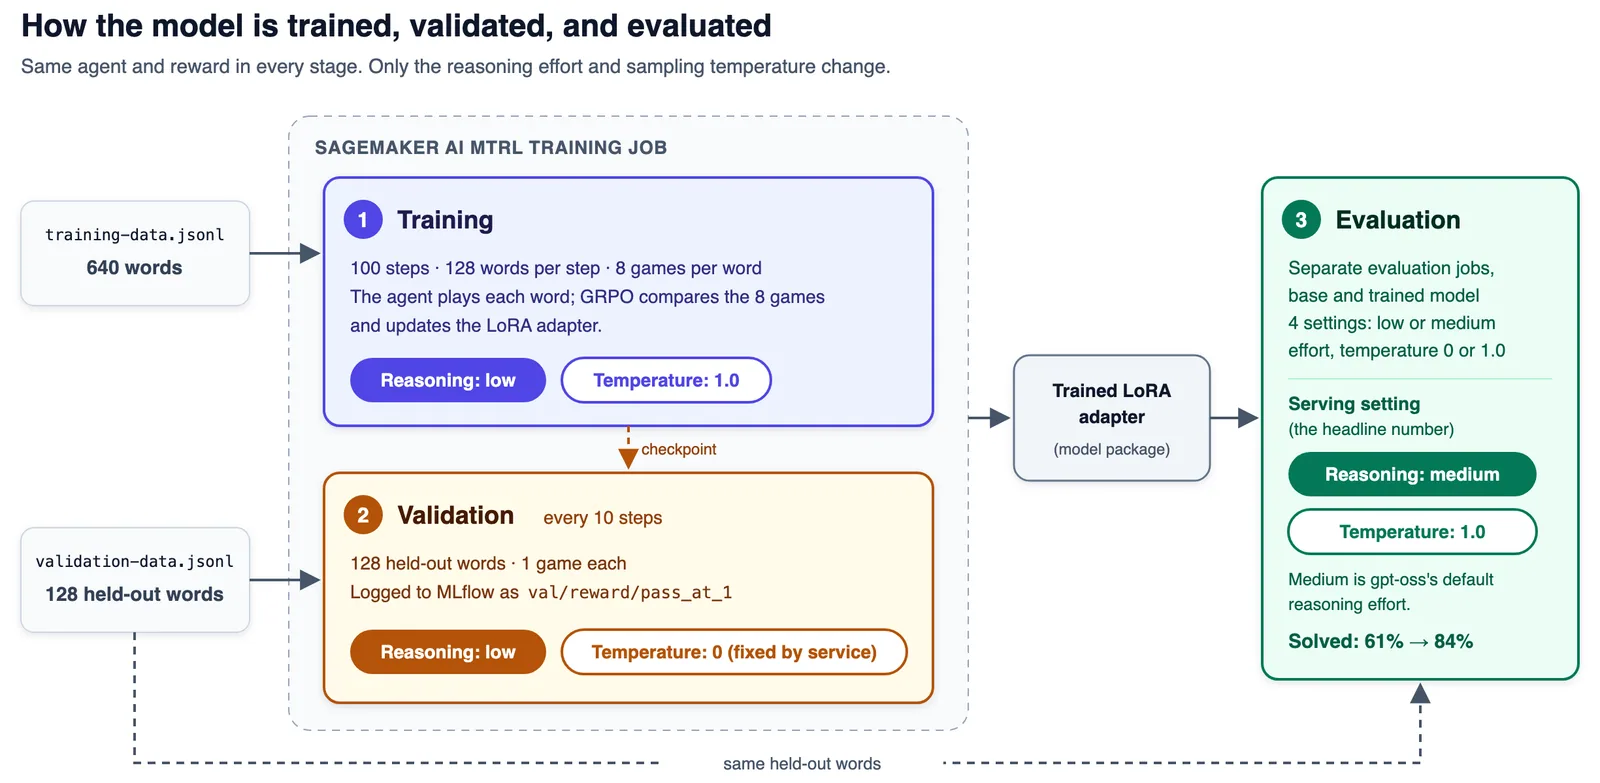

Hasil evaluasi menunjukkan insight menarik: pada temperature 0 (greedy decoding), kedua model sering macet. Tapi di temperature 1.0 (kondisi serving riil), model terlatih mampu memecahkan 84 persen kata rahasia pada reasoning medium (naik dari 61 persen pada base model), dan memecahkan 69 persen pada reasoning low (naik drastis dari cuma 15 persen pada base model).
Kalau kamu lagi merancang arsitektur agen di cloud, kamu juga bisa membaca artikel kami tentang Multi-Agent AI Produksi di AWS dan eksplorasi SageMaker AI Training Session untuk referensi pelengkap.
Jebakan Desain Reward: Jangan Sampai Agent Cari Celah!
Merancang fungsi reward untuk tugas multi-turn itu gampang-gampang susah. Kesalahan paling fatal yang sempat dialami tim AWS adalah menjumlahkan poin per tebakan secara mentah.
Akibatnya muncul anomali konyol:
- Agent yang kalah setelah main 6 ronde malah dapet reward positif (+0.49) karena ngumpulin bonus eksplorasi huruf tiap giliran.
- Menebak benar di ronde ke-3 dapet skor lebih tinggi (+1.61) daripada menebak benar langsung di ronde ke-1 (+0.99), karena agent dapet bonus langkah tambahan!
Solusinya adalah membagi reward jadi dua komponen: outcome utama yang dominan dan shaping bonus bernilai kecil:
$$\text{reward} = \text{outcome} + w \times \text{clip}(\text{shaping}, -1, 1)$$
Bobot $w$ dipatok sangat kecil (0.04 kalau menang, 0.15 kalau kalah). Nilai outcome dipatok:
- Menang di tebakan ke-$n$: $1.05 + 0.5 \times (6 - n) / 5$ (skor 1.55 di tebakan 1 turun ke 1.05 di tebakan 6).
- Kalah setelah 6 tebakan: -0.5.
- Gagal nebak secara valid: -1.5.
Dengan rumus ini, menang cepat selalu dapet skor lebih tinggi daripada menang lambat, menang selalu ngalahin kalah, dan shaping bonus tetap berguna memberi sinyal variasi ke algoritma GRPO saat membandingkan dua sesi yang sama-sama kalah.
Berikut contoh template instruksi agent yang bisa kamu terapkan saat merancang prompt interaksi tool serupa:
Kamu adalah agen pemecah kata 5 huruf. Gunakan tool `guess_word` untuk menguji kata tebakan.Aturan:1. Manfaatkan informasi huruf hijau di posisi yang sama.2. Jangan gunakan kembali huruf abu-abu yang terbukti salah.3. Uji posisi baru untuk setiap huruf kuning.Tujuanmu adalah menyelesaikan tugas dalam sesedikit mungkin langkah.
Masalah Teknis yang Sering Muncul dan Solusinya
Berdasarkan catatan tim AWS, ada beberapa kendala teknis nyata yang siap menghadang kalau kamu coba menjalankan pipeline ini:
- Kelebihan Beban Bearer Token: Menghasilkan bearer token pakai sesi botocore baru di tiap panggilan bakal bikin credential provider kolaps pas ada 32 rollout bersamaan. Solusinya: pakai satu sesi yang self-refreshing dengan cache pendek.
- Rollout Nyangkut Bikin Seluruh Job Gagal: Jika agent gagal manggil policy model karena kendala autentikasi atau timeout, layanan bakal mematikan seluruh training job dengan pesan "No sampling requests were received". Pastikan agent selalu mengembalikan angka reward (misalnya -1.5), jangan sampai melempar error status unhandled.
- Model Halusinasi Format Tool Call: Jika learning rate terlalu tinggi, model bisa mendadak nulis format pemanggilan tool sebagai teks biasa alih-alih JSON tool call resmi. Parser di agent harus disiapkan untuk mengekstrak tebakan dari teks mentah sambil memberi sedikit penalti format agar gradient tidak hilang.
- Plateau di Tengah Jalan: Skor training cenderung stabil setelah step 15. Untuk eksplorasi lebih lanjut, kamu bisa menerapkan kurikulum training bertahap atau memperbesar
group_sizedi atas 8.
Dampak Nyata untuk Developer dan Tim AI di Indonesia
Buat developer, engineer, dan startup di Indonesia, hadirnya panduan Multi-Turn RL di SageMaker AI ini ngasih arah baru dalam otomatisasi bisnis. Selama ini kita sering ketergantungan sama model komersial berukuran raksasa yang biaya token per bulannya bikin boncos kalau dipakai bolak-balik manggil tool.
Dengan teknik MTRL ini, kamu bisa ngelatih model open-weights berukuran sedang (seperti 20B–30B parameter) agar punya keahlian setara model frontier dalam menyelesaikan alur kerja internal yang sangat spesifik—misalnya rekonsiliasi data perbankan lokal, otomasi tiket customer care berbahasa daerah, atau alur ERP pabrik.
Selain itu, aspek privasi dan kepatuhan regulasi UU Perlindungan Data Pribadi (UU PDP) jadi jauh lebih terjaga. Dataset internal dan model yang kamu latih tetap berada di dalam akun AWS sendiri dan nggak dipakai buat ngelatih model publik vendor lain.
Kalau kamu pengin mulai bereksperimen menguji keandalan berbagai model reasoning (seperti GPT, Claude, DeepSeek, atau Qwen) sebelum berkomitmen sewa infrastruktur training sendiri, kamu bisa memanfaatkan layanan Classai Router. Cukup pakai satu API key yang kompatibel dengan format SDK OpenAI, kamu bisa langsung membandingkan performa model kayak qwen-3.8-27b (Rp810 / 1M token input) atau deepseek-v4.1-flash (Rp1.155 / 1M token input) buat nemuin kandidat base model yang paling pas buat kebutuhan bisnismu. Kamu juga bisa mengasah kemampuan pengembangan solusi AI secara mendalam lewat kelas AI untuk Developer di Classai.
Sumber & referensi
- 01
AWS · 24 Oktober 2026
Multi-Turn Reinforcement Learning on Amazon SageMaker AI: A hands-on guide
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa bedanya Multi-Turn RL dengan fine-tuning biasa?
Fine-tuning biasa (SFT) melatih model berdasarkan pasangan prompt dan jawaban tunggal. Sebaliknya, Multi-Turn RL melatih model untuk mengambil serangkaian keputusan berurutan, lalu menilai keberhasilan berdasarkan skor reward di akhir seluruh alur interaksi.
Model apa saja yang didukung oleh MTRL SageMaker AI?
Saat ini MTRL di SageMaker AI mendukung model open-weights berbasis LoRA adapter, antara lain Amazon Nova 2 Lite, GPT-OSS-20B, Gemma 4 31B (instruction-tuned), dan Qwen 3.6 27B di region US East (N. Virginia) dan US West (Oregon).
Berapa perkiraan biaya melatih agent pakai teknik ini?
Pada pengujian 100-step Wordle menggunakan GPT-OSS-20B, biaya pemrosesan token training mencapai sekitar $338.50 untuk 1,29 miliar token, ditambah biaya vCPU/memori Amazon Bedrock AgentCore sekitar $79.
Mengapa reward shaping harus dirancang hati-hati?
Jika bonus per langkah (shaping) terlalu besar, agent bisa mengeksploitasi sistem dengan sengaja memperpanjang langkah interaksi demi mengumpulkan poin tambahan, meskipun akhirnya gagal menyelesaikan misi utama.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.