Ray LLM Amazon EKS Rilis: Multi-Node Inference LLM Tanpa Ribet
AWS merilis Ray LLM Deep Learning Containers untuk multi-node inference di Amazon EKS. Pisahkan prefill dan decode tanpa pusing mikirin setup CUDA.
· 10 menit baca
Inti singkat
- AWS meluncurkan Ray LLM Deep Learning Containers untuk multi-node inference di Amazon EKS tanpa setup dependensi manual.
- Teknik prefill/decode disaggregation memisahkan beban kerja komputasi berat dan generasi token ke node GPU berbeda.
- Transfer KV-cache antar-node berjalan kencang memakai NIXL dan AWS Elastic Fabric Adapter berbasis Libfabric.
- Konfigurasi serving berjalan sepenuhnya lewat YAML deklaratif dengan endpoint yang kompatibel dengan format API OpenAI.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
AWS resmi ngerilis Ray LLM Deep Learning Containers (DLC) untuk multi-node inference di Amazon EKS, solusi praktis buat memisahkan fase prefill dan decode ke beberapa node GPU tanpa ribet setup driver. Pembaruan ini bikin tim engineering bisa menjalankan model bahasa berukuran besar di infrastruktur cloud dengan latensi yang jauh lebih stabil.
Kalau kamu pernah nyobain deploy model open-weight sendiri di Kubernetes, kamu pasti tahu betapa bikin frustrasinya ngurusin dependensi GPU. Begitu modelnya makin gede dan butuh lebih dari satu mesin, kerumitannya langsung melonjak drastis. Masalah kompatibilitas versi CUDA, library NCCL, sampai urusan transfer data antarmesin sering kali makan waktu berhari-hari sebelum aplikasimu benar-benar jalan.
Lewat pengumuman terbaru di AWS Machine Learning Blog, AWS menghadirkan wadah siap pakai yang memadukan Ray Serve, vLLM, dan akselerasi jaringan Elastic Fabric Adapter (EFA). Yuk, kita bedah bareng-bareng apa itu arsitektur multi-node disaggregation dan gimana cara pasangnya di EKS.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Kenapa Menjalankan Model AI Skala Besar di Satu GPU Mulai Kerepotan?
Menjalankan model AI modern saat ini bukan cuma soal muat atau nggak di memori VRAM. Banyak tim developer yang mendapati respons model mereka mendadak lelet pas nerima prompt panjang, padahal kartu grafis yang dipakai udah kelas enterprise. Kenapa hal ini bisa terjadi?
Jawabannya ada pada siklus hidup inference model itu sendiri. Proses pengolahan prompt di dalam model bahasa terbagi jadi dua fase yang sifat karakternya bertolak belakang:
- Fase Prefill: Fase di mana model membaca seluruh prompt input sekaligus secara paralel buat nyusun Key-Value (KV) cache. Tahap ini sangat compute-bound alias butuh tenaga komputasi GPU yang luar biasa besar.
- Fase Decode: Fase di mana model memproduksi kata demi kata secara berurutan (token-by-token) sambil membaca KV-cache tadi. Tahap ini bersifat memory-bandwidth bound, alias lebih bergantung pada kecepatan transfer memori ketimbang tenaga hitung murni.
Kalau kedua fase ini dipaksa jalan barengan di satu GPU yang sama, mereka bakal saling sikut. Setiap kali ada request masuk dengan prompt dokumen yang panjang—seperti pada use case Retrieval-Augmented Generation (RAG) atau summarization—proses prefill yang rakus komputasi bakal menghentikan sejenak proses decode dari user lain. Hasilnya, user lain bakal ngerasain stuttering atau latensi generasi token yang tiba-tiba melambat.
Solusi Cerdas: Prefill/Decode (PD) Disaggregation
Buat mengatasi masalah rebutan sumber daya tadi, komunitas machine learning menciptakan pola arsitektur yang dinamakan Prefill/Decode (PD) disaggregation. Idenya simpel tapi brilian: kita pisahkan mesin pemroses prefill dan mesin pemroses decode ke node fisik atau GPU yang berbeda.
Dengan memisahkan kedua fase ini, GPU decode bisa terus memproduksi token dengan ritme yang konsisten tanpa pernah terganggu oleh prompt masuk yang panjang. Beban kerja komputasi tinggi terisolasi rapi di GPU prefill. Masing-masing bagian juga bisa di-scale secara independen sesuai profil traffic aplikasi kamu.
Namun, ada satu tantangan teknis yang cukup berat: KV-cache yang udah dihitung di node prefill harus dikirim secepat kilat ke node decode. Kalau transfer jaringan antarnode ini lambat, keuntungan performa dari pemisahan tugas tadi bakal hilang sia-sia tergerus oleh latensi jaringan. Di sinilah perangkat keras jaringan berkecepatan tinggi seperti AWS EFA dan library transfer khusus jadi penentu utama.
Apa yang Disediakan oleh Ray LLM Deep Learning Container AWS?
Menyiapkan tumpukan software untuk inference terdistribusi biasanya butuh waktu lama karena kamu harus mencocokkan puluhan pustaka kode. Lewat deep learning container aws terbaru ini, AWS udah ngebungkus semuanya ke dalam satu image Docker siap tarik yang sudah dites dan ditambal keamanannya.
Di dalam container ini, kamu langsung dapet komponen-komponen terbaik di industrinya:
- vLLM: Engine inference berkecepatan tinggi yang menangani komputasi tensor dan manajemen memori paged-attention.
- Ray Serve: Framework komputasi terdistribusi yang ngatur routing request HTTP dan membagi beban ke berbagai worker.
- NVIDIA Inference Transfer Library (NIXL): Library khusus performa tinggi yang bertugas memindahkan KV-cache antarnode secara langsung.
- EFA Stack (libfabric dan aws-ofi-nccl): Driver jaringan bypass-kernel dari AWS yang memungkinkan transfer data antarnode berkecepatan tinggi dengan latensi super rendah.
- OpenAI-Compatible HTTP Layer: Endpoint bawaan yang langsung cocok dengan format JSON request OpenAI, jadi kamu nggak perlu nulis API wrapper sama sekali.
Menariknya lagi, kamu nggak perlu nulis class handler Python yang rumit atau bikin image container kustom. Ray Serve LLM menyediakan builder bawaan bernama build_pd_openai_app yang memungkinkan seluruh konfigurasi diatur hanya lewat satu file YAML deklaratif.
Membedah Arsitektur Multi-Node Ray LLM di Amazon EKS
Untuk menjalankan setup ini, arsitektur cluster dirancang agar memisahkan antara beban kerja sistem manajemen dan beban kerja komputasi inferensi GPU.
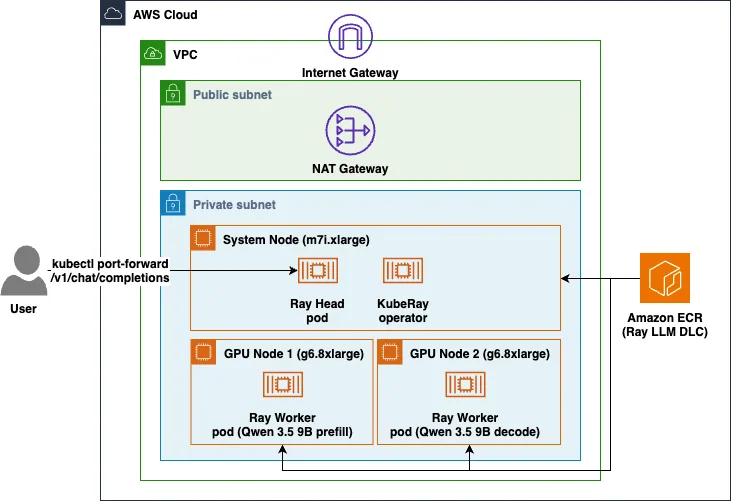
Dalam rancangan ini, cluster Amazon EKS ditempatkan di dalam Virtual Private Cloud (VPC) dengan subnet privat yang memiliki akses internet keluar via NAT Gateway. Komponen cluster dibagi menjadi dua kelompok node:
- CPU System Node (Instance m7i.xlarge): Bertindak sebagai pengelola sistem. Node ini menjalankan add-on Kubernetes standar, KubeRay operator, dan pod Ray head (tanpa alokasi GPU). Ray head berfungsi menerima request HTTP pertama kali dari user sebelum membagikannya ke worker.
- GPU Worker Nodes (Dua Instance g6.8xlarge): Menjalankan pod Ray worker yang menarik image Ray LLM DLC dari Amazon Elastic Container Registry (ECR). Satu node ditugaskan khusus untuk melayani fase prefill, sementara satu node lainnya melayani fase decode.
KubeRay operator secara otomatis mengawasi resource custom RayService yang kita deploy dan menyambungkan pod worker ke pod head tanpa campur tangan manual. Aliran KV-cache dari worker prefill ke worker decode mengalir lewat protokol NIXL dengan memanfaatkan kartu jaringan EFA.
Menelaah Konfigurasi RayService dan NIXL
Kunci utama dari lancarnya orkestrasi ini terletak pada blok konfigurasi serveConfigV2 di dalam file manifest Kubernetes. Berkat fungsi bawaan ray.serve.llm:build_pd_openai_app, kamu cukup mendefinisikan parameter kedua worker seperti ini:
applications:
  - name: qwen
    import_path: ray.serve.llm:build_pd_openai_app
    route_prefix: /
    args:
      prefill_config:
        model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
        engine_kwargs:
          max_model_len: 4096
          dtype: bfloat16
          gpu_memory_utilization: 0.90
          enforce_eager: true
        kv_transfer_config:
          kv_connector: NixlConnector
          kv_role: kv_both
          engine_id: prefill
          kv_connector_extra_config: { backends: ["LIBFABRIC"] }
        deployment_config: { num_replicas: 1 }
      decode_config:
        model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
        engine_kwargs:
          max_model_len: 4096
          dtype: bfloat16
          gpu_memory_utilization: 0.90
          enforce_eager: true
        kv_transfer_config:
          kv_connector: NixlConnector
          kv_role: kv_both
          engine_id: decode
          kv_connector_extra_config: { backends: ["LIBFABRIC"] }
        deployment_config: { num_replicas: 1 }
Beberapa parameter teknis di atas punya peran yang sangat krusial:
max_model_len: 4096membatasi ukuran konteks agar muat dalam alokasi KV-cache di memori GPU.enforce_eager: truesengaja dinyalakan buat melewati fase capture CUDA graph, yang efektif memangkas lonjakan konsumsi VRAM puncak.kv_connector: NixlConnectorbersamabackends: ["LIBFABRIC"]memastikan transfer cache berjalan lewat jalur cepat hardware EFA. Kalau baris libfabric ini terlewat, NIXL bakal mundur ke koneksi soket UCX biasa yang kecepatannya setara TCP standar.- Pada level pod Kubernetes, container wajib diberi izin
privileged: true. Langkah ini mutlak diperlukan karena NIXL mendaftarkan alamat VRAM CUDA langsung ke Network Interface Card (NIC) milik EFA, sehingga batas izin standar Linux sepertiIPC_LOCKaja nggak bakal cukup.
Selain itu, sistem ini memanfaatkan caching memori halaman sistem operasi (OS page cache). Pada pengujian model Qwen3.5-9B di instance g6.8xlarge, waktu muat ulang bobot model (weight loading) saat container restart anjlok drastis dari sekitar 145 detik menjadi cuma sekitar 2 detik aja.
Panduan Praktis: Deploy Model EKS Langkah Demi Langkah
AWS membagikan script instalasi otomatis di repositori pendukungnya. Sebelum mulai, pastikan kamu udah punya akun AWS aktif dengan kuota instance g6.8xlarge minimal 64 vCPU di region target, serta tool CLI seperti aws, kubectl, eksctl, helm, dan envsubst di komputer kamu.
Berikut langkah-langkah instalasinya secara berurutan:
1. Siapkan Variabel Lingkungan dan Cluster EKS
Clone repositori contoh dari AWS dan muat file konfigurasinya:
cd ray-serve-multi-node/scripts
source ./env.sh
./deploy_cluster.sh
Script ini memakan waktu sekitar 15–20 menit untuk membuat VPC, cluster EKS, add-on jaringan, dan CPU node group penampung KubeRay operator.
2. Tambahkan GPU Node Group dengan Dukungan EFA
Jalankan pembuatan kelompok node worker GPU:
./deploy_node_group.shProses ini memerlukan waktu 5–20 menit untuk memicu dua instance g6.8xlarge, mengaktifkan adapter jaringan EFA, serta memasang plugin device EFA agar Kubernetes mengenali resource vpc.amazonaws.com/efa.
3. Pasang KubeRay Operator
Pasang operator pengelola siklus hidup cluster Ray dengan helm:
./install_kuberay.shLangkah ini cuma butuh waktu 1–2 menit dan dipasang di atas CPU node group agar tidak memakan jatah kartu grafis.
4. Luncurkan Aplikasi RayService
Deploy model bahasa ke dalam cluster:
./deploy_ray_service.shKubeRay bakal membuat pod head dan dua pod worker GPU. Kamu bisa memantau status kesiapan pod dan penempatan node dengan perintah:
./deploy_ray_service.sh status5. Uji Coba Endpoint Model
Setelah aplikasi melaporkan status RUNNING, buka akses port service ke komputer lokal kamu:
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000Sekarang, kamu bisa langsung ngetes endpoint tersebut memakai perintah curl standar layaknya memanggil API komersial:
curl --silent --request POST "http://127.0.0.1:8000/v1/chat/completions" \ --header "Content-Type: application/json" \ --data '{ "model": "qwen3.5-9b", "messages": [ {"role": "user", "content": "Jelaskan keuntungan memisahkan fase prefill dan decode pada model bahasa!"} ], "max_tokens": 200, "temperature": 0.7 }'
Kamu bisa memverifikasi status backend jaringan lewat log pod worker dengan baris perintah ini:
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
  grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
Jika setup kamu sukses, kamu bakal melihat teks LIBFABRIC tercatat di log container.
Perbandingan: Self-Hosting di EKS vs Layanan Managed API
Memutuskan apakah kamu harus mengelola cluster Kubernetes sendiri atau memakai API terpadu sangat bergantung pada kebutuhan skala dan kapabilitas tim engineering kamu. Berikut gambaran perbandingannya:
| Aspek Penilaian | Ray LLM di Amazon EKS | Managed API (seperti Classai Router) |
|---|---|---|
| Kontrol Infrastruktur | Penuh (bisa otak-atik bobot, driver, VRAM) | Terisolasi (cukup pakai endpoint) |
| Kompleksitas Operasional | Tinggi (butuh skill EKS, Helm, kuota GPU) | Sangat mudah (cukup simpan satu API key) |
| Struktur Biaya | Tetap per jam sewa instance GPU AWS | Berbasis konsumsi token aktual per request |
| Kemudahan Scaling | Butuh penyesuaian node pool & KubeRay | Skala otomatis tanpa mikir kapasitas node |
| Batas Model | Tergantung ukuran memori instance yang disewa | Bebas ganti model frontier kapan saja |
Kalau tim kamu butuh menjalankan model khusus dengan keamanan data ketat di dalam VPC perusahaan, solusi deploy model eks dengan Ray LLM DLC adalah pilihan yang sangat solid. Tapi kalau tujuan utamamu adalah memvalidasi fitur AI ke pengguna secepat mungkin tanpa pusing mikirin biaya sewa GPU yang terus berjalan saat aplikasi sepi, memanfaatkan layanan agregator API model jauh lebih masuk akal.
Buat developer yang pengin langsung bereksperimen dengan model-model open-weight hebat dari seri Qwen tanpa repot mengelola klaster cloud, kamu bisa langsung mencoba model seperti qwen3.7-plus (Rp810 / Rp3.630 per 1M token) atau qwen3.8-max (Rp1.950 / Rp9.720 per 1M token) melalui Classai Router. Cukup pakai satu API key standar tanpa perlu pusing ngurusin driver CUDA.
Kalau kamu tertarik mendalami arsitektur aplikasi AI, integrasi agent, dan teknik prompt production-ready, kamu juga bisa melihat modul praktis di kelas AI untuk Developer yang dirancang khusus buat tim pengembang software di Indonesia.
Dampak Nyata Buat Tim Developer dan Bisnis di Indonesia
Peluncuran wadah container ini membawa angin segar buat ekosistem pengembang teknologi di tanah air, terutama dalam aspek efisiensi biaya dan kepatuhan regulasi:
- Kepatuhan Privasi dan UU PDP: Perusahaan perbankan, layanan kesehatan, dan fintech di Indonesia yang terikat regulasi perlindungan data pribadi (UU PDP) kerap dilarang mengirimkan data nasabah ke API pihak ketiga di luar negeri. Menggelar model open-source di dalam VPC privat EKS sendiri memastikan data transaksi tidak pernah keluar dari perimeter keamanan internal.
- Pengurangan Beban Kerja Tim DevOps: Sebelumnya, tim engineer lokal sering menghabiskan waktu berminggu-minggu cuma buat mengompilasi driver GPU dan mengatasi version drift antar-library. Dengan tersedianya image container teruji dari AWS, tim tech bisa langsung melompat ke tahap delivery produk.
- Efisiensi Biaya GPU Cloud: Dengan arsitektur prefill/decode disaggregation, perusahaan tidak perlu langsung menyewa mesin GPU super mahal bertingkat-tingkat untuk use case RAG dokumen internal. Penggunaan instance yang terpisah dan terarah bikin pemanfaatan komputasi jauh lebih optimal.
Setelah selesai melakukan uji coba teknis, jangan lupa buat membersihkan seluruh resource cloud kamu agar tidak terkena tagihan sewa instance yang tidak terpakai lewat script ./delete_ray_service.sh, ./install_kuberay.sh cleanup, ./delete_node_group.sh, dan ./delete_cluster.sh.
Sumber & referensi
- 01
AWS · 12 Oktober 2026
Run multi-node inference workloads using Ray LLM Deep Learning Containers
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu Ray LLM Deep Learning Container?
Ray LLM DLC adalah image Docker resmi dari AWS yang sudah memaketkan framework vLLM, Ray Serve, library NIXL, dan driver jaringan EFA. Wadah ini dirancang khusus untuk menyederhanakan proses deploy inferensi model bahasa terdistribusi di Amazon EKS tanpa perlu kompilasi dependensi manual.
Mengapa fase prefill dan decode perlu dipisahkan dalam inferensi LLM?
Pemisahan ini penting karena prefill membutuhkan tenaga komputasi intensif untuk memproses prompt panjang, sedangkan decode lebih bergantung pada bandwidth memori untuk mencetak token satu per satu. Dengan memisahkan keduanya ke node berbeda, prompt dokumen yang panjang tidak akan mengganggu kecepatan respons user lain.
Apa fungsi AWS EFA dalam arsitektur multi-node ini?
AWS Elastic Fabric Adapter (EFA) menyediakan jalur komunikasi jaringan berkecepatan tinggi antarnode GPU dengan latensi sangat rendah. Koneksi ini dipakai oleh library NIXL untuk mentransfer data KV-cache dari worker prefill ke worker decode dalam hitungan milidetik.
Apakah endpoint Ray LLM ini kompatibel dengan aplikasi OpenAI yang sudah ada?
Ya, builder aplikasi Ray Serve LLM secara bawaan langsung menyediakan rute API yang kompatibel dengan skema chat-completion OpenAI di port 8000. Kamu bisa langsung mengarahkannya ke aplikasi yang ada tanpa perlu mengubah struktur kode JSON request.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.