Falcon ASR Rilis: Model Transkripsi 1.6B Tembus Akurasi Arab Top
TII ngerilis Falcon ASR, model speech to text 1.6B yang jago transkripsi bahasa Arab dan Inggris. Simak hasil benchmark lengkap dan cara mencobanya di sini.
· 8 menit baca
Inti singkat
- Falcon ASR punya 1,6 miliar parameter dan dikembangkan oleh Technology Innovation Institute (TII) di Abu Dhabi.
- Model ini mencatat rata-rata Word Error Rate 20,92% di enam benchmark bahasa Arab, mengalahkan rekor sebelumnya.
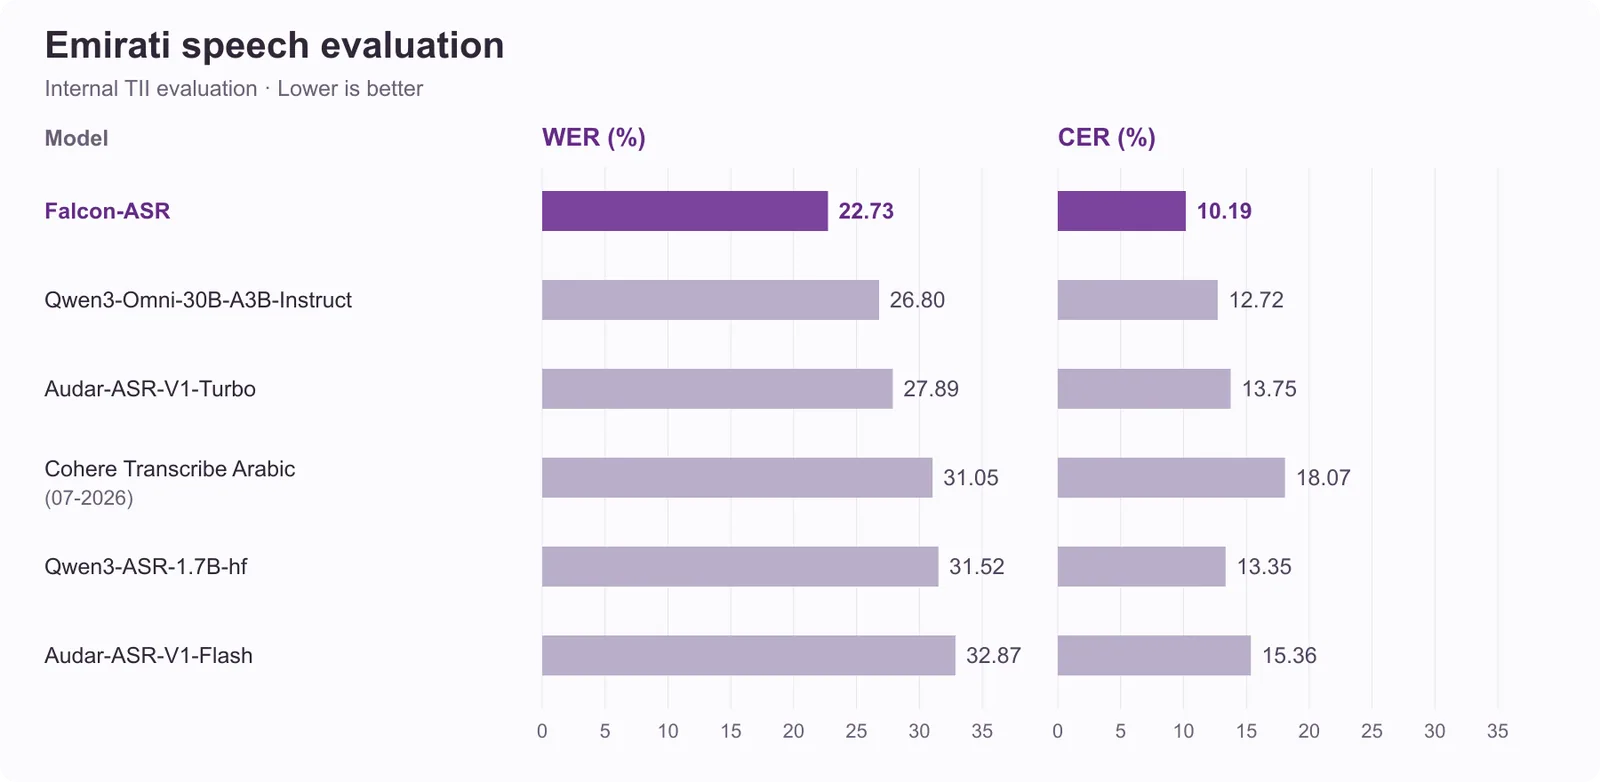
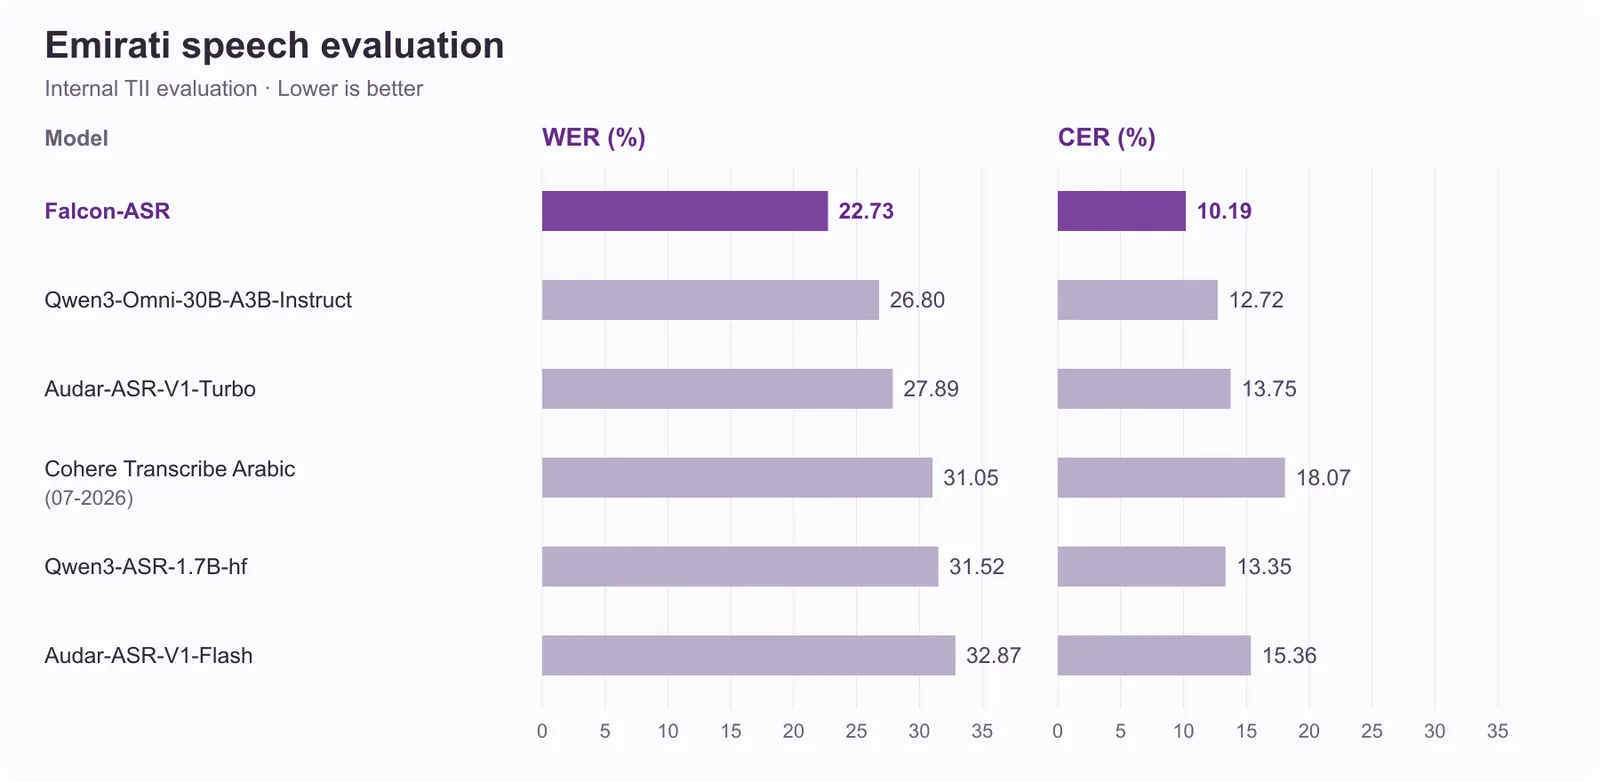
- Pada evaluasi internal dialek Emirati, Falcon ASR unggul 4,07 poin persentase dibanding Qwen3-Omni.
- Selain bahasa Arab, model ini mendukung bahasa Inggris (WER 5,74%), Prancis, Spanyol, dan Portugis dengan bobot yang sama.
- Falcon ASR sudah dilengkapi fitur word-level timestamp dan bisa dicoba langsung lewat Hugging Face Spaces.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Technology Innovation Institute (TII) di Abu Dhabi resmi ngerilis Falcon ASR, model pengenal suara 1,6 miliar parameter yang mencatat rekor akurasi baru untuk transkripsi bahasa Arab dan dialek regional. Model ini dirancang khusus buat menangani percakapan sehari-hari yang rumit sekaligus mendukung transkripsi multibahasa tanpa perlu ganti setelan.
Kabar peluncuran ini diumumkan langsung lewat pengumuman resmi TII di Hugging Face. Buat developer yang sering berkutat dengan pemrosesan audio, urusan transkripsi audio AI di luar bahasa Inggris emang sering bikin pusing. Bahasa Arab khususnya punya tantangan ekstra: ragam dialek lokalnya banyak banget, sementara data transkripsi yang rapi buat latihan AI masih terbilang minim dibanding bahasa standar.
Tim peneliti TII yang beranggotakan Abdul Muneer, Rishabh Saraf, Ramesh Gundluru, Shamsa Hamad, Ludovick Lepauloux, dan Hakim Hacid mencoba mengatasi celah itu lewat Falcon ASR. Mereka nggak cuma mengoptimalkan model buat bahasa formal, tapi juga menargetkan dialek sehari-hari dan kondisi rekaman riil di lapangan.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu Falcon ASR dan Kenapa Menarik Perhatian?
Falcon ASR adalah model speech to text berbasis AI yang punya ukuran 1,6 miliar parameter (1.6B). Fokus utamanya ada di pengenalan bahasa Arab, terutama dialek Emirati dan kawasan Teluk, tanpa mengorbankan performa bahasa internasional lainnya.
Kerennya, kamu nggak cuma dapat teks transkripsi polos. Model ini langsung mendukung word-level timestamps, yaitu penanda waktu presisi yang mengaitkan setiap kata hasil transkripsi ke posisi detik suara di file rekaman aslinya. Fitur ini ngebantu banget kalau kamu pengin bikin fitur navigasi audio, teks terjemahan otomatis (subtitle), atau pencarian kata kunci di rekaman rapat panjang.
Selain dialek kawasan Teluk, model speech to text ini juga membawa bobot model yang sama buat memproses empat bahasa lain: Inggris, Prancis, Spanyol, dan Portugis. Jadi, kamu nggak perlu repot memilih bahasa asal sebelum audio diproses; model bakal mendeteksi dan mengeluarkan transkripsi sesuai bahasa yang diucapkan penutur.
Arsitektur dan Rahasia di Balik Model Speech to Text 1.6B Ini
Pengembangan Falcon ASR nggak dimulai dari nol. Pondasi arsitekturnya berakar dari riset Falcon3-Audio yang sebelumnya dibahas mendalam di makalah ilmiah berjudul Competitive Audio-Language Models with Data-Efficient Single-Stage Training on Public Data.
Dalam makalah tersebut, tim TII mendemonstrasikan metode pelatihan satu tahap (single-stage training) yang efisien data. Pendekatan ini bikin model bisa memetakan fitur audio langsung ke teks dengan konsumsi komputasi yang lebih hemat, dibantu dukungan infrastruktur dari Mikhail Lubinets.
Selain itu, model ini juga mendapat sokongan dari tim di balik proyek Falcon-Emirati. Sinergi ini memastikan pemahaman budaya lokal, idiom, dan istilah percakapan kasual di jazirah Arab bisa terserap rapi ke dalam representasi bobot model tanpa merusak kemampuan dasarnya.
Skor Benchmark Falcon ASR: Paling Unggul di Bahasa Arab
Pengujian performa transkripsi bahasa Arab dilakukan lewat Open Universal Arabic ASR Leaderboard yang dikelola oleh ELM Research Center. Evaluasi ini menggunakan metrik standar industri, yaitu Word Error Rate (WER) dan Character Error Rate (CER). Makin kecil persentase angkanya, makin sedikit kesalahan transkripsinya.
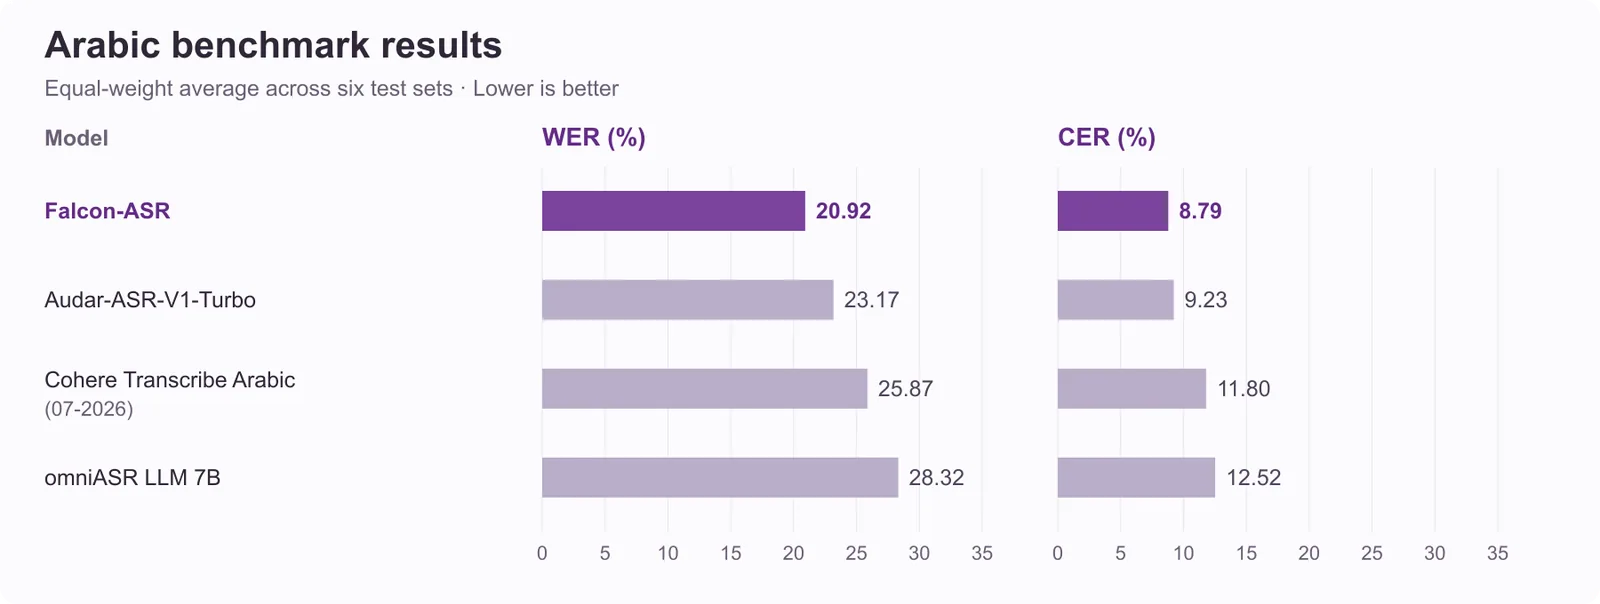
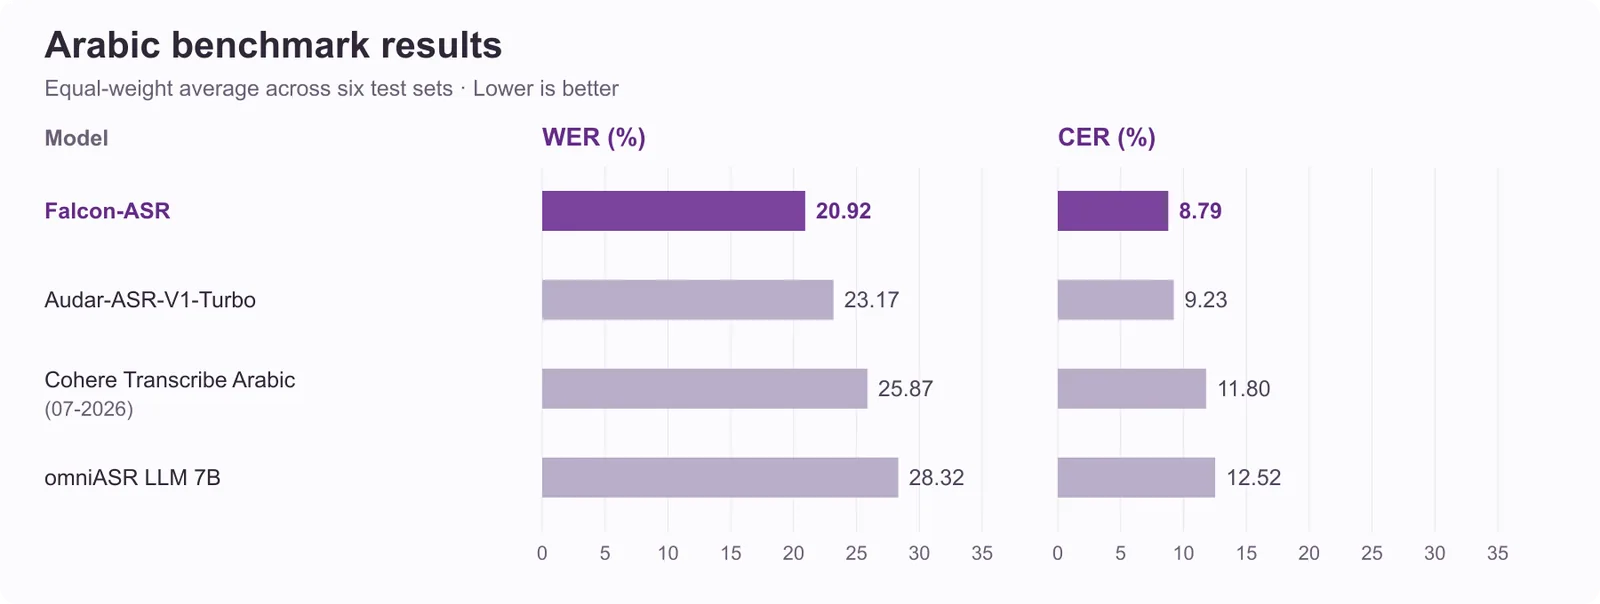
Tim TII menguji Falcon ASR memakai protokol dan enam set data uji yang sama persis dengan papan peringkat tersebut. Data pesaing diambil dari snapshot papan peringkat per 30 September 2026. Hasilnya, Falcon ASR sukses melampaui rekor terbaik yang pernah dipublikasikan.
| Metrik Evaluasi | Hasil Terbaik Sebelumnya (Papan Peringkat) | Falcon ASR (TII) | Selisih Keunggulan |
|---|---|---|---|
| Rata-rata WER (6 Test Set) | 23,17% | 20,92% | Lebih baik 2,25 poin persentase |
Dengan rata-rata WER 20,92%, Falcon ASR unggul 2,25 poin persentase dibanding model terbaik sebelumnya di leaderboard tersebut. Ini ngebuktiin kalau model ini konsisten di enam variasi set data uji yang berbeda.
Laporan performa ini juga dibagikan dalam format dokumentasi dwibahasa oleh tim TII untuk mempertegas posisi model di komunitas peneliti AI global maupun kawasan Timur Tengah.
Uji Akurasi Dialek Emirati: Kalahkan Qwen3-Omni
Menangani dialek percakapan jauh lebih menantang daripada membaca naskah berita Modern Standard Arabic (MSA). Di data publik memang sudah ada dataset Casablanca yang punya subset khusus Uni Emirat Arab (UEA). Namun, TII melangkah lebih jauh dengan menggelar evaluasi internal.
Mereka mengumpulkan rekaman dialek Emirati dan Teluk tambahan yang sengaja dipisahkan (held-out recordings), lengkap dengan teks pembanding yang sudah divalidasi langsung oleh manusia (human-validated transcripts). Tujuannya buat ngecek apakah AI ini benar-benar paham obrolan santai warga lokal.
| Model Pengenal Suara | Dialek Emirati WER | Dialek Emirati CER |
|---|---|---|
| Falcon ASR | 22,73% | 10,19% |
| Qwen3-Omni | 26,80% (selisih +4,07%) | Lebih tinggi dari Falcon ASR |
Di pengujian internal ini, Falcon ASR mencatat WER 22,73% dan CER 10,19%. Capaian WER ini 4,07 poin persentase lebih rendah dibanding Qwen3-Omni yang menempati posisi kedua. Angka ini menegaskan kalau akurasi Falcon ASR di tingkat kata maupun karakter untuk dialek Emirati adalah yang paling bersih di antara sistem yang mereka bandingkan.
Evaluasi mendalam pada dialek lokal ini jadi bukti penting bahwa kecerdasan buatan sumber terbuka sekarang makin tajam dalam mengenali ragam aksen dan dialek non-standar.
Performa Bahasa Inggris dan Dukungan Multilingual Falcon ASR
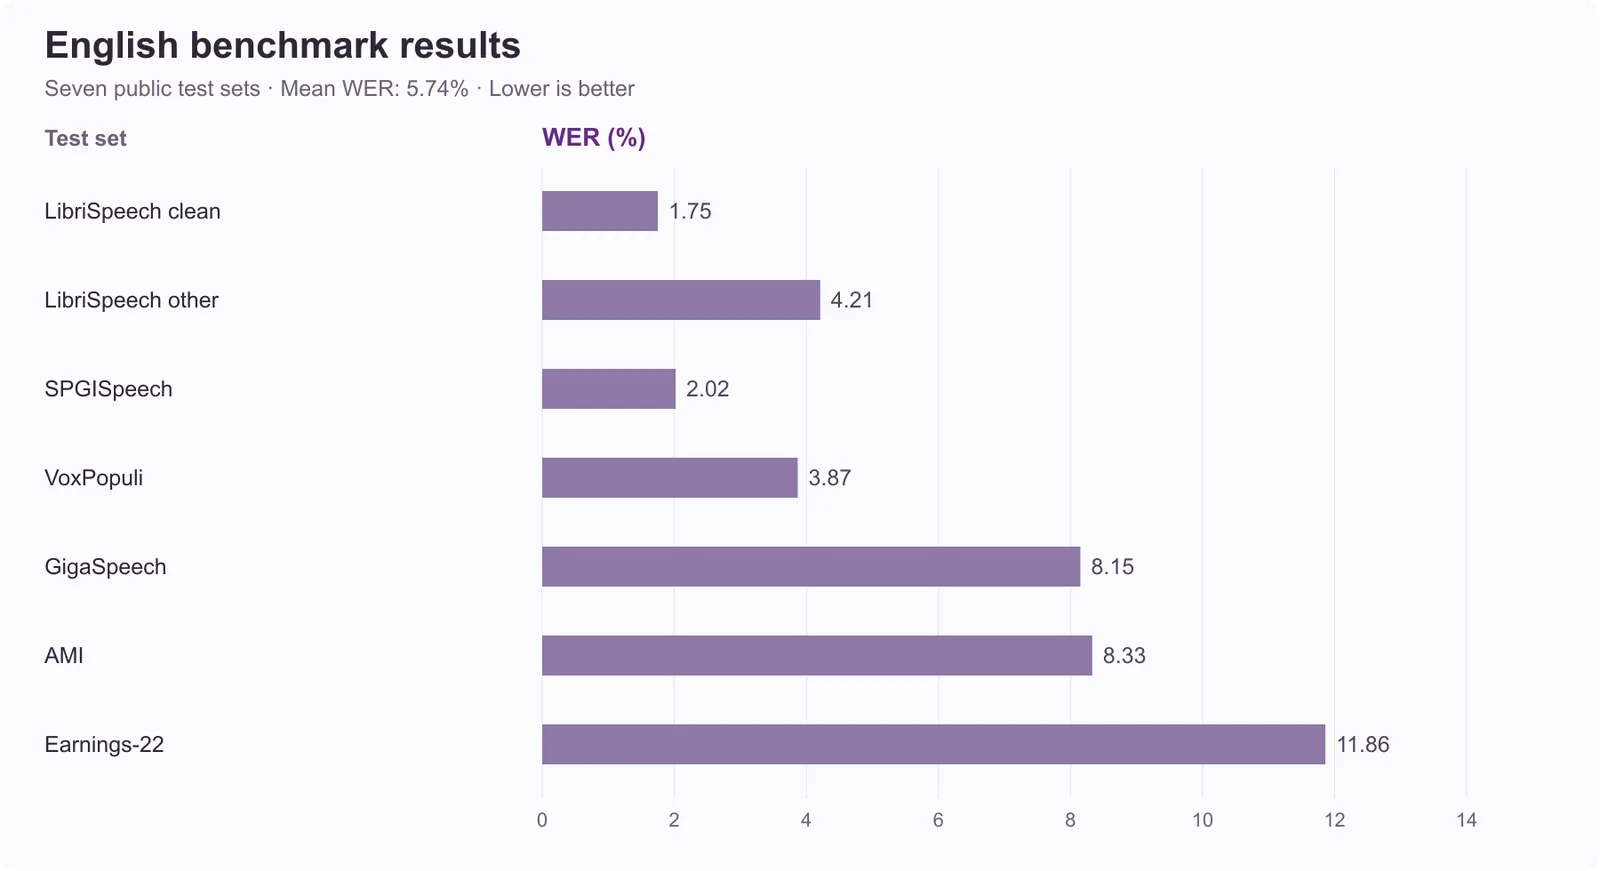
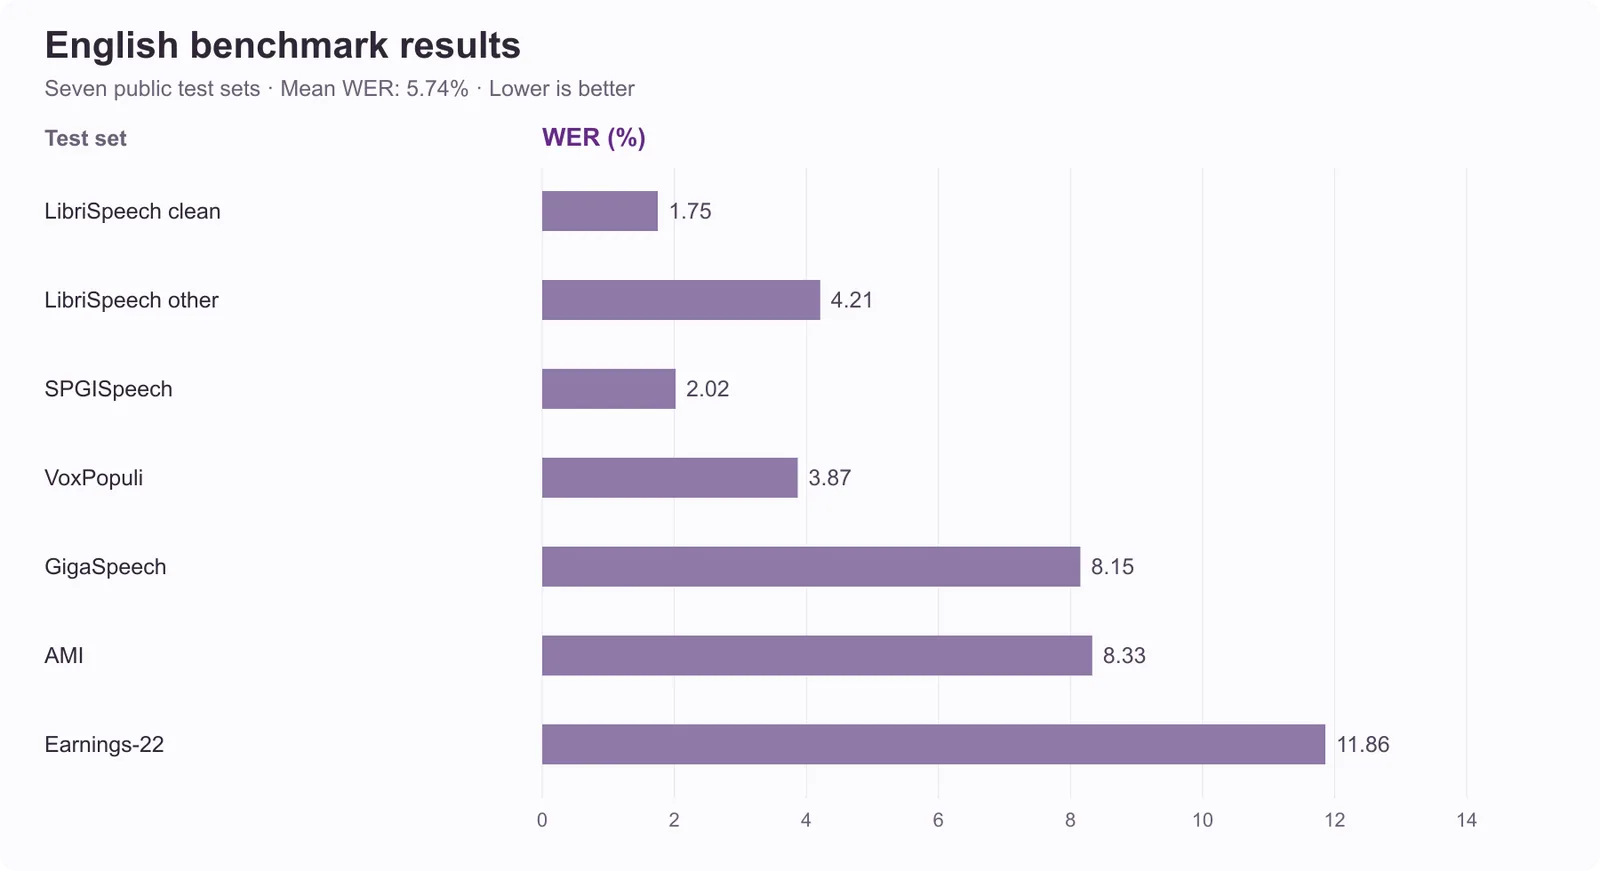
Walaupun fokus utamanya ada di dialek Arab, kamu nggak perlu khawatir soal kemampuan bahasa lainnya. TII menguji model speech to text ini pada tujuh set data uji publik bahasa Inggris yang biasa dipakai di Hugging Face Open ASR Leaderboard.
Hasilnya lumayan keren: Falcon ASR mencatat rata-rata WER 5,74% untuk bahasa Inggris. Tingkat kesalahan di bawah 6% ini menunjukkan kalau bobot modelnya tetap tajam buat kebutuhan transkripsi audio umum.
Selain bahasa Inggris, Falcon ASR juga mendukung bahasa Prancis, Spanyol, dan Portugis. Kelima bahasa ini memakai file bobot model yang sama persis tanpa perlu konfigurasi khusus. Output yang keluar bakal otomatis mengikuti bahasa yang sedang diucapkan di dalam rekaman.
Tahan Bising: Cara Falcon ASR Dilatih Menghadapi Audio Dunia Nyata
Banyak model transkripsi terdengar hebat di lab pengujian, tapi langsung berantakan pas disuruh menyalin rekaman suara telepon yang kresek-kresek. Peneliti TII paham betul masalah klasik ini, makanya mereka sengaja bikin proses pelatihannya jauh lebih keras.
Dalam proses latihannya, dataset Falcon ASR dijejali berbagai gangguan audio dunia nyata, antara lain:
- Kebisingan latar belakang (background noise): Suara dengung ruangan, kendaraan, dan keramaian kafe.
- Suara orang bicara barengan (overlapping speech): Kondisi saat dua pembicara saling menyela di tengah rapat.
- Musik dan gema ruangan (room reverberation): Suara pantulan dinding ruangan rapat atau aula kosong.
- Efek jaringan telepon (telephony effects): Kompresi frekuensi rendah khas panggilan suara seluler.
- Variasi laju bicara dan nada (speed and pitch variations): Pengucapan cepat, lambat, nada tinggi, maupun nada rendah.
Perlakuan yang sama juga diterapkan pada sampel rekaman dialek Emirati. Hasilnya, model ini punya ketahanan ekstra saat harus memproses rekaman panggilan telepon layanan pelanggan (call center) atau rekaman rapat luring yang kualitas mic-nya pas-pasan.
Cara Mencoba Falcon ASR di Hugging Face dan Rencana Rilisnya
Pengin langsung ngetes kualitas audionya? Kamu bisa langsung nyobain Falcon ASR lewat demo interaktif yang sudah disediakan pengembangnya.
Berikut langkah buat menjajalnya sekarang:
- Buka peramban kamu dan akses Hugging Face Demo Space resmi Falcon ASR yang disediakan TII.
- Unggah file rekaman audio yang mau kamu transkripsikan, atau rekam langsung suaramu lewat mikrofon peramban.
- Jalankan proses transkripsi, lalu amati teks yang keluar beserta rincian penanda waktu (timestamp) di tiap katanya.
- Bandingkan hasilnya dengan rekaman berisik untuk mengecek ketahanan audionya.
TII juga mengonfirmasi kalau akses API resmi dan aplikasi bawaan (native applications) sedang disiapkan untuk rilis mendatang. Jadi, developer yang berniat membangun sistem integrasi skala besar bisa menunggu pipeline API tersebut dirilis ke publik.
Dampak Buat Developer dan Proyek AI di Indonesia
Buat ekosistem teknologi di Indonesia, rilisnya Falcon ASR membawa sejumlah peluang menarik, terutama di sektor-sektor yang bersinggungan langsung dengan kawasan Timur Tengah:
- Aplikasi Haji dan Umrah: Developer lokal yang membangun aplikasi pendamping jemaah haji dan umrah bisa memanfaatkan model ini untuk mengenali percakapan lokal di Arab Saudi atau UEA.
- Layanan Perlindungan Pekerja Migran: Perekaman aduan atau layanan panggilan darurat dari pekerja migran di Timur Tengah bisa ditranskripsikan otomatis secara akurat tanpa kendala dialek lokal.
- Peluang Call Center Ekspor: Perusahaan outsourcing dan layanan pelanggan di Indonesia yang menangani klien dari Uni Emirat Arab bisa memanfaatkan AI open source Hugging Face ini untuk analisis percakapan telepon berkualitas tinggi.
- Pengembangan Agen Percakapan Multibahasa: Jika digabungkan dengan pipeline AI suara seperti ulasan agen suara Amazon Nova Sonic, pengenalan dialek yang presisi bakal bikin interaksi suara terasa makin luwes.
Alur Integrasi Transkripsi Audio AI dengan LLM
Setelah audio berhasil diubah jadi teks oleh Falcon ASR, langkah berikutnya biasanya mengirim teks tersebut ke model bahasa besar (LLM) untuk diringkas, diekstrak poin pentingnya, atau diterjemahkan ke bahasa Indonesia.
Kamu bisa menyiapkan alur pemrosesan teks tersebut lewat prompt terstruktur seperti ini:
Kamu adalah asisten analis percakapan multibahasa.Berikut adalah transkripsi mentah hasil audio to text yang berisi percakapan campuran (Arab/Inggris) beserta timestamp: [TEMPEL TRANSKRIPSI FALCON ASR DI SINI] Tugasmu:1. Rapikan kalimat yang terpotong tanpa mengubah makna aslinya.2. Identifikasi topik utama yang dibahas oleh para pembicara.3. Terjemahkan intisari percakapan tersebut ke dalam bahasa Indonesia yang santai dan mudah dipahami.4. Susun daftar tindak lanjut (action items) dari rekaman tersebut.
Buat tahap pemrosesan teks dari transkripsi audio tersebut, kamu bisa memakai model LLM kencang dan hemat token seperti DeepSeek V4.1 Flash (Rp160 input / Rp800 output per 1 juta token) atau GPT-4o (Rp500 input / Rp2.500 output per 1 juta token) lewat Classai Router. Satu API key di Classai Router bisa dipakai buat puluhan model AI global sekaligus, pembayarannya fleksibel pakai QRIS tanpa perlu kartu kredit luar negeri, dan integrasinya gampang banget karena kompatibel penuh dengan SDK OpenAI maupun Anthropic.
Dengan hadirnya Falcon ASR yang membawa akurasi rekor baru di bahasa Arab dan dialek regionalnya, pilihan model pengenal suara sumber terbuka makin kaya. Kita tinggal menunggu rilis API resminya agar integrasi ke aplikasi produksi jadi makin mulus.
Sumber & referensi
- 01
Hugging Face · 7 Oktober 2026
Introducing Falcon ASR
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu Falcon ASR?
Falcon ASR adalah model speech to text 1,6 miliar parameter buatan Technology Innovation Institute di Abu Dhabi. Model ini dirancang khusus untuk mentranskripsikan bahasa Arab percakapan dan dialek Emirati ke dalam teks secara presisi. Selain bahasa Arab, model ini juga bisa mengenali suara bahasa Inggris, Prancis, Spanyol, dan Portugis dengan bobot yang sama.
Berapa skor Word Error Rate (WER) Falcon ASR?
Falcon ASR mencatatkan rata-rata Word Error Rate sebesar 20,92% di enam benchmark Open Universal Arabic ASR Leaderboard, mengungguli skor terbaik sebelumnya sebesar 23,17%. Pada evaluasi internal untuk dialek Emirati, angka WER model ini menyentuh 22,73% dan Character Error Rate 10,19%. Capaian tersebut tercatat 4,07 poin persentase lebih baik dibanding model Qwen3-Omni.
Bahasa apa saja yang didukung oleh Falcon ASR?
Model Falcon ASR mendukung bahasa Arab, Inggris, Prancis, Spanyol, dan Portugis secara langsung. Kelima bahasa ini diproses memakai kumpulan bobot model yang sama persis tanpa perlu memilih setelan bahasa asal terlebih dahulu. Teks transkripsi otomatis keluar sesuai bahasa yang diucapkan penutur, lengkap dengan penanda waktu kata per kata.
Bagaimana cara mencoba Falcon ASR sekarang?
Kamu bisa langsung menjajal Falcon ASR secara gratis lewat Hugging Face Demo Space resmi yang disediakan oleh TII. Cukup buka halaman demonya, lalu unggah file audio atau rekam suara langsung lewat mikrofon browser untuk melihat transkripsi instan. Untuk kebutuhan integrasi sistem, TII berencana merilis akses API dan aplikasi native.
Bagaimana ketahanan Falcon ASR menghadapi rekaman audio bising?
Falcon ASR dilatih menggunakan berbagai kondisi rekaman audio dunia nyata yang penuh tantangan. Tim pengembang memasukkan data suara dengan kebisingan latar, orang berbicara tumpang-tindih, musik latar, gema ruangan, hingga distorsi suara telepon. Model ini juga dilatih menghadapi variasi kecepatan bicara dan nada suara agar tetap akurat saat dipakai rapat.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.