BotPsy Model AI Rilis: Asisten On-Device Mungil yang Kalahkan Model 2B
Tether AI Research ngerilis BotPsy, model AI 0,8B untuk asisten on-device yang sanggup kalahkan model 2,5 kali lebih gede dalam urusan function calling.
· 10 menit baca
Inti singkat
- BotPsy adalah model AI 0,8B berbasis Qwen3.5-0.8B yang dirancang khusus untuk eksekusi tugas on-device.
- Performanya mengungguli semua model sekelas di bawah 1,2B dan melampaui Qwen3.5-2B pada lima dari enam benchmark agen.
- Model ini dilatih lewat empat tahap: SFT, distilasi on-policy multi-guru, dan dua ronde reinforcement learning.
- Keamanan BotPsy makin tangguh dengan penurunan respons tidak aman menjadi 21% dan prompt injection menjadi 31%.
- Tersedia gratis di Hugging Face dengan lisensi Apache 2.0 dalam format safetensors serta GGUF Q4, Q8, dan bf16.
Daftar isi9 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
- 09
Tether AI Research baru aja ngerilis BotPsy model AI, model bahasa sub-billion parameter (0,8B) yang dirancang khusus jadi asisten AI on-device buat ngerjain tugas agen dan pemanggilan fungsi langsung di perangkatmu. Kehadiran model ini ngebuktiin kalau kita nggak melulu butuh model raksasa berbasis cloud cuma buat beresin perintah praktis harian.
Ketergantungan sama model cloud berukuran jumbo sering bikin pusing developer: biayanya mahal, gampang berubah sewaktu-waktu, dan data pribadi pengguna terpaksa dikirim ke server pihak ketiga. Menurut laporan teknis tim Tether AI Research di Hugging Face, BotPsy dibangun di atas fondasi Qwen3.5-0.8B buat ngejawab kebutuhan asisten lokal yang privat, ngebut, dan hemat daya. Dibanding model ringkas lain seperti yang pernah dibahas di artikel Meta Muse Ember model agen AI murah, BotPsy ngambil pendekatan ekstrem dengan ukuran di bawah 1 miliar parameter tapi punya spesialisasi tool-use yang tajam banget.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Itu BotPsy Model AI dan Kenapa Menarik?
BotPsy adalah model bahasa berukuran 0,8 miliar parameter (0,8B) yang fokus utamanya ada pada function calling dan alur kerja agen (agentic workflow). Model ini bertindak layaknya asisten pribadi yang memakai berbagai tools buat nuntaskan rupa-rupa tugas ringan sampai menengah. Cakupan kerjanya luas, mulai dari pencarian web dan riset, perjalanan dan gaya hidup, belanja dan finansial, operasional bisnis dan pelanggan, kontrol perangkat dan kendaraan, pengaturan file dan dokumen, sampai urusan kalender serta perpesanan.
Yang bikin makin menarik, BotPsy dirancang pas banget buat kebutuhan deployment on-device kayak di smartphone, laptop pribadi, atau perangkat lokal lain. Karena ukurannya super mungil, komputer kamu nggak bakal megap-megap kehabisan memori. Model ini ngebuka jalan buat eksekusi otomatis yang aman dari risiko bocornya data pribadi, bebas biaya langganan API bulanan, dan tetap bisa diandalkan buat alur kerja harian.
Skor Benchmark: Ungguli Model Lebih Gede Sampai 2,5 Kali Lipat
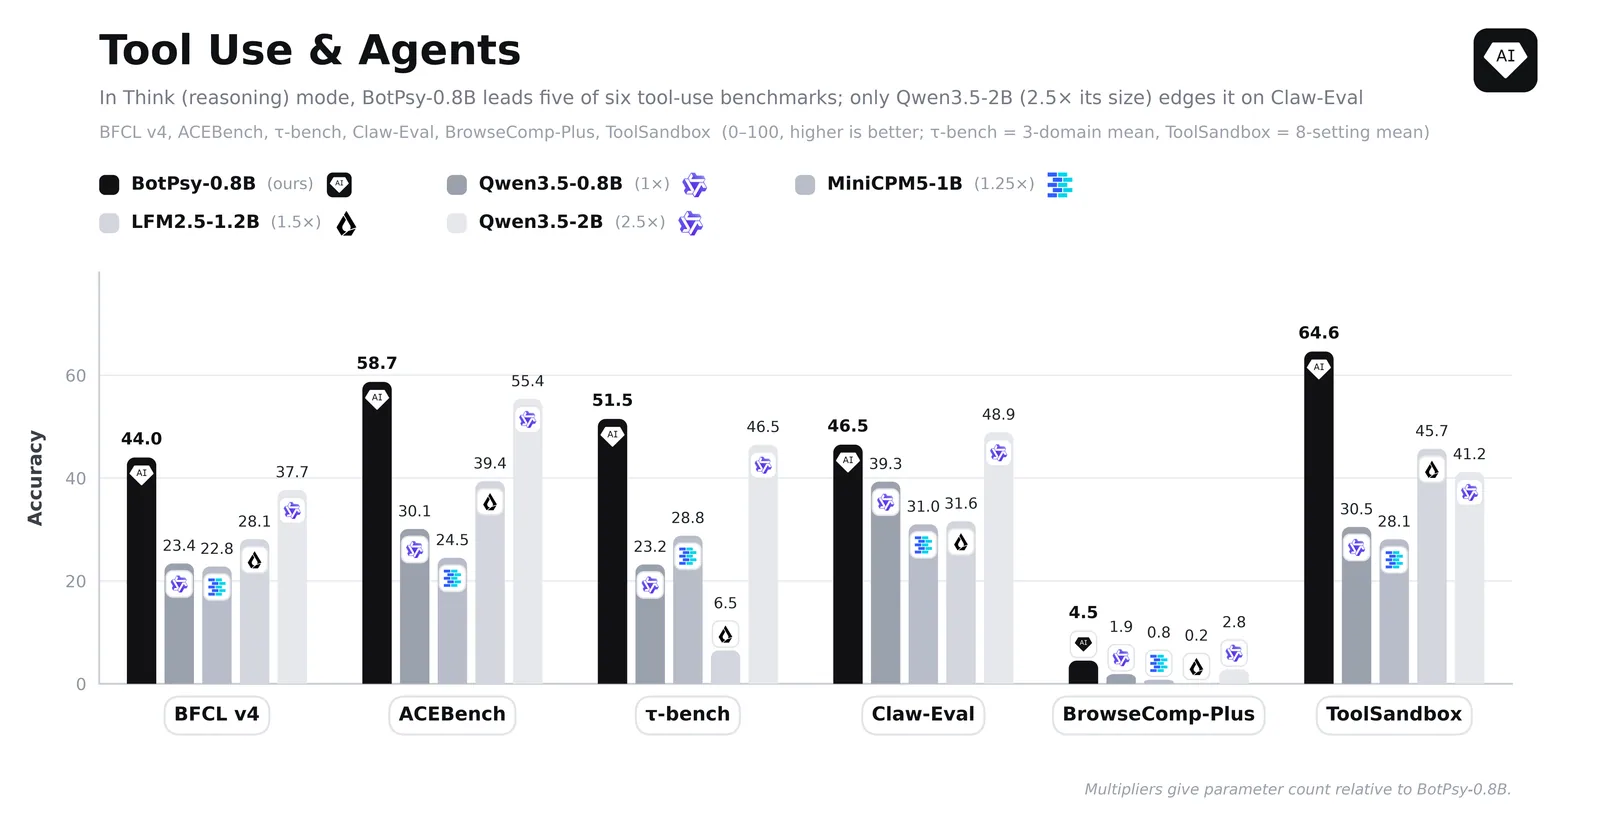
Hal paling mencengangkan dari BotPsy model AI ada pada lonjakan kemampuannya dibanding model dasar maupun pesaing di kelas bobot yang mirip. BotPsy sukses mengungguli model-model di kelas ≤1,2B parameter kayak Qwen3.5-0.8B-Think, LFM2.5-1.2B-Think, dan MiniCPM5-1B-Think di enam benchmark agen sekaligus.
Bahkan yang bikin geleng-geleng kepala, BotPsy sanggup ngalahin Qwen3.5-2B-Think yang ukurannya 2,5 kali lipat lebih gede pada lima dari enam tolok ukur pengujian. Mari kita intip perbandingan angka resminya di tabel ini:
| Benchmark | BotPsy-0.8B | Qwen3.5-0.8B-Think (Base) | Qwen3.5-2B-Think | LFM2.5-1.2B-Think | MiniCPM5-1B-Think |
|---|---|---|---|---|---|
| BFCL v4 | 44,0 | 23,4 | 37,7 | 28,1 | 22,8 |
| ACEBench | 58,7 | 30,1 | 55,4 | 39,4 | 24,5 |
| τ-bench | 51,5 | 23,2 | 46,5 | 6,5 | 28,8 |
| Claw-Eval | 46,5 | 39,3 | 48,9 | 31,6 | 31,0 |
| BrowseComp-Plus | 4,5 | 1,9 | 2,8 | 0,2 | 0,8 |
| ToolSandbox | 64,6 | 30,5 | 41,2 | 45,7 | 28,1 |
| Rata-rata | 45,0 | 24,7 | 38,8 | 25,3 | 22,7 |
Satu-satunya pengujian agen di mana Qwen3.5-2B-Think masih unggul tipis cuma di Claw-Eval (48,9 berbanding 46,5). Pada benchmark lainnya, BotPsy mencatat rata-rata 45,0 — hampir dua kali lipat kemampuan model basis aslinya yang cuma ada di angka 24,7.
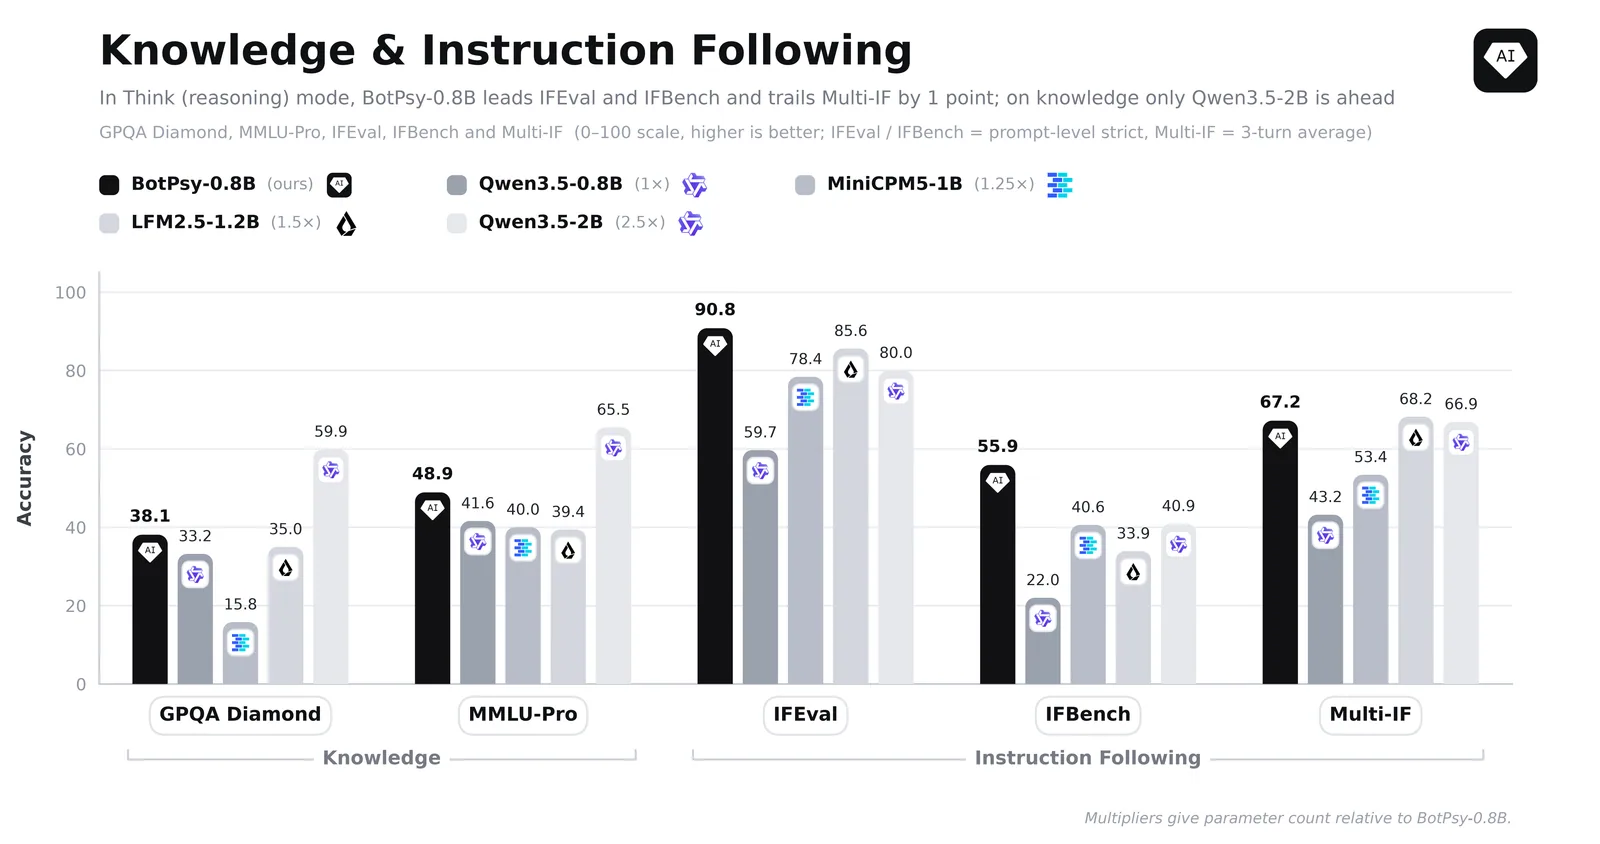
Lalu gimana nasib pemahaman umumnya? Biasanya, model kecil yang dipaksa belajar tool-use bakal lupa sama pengetahuan dasarnya. Tapi di BotPsy, skor GPQA Diamond justru naik dari 33,2 ke 38,1, dan MMLU-Pro melesat dari 41,6 ke 48,9. Angka ini jadi yang paling tinggi di antara model sekelas di bawah 1,2B parameter. Walaupun model 2B tetap unggul di pengetahuan ensiklopedis murni (GPQA 59,9), BotPsy emang sengaja dirancang bukan buat ngafal isi bumi, melainkan buat manggil tool eksternal pas butuh data faktual.
Lebih Lihai Ngobrol Panjang dan Tahu Kapan Nggak Boleh Manggil Tool
Masalah klasik yang sering bikin jengkel saat nyobain agen AI kecil adalah gampang ngelantur pas diajak ngobrol panjang yang butuh aksi bertahap (multi-turn). Di sinilah peningkatan BotPsy kelihatan nyata banget.
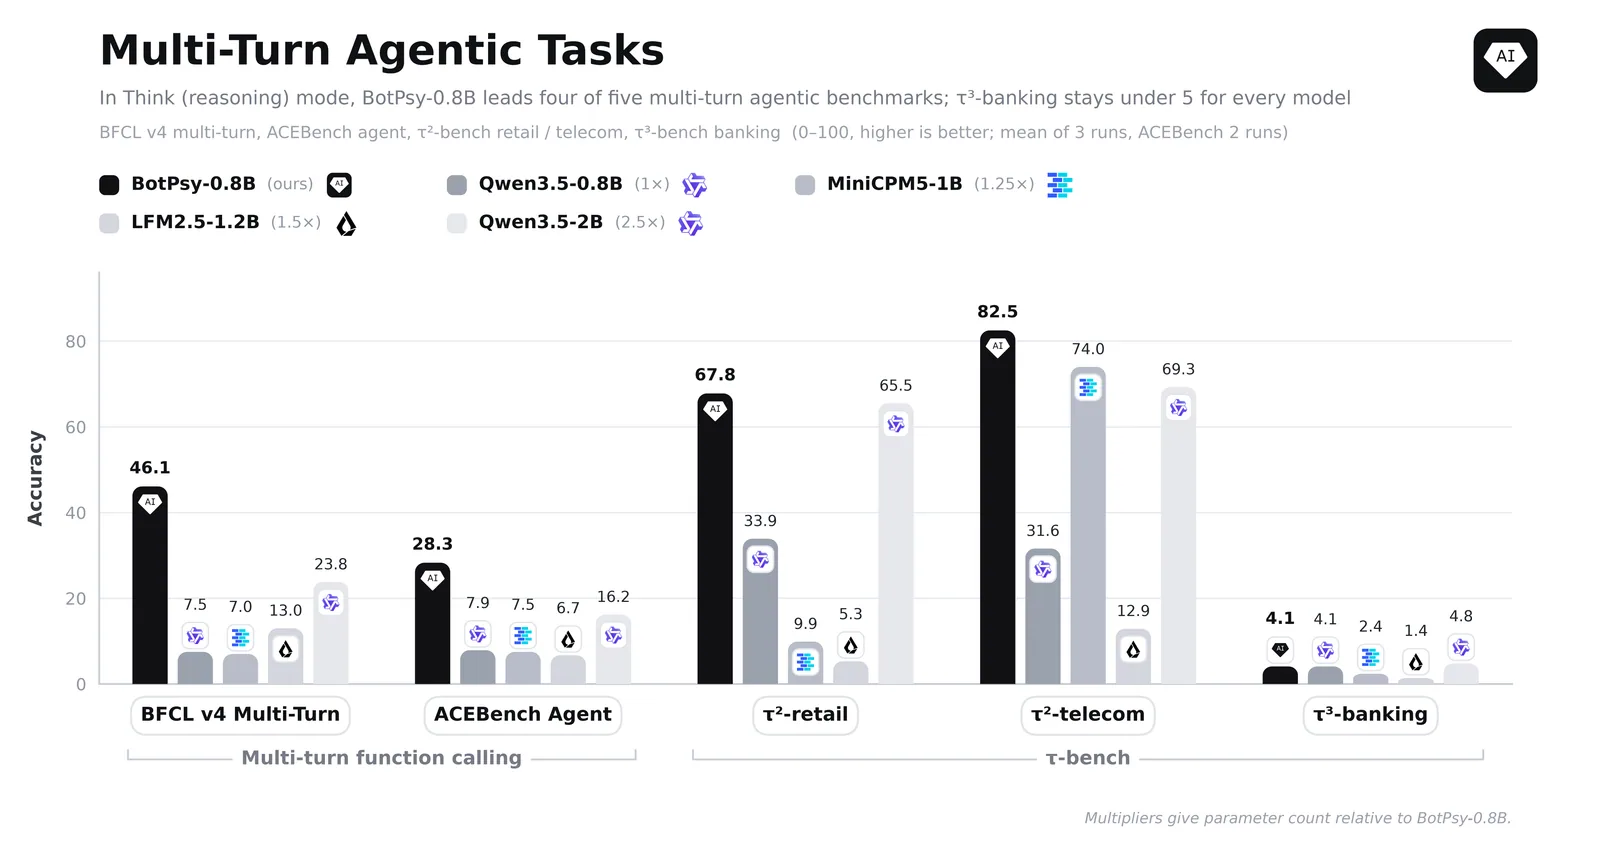
Pada pengujian BFCL v4 multi-turn, skor BotPsy meroket dari 7,5 (pada model dasar) ke 46,1 — hampir dua kali lipat dari skor Qwen3.5-2B-Think yang cuma nembus 23,8. Di pengujian τ²-bench bidang telekomunikasi, di mana AI harus memandu pemecahan kendala pelanggan lewat percakapan panjang dengan aturan ketat, BotPsy sukses nyentuh skor 82,5, ninggalin MiniCPM5-1B-Think (74,0) dan Qwen3.5-2B-Think (69,3).
Selain itu, agen yang pintar juga harus tahu kapan dia nggak boleh bertindak asal-asalan. Pada uji halusinasi BFCL v4 yang ngecek apakah model mau menolak pas nggak ada tool yang pas, BotPsy meraih skor 86,1 alias paling tinggi di antara semua model yang diuji. Di skenario khusus ACEBench (saat permintaan pengguna belum lengkap atau ada parameter yang salah), skornya naik pesat dari 13,7 jadi 51,3.
Rahasia Dapur: Resep Latihan 4 Tahap BotPsy
Kenapa model sekecil 0,8B bisa punya kelihaian agen sehebat ini? Rahasianya ada di resep post-training empat tahap yang memadukan tiga macam umpan balik: tiruan demonstrasi, bimbingan guru spesialis, dan sistem verifikasi aturan yang ketat.
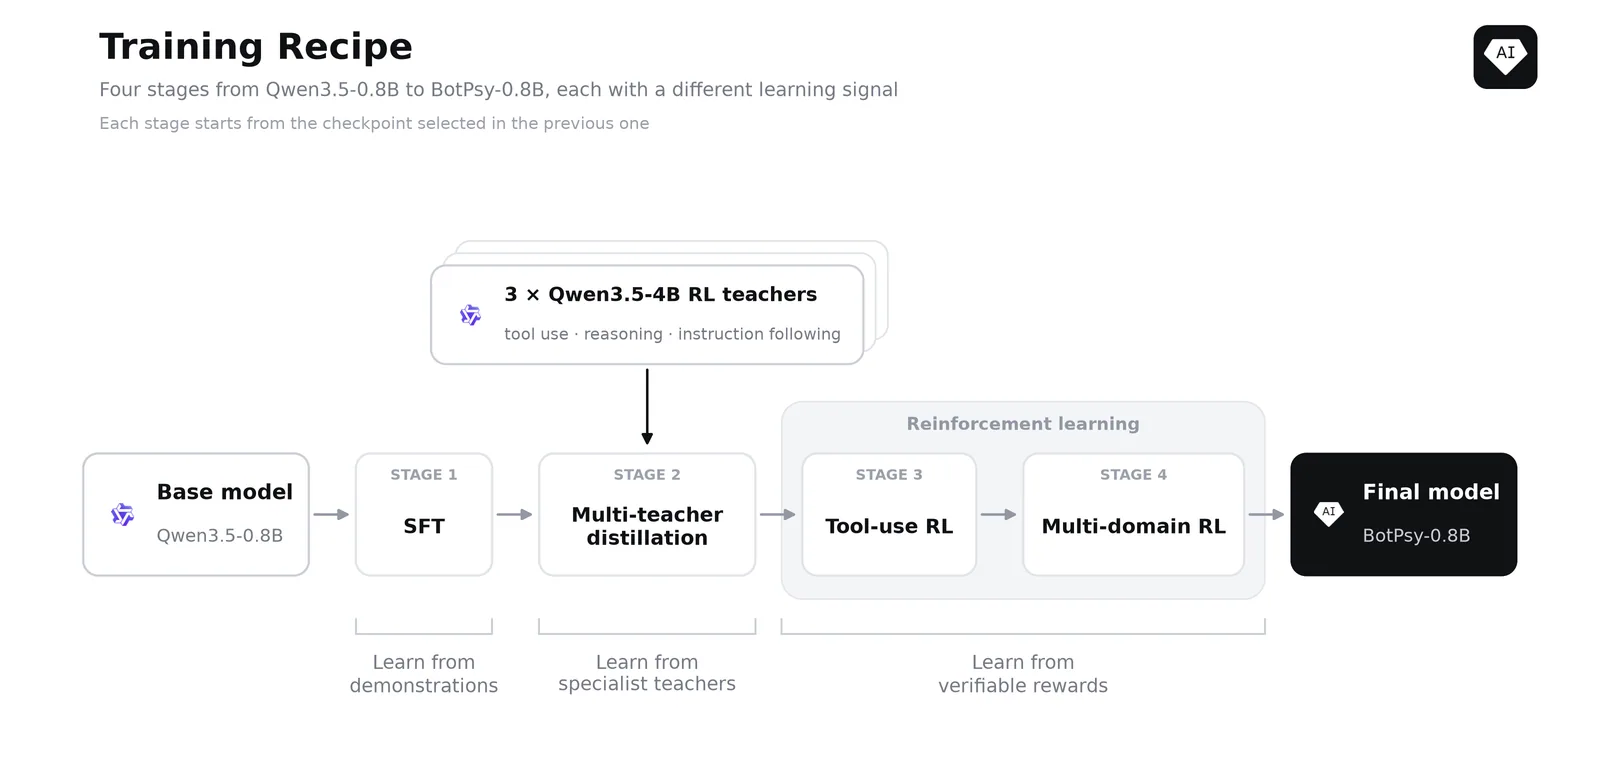
Proses pelatihannya dirancang secara berurutan lewat alur berikut:
- Supervised Fine-Tuning (SFT): Penyetelan awal parameter penuh memakai data percakapan penggunaan tool. Tahap ini mencakup simulasi alur multi-turn, panggilan tunggal, panggilan paralel, sampai contoh kasus di mana tool sama sekali nggak boleh dipanggil.
- Multi-teacher On-Policy Distillation (MOPD): Di tahap ini, model bikin jawabannya sendiri, lalu dinilai per-token oleh tiga model guru spesialis (tiga model Qwen3.5-4B yang masing-masing udah dilatih RL khusus buat tool-use, penalaran umum, dan kepatuhan instruksi). Bimbingan guru ini ampuh banget buat ngembaliin pengetahuan umum yang sempat drop pasca-SFT.
- Reinforcement Learning Ronde 1: Memakai sistem reward berbasis aturan lewat algoritma DAPO (Decoupled Clip and Reward PPO). Sistem verifier ngecek format panggilan fungsi dan ngasih nilai parsial mendalam ala ToolRL buat kecocokan nama fungsi beserta argumennya.
- Reinforcement Learning Ronde 2: Memperluas latihan ke tugas-tugas verifikasi domain umum kayak matematika, coding, structured outputs, dan simulasi skenario kerja multi-langkah.
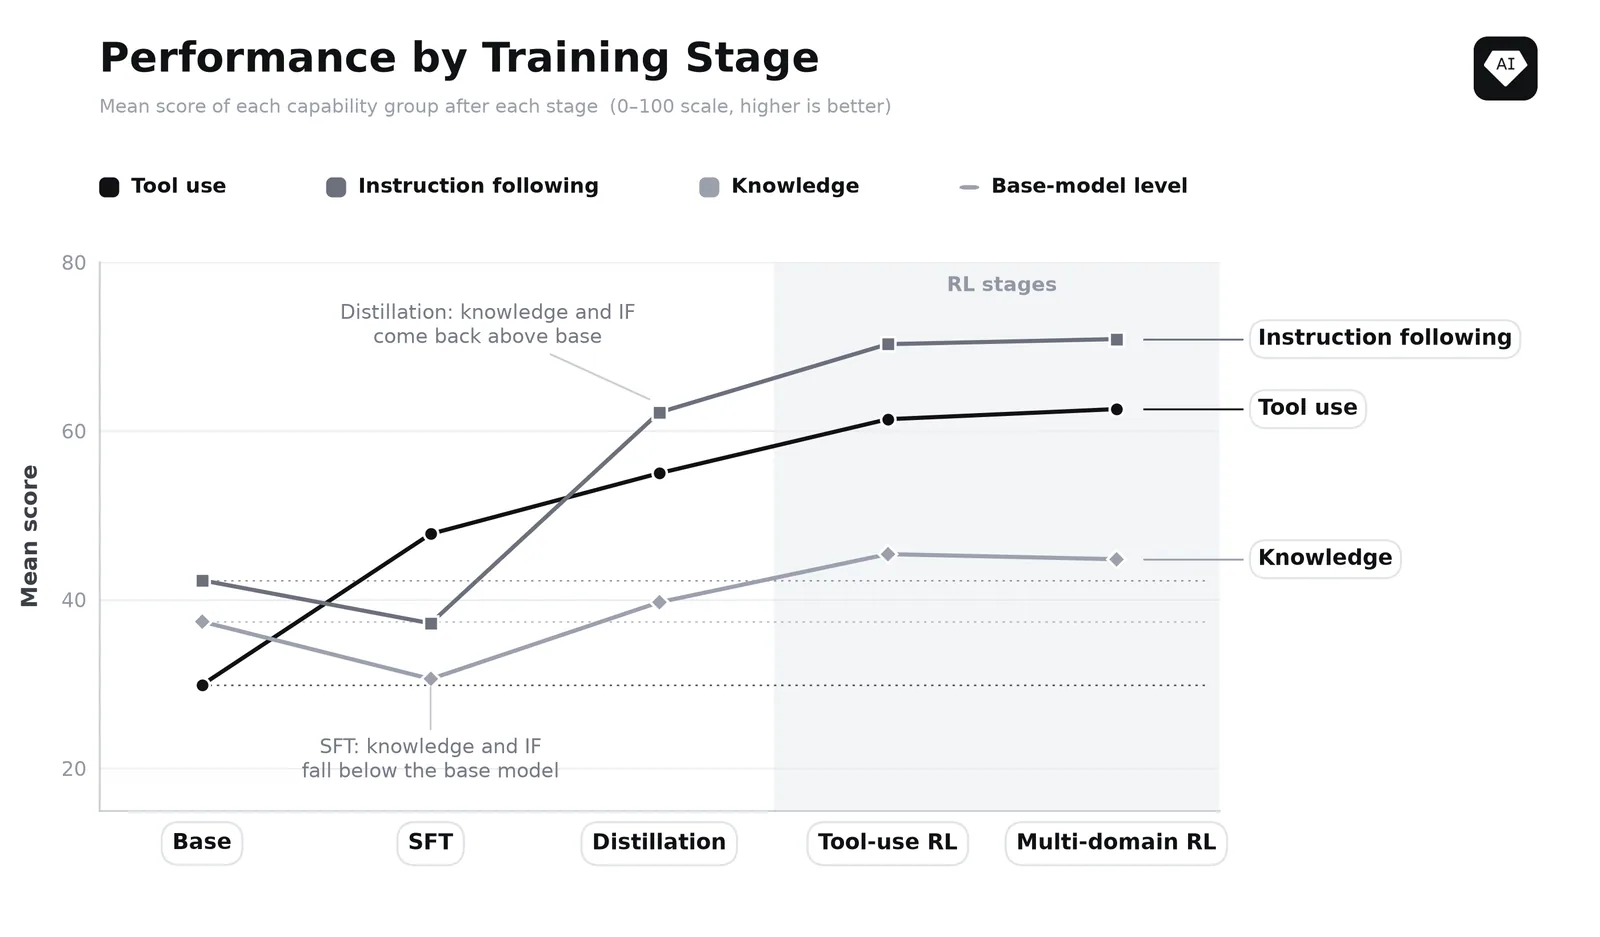
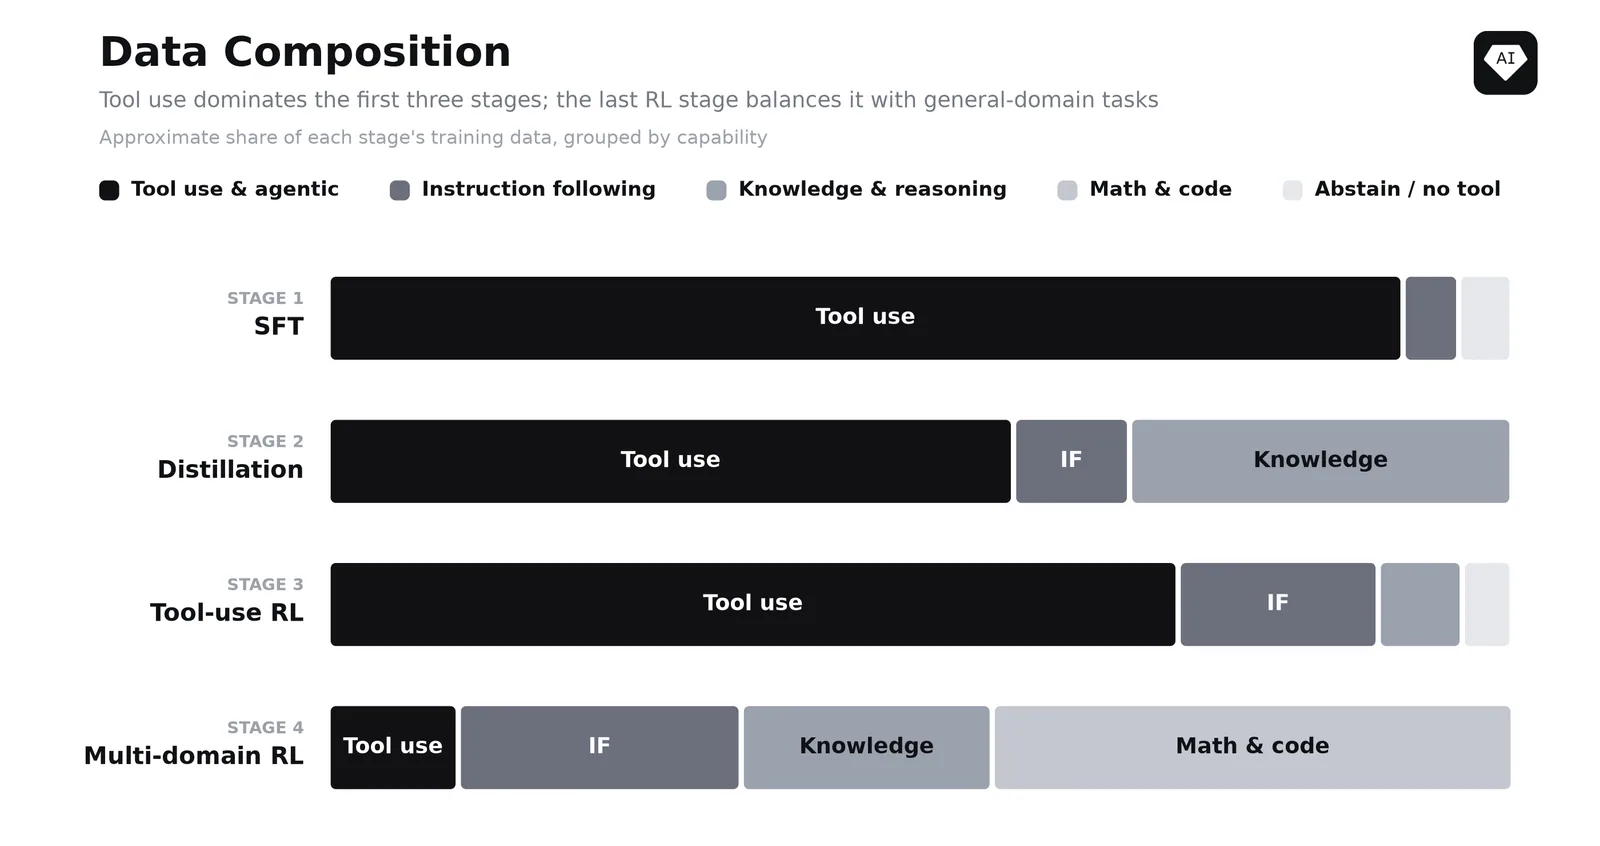
Pembagian porsi data yang pas bikin model nggak cuma hafal ngetik format JSON, tapi juga beneran ngerti kapan dan gimana cara mengeksekusi instruksi dengan benar.
Performa per Aplikasi: Perkasa di Ponsel, Meringis di Riset Rumit
Tim peneliti ngebedah performa BotPsy di berbagai kelompok skenario aplikasi nyata, memisahkannya jadi skenario gampang (satu giliran percakapan, satu panggilan fungsi) dan skenario rumit (banyak giliran atau banyak fungsi sekaligus).
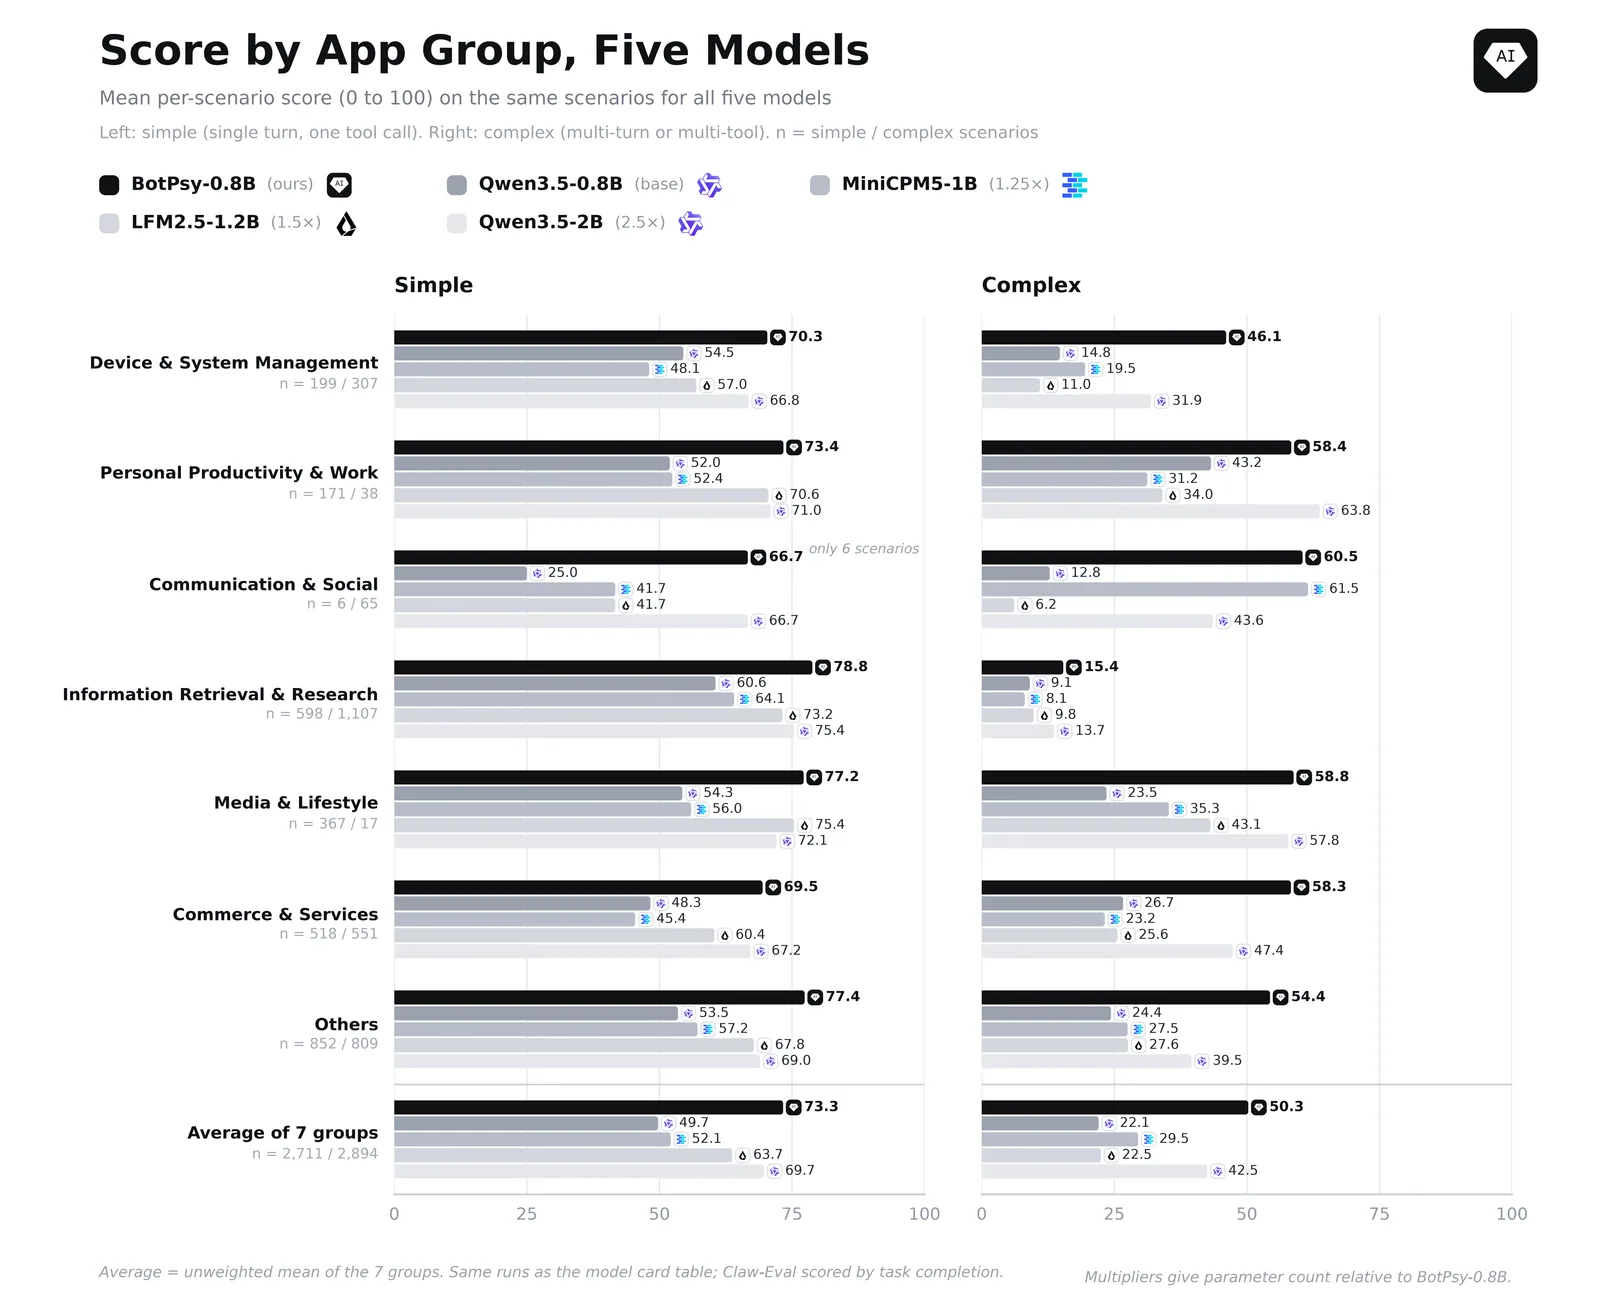
Buat skenario gampang, performa BotPsy stabil banget di kisaran skor 70–79 pada hampir semua kategori aplikasi (rata-rata 75 poin, jauh di atas model dasarnya yang cuma dapet 54). Nah, lonjakan terbesar pada tugas rumit multi-langkah tampak jelas di sektor:
- Komunikasi & Sosial: Meraih skor 61 (skor model dasar cuma 13).
- Perdagangan & Layanan: Mencapai skor 58 (skor model dasar 27).
- Manajemen Perangkat & Sistem: Mengantongi skor 46 (skor model dasar 15).
Meski begitu, ada kelemahan yang nyata banget: pencarian informasi dan riset mendalam multi-langkah (Complex Information Retrieval & Research). Pada skenario ini, BotPsy cuma kebagian skor 15. Kasus penelusuran web yang rumit kayak di BrowseComp-Plus terbukti masih jadi PR besar buat semua model di kelas sub-1B.
Efisiensi Berpikir dan Keamanan yang Makin Irit Memori
Buat asisten lokal di smartphone atau laptop, waktu tunggu (latency) itu penentu utama kenyamanan. Kalau AI mikirnya kelamaan dan muter-muter, baterai bakal cepet habis dan perangkat jadi panas. BotPsy dilatih biar nggak bertele-tele saat menalar masalah.
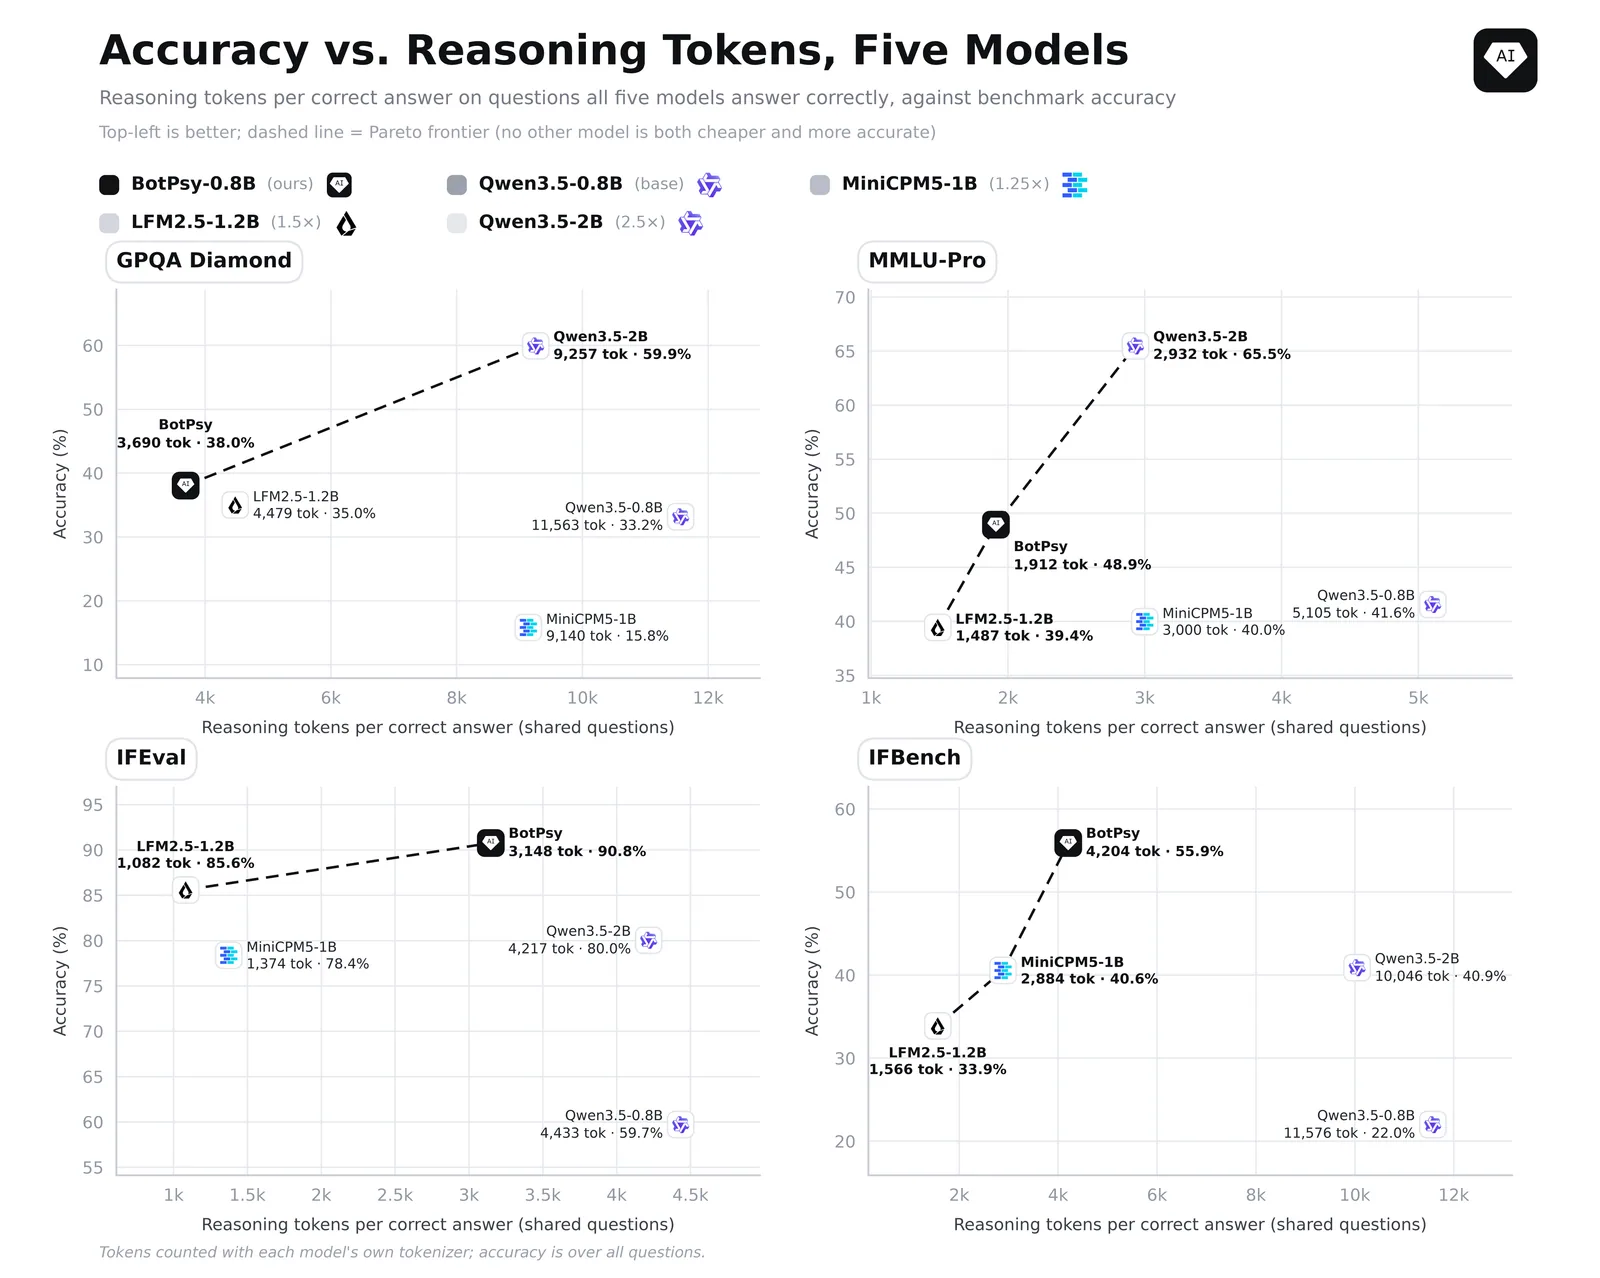
Pada soal-soal yang dijawab bener oleh semua model pembanding, BotPsy butuh token penalaran 3 kali lebih sedikit di GPQA Diamond (3.690 token vs 11.563 pada model dasar) dan 2,7 kali lebih irit di MMLU-Pro (1.912 vs 5.105 token). Penyakit reasoning loop alias AI yang muter-muter mikir tanpa ujung berhasil dipangkas dari 22,9% jadi tinggal 1,4% di IFBench. Jumlah proses yang mentok kena limit 32k token juga terjun bebas dari 28,3% jadi cuma 0,2%.
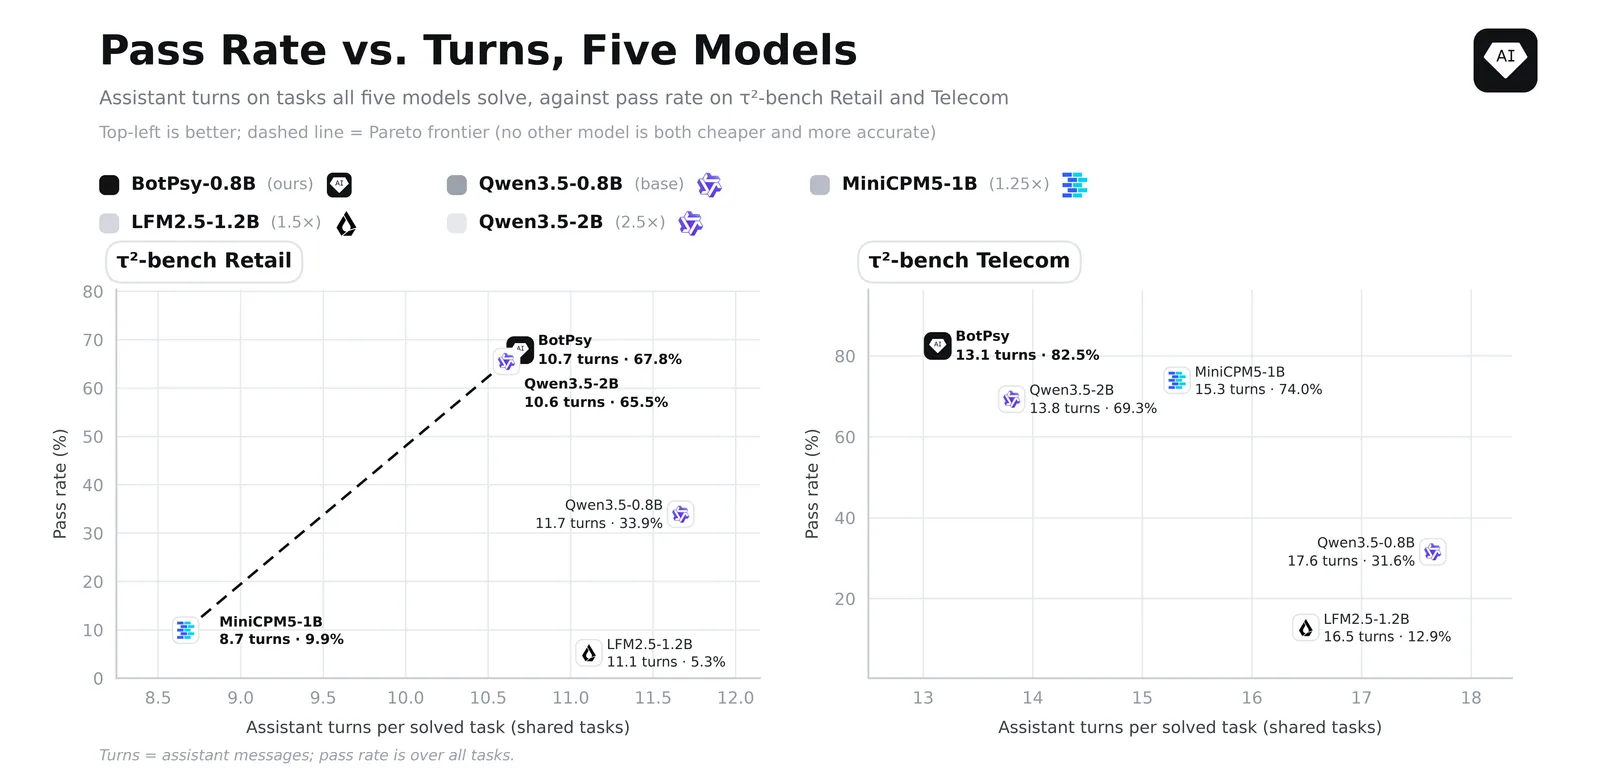
Di pengujian τ²-bench telekomunikasi, BotPsy cuma butuh rata-rata 13,1 putaran percakapan asisten buat beresin masalah pelanggan, 26% lebih ringkas dibanding model aslinya (17,6 putaran), sambil meloloskan tugas 2,6 kali lebih banyak.
Dari urusan keamanan (red-teaming), BotPsy terbukti lebih tahan banting. Persentase menghasilkan jawaban berbahaya turun jadi 21% (dibandingkan basisnya 36%, LFM2.5 di 35%, dan MiniCPM5 di 47%). Pas dihantam serangan prompt injection lewat output tool yang disusupi hacker, angka kerentanannya turun dari 46% jadi 31%.
Kelemahan dan Batasan yang Perlu Diwaspadai
Walau hasilnya keren banget, tim Tether AI Research ngasih catatan jujur soal batasan model ini:
- Keterbatasan Bahasa: BotPsy dioptimalkan utama buat bahasa Inggris. Pada uji Multi-IF delapan bahasa, kemampuannya di bahasa dengan sumber daya rendah kayak Hindi (24,5) dan Rusia (57,6) jauh tertinggal dibanding bahasa Inggris, Prancis, Spanyol, atau Mandarin (72–80). Bahasa Indonesia belum diuji secara resmi di laporan ini.
- Bukan Buat Tugas Kritis Berisiko Tinggi: Model ini cuma disiapin buat tugas tingkat kesulitan rendah sampai menengah. Jangan pakai BotPsy buat urusan medis gawat darurat, analisis hukum berisiko, atau urusan duit secara otomatis (pada tes τ³-banking, semua model sub-billion termasuk BotPsy masih jeblok di bawah angka 5).
- Kapasitas Pengetahuan Terbatas: Karena bobotnya cuma 0,8B parameter, model ini bukan tempat bertanya rupa-rupa ensiklopedia. Dia wajib disambungkan ke tool pencari atau database eksternal biar nggak ngarang bebas pas ditanya fakta.
Cara Nyobain BotPsy Model AI dan Format yang Tersedia
Tether AI Research ngerilis model ini di Hugging Face dengan lisensi terbuka Apache 2.0 buat riset dan pendidikan. Kamu bisa langsung comot bobot modelnya sesuai kebutuhan perangkat:
- Hugging Face safetensors: Pas banget buat kamu yang biasa ngoding Python pakai library PyTorch dan Transformers.
- GGUF (bf16, Q8, Q4): Format ringkas yang siap dijalankan langsung di laptop atau HP lewat llama.cpp, Ollama, atau QVAC SDK.
Contoh konfigurasi prompt sistem sederhana buat nyobain fungsi lokal BotPsy bisa kamu tiru kayak format berikut:
You are BotPsy, a helpful on-device assistant. You have access to local device tools: [set_alarm, toggle_wifi, search_contacts]. Analyze the user's request carefully. If a tool is required, generate the function call in valid JSON format. If no tool matches or required arguments are missing, politely ask the user for clarification. User: Matikan wifi dan pasang alarm besok pagi jam 6.
Efek Nyata Buat Developer dan Pengguna di Indonesia
Perkembangan model kayak BotPsy ngebuka peluang emas buat developer aplikasi di Indonesia. Developer aplikasi mobile atau sistem kasir UMKM sekarang bisa nyelipin fitur asisten pintar langsung di aplikasi Android tanpa waswas mikirin tagihan bulanan API yang membengkak.
Dari sisi kepatuhan regulasi UU Pelindungan Data Pribadi (UU PDP), model lokal begini jelas jadi penyelamat. Data sensitif seperti rekaman chat, kontak pelanggan, atau catatan transaksi toko nggak perlu lagi dikirim lewat internet ke server luar negeri karena semuanya beres diproses langsung di memori HP atau komputer kantor.
Kalau kamu pengin ngebangun sistem hybrid—pakai model lokal mungil buat tugas rutin sehari-hari dan manggil model cloud saat butuh penalaran rumit—kamu bisa memanfaatkan Classai Router. Cukup pakai satu API key yang kompatibel dengan format SDK standar, aplikasimu bisa fleksibel manggil model pintar kayak qwen3.7-plus (Rp810 per 1 juta token input) atau deepseek-v4-flash (Rp1.020 per 1 juta token input) sewaktu pengguna butuh analisis mendalam.
Buat kamu yang mau ngasah skill ngerancang arsitektur agen otomatis dan integrasi API cerdas dari nol, kamu bisa belajar langsung lewat materi praktis di kelas AI untuk Developer.
Sumber & referensi
- 01
Hugging Face · 11 November 2026
BotPsy: On-Device Personal Assistant with a Sub-Billion-Parameter Agentic Language Model
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu BotPsy model AI?
BotPsy adalah model bahasa berukuran 0,8B parameter berbasis Qwen3.5-0.8B yang dirilis oleh Tether AI Research. Model ini dirancang khusus untuk menjalankan fungsi asisten pribadi dan pemanggilan tool secara lokal langsung di perangkat pengguna.
Apakah BotPsy bisa dijalankan secara offline?
Bisa banget. Karena dirilis dalam format safetensors dan GGUF (Q4, Q8, bf16), kamu bisa langsung menjalankannya secara lokal lewat runtime seperti llama.cpp atau QVAC SDK tanpa butuh koneksi internet sama sekali.
Seberapa jago performa BotPsy dibanding model lain?
BotPsy mengungguli semua model di bawah 1,2B parameter pada benchmark agen dan bahkan mengalahkan model Qwen3.5-2B yang berukuran 2,5 kali lebih besar pada lima dari enam tolok ukur pengujian tool-use.
Apakah BotPsy aman dari serangan prompt injection?
Tingkat keamanan BotPsy lebih tangguh dibanding pendahulunya, dengan tingkat kerentanan terhadap prompt injection turun menjadi 31% dibanding model dasarnya yang mencapai 46%.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.