Bikin Asisten AI Bedrock OpenClaw: Punya Memori dan Hemat Biaya
Asisten AI biasa gampang lupa obrolan lama. Lewat arsitektur AgentCore dan OpenClaw di AWS, kamu bisa bikin bot Telegram yang beneran ingat detail penggunanya.
· 11 menit baca
Inti singkat
- Asisten AI Bedrock OpenClaw mengatasi masalah amnesia bot dengan sistem AgentCore memory berlapis.
- Arsitektur serverless di AgentCore runtime hanya menagih komputasi aktif tanpa bayar waktu tunggu respons model.
- Dua model Claude dipakai terpisah: Haiku 4.5 untuk teks obrolan dan Sonnet 4.5 untuk penalaran visual.
- Prompt caching di Amazon Bedrock mampu memangkas biaya hingga 90 persen dan latensi sampai 85 persen.
Daftar isi7 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
AWS baru saja membagikan cara membangun asisten AI Bedrock OpenClaw yang punya memori jangka panjang persisten dan berjalan sepenuhnya serverless. Lewat panduan arsitektur agen AI ini, kamu nggak perlu lagi pusing bikin vector store manual cuma biar bot kenal preferensi lama penggunanya.
Sering ngerasa jengkel pas ngobrol sama chatbot AI karena dia gampang lupa? Hari ini kamu cerita panjang lebar soal masalah kerjaan atau hobi kamu, tapi pas disapa tiga minggu lagi, dia udah amnesia total. Masalahnya bukan di pintarnya jawaban model bahasa, melainkan ketiadaan memori jangka panjang yang bikin kamu harus terus-terusan mengulang konteks dari nol.
Nah, menurut panduan resmi dari AWS Machine Learning Blog, masalah itu bisa dibereskan pakai kombinasi sistem open source OpenClaw dan runtime AgentCore Amazon Bedrock. Lewat contoh bot berkebun bernama Sprout di Telegram, arsitektur ini membuktikan bahwa asisten pribadi yang kontekstual bisa dideploy dalam satu template CloudFormation dengan biaya operasional yang ramah di kantong.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Masalah Asisten AI Biasa dan Solusi Konteks AI Memory
Sebagian besar chatbot AI yang ada di pasaran bersifat stateless. Kalau kamu ngobrolin kebun hari ini, model AI sama sekali nggak ingat kalau tiga minggu lalu kamu bilang bedengan tanamanmu berpasir, kamu cuma pakai pupuk organik, atau bunga petuniamu lagi layu gara-gara cuaca panas. Beban buat menjelaskan ulang konteks selalu jatuh ke tangan kamu sebagai pengguna.
Di sinilah fitur konteks AI memory dari Amazon Bedrock AgentCore unjuk gigi. Fitur ini mengubah riwayat obrolan sekali pakai jadi basis pengetahuan yang tahan lama. Data ingatan ini diberi metadata terstruktur biar sistem bisa menarik catatan yang pas banget sama pertanyaan yang lagi kamu ajukan.
Meski contoh bot yang dibikin bernama Sprout, rancangan arsitektur agen AI ini sebenarnya agnostik atau bisa dipakai buat kebutuhan apa aja. Kamu cukup ganti persona dan daftar kemampuannya (skills), maka arsitektur yang sama langsung berubah jadi bot customer support, pelatih kebugaran pribadi, sampai meja bantuan internal kantor.
Bedah Arsitektur Agen AI: Serverless di Atas AgentCore Runtime
Seluruh komponen sistem asisten AI Bedrock OpenClaw ini dikemas rapi dalam satu template AWS CloudFormation tanpa butuh perkakas build yang ribet saat peluncuran. Alur kerjanya menghubungkan pesan pengguna sampai ke model AI secara otomatis.
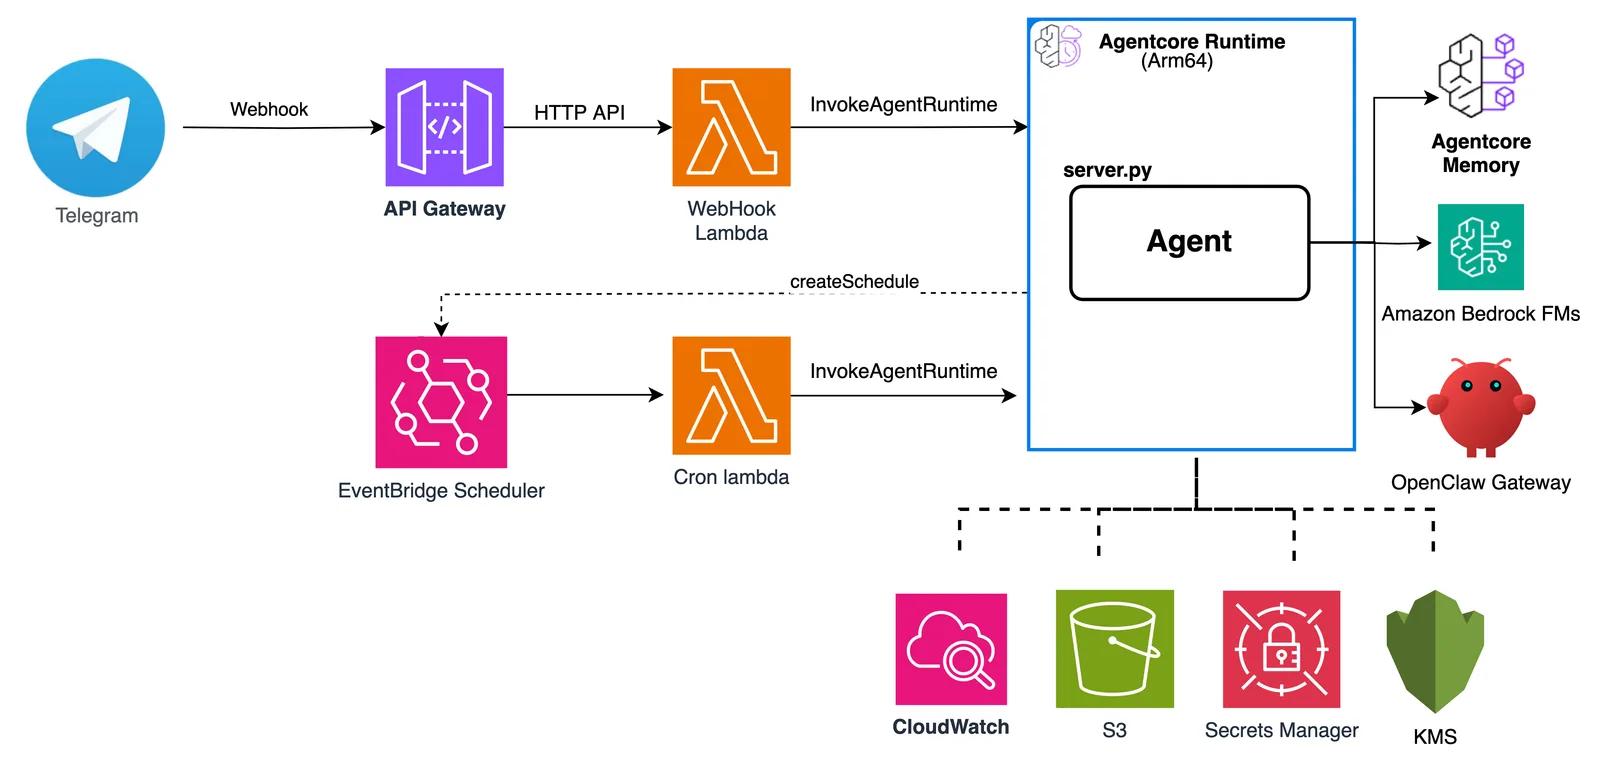
Alur kerjanya punya dua pintu masuk utama yang bermuara ke satu agen yang sama:
- Pesan Telegram: Dikirim oleh pengguna lewat antarmuka chat, masuk lewat Amazon API Gateway, lalu divalidasi oleh fungsi AWS Lambda sebelum memanggil API
InvokeAgentRuntime. - Pekerjaan Terjadwal (Cron): Dikirim oleh Amazon EventBridge Scheduler menuju fungsi Lambda terjadwal untuk mengirim pengingat proaktif, seperti jadwal menyiram tanaman pagi hari.
Di sisi runtime AgentCore, ada sebuah proses Python ringan (server.py) yang mengoordinasikan gateway OpenClaw, memori AgentCore, dan Amazon Bedrock Converse API. Seluruh penyimpanan ruang kerja ditangani oleh Amazon S3, enkripsi data diamankan AWS KMS, token bot disimpan di AWS Secrets Manager, dan metrik sistem dipantau lewat Amazon CloudWatch. Konsep otomasi proaktif ini sejalan dengan pembahasan kita soal ambient agents di Amazon Bedrock yang bisa jalan otomatis mengikuti event tertentu.
Keuntungan Hemat Biaya AgentCore Runtime
Agen ini berjalan di dalam container pada AgentCore runtime yang menerapkan skema konsumsi murni (consumption-based pricing). Artinya, kamu cuma ditagih buat komputasi yang beneran dipakai agen saat memproses data, bukan durasi jam dinding (wall-clock uptime). Kamu bahkan nggak perlu bayar waktu nganggur pas agen lagi nunggu balasan dari model AI.
Buat asisten pribadi yang dipakai berkala, perbedaan biayanya lumayan jauh. Pola serverless ini cuma makan biaya baseline sekitar $1–2 per bulan, beda jauh dibanding menyalakan instance Amazon EC2 terus-menerus yang bisa tembus kisaran $35 per bulan (berdasarkan estimasi penggunaan pribadi ringan per Juli 2026).
Kontrak containernya simpel banget: container berbasis linux/arm64 cuma perlu membuka port 8080, menyediakan endpoint GET /ping untuk health check, dan POST /invocations sebagai pintu masuk eksekusi perintah.
Peran OpenClaw sebagai Kerangka Kerja Agen
OpenClaw bertindak sebagai fondasi yang mengatur loop agen, penggunaan alat (tool use), dan sistem keterampilan. File pembungkus server.py menjalankan perintah openclaw gateway run sebagai sub-proses lokal.
Kerennya, AgentCore punya kemampuan mencairkan container yang sempat membeku (frozen container) saat idle. Karena ada kemungkinan sub-proses mati saat container aktif kembali, file pembungkus selalu memanggil fungsi ensure_openclaw_ready() buat mengecek ulang kesehatan gateway dan menyalakannya lagi kalau mati sebelum memproses pesan pengguna. Pola pembungkus ini bisa kamu tiru buat kerangka kerja agen open source apa pun tanpa perlu mengubah kode sumber aslinya.
Routing Dua Model AI: Teks dan Vision Dipisah
Kebutuhan obrolan teks biasa dan analisis gambar punya pertimbangan biaya serta kualitas yang jauh beda. Makanya, asisten AI Bedrock OpenClaw membagi tugas ke dua model Claude di Bedrock:
- Claude Haiku 4.5 untuk Teks: Dipakai buat interaksi harian bervolume tinggi karena responsnya cepat dan biayanya jauh lebih murah.
- Claude Sonnet 4.5 untuk Vision: Dipakai buat penalaran multimodal yang lebih berat, kayak menganalisis foto tanaman yang bermasalah.
Pesan teks dialirkan lewat gateway OpenClaw yang mengelola status sesi dan tools. Sedangkan pesan bergambar diproses langsung dari server.py menuju Amazon Bedrock Converse API tanpa lewat gateway OpenClaw. Ini dilakukan sengaja karena build internal OpenClaw sempat membuang konten image_url sebelum sampai ke Bedrock. Dengan memanggil Converse API langsung, model dijamin bisa melihat piksel gambar aslinya. ID kedua model ini disimpan di variabel lingkungan (MODEL_ID dan VISION_MODEL_ID), jadi kamu bisa ganti model kapan aja tanpa build ulang image container.
| Kebutuhan Tugas | Model yang Dipakai | Alasan Pemilihan | Jalur Pemrosesan |
|---|---|---|---|
| Obrolan Teks Harian | Claude Haiku 4.5 | Cepat dan hemat biaya untuk volume pesan tinggi | Lewat gateway OpenClaw |
| Analisis Foto & Visual | Claude Sonnet 4.5 | Penalaran multimodal kuat buat diagnosis akurat | Langsung via server.py ke Converse API |
Rahasia Memori: Dari Catatan Sesi Jadi Pengetahuan Abadi
Bagian paling menarik dari arsitektur ini ada pada pengelolaan memori AgentCore yang dibagi jadi dua lapisan utama:
- Memori Jangka Pendek (Short-term): Menyimpan setiap giliran obrolan sebagai event mentah lewat perintah
CreateEvent, dipetakan berdasarkanactorId(ID chat Telegram) dansessionId. - Memori Jangka Panjang (Long-term): Diekstraksi secara asinkron dari event mentah ke dalam catatan terstruktur yang tahan lama.
Ekstraksi jangka panjang ini memakai tiga strategi cerdas:
USER_PREFERENCE: Pilihan eksplisit yang diucapkan pengguna (misalnya: "Saya cuma pakai pupuk organik").SEMANTIC: Fakta yang disimpulkan model dari obrolan (misalnya: menanam Mexican petunia di bedengan baja Corten).SUMMARIZATION: Ringkasan episodik dari sesi obrolan sebelumnya (misalnya: membahas daun bawah yang menguning pas cuaca panas).
Isolasi Data Lewat Namespace dan Metadata
Biar data pengguna nggak tertukar, Sprout memisahkan catatan ke dalam namespace berbasis ID pengguna:
sprout/{chat_id}/long_term: Menyimpan preferensi dan fakta semantik.sprout/{chat_id}/episodic/{session_id}: Menyimpan ringkasan per sesi.
Selain namespace, metadata terstruktur dipakai buat menyaring ingatan sebelum disuntikkan ke prompt. Kuncinya, metadata cuma bisa difilter di sisi server kalau kamu mendaftarkannya sebagai kunci terindeks (indexed keys). Sprout memakai tiga kunci:
type: Membedakan jenis catatan (STRING).section: Lokasi bedengan atau area tanam (STRING).plants: Daftar tanaman yang tumbuh di area itu (STRINGLIST).
Tiap kunci bisa diset ekstraksinya ke STRICTLY_CONSISTENT (data pasti dari input event) atau LLM_INFERRED (disimpulkan oleh model AI dengan batasan nilai daftar tertentu biar kosakatanya seragam).
Alur Retrieval dan Perakitan Prompt
Setiap kali ada pesan baru dari pengguna, server.py menjalankan alur penarikan data secara ketat:
- Ambil Catatan: Memanggil
RetrieveMemoryRecordske namespace jangka panjang memakai query pesan pengguna, dibatasi maksimal 50 hasil dengan batas waktu (timeout) 3 detik. Kalau gagal atau lewat batas waktu, sistem tetap membalas pesan pengguna tanpa memori daripada bikin bot error. - Urutkan Prioritas: Preferensi eksplisit (
USER_PREFERENCE) ditaruh di urutan paling atas mendahului fakta kesimpulan model (inferred), lalu dipotong maksimal 50 catatan. - Simpan Event Baru: Setelah model membalas, bot memanggil
CreateEventuntuk menyimpan giliran obrolan pengguna dan asisten agar bisa diekstraksi ke memori jangka panjang berikutnya.
Karena ekstraksi memori berjalan asinkron di belakang layar, fakta yang baru kamu sebutkan di sesi sekarang baru bisa ditarik kembali pada sesi berikutnya. Pendekatan evaluasi dan pemantauan agen semacam ini juga dibahas mendalam di ulasan evaluasi multi agent Bedrock.
Hasil Nyata: Rencana Perawatan Personal dan Diagnosis Visual
Kombinasi memori dan kemampuan visual ini menghasilkan asisten yang beneran terasa hidup. Pengguna cukup bercerita santai dari hari ke hari soal tanamannya. Bot bakal otomatis menyerap data lokasi, paparan sinar matahari, dan jenis pot yang dipakai.
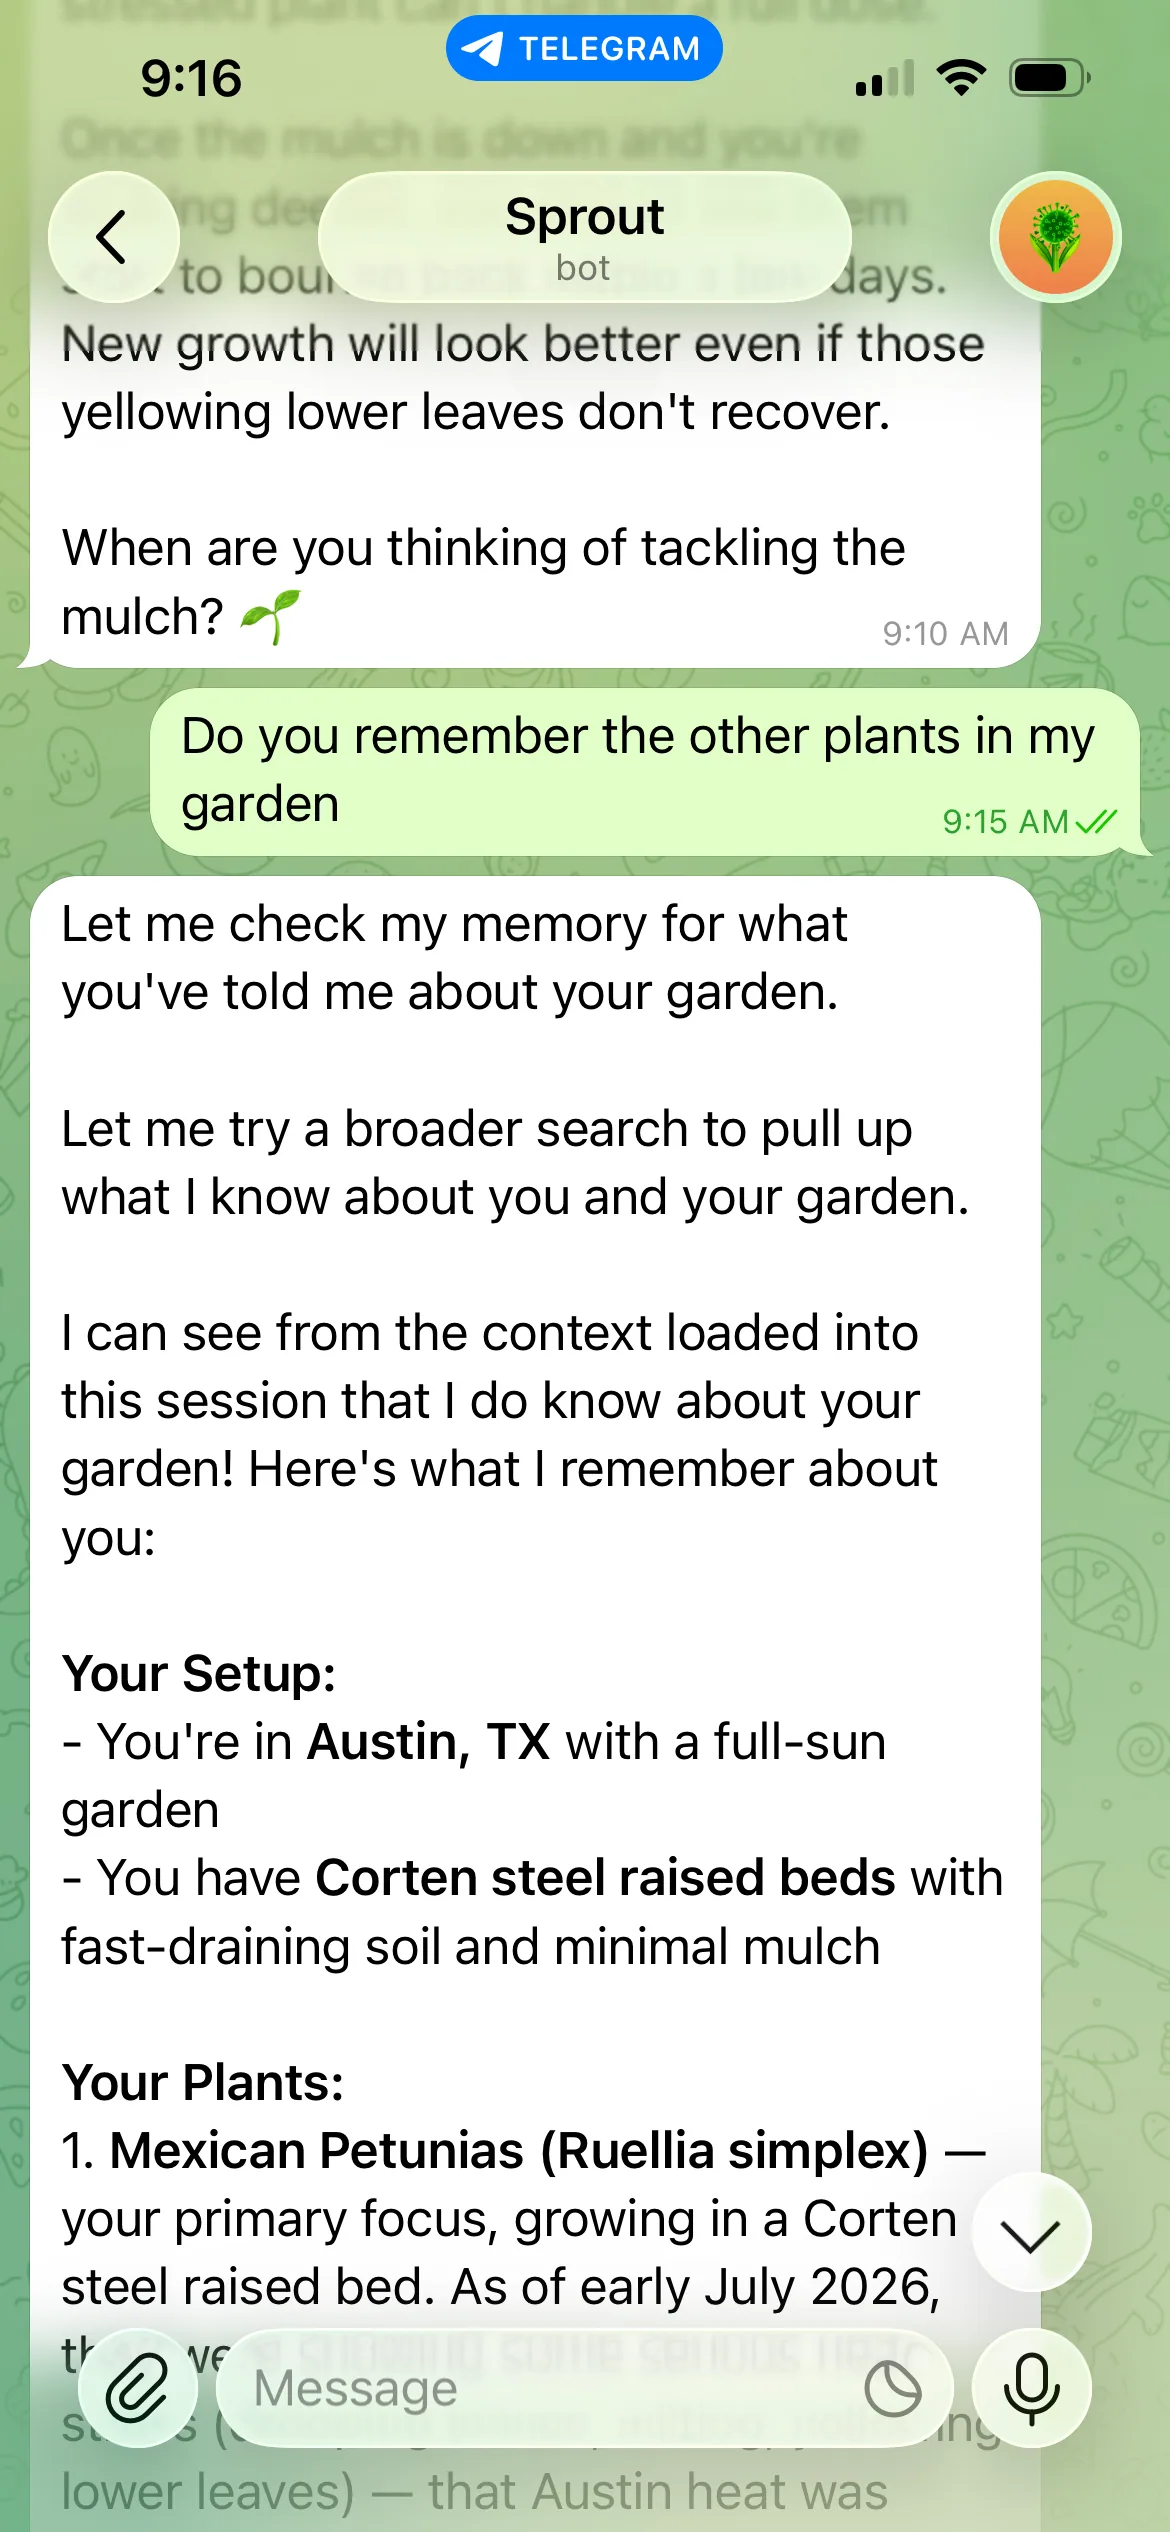
Ketika pengguna bertanya, "Kamu ingat tanaman apa saja yang ada di kebunku?", bot langsung menjawab lengkap dengan kondisi tanah dan lokasi penempatannya, padahal pengguna nggak menyebutkan detail itu di pesan terbarunya.
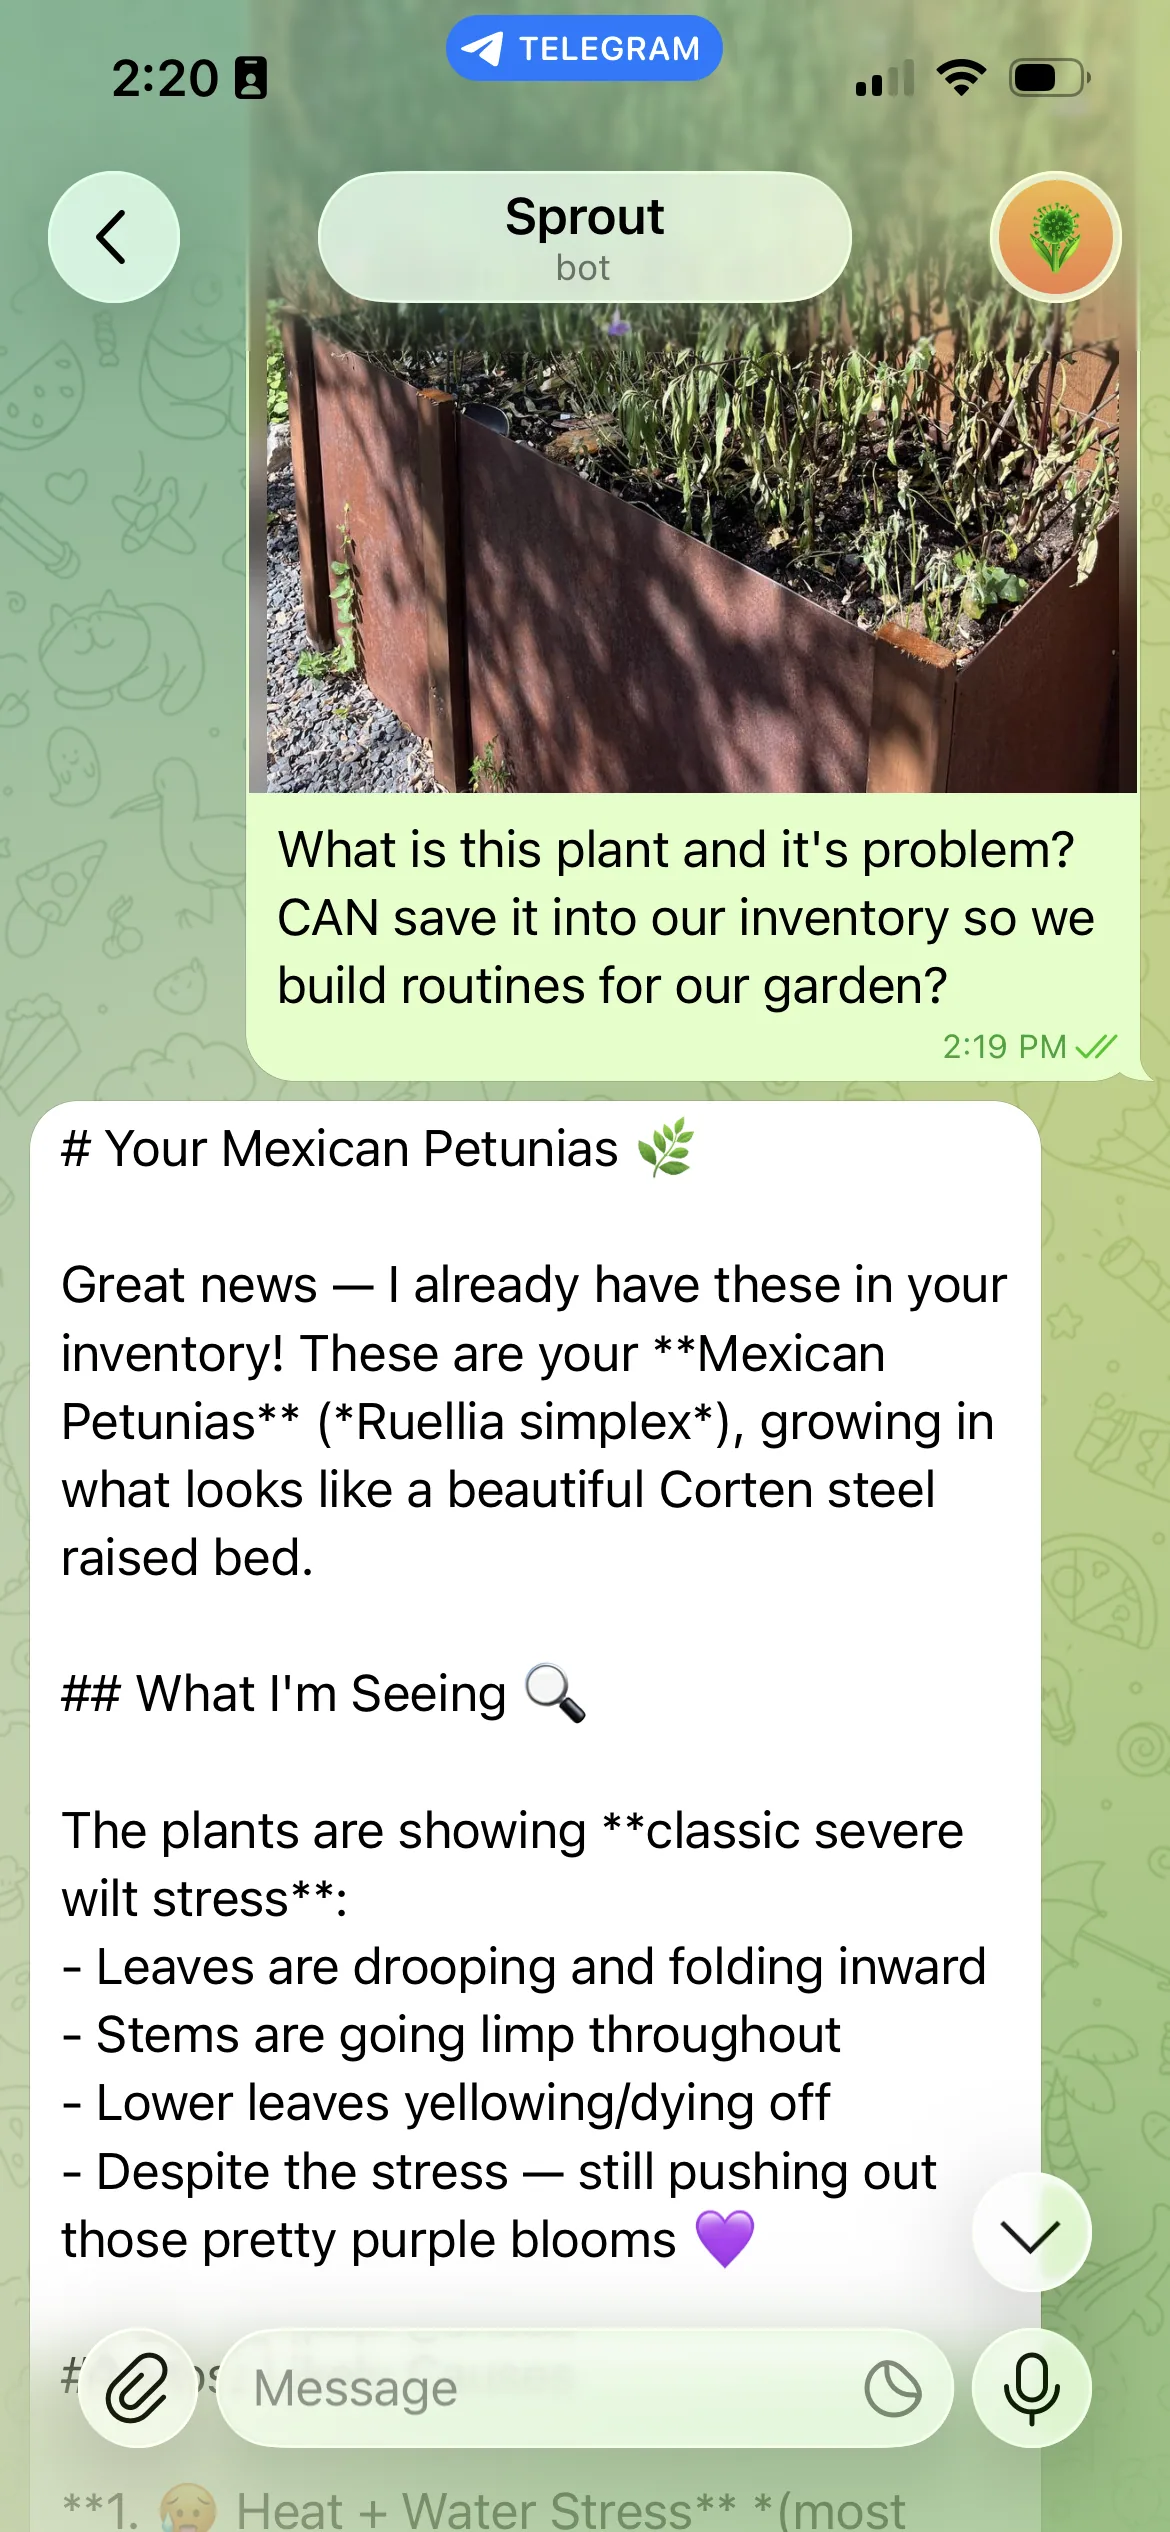
Keajaiban lainnya terjadi saat pengguna mengirim foto daun tanaman yang layu. Gambar dikirim ke Claude Sonnet 4.5, sementara system prompt disuntikkan memori kebun pengguna. Hasilnya, asisten langsung tahu bahwa tanaman layu itu adalah Mexican petunia milik si pengguna, bukan sekadar tebakan umum.
Dalam uji coba tanpa konteks memori, model sempat keliru mengira tanaman itu sebagai morning glory karena bentuk bunganya sama-sama mirip terompet ungu. Suntikan memori terbukti bikin akurasi diagnosis model visual melonjak tajam.
Pangkas Biaya Pakai Prompt Caching
Menyuntikkan puluhan catatan memori ke setiap giliran chat tentu bikin system prompt jadi bengkak. Kalau diproses mentah-mentah, kamu bakal tekor bayar token input berulang kali.
Solusinya adalah memanfaatkan fitur prompt caching di Amazon Bedrock. Caranya gampang: tata struktur prompt secara rapi dengan menaruh awalan yang stabil (persona bot dan blok memori hasil urutan) di bagian paling atas, lalu taruh input pengguna yang dinamis di bagian paling bawah. Bedrock bakal menyimpan cache awalan tersebut, sehingga kamu nggak perlu bayar komputasi ulang untuk teks yang sama. Fitur prompt caching ini mampu memangkas biaya token hingga 90 persen dan memotong latensi respons sampai 85 persen.
Contoh struktur prompt caching yang efektif bisa disusun seperti ini:
[SYSTEM INSTRUCTION: STABLE PREFIX]Kamu adalah Sprout, asisten kebun pribadi yang ramah. [MEMORI PENGGUNA TERVERIFIKASI]- Preferensi: Hanya menggunakan pupuk organik cair.- Lokasi: Balkon menghadap timur, panas terik pagi hari.- Tanaman: Mexican petunia di bedengan baja Corten. [KONTEKS SESI AKTIF]Gunakan data di atas untuk menjawab kebutuhan berkebun pengguna. [USER INPUT: VOLATILE]Daun bagian bawah tanaman petuniaku mulai layu, apa yang harus kulakukan?
Panduan Praktis dan Langkah Mencoba Mandiri
Berdasarkan pengujian arsitektur Sprout, ada beberapa prinsip desain utama yang perlu kamu pegang kalau mau bikin agen di stack ini:
- Bungkus, Jangan Fork: Adaptasikan kerangka kerja agenmu ke kontrak container AgentCore lewat file pembungkus HTTP sederhana (
server.py), jangan memodifikasi kode inti framework. - Rancang Namespace Sejak Awal: Jadikan ID pengguna (seperti chat ID Telegram) sebagai segmen pemisah utama namespace biar isolasi data antar pengguna terjamin aman.
- Anggap Memori Sebagai Pelengkap: Jangan biarkan kegagalan pengambilan memori bikin bot macet. Terapkan fallback agar bot tetap menjawab biasa kalau query memori timeout.
- Pisahkan Model Berdasarkan Beban Kerja: Gunakan model hemat untuk chat teks rutin dan simpan model multimodal bertenaga untuk permintaan analisis gambar.
- Pasang Batasan Anggaran (Budget Alert): Pasang AWS Budgets dengan alert di angka 80 persen dan 100 persen untuk memantau lonjakan komputasi sedini mungkin.
- Bikin Skills yang Spesifik: Satu skill cukup mengerjakan satu tugas terukur (misal: cek cuaca atau pasang alarm) agar model AI nggak bingung memilih fungsi.
Untuk mencobanya sendiri, AWS menyediakan repositori kode publik di sample-agentcore-memory-openclaw GitHub repository. Kamu punya dua opsi peluncuran:
- Peluncuran Sekali Klik (Launch Stack): Menggunakan template CloudFormation yang langsung mengambil image publik Amazon ECR. Kamu cuma butuh memasukkan token bot Telegram dari BotFather.
- Deploy Manual via Script: Menjalankan
scripts/deploy.shuntuk memvalidasi template, membuild image ARM64 ke ECR pribadi akunmu, mendeploy stack CloudFormation, dan mendaftarkan webhook Telegram secara otomatis.
Estimasi biaya untuk penggunaan pribadi ringan berkisar antara $5–9 per bulan per Juli 2026 (sekitar $2 untuk infrastruktur serverless, $1–3 untuk teks Claude Haiku 4.5, dan $2 untuk analisis gambar Claude Sonnet 4.5). Kalau sudah selesai mencoba, kamu cukup menghapus stack CloudFormation untuk membersihkan semua resource Lambda, API Gateway, dan EventBridge, serta menghapus data memori AgentCore agar tidak meninggalkan sisa biaya.
Solusi Alternatif: Coba Model AI Terbaik via Classai Router
Kalau kamu seorang developer yang pengin bereksperimen dengan model-model AI terbaik seperti keluarga Claude tanpa harus repot mengatur akun AWS Bedrock atau menyiapkan kartu kredit luar negeri, kamu bisa langsung mencoba Classai Router.
Lewat satu API key Classai Router, kamu bisa mengakses model Anthropic seperti Claude Haiku 4.5 (claude-haiku-4.5) dengan harga Rp160 per 1 juta token input dan Rp800 per 1 juta token output, serta Claude Sonnet 4.5 (claude-sonnet-4.5) seharga Rp160 per 1 juta token input dan Rp800 per 1 juta token output. Kamu juga bisa menjajal alternatif model penalaran lain seperti GLM 5.3 seharga Rp2.500 per 1 juta token input dan Rp3.500 per 1 juta token output atau DeepSeek V4.1 Flash seharga Rp160 per 1 juta token input dan Rp800 per 1 juta token output.
Integrasinya sangat gampang karena Classai Router sepenuhnya kompatibel dengan SDK OpenAI maupun Anthropic Messages API. Cukup ubah base URL ke router.classai.id/v1, dan kamu bisa langsung top up saldo mulai dari Rp10.000 memakai QRIS atau transfer virtual account bank lokal tanpa langganan bulanan.
Sumber & referensi
- 01
AWS · 7 Oktober 2026
Building a context-aware AI assistant on AgentCore and OpenClaw
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa bedanya asisten AI biasa dengan asisten AI berbasis AgentCore memory?
Asisten AI biasa bersifat stateless sehingga melupakan seluruh konteks obrolan lama begitu sesi ditutup. Sebaliknya, asisten berbasis AgentCore memory menyimpan riwayat obrolan secara terstruktur ke dalam memori jangka panjang, sehingga mampu mengenali preferensi dan riwayat pengguna di masa lalu.
Mengapa arsitektur OpenClaw di AgentCore ini bisa hemat biaya?
Arsitektur ini menggunakan serverless runtime di mana biaya komputasi hanya ditagih saat container aktif memproses tugas, tanpa membayar waktu tunggu balasan model. Selain itu, teknik routing model teks hemat serta prompt caching mampu memangkas biaya token hingga 90 persen.
Apakah data antar pengguna di bot Telegram bisa saling tertukar?
Tidak bisa tertukar karena sistem memori AgentCore memisahkan data ke dalam namespace unik berdasarkan chat ID masing-masing pengguna di Telegram. Setiap pengguna memiliki partisi ruang memori terisolasi yang tidak dapat diakses oleh pengguna lain.
Model AI apa saja yang digunakan dalam arsitektur asisten Sprout ini?
Sistem ini memadukan dua model Claude di Bedrock berdasarkan tugasnya, yaitu Claude Haiku 4.5 untuk menangani percakapan teks harian yang bervolume tinggi, dan Claude Sonnet 4.5 untuk tugas penalaran visual saat menganalisis foto tanaman.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.