Mistral Large 4 Le Chonk Rilis: Model 1T Buat Cyber dan Coding
Mistral ngerilis bobot model Mistral Large 4 alias Le Chonk dengan 1T parameter, fokus banget buat urusan keamanan siber defensif dan coding agent.
· 8 menit baca
Inti singkat
- Mistral Large 4 membawa total 1 triliun parameter dengan 49 miliar parameter aktif dan konteks 1 juta token.
- Model ini mencetak skor 82% pada pengujian reproduksi dan patch celah keamanan di Artificial Analysis Cyber Index.
- Bobot model dibagikan lewat Hugging Face di bawah lisensi Mistral Ecosystem Open-Weight License.
- ML4 mengalahkan DeepSeek V4 Pro 0813 dan Qwen3.8 Max di indeks coding agent dengan konsumsi token 47% lebih hemat dari GLM-5.3.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
Mistral resmi ngerilis bobot model terbarunya, Mistral Large 4 alias Le Chonk, yang punya total 1 triliun parameter dan dirancang khusus buat ngerjain tugas keamanan siber serta coding agent.
Kabar seru ini diumumkan langsung lewat laporan teknis Hugging Face dan ikut diulas sama TechCrunch. Model raksasa multimodal ini pakai arsitektur Mixture-of-Experts (MoE) dengan 49 miliar parameter aktif di setiap token, plus jendela konteks super lega sampai 1 juta token. Menariknya, Mistral sengaja ngebuka bobot modelnya (open weights) biar perusahaan maupun instansi pemerintah bisa ngejalanin dan ngontrol sistem AI canggih ini langsung di server sendiri tanpa ketergantungan pihak luar.
Langkah ini jelas bikin peta persaingan model AI makin seru. Menurut CEO Mistral, Arthur Mensch, AI itu semestinya "jadi alat buat pemberdayaan, bukan dominasi." Penasaran kan segemuk apa kemampuan Le Chonk? Yuk, kita bedah bareng arsitektur, hasil benchmark, sampai cara nyobainnya!
Panduan gratis · gratis
30 Prompt AI untuk Kerja (Bahasa Indonesia)
Prompt siap salin untuk email, rapat, laporan, riset, konten, dan belajar — semuanya memakai Rumus PAKET.
- 30 prompt siap salin untuk 6 jenis pekerjaan
- Rumus PAKET: Peran, Audiens, Konteks, Ekspektasi, Tampilan
- Cara memperbaiki jawaban AI yang kurang pas
- Daftar data yang tidak boleh masuk ke AI
Apa Itu Mistral Large 4 Le Chonk?
Mistral Large 4 adalah model multimodal yang bisa nerima input teks bareng gambar terus ngasilin teks. Julukan "Le Chonk" emang pas banget disematkan karena badannya yang bongsor: total parameternya nyentuh angka 1 triliun. Tapi tenang aja, biarpun ukurannya gede banget, proses komputasinya nggak bikin server megap-megap karena sistem cuma ngaktifin 49 miliar parameter tiap kali memproses sebuah token.
Model ini resmi dirilis dalam dua varian bobot bawaan, yaitu FP8 dan NVFP4. Komunitas juga langsung gerak cepat ngasih format GGUF lewat Unsloth dan tim llama.cpp. Mistral membagikannya lewat lisensi Mistral Ecosystem Open-Weight License, semacam turunan lisensi MIT yang ngizinin pemakaian bebas buat internal tapi ngasih batasan ketat kalau ada yang mau ngejualnya lagi sebagai layanan model-as-a-service.
Bedah Arsitektur Le Chonk: Kenapa Model 1T Ini Bisa Irit?
Di balik bobot 1T miliknya, decoder teks Mistral Large 4 dibangun pakai 72 layer, dimensi tersembunyi (hidden dimension) 6.144, dan 64 attention heads. Mistral menggabungkan dua bentuk penghematan (sparsity) sekaligus: milih jaringan pakar lewat MoE dan milih posisi konteks lewat mekanisme perhatian khusus.
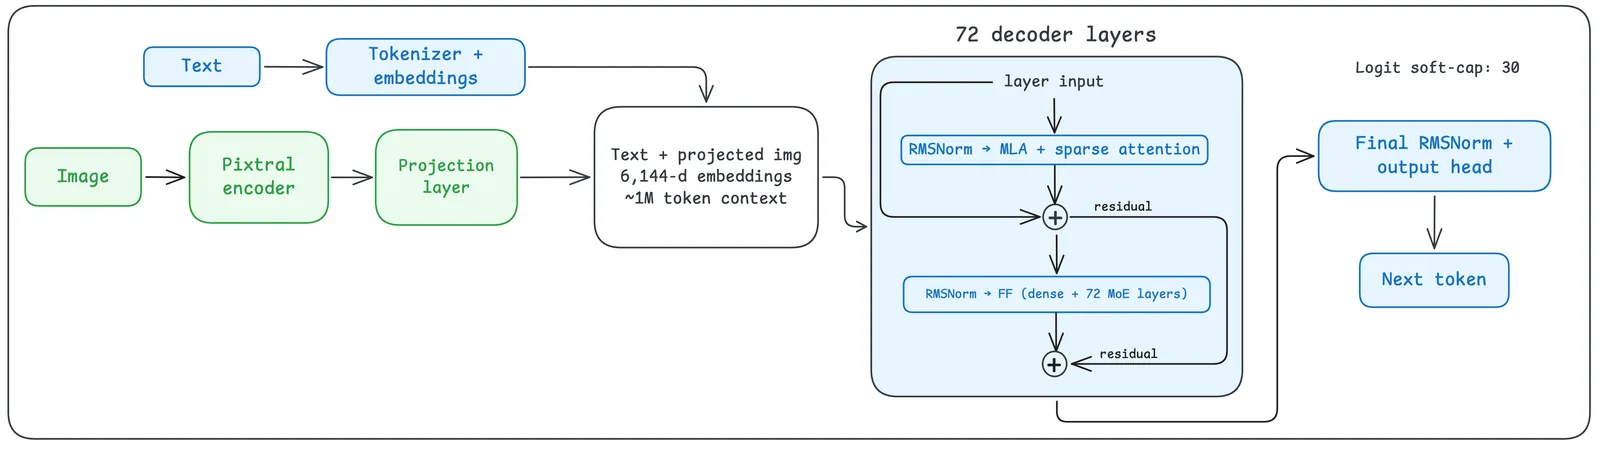
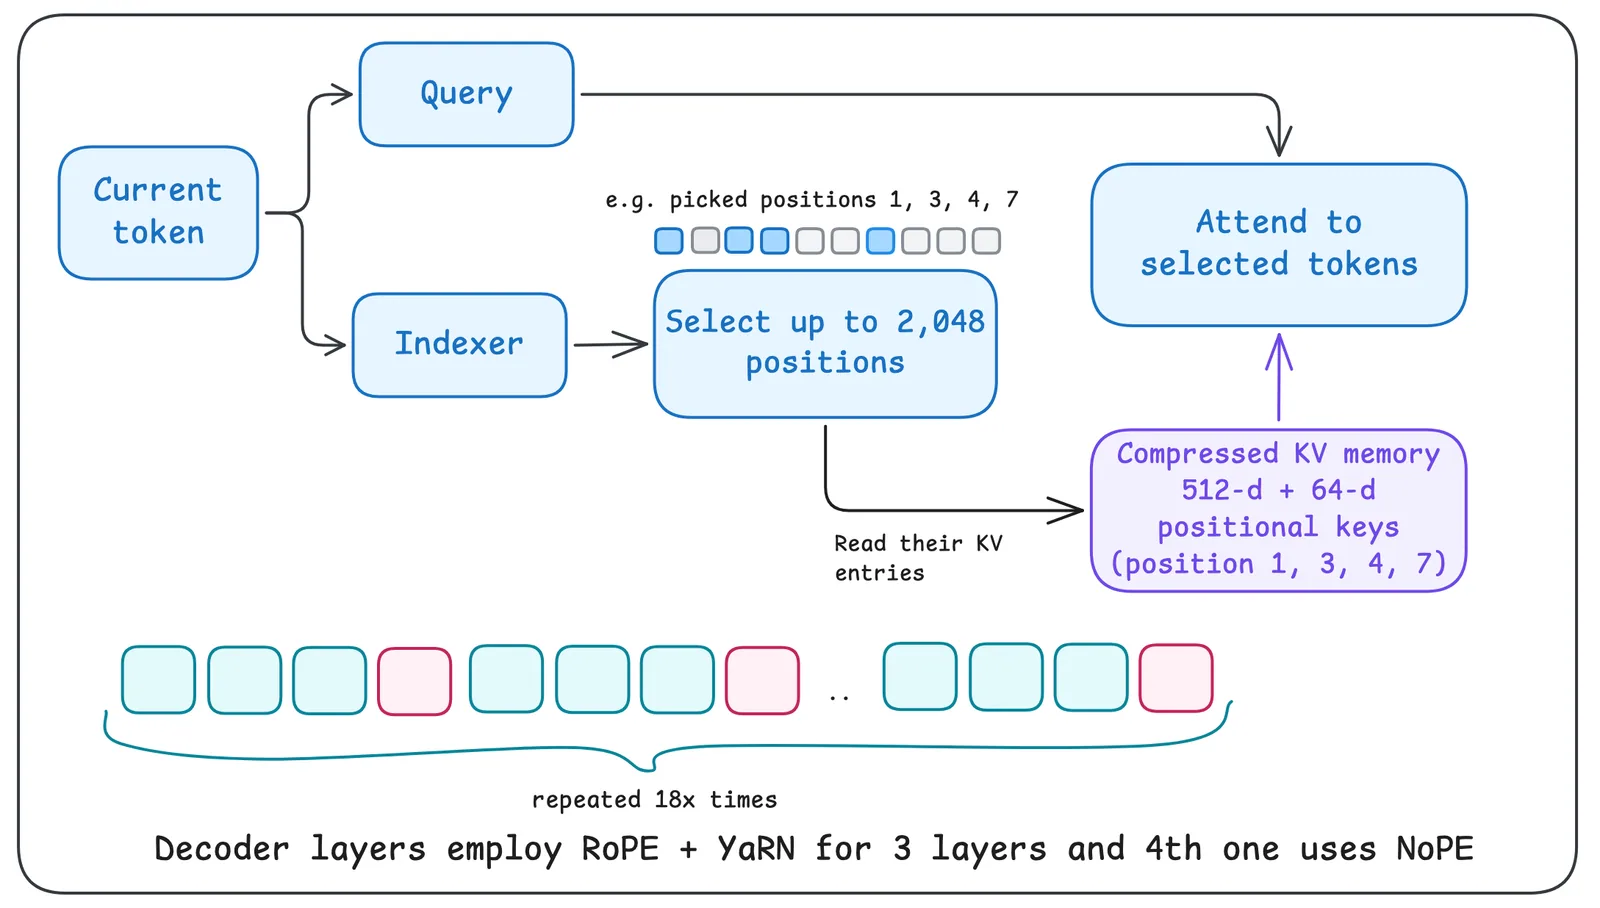
Blok perhatiannya memadukan Multi-head Latent Attention (MLA) dengan pengindeks DeepSeek Sparse Attention (DSA). Fungsinya simpel tapi pintar: MLA menjaga representasi Key-Value (KV) tetap padat, sementara DSA ngecek dan milih maksimal 2.048 posisi kunci yang paling pas buat tiap pertanyaan. Model ini juga menerapkan pola 3:1 antara RoPE dan NoPE, di mana tiga layer decoder pakai RoPE dan layer keempat pakai NoPE, ditambah sistem LeRope (YaRN-scaled RoPE) dengan pengali otomatis di tiap frekuensinya.
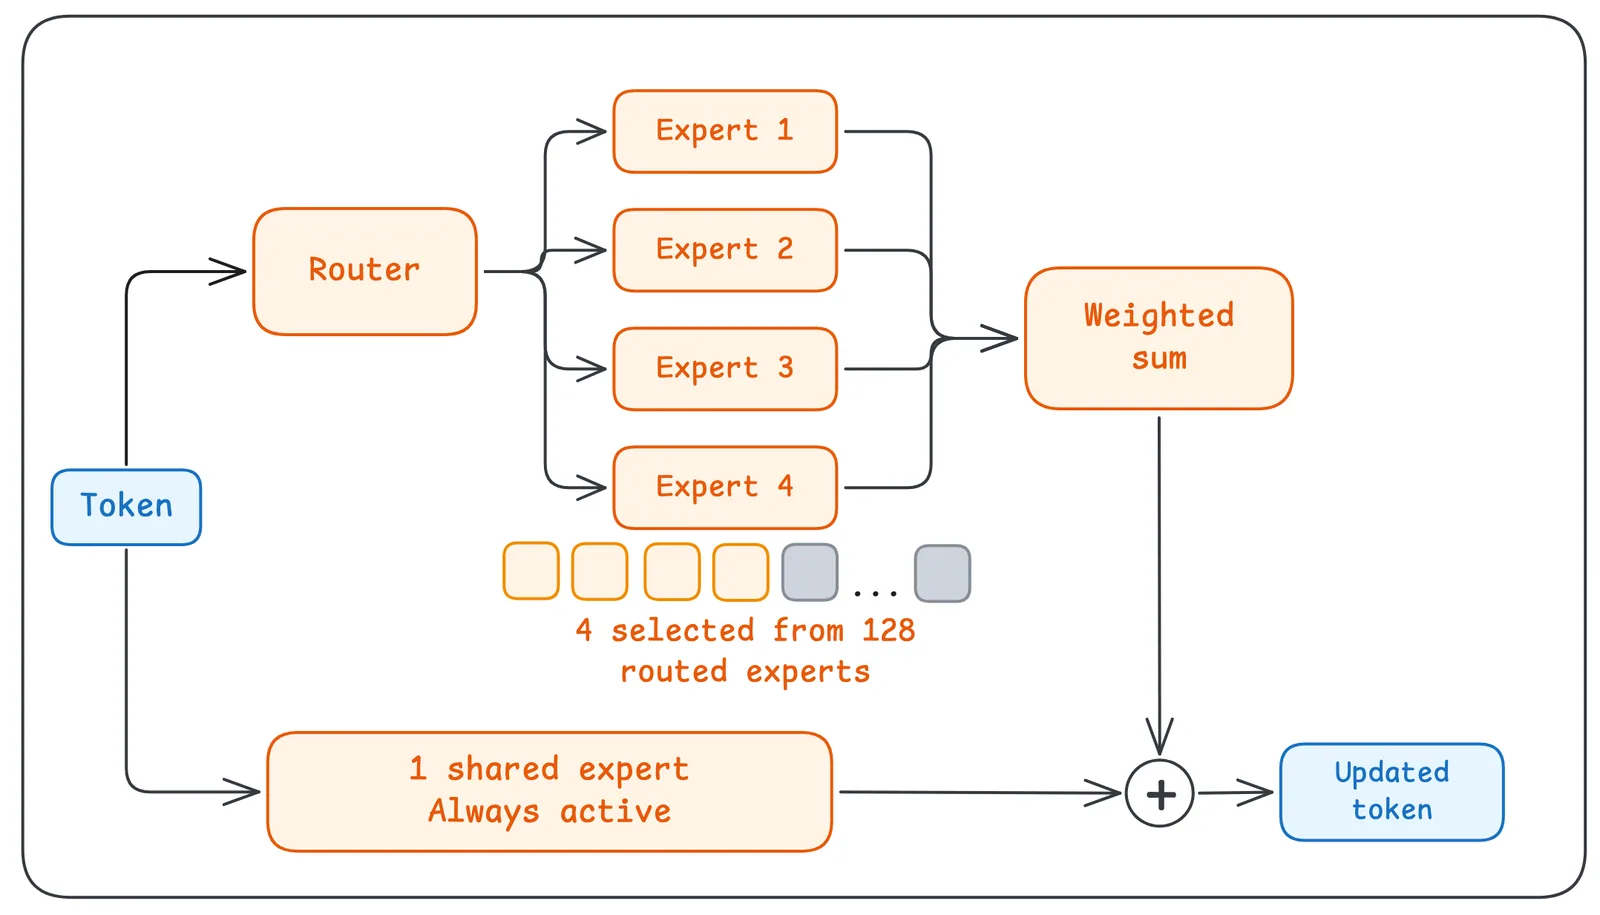
Urusan feed-forward-nya juga unik. Layer paling pertama pakai jaringan padat (dense), tapi 71 layer sisanya memakai blok MoE. Di tiap token, router softmax bakal milih 4 dari total 128 pakar (experts), ditambah 1 pakar bersama (shared expert) yang selalu aktif barengan. Jadi, totalnya ada 5 pakar aktif per token.
Vision Encoder Pixtral: Langsung Paham Gambar Tanpa Tool Tambahan
Bukan cuma jago teks, Mistral Large 4 juga dibekali encoder visual Pixtral berukuran 1,6 miliar parameter. Pixtral punya 30 layer, dimensi tersembunyi 2.048, dan 16 attention heads.
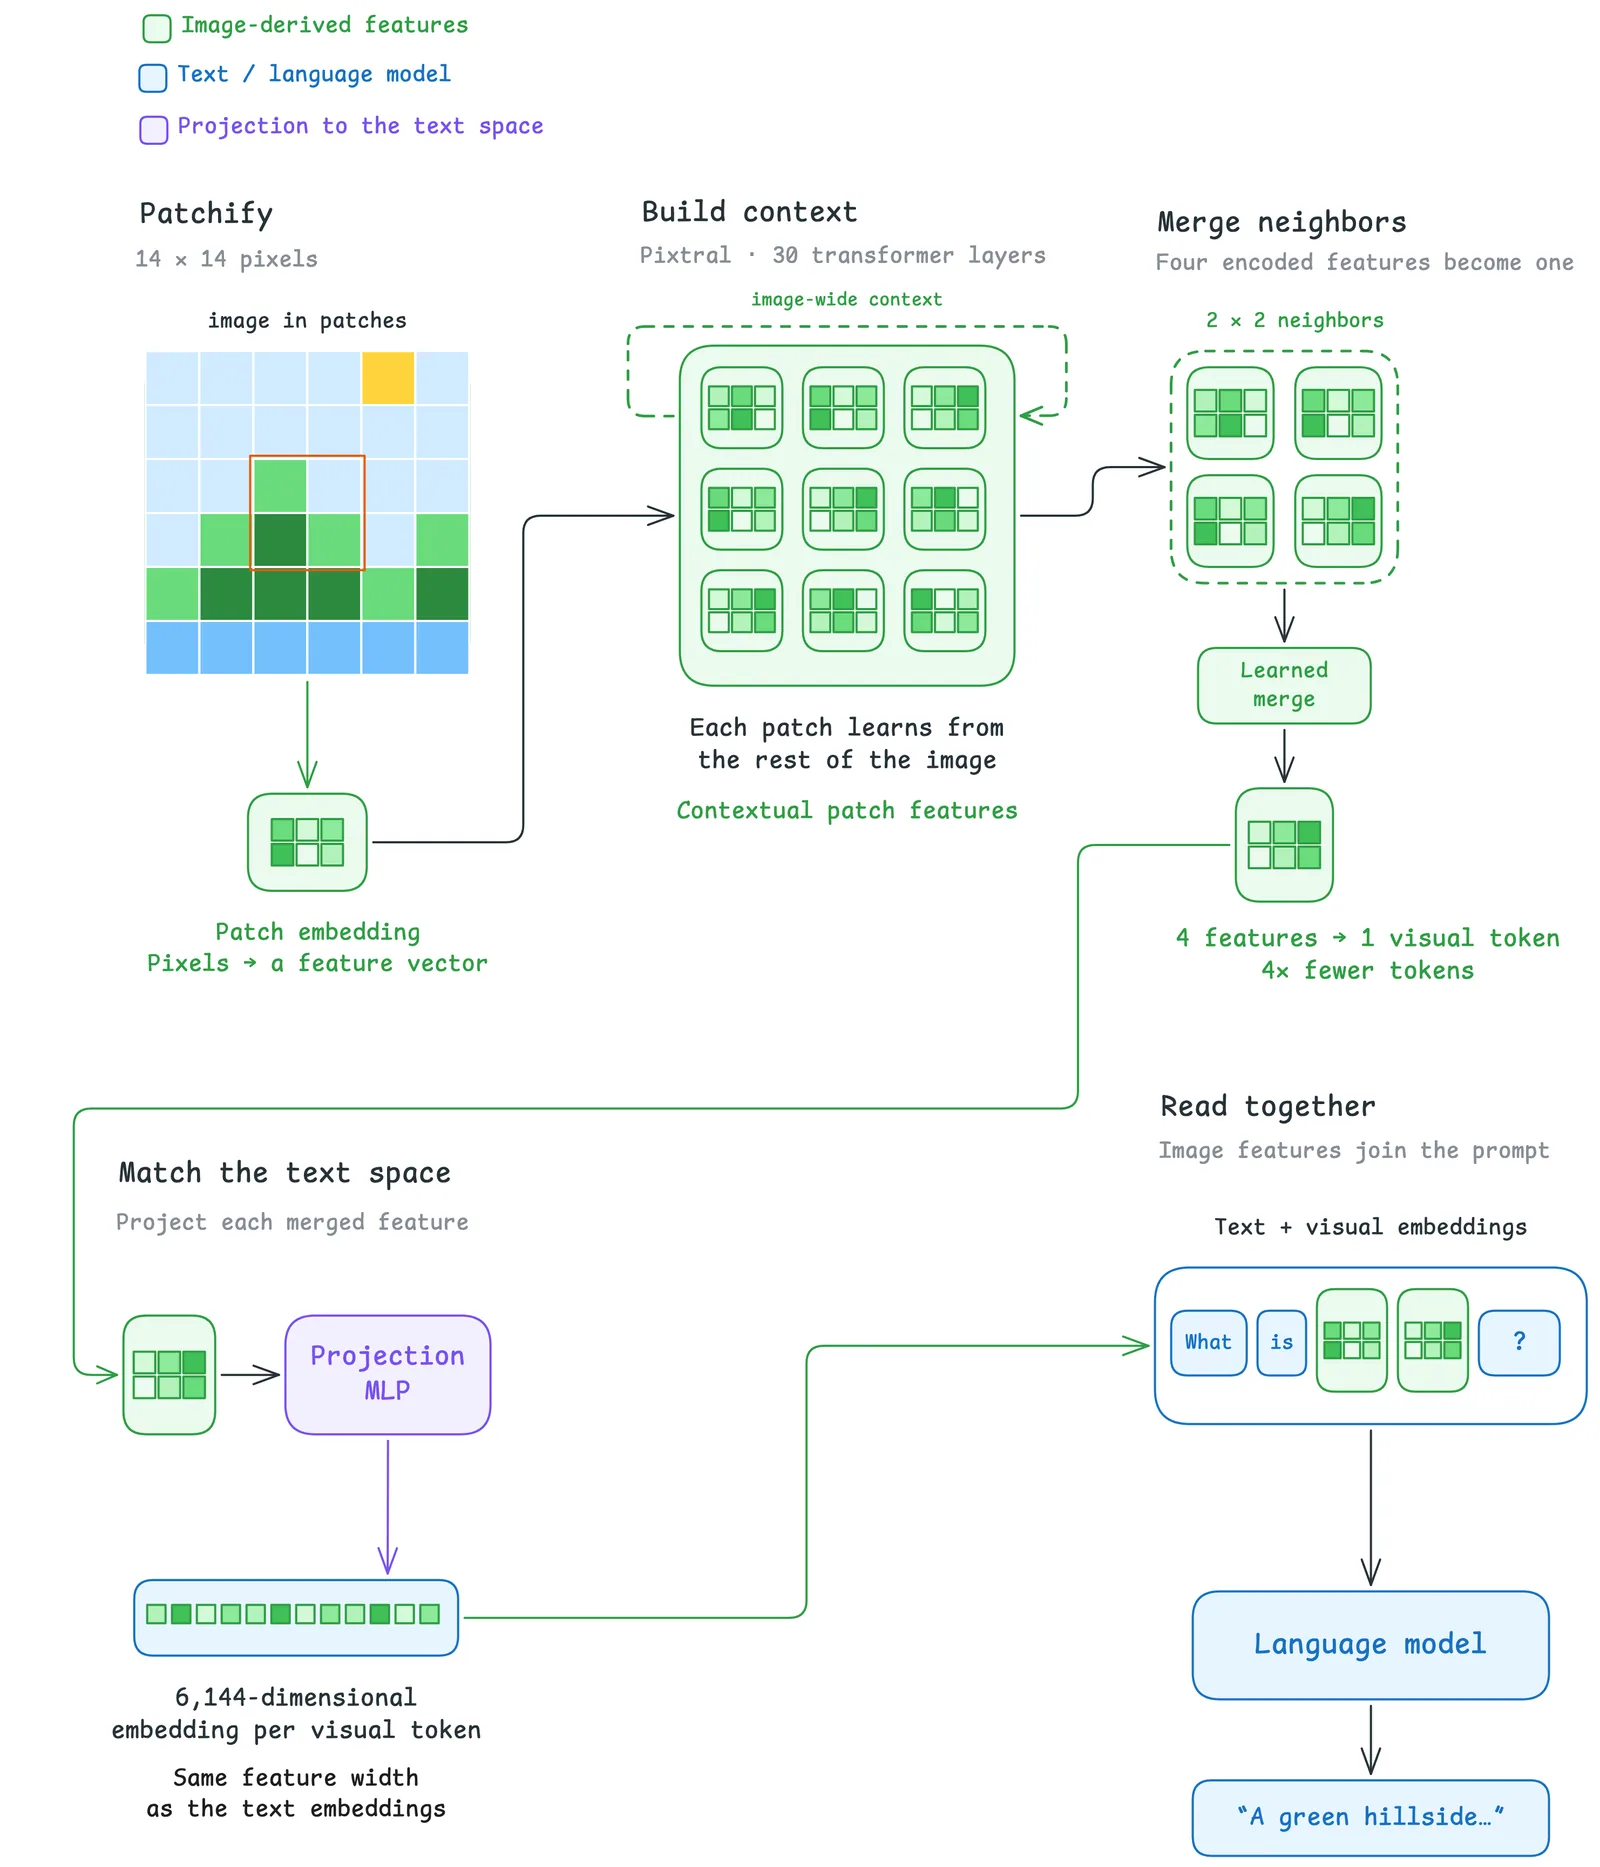
Encoder ini bekerja motong gambar jadi kotak-kotak patch ukuran 14 x 14 sebelum diproses lewat patch-merge projector dengan ukuran penggabungan spasial 2. Karena udah nyatu dari awal, Le Chonk bisa langsung kamu ajak ngecek tangkapan layar bug sistem, diagram arsitektur cloud, sampai dokumen teknis yang rumit tanpa perlu oper-operan data ke model visual lain.
Jagoan Keamanan Siber: Nggak Bakal Nolak Diajak Riset Bug
Keamanan siber defensif adalah panggung utama tempat Mistral Large 4 bersinar. Selama ini, tim pertahanan siber sering banget dibikin kesel sama model AI komersial tertutup. Pas lagi menganalisis celah keamanan atau ngecek sampel malware, permintaan mereka malah sering ditolak mentah-mentah sama filter penyedia cloud karena dikira lagi nyerang sistem.
Pierre Stock dari Mistral ngejelasin kalau merilis bobot model secara terbuka bikin organisasi punya kendali penuh atas pertahanan mereka. Akses intelijen ini nggak bakal bisa diputus tiba-tiba di tengah penanganan insiden darurat. Hebatnya lagi, biarpun fleksibel buat kerjaan sekuriti, ML4 tetap punya tingkat penolakan paling tinggi di antara model terbuka lain pas dicekoki perintah perusak di uji JailbreakBench, StrongREJECT, dan AgentHarm.
Berikut bukti taring ML4 di pengujian keamanan siber dunia:
- Artificial Analysis Cyber Index: ML4 nangkring di jajaran 5 besar model terbaik dunia buat urusan nemuin sekaligus nambal celah software.
- Vulnerability Reproduction & Patching: Dapat skor 82%, rekor paling tinggi di pengujian ini. Model ini disuruh ngulangin celah asli di proyek open source terus langsung bikin kode tambalannya (patch).
- Cybench: Sukses nyelesein 93% dari 40 tantangan kompetisi keamanan siber (capture the flag).
- Lakera B3: Nunjukin ketahanan 93,3% dari serangan injeksi prompt (prompt injection).
Benchmark Coding Agent dan Produktivitas Kerja
Buat urusan ngoding otomatis, Mistral Large 4 juga nggak main-main. Dibandingin sama model terbuka asal Tiongkok, GLM-5.3, Mistral ngaku modelnya 47% lebih irit token pas ngerjain tugas yang sama, jadi biaya operasionalnya kerasa jauh lebih murah.
Yuk intip perbandingan skor benchmark performa Mistral Large 4 dari data Artificial Analysis:
| Tolok Ukur Benchmark | Skor ML4 | Keterangan & Perbandingan |
|---|---|---|
| Artificial Analysis Coding Agent Index | 49,8% | Lebih unggul dari DeepSeek V4 Pro 0813 dan Qwen3.8 Max |
| DeepSWE v1.1 | 61,7% | Ngetes kemampuan nyelesein isu rekayasa software riil |
| SWE-Atlas-QnA | 59,4% | Pemahaman tanya jawab di repositori kode rumit |
| Terminal-Bench 4 | 28,3% | Eksekusi perintah langsung di terminal Linux |
| AutomationBench | 59,9% | Otomasi alur kerja proses bisnis |
| AA-Briefcase | 1.393 Elo | Tugas kantoran jangka panjang (long-horizon) |
| Artificial Analysis Intelligence Index | Peringkat 5 | Model terbuka terbaik ke-5 per 29 Oktober 2026 |
Skor ini nunjukin kalau Le Chonk emang udah siap diajak terjun ke proyek software beneran, mirip kemampuan audit repositori yang pernah kita bahas pas CodeRabbit GPT-6.1 Sol rilis.
Cara Nyobain dan Menjalankan Mistral Large 4
Kamu nggak perlu nunggu lama buat nyobain model ini karena ekosistem open source udah ngasih dukungan sejak hari pertama rilis. Berikut beberapa opsi praktis yang bisa kamu pakai:
1. Pakai Library Transformers
Kamu tinggal pasang transformers versi paling baru terus panggil AutoModelForMultimodalLM bareng AutoProcessor. Kamu bisa nyetel penalaran (reasoning effort) ke opsi low, medium, atau high (default).
import os
from transformers import AutoProcessor, AutoModelForMultimodalLM, DistributedConfig

distributed_config = DistributedConfig(
    tp_size=int(os.environ["WORLD_SIZE"]),
    ep_size=int(os.environ["WORLD_SIZE"]),
)

model_id = "mistralai/Mistral-Large-4-1T-A52B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(
    model_id,
    distributed_config=distributed_config,
)
Kamu bisa ngejalanin skrip multi-GPU di atas lewat perintah terminal torchrun --nproc-per-node 8 script.py.
2. Jalankan Kencang Lewat vLLM
Buat varian NVFP4, vLLM udah ngedukung chip NVIDIA arsitektur Blackwell dan draft head DSpark buat nyepetin proses pembacaan token. Tinggal jalanin perintah vllm serve mistralai/Mistral-Large-4-1T-A52B-NVFP4 pakai tensor parallel 8.
3. Nyobain di Komputer Lokal Pakai Llama.cpp
Tim llama.cpp nyediain banyak ukuran kuantisasi kayak IQ2_XXS, Q2_K, Q4_K_M, sampai NVFP4. Yang bikin kaget, versi 2-bit ternyata sanggup jalan di satu perangkat Apple Silicon Ultra yang punya unified RAM 512 GB! Di M3 Ultra, kuantisasi Q2_K dapet kecepatan prefill sekitar 90 token/detik dan generasi 15 token/detik.
Kalau pakai 4 kartu RTX6000 Pro, format IQ2_XXS bisa ngasih prefill sampai 500 token/detik dan generasi 30 token/detik di konteks pendek.
4. Deploy Skala Perusahaan Lewat Dell Enterprise Hub
Buat tim yang punya server Dell AI (NVIDIA H200, B200, GB200, atau GB300), kamu tinggal pasang CLI via pip install dell-ai && dell-ai login terus langsung deploy model ke cluster server tanpa ribet ngetik konfigurasi dari nol.
Ini contoh prompt audit kode yang bisa langsung kamu salin pas ngecek skrip backend:
Kamu adalah auditor keamanan siber senior. Tolong bedah cuplikan kode backend berikut:1. Cari celah kerentanan yang ada (seperti bug otentikasi, injeksi query, atau kebocoran memori).2. Buat langkah reproduksi minimal biar tim tahu gimana celah itu bisa terjadi.3. Tuliskan kode perbaikan (patch) yang rapi dan jelaskan kenapa cara ini aman.
Efeknya Buat Developer dan Perusahaan di Indonesia
Rilisnya model bongsor ini ngasih dampak yang lumayan kerasa buat praktisi teknologi di Indonesia, khususnya perbankan, instansi pemerintah, dan startup yang wajib patuh sama aturan kerahasiaan data seperti UU Pelindungan Data Pribadi (UU PDP).
- Data Sensitif Nggak Perlu Keluar: Perusahaan bisa naruh model ini di data center lokal sendiri. Log crash server dan kode aplikasi rahasia nggak perlu lagi dikirim lewat API luar negeri.
- Kerja Tim Security Makin Gesit: Saat ada insiden di malam hari, tim IT lokal bisa langsung minta model ngereproduksi celah dan nyiapin draf tambalan tanpa waswas kuota API disetop sepihak.
- Hemat Biaya Token: Sifatnya yang 47% lebih irit token ketimbang model kayak GLM-5.3 bikin tagihan listrik maupun biaya sewa server inferensi jangka panjang jadi jauh lebih masuk akal.
Kalau kamu butuh perbandingan sama model komersial lain yang juga jago mikir dan ngoding, kamu bisa intip ulasan performa Gemini 4 Carbon yang punya fokus serupa.
Mau Nyobain Model AI Canggih Tanpa Pusing Mikirin Server?
Harus diakui, ngejalanin model raksasa 1 triliun parameter kayak Mistral Large 4 butuh spek server GPU yang harganya nggak murah. Tapi tenang, kalau kamu pengembang yang pengin langsung nyobain model penalaran canggih tanpa pusing urusan pasang rig server sendiri, kamu bisa mampir ke Classai Router.
Lewat Classai Router, kamu cukup modal satu API key yang udah pas banget sama SDK OpenAI maupun Anthropic. Kamu bisa langsung nyicipin model-model papan atas lainnya kayak glm-5.3 (Rp1.875 input / Rp9.120 output per 1 juta token), deepseek-v4-pro-0813 (Rp3.210 input / Rp8.175 output), atau qwen3.8-max (Rp1.950 input / Rp9.720 output). Nggak perlu pusing kartu kredit luar negeri karena saldo bisa langsung diisi mulai Rp10.000 lewat QRIS.
Buat kamu yang pengin makin jago nerapin AI di alur kerja software, yuk intip juga materi praktis di kelas AI untuk Developer biar skill teknismu makin relevan di era sekarang!
Sumber & referensi
- 01
Hugging Face · 29 Oktober 2026
Welcome Le Chonk: Mistral Large 4 on Hugging Face - 02
TechCrunch · 29 Oktober 2026
Mistral releases weights for its trillion-parameter AI model, targeting cybersecurity
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Berapa total parameter Mistral Large 4 Le Chonk?
Mistral Large 4 punya total sekitar 1 triliun parameter dengan arsitektur Mixture-of-Experts (MoE). Walaupun badannya bongsor, model ini cuma ngaktifin 49 miliar parameter di setiap token yang diproses, jadi proses komputasinya tetap efisien.
Apakah Mistral Large 4 bisa diunduh gratis?
Iya, bobot modelnya bisa langsung diunduh lewat Hugging Face di bawah lisensi Mistral Ecosystem Open-Weight License. Lisensi ini ngebebasin kamu pakai buat kebutuhan internal, tapi ngelarang model ini dijual ulang sebagai layanan model-as-a-service pihak ketiga.
Spesifikasi komputer apa yang sanggup ngejalanin Le Chonk?
Buat varian FP8 penuh, kamu butuh node server berisi 8 GPU kelas NVIDIA H200 atau B300. Tapi buat kuantisasi 2-bit lewat llama.cpp, model ini udah bisa jalan di satu komputer Apple Silicon Ultra dengan memori terpadu 512 GB.
Kenapa Mistral Large 4 dijagokan buat keamanan siber?
Model ini berhasil nyetak skor 82% di pengujian Artificial Analysis Cyber Index buat nemuin dan nambal celah software. Karena bobotnya bisa dipasang di server lokal, tim sekuriti bebas nguji malware tanpa takut terhalang filter penolakan yang sering muncul di API model tertutup.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.