FLUX 3 Image Klein Rilis: Bikin Gambar dan Tata Layout Jadi Mudah
Black Forest Labs resmi meluncurkan FLUX.3 Image Klein di Hugging Face Diffusers. Model ini bisa text-to-image, multi-reference, dan punya layout control pakai bounding box.
· 8 menit baca
Inti singkat
- FLUX.3 Image Klein menyatukan text-to-image, multi-reference editing, dan kontrol tata letak berbasis bounding box dalam satu model.
- Versi distilled mampu memproses gambar 1024x1024 hanya dalam waktu sekitar 2 detik pada GPU NVIDIA H100.
- Tersedia varian bobot terkuantisasi FP8 (fp8r) dan NVFP4 untuk dijalankan pada GPU dengan memori VRAM lebih terbatas.
- Model ini memakai encoder teks Qwen3-VL dan arsitektur flow matching dua tahap yang fleksibel.
Daftar isi8 bagian
- 01
- 02
- 03
- 04
- 05
- 06
- 07
- 08
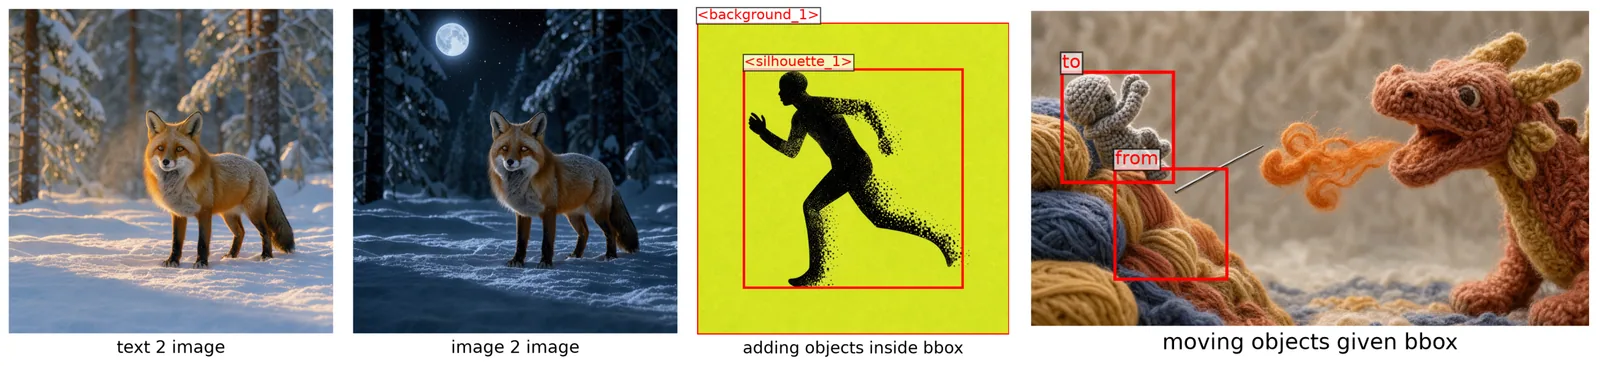
Black Forest Labs resmi merilis FLUX.3 Image Klein, model open weights terbaru yang langsung didukung oleh ekosistem Hugging Face Diffusers sejak hari pertama. Lewat pembaruan ini, satu model bisa menangani kebutuhan text-to-image, multi-reference image-to-image, sekaligus kontrol tata letak visual (layout control) presisi memakai koordinat kotak pembatas (bounding box).
Kabar gembira ini diumumkan langsung melalui blog resmi Hugging Face. Kalau biasanya kamu harus pusing menggabungkan beberapa adapter terpisah cuma buat mengatur posisi objek di kanvas, FLUX.3 sekarang membawa kontrol tata letak langsung di dalam prompt. Yuk, kita kupas tuntas fitur baru, arsitektur di baliknya, dan cara mencobanya di kode Python kamu.
Panduan gratis · gratis
Panduan Cepat API AI untuk Developer
Dari request pertama sampai siap produksi: contoh kode, streaming, kontrol biaya, keamanan API key, dan penanganan error.
- Contoh request dengan cURL, Python, dan JavaScript
- Streaming dan format OpenAI vs Anthropic
- Cara mengontrol biaya token
- Checklist keamanan dan siap produksi
Apa Saja Kemampuan Baru di FLUX.3 Image Klein?
FLUX.3 Image Klein hadir dengan dua jenis checkpoint di koleksi Hugging Face. Pertama, ada versi time step distilled (black-forest-labs/flux-3-image-klein) yang ditujukan buat inferensi kilat cukup dengan 16 langkah tanpa Classifier-Free Guidance (CFG). Kedua, tersedia varian base (black-forest-labs/flux-3-image-klein-base) yang berjalan di 50 langkah dengan panduan CFG penuh, cocok banget buat bahan fine-tuning lanjutan.
Secara garis besar, ada tiga fitur utama yang bikin model ini sangat menarik buat alur kerja kreatif:
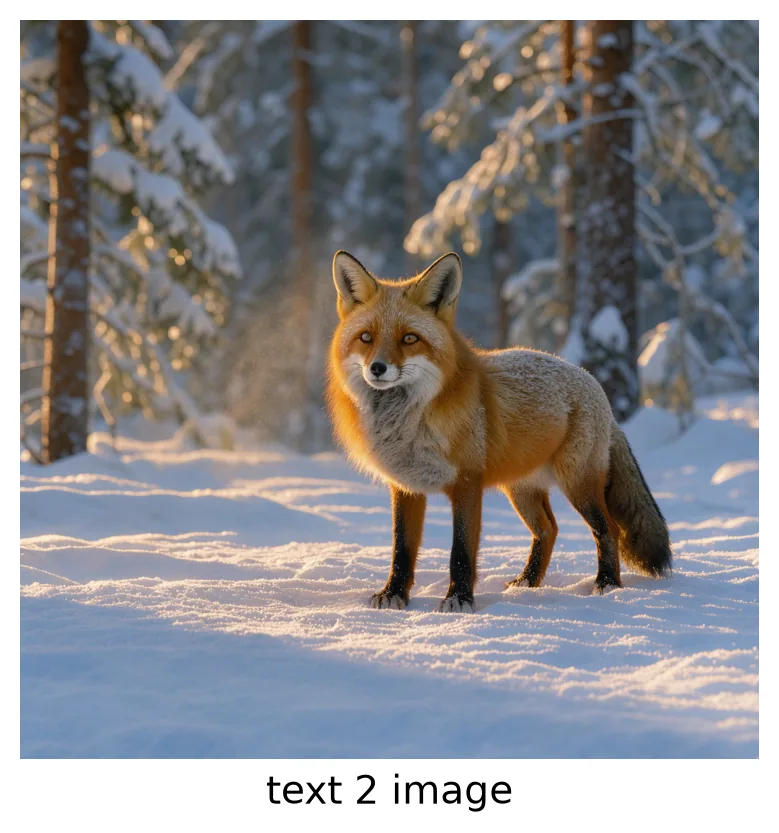
- Text-to-Image yang Detail: Menghasilkan adegan visual kompleks dengan instruksi gaya, sudut pandang, pencahayaan, dan komposisi yang rapat.
- Multi-Reference Image-to-Image: Menerima satu atau beberapa gambar referensi sekaligus, lalu menggabungkan elemen-elemennya lewat penanda khusus pada prompt.
- Layout Control Berbasis JSON: Mengatur letak objek baru maupun memindahkan posisi objek dari gambar referensi pakai koordinat bounding box.
Cara Mencoba Text-to-Image dan Multi-Reference
Buat mulai menjalankan model ini, kamu perlu memperbarui pustaka diffusers dan transformers ke versi paling baru karena encoder teksnya memakai Qwen3-VL. Kode dasarnya simpel banget berkat format ModularPipeline:
import torch
from diffusers import ModularPipeline

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein")
pipe.load_components(dtype=torch.bfloat16)
pipe.to("cuda")

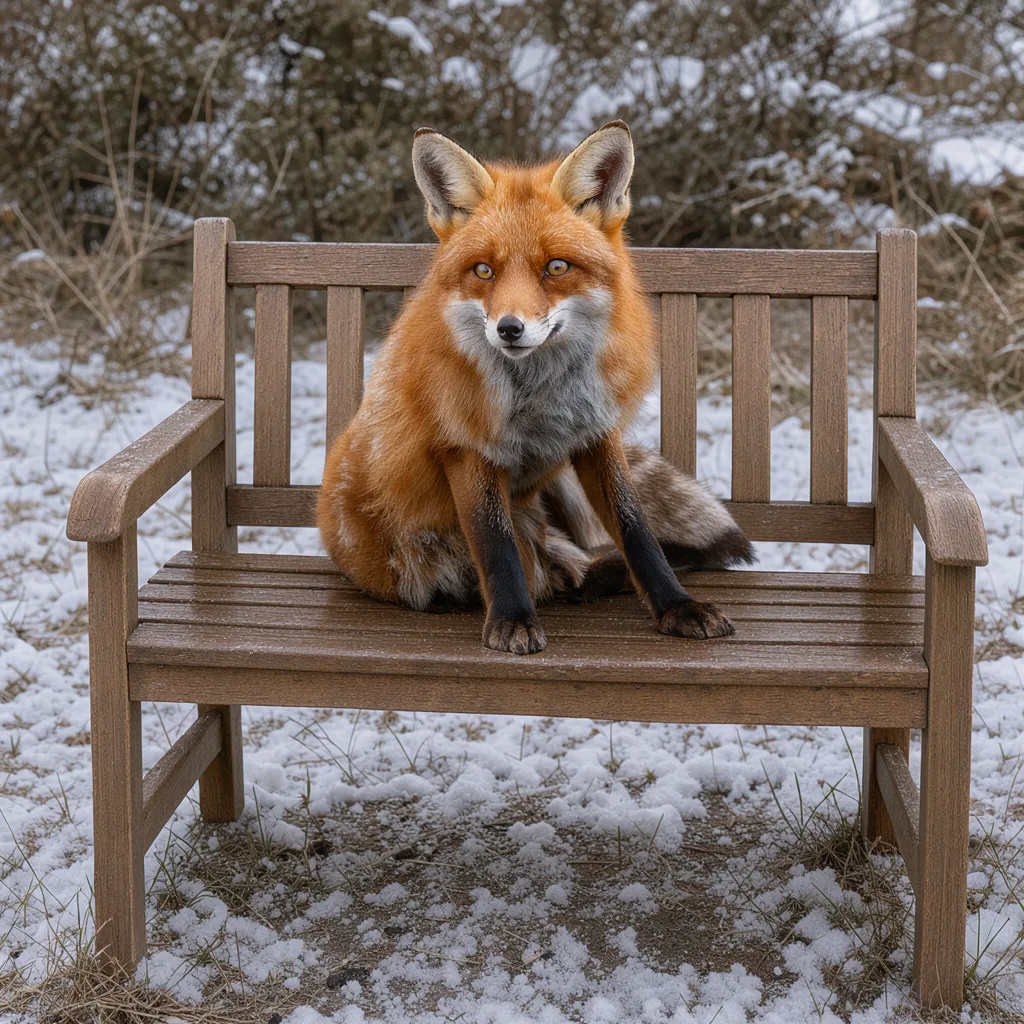
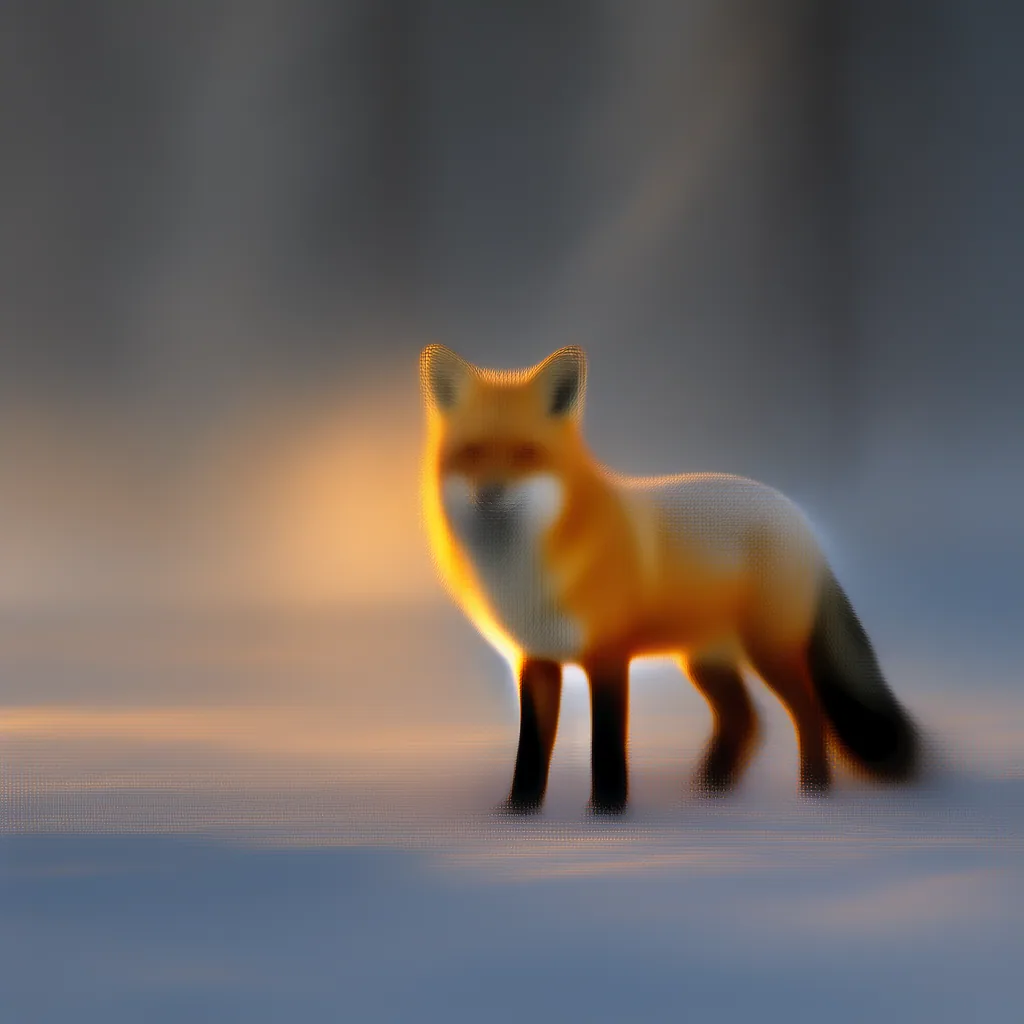
pipe(prompt="a red fox", output="images")[0].save("fox.png")
Menariknya, kalau kamu ingin mengubah suasana gambar tadi, kamu tinggal memasukkan gambar tersebut kembali ke argumen image dan menuliskan prompt baru. Model ini bakal mempertahankan wujud subjek sambil menyesuaikan konteks barunya.

Bahkan kalau kamu punya beberapa gambar acuan terpisah, kamu bisa menandainya secara berurutan sebagai <ref_image_0>, <ref_image_1>, dan seterusnya di dalam prompt gabungan.
Kendalikan Tata Letak Visual dengan Layout Control
Salah satu keunggulan terbesar FLUX.3 Image Klein dibanding generasi sebelumnya ada pada fitur layout control. Kamu bisa menuliskan daftar region berformat JSON tepat di akhir deskripsi adegan. Format kotak pembatas (bounding box) ditulis dengan skala normalisasi 0 sampai 1000 berupa [y_min, x_min, y_max, x_max].
Skala normalisasi ini bikin koordinat tetap bekerja akurat di berbagai resolusi kanvas tanpa perlu menghitung ulang rasio piksel secara manual.
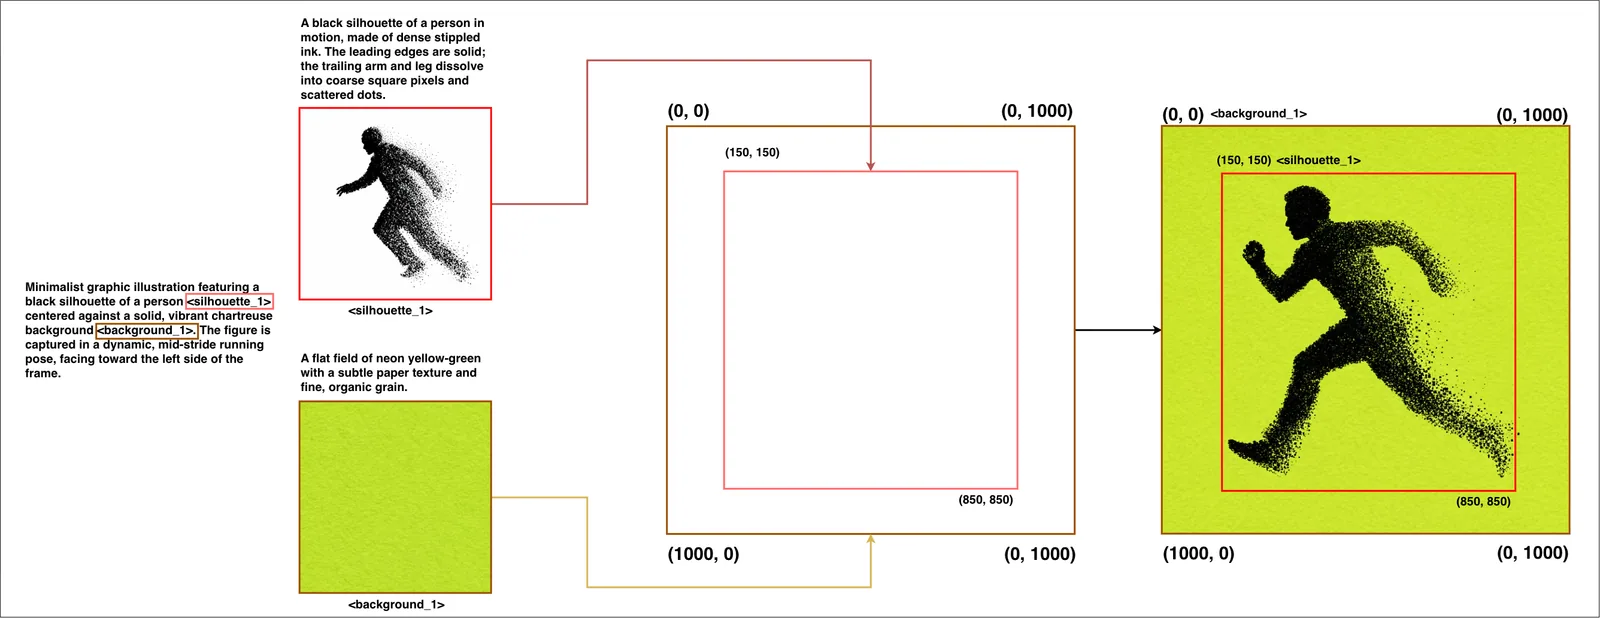
Nggak cuma buat bikin gambar dari nol, koordinat ini juga bisa dipakai untuk memindahkan objek di dalam gambar referensi. Kamu cukup menentukan kotak asal (src_bbox) dan kotak tujuan (tgt_bbox), sementara elemen lain yang dipatok koordinatnya bakal tetap diam di tempat.

Menjalankan Model di GPU Hemat: Opsi Bobot FP8 dan NVFP4
Masalah klasik saat menjalankan model difusi ukuran besar di komputer lokal atau server cloud adalah kapasitas VRAM. Untungnya, Black Forest Labs menyediakan bobot transformer tunggal (single-file) dalam format bf16 serta dua varian kuantisasi: fp8r (rowwise FP8) dan nvfp4.
Berikut konsumsi memori puncak (peak allocated memory) untuk varian-varian tersebut:
| Varian Bobot | Perangkat Uji | Peak Memori Pasca Load | Peak Memori Pasca Inferensi |
|---|---|---|---|
| nvfp4 | RTX 6000 | 13,4 GiB | 15,3 GiB |
| fp8r | H100 | 14,35 GiB | 16,27 GiB |
| bf16 | H100 | 18,80 GiB | 20,72 GiB |
Kernel cepat untuk format fp8r bisa dinikmati pada kartu grafis berarsitektur Compute capability 8.9+ (seperti Ada Lovelace, Hopper, dan Blackwell). Sementara buat format nvfp4, optimasi akselerasi penuh bekerja pada arsitektur Blackwell menggunakan paket flashinfer-python dan flashinfer-cubin dengan versi yang cocok. Di GPU lain, bobot tetap bisa dimuat lewat dekuantisasi per langkah untuk menghemat VRAM, meski tanpa lonjakan kecepatan.
Seberapa Cepat Performa FLUX.3 di Server?
Berdasarkan pengujian pada satu unit NVIDIA H100 80GB menggunakan checkpoint distilled (16 langkah, tanpa offloading, backend atensi standar), catatan waktu inferensinya tergolong sangat responsif:
| Alur Kerja (Workflow) | Ukuran Output | Waktu Eksekusi | Peak Memori |
|---|---|---|---|
| Text-to-image | 1024 × 1024 | 1,93 detik | 23,8 GiB |
| Image-to-image (1 referensi 1024×1024) | 1024 × 1024 | 3,87 detik | 23,8 GiB |
| Layout editing (1 referensi 1360×768) | 1360 × 768 | 4,10 detik | 23,8 GiB |
Kenapa alur dengan gambar referensi memakan waktu sekitar dua kali lipat lebih lama? Karena token dari gambar referensi digabungkan ke urutan sekuens yang sama dengan teks dan gambar target. Tiap gambar referensi 1024×1024 menambahkan 4.096 token ke dalam panggilan transformer.

Panduan Singkat Fine-Tuning LoRA
Buat pengembang yang ingin melatih gaya visual atau subjek khusus, checkpoint base FLUX.3 sangat ideal dijadikan pondasi LoRA (Low-Rank Adaptation). Skrip DreamBooth bawaan Diffusers sudah mendukung pelatihan text-to-image maupun instruksi editing image-to-image.
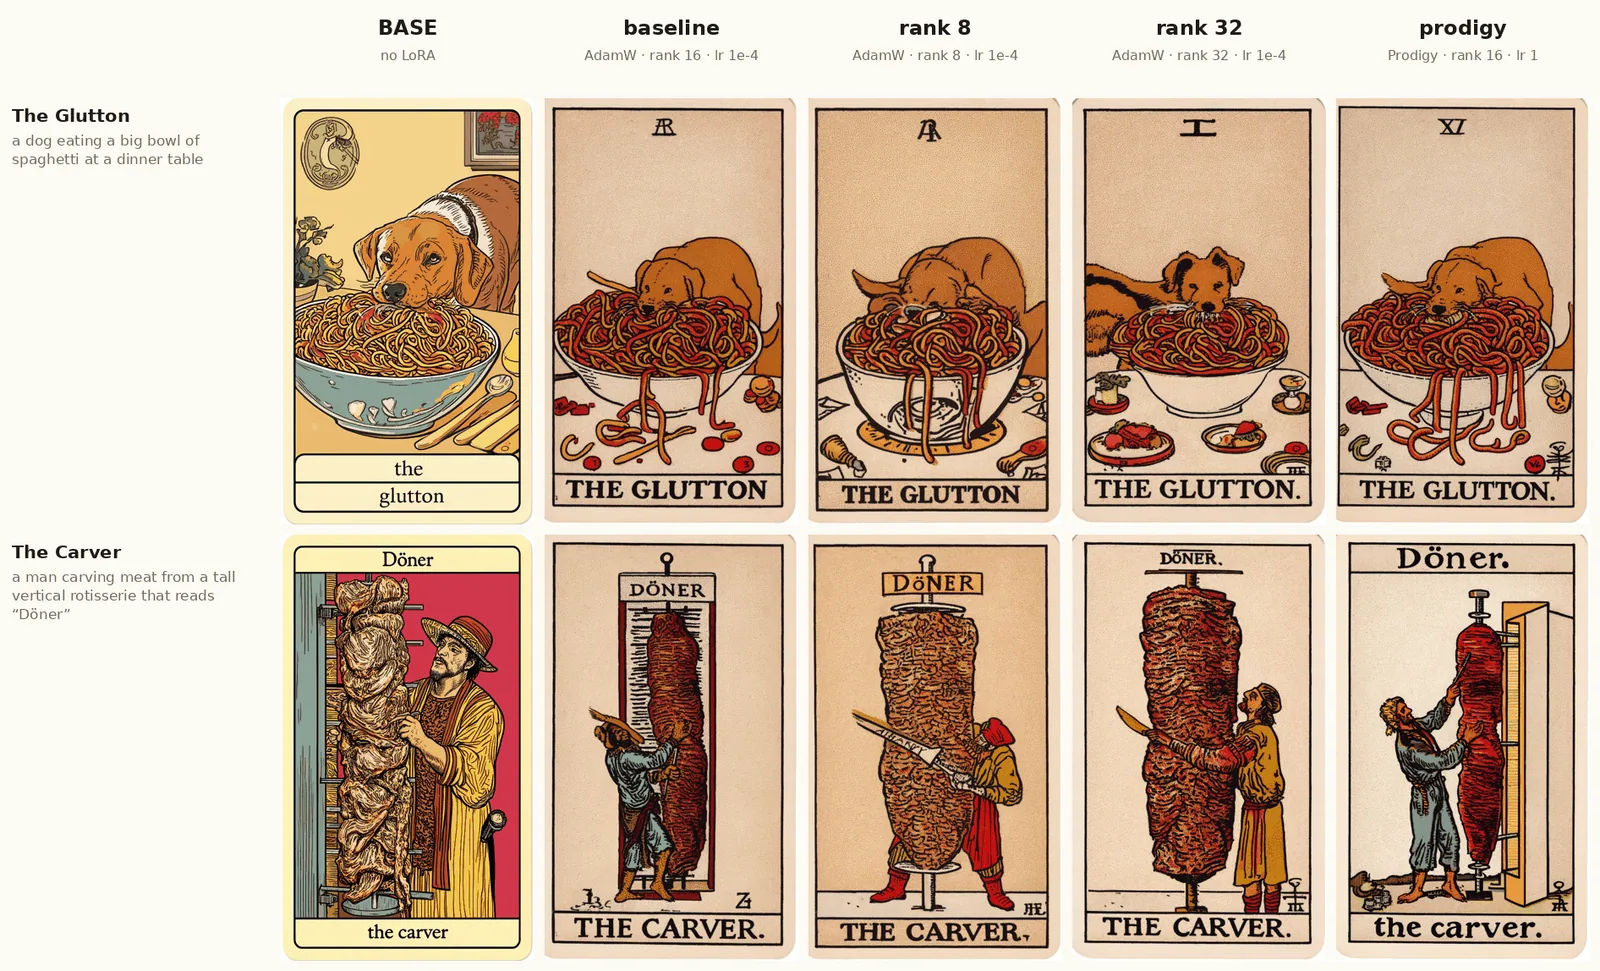
Untuk menghemat penggunaan VRAM saat proses training berjalan, kamu bisa menyalakan tiga flag penghemat memori utama:
--gradient_checkpointing: Menghitung ulang aktivasi di backward pass agar VRAM lebih longgar.--cache_latents: Melakukan pra-enkode gambar lebih awal sehingga modul VAE bisa langsung dilepas dari memori.--use_8bit_adam: Menyimpan status optimizer dalam format 8-bit.
Kalau kamu butuh model teks pendukung untuk merapikan dataset atau menyusun prompt otomatis sebelum melatih model gambar, kamu bisa memanfaatkan model canggih seperti Claude Sonnet 5 (Rp3.210 input / Rp15.750 output per 1M token) atau opsi ekonomis kencang seperti DeepSeek V4.1 Flash (Rp1.155 input / Rp4.200 output per 1M token) via Classai Router.
Menilik Rahasia Arsitektur FLUX.3 Image Klein
Di balik kemampuannya, FLUX.3 mengadopsi struktur latent-space flow model yang cukup unik:
1. Kompresi VAE dan Encoder Qwen3-VL
FLUX.3 mempertahankan arsitektur VAE dari FLUX.2, yang mengompres gambar 8× ke dalam 32 kanal, lalu mengemas setiap patch 2×2 menjadi satu token berkanal 128. Artinya, satu token mewakili bidang 16×16 piksel, sehingga gambar 1024×1024 dipadatkan menjadi 4.096 token.
Untuk teks, FLUX.3 memanfaatkan vision-language model Qwen3-VL. Alih-alih cuma mengambil lapisan terakhir, model ini mengekstrak dan menumpuk hidden states dari delapan layer (layer 4, 8, sampai 32) menghasilkan vektor 20.480 dimensi sebelum diproyeksikan ke lebar transformer 3.072 dimensi.
2. Dua Tahap Pemrosesan Transformer
Transformer memproses data dalam dua etape:
- Stage 1 (Per-mode blocks): Terdiri dari 5 blok terpisah di mana teks, noise gambar, dan gambar referensi hanya memproses dirinya sendiri dengan bobot masing-masing.
- Stage 2 (Joint blocks): Seluruh token digabung dalam satu sekuens panjang
[text | image | reference]melewati 28 blok bersama. Di sini, gambar menyerap informasi dari teks dan referensi.
3. Modulasi dan Koordinat 4 Dimensi
FLUX.3 menggunakan rotary position embeddings (RoPE) berbasis empat sumbu: (t, h, w, l) yaitu timestep, tinggi, lebar, dan panjang urutan. Karena gambar referensi memakai sistem koordinat (h, w) yang sama dengan kanvas target, model bisa memahami letak pasti suatu objek dari kotak acuan.

Scheduler FLUX.3 memakai pergeseran waktu (time shift) sebesar 6.93, membuat tingkat noise tetap tinggi di sebagian besar tahapan inferensi (44 dari 50 langkah terjadi di atas nilai σ = 0.5).
Dampak Nyata untuk Industri Kreatif dan Developer Indonesia
Kehadiran FLUX.3 Image Klein membawa angin segar bagi komunitas teknologi, studio desain, dan pengembang di Indonesia:
- Efisiensi Produksi Konten Komersial: Desainer dan UMKM lokal kini bisa mengatur komposisi tata letak produk atau poster promosi secara presisi lewat bounding box, tanpa perlu bergantung pada proses edit manual yang memakan waktu.
- Kemandirian Infrastruktur (Self-Hosting): Berkat dukungan format bobot FP8 dan NVFP4, studio kreatif lokal dapat meng-host model ini secara on-premise atau di server cloud hemat biaya tanpa harus menyewa kluster GPU enterprise yang mahal.
- Kepatuhan Privasi Data: Mengingat sifat modelnya yang terbuka (open weights), korporasi atau instansi lokal bisa menjalankan alur kerja pengolahan aset visual langsung di server internal tanpa mengirimkan materi rahasia ke API pihak ketiga, sejalan dengan prinsip perlindungan data privat.
Kalau kamu tertarik mendalami cara kerja model generatif atau integrasi API AI ke dalam aplikasi bisnis, kamu juga bisa melihat panduan di AI untuk Developer untuk mengasah alur integrasi sistem otomasi cerdas kamu.
Sumber & referensi
- 01
Hugging Face · 15 Oktober 2026
Welcome FLUX.3 Image Klein in Diffusers
Artikel ini ditulis ulang oleh Tim Classai dengan bantuan AI berdasarkan sumber di atas — bukan terjemahan. Ada yang keliru? Kabari kami di [email protected].
Pertanyaan yang sering ditanyakan
Apa itu FLUX 3 Image Klein?
FLUX 3 Image Klein adalah model generasi gambar sumber terbuka terbaru dari Black Forest Labs yang mendukung text-to-image, multi-reference editing, dan layout control lewat ekosistem Hugging Face Diffusers.
Apa perbedaan checkpoint distilled dan base di FLUX 3?
Checkpoint distilled dirancang untuk inferensi cepat dalam 16 langkah tanpa CFG, sedangkan checkpoint base membutuhkan 50 langkah dengan CFG dan menjadi pilihan utama untuk fine-tuning LoRA.
Bagaimana cara kerja layout control di FLUX 3?
Layout control bekerja dengan menambahkan daftar JSON berisi ID wilayah, koordinat kotak pembatas (bbox) berskala 0 sampai 1000, serta deskripsi objek langsung di ujung prompt teks.
Apakah FLUX 3 bisa dijalankan di GPU dengan VRAM terbatas?
Bisa, kamu dapat menggunakan bobot terkuantisasi seperti FP8 (fp8r) atau NVFP4, menerapkan automatic CPU offloading, serta memisahkan proses text encoder untuk menghemat konsumsi memori grafis.
Classai Weekly
dari Luthfi · Setiap Senin, 06.30 WIB
Nggak sempat ngikutin berita AI? Biar aku yang rangkumin tiap Senin.
- 5 berita AI paling penting minggu ini — udah disaring, nggak perlu baca puluhan situs
- Kenapa itu penting buat kamu — plus opini jujur Luthfi soal arahnya
- 1 prompt siap pakai yang bisa langsung dicoba
- Pilihan kelas & model AI minggu ini — kadang ada promo khusus pelanggan
Langkah berikutnya
Sudah paham teorinya. Sekarang praktikkan.
Daftar, isi saldo mulai puluhan ribu rupiah, dan panggil model AI pilihanmu dari kode yang sudah ada.
Ditulis oleh
Pengembang Classai Router
Tim Engineering Classai membangun dan menjalankan Classai Router, gateway API AI yang kompatibel dengan format OpenAI dan Anthropic. Kami menulis panduan teknis dari pengalaman mengoperasikan API AI setiap hari.